ARTICLE · 1160370
一个正负号的价值:论软件工程思维如何"攻克"数学
近日,OpenAI 一口气放出 722 篇 AI 数学手稿,场面蔚为壮观,颇有"数学界从此进入工业化大生产时代"的气势。结果还没等掌声落地,其中 3 篇就被悄悄撤回了。原因说出来有点不好意思:一个正负号写错了。
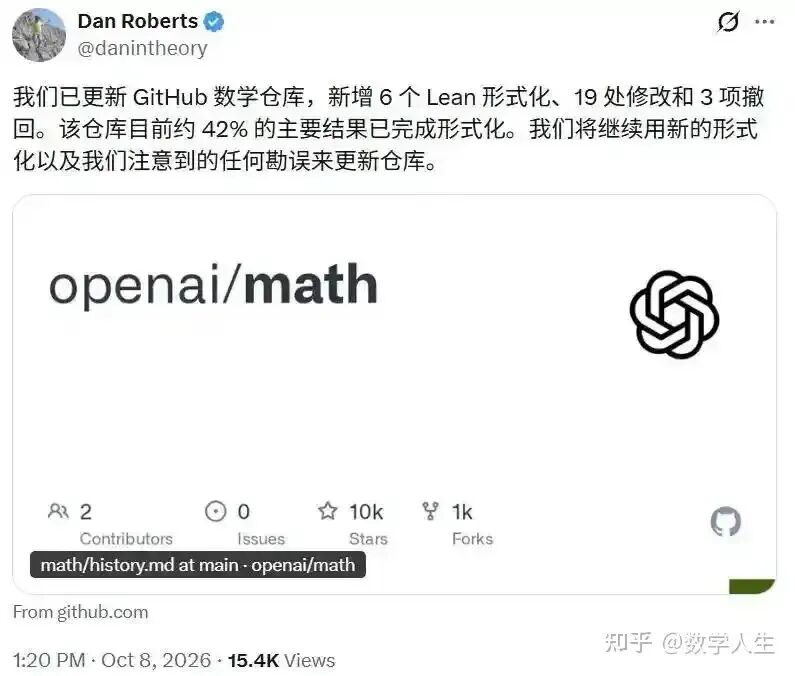
一个正负号。就这么点东西。
学过数学分析的人都知道,ε-δ 语言里随便一个地方正负号一错,整条证明链当场塌方,连个响都听不见。数学这门学科几百年来建立起的威信,靠的就是这种近乎偏执的较真:每一步推理都要经得起任何人在任何时间反复推敲。结果到了 AI 这里,一天 722 篇的产能,质量把关靠的却是"先放出来,网友帮你看"。
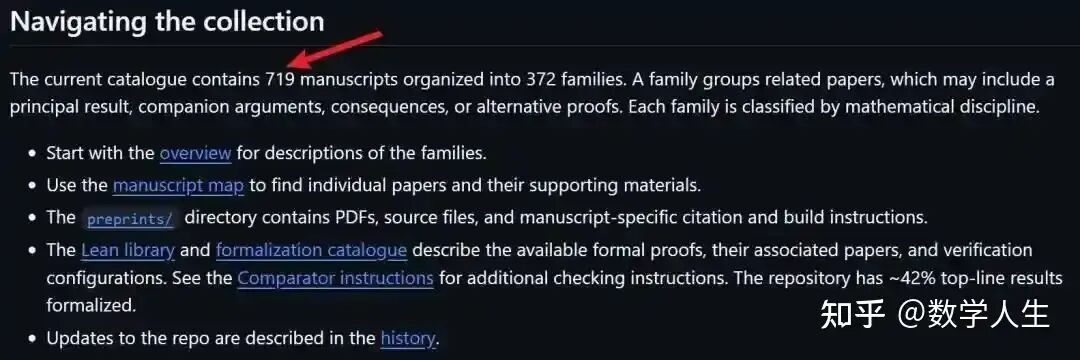
这就很有意思了。这套流程我们其实熟悉得很——这是软件开发的玩法。
先上线,后修 bug;灰度发布,快速迭代;用户反馈驱动版本更新。代码写崩了,回滚一下就行,服务器重启,生活继续。可数学不是软件。数学论文不是 App 的 beta 版,撤回的论文不能像崩溃的程序一样发个补丁就当无事发生。一个符号的错误在数学里不是"小瑕疵",而是整个论证大厦的地基裂了缝——你楼盖得再快、装修得再漂亮,地基歪了,全拆。
一天 722 篇,意味着平均每两分钟不到就"完成"一篇数学手稿。人类数学家一辈子能做出几篇真正站得住的工作?陈景润筛法那篇论文磨了多少年,佩雷尔曼证明庞加莱猜想之后还要接受全世界专家好几年的逐行审查。数学界几千年来的惯例是:宁慢勿错。而 AI 时代的逻辑变成了:宁多勿慢,错了再撤。前者是学术,后者是流水线。
严谨性不是靠算力堆出来的。语言模型生成证明,本质上是概率上的"看起来很对",而不是逻辑上的"必然正确"。正负号这种细节,恰恰是统计拟合最容易翻车的地方——因为它不起眼,出现频率高,错了也不影响"读起来像那么回事"。没有人类数学家逐行逐句的严格论证,没有同行评审那种鸡蛋里挑骨头的审查,所谓的"AI 攻克数学",目前更像是"AI 量产数学风格的文本"。
AI 在数学上确实在进步,将来也大概率会成为数学家的好帮手。但"帮手"和"主力"之间,隔着的是一整套关于严谨性的文化。软件行业可以容忍 bug,因为 bug 修了就完了;数学不能容忍错误,因为错误意味着你根本没证明任何东西。把软件工程那套"快速试错、拥抱失败"的方法论原封不动搬进数学,得到的不会是 722 篇论文,而是 722 份待质检的半成品,外加 3 篇已经被质检打回来的退货。
数学的门槛从来不在"写得多",而在"错不了"。