ARTICLE · 1160729
引入AI编程工具后,用什么方法保证代码质量?
天下武功,唯快不破。百步之内,agent比人快,十步之内,agent又准又快。
上个月团队内部技术分享的共识就是抛弃人工review,以及所谓的bug free的观念。
要承认任何用LLM工具生成出来的代码,只要服务于复杂体系,或多或少就是会有bug,人能做的无非是引入多个Agent交叉审交叉修。
换言之,只要你的Agent修得够快,那么某种程度上就可以认为没有bug。
为此你需要三样东西:第一梯队的模型,完全仿照生产的模拟环境,以及一个自动迭代修复各种问题的系统(或者说是Harness也行)。
人做不到bug free,从人类知识里提炼出各种模式的大模型也做不到bug free。
一个公司的技术架构越复杂,各种服务里的bug就越多,甚至要这个公司还活着,就基本没有哪天是没bug的。
评价一个大模型输出的代码质量如何,写unit test已经是自欺欺人的做法。因为同一个大模型会照着自己刚写的实现反推断言,覆盖率能刷到百分之九十以上,一上线遇到不属于大模型预估的输入行为就直接歇菜了。
现在最符合快速发版的审核方式就是用一部分真实线上数据作为输入来模拟运行(数据的部分不多说,没有就beta阶段去搜集,再没有就得自己找过往的数据集去重构一个新的数据集),看软件的表现是否和最初设计的预期是一致的。
这就要求要么项目本身用极简的技术栈,那么你开发、测试、生产环境也许就是同一个;要么项目很复杂,但是环境可控且一致,那么即便开发、测试、生产的环境是隔离的,同一套编译好的代码上去跑问题是可以复现然后被定位到的。
这里的模拟,不是让你再搭一个长得像生产的 staging。那种东西谁都搭过,最后大多变成一个月没人碰的僵尸集群。
真正管用的是影子流量。把新版本部署上去,让它和老版本同步吃同一份真实请求,只是它的返回不落库、不面向用户,只在后台跟老版本逐条比对。

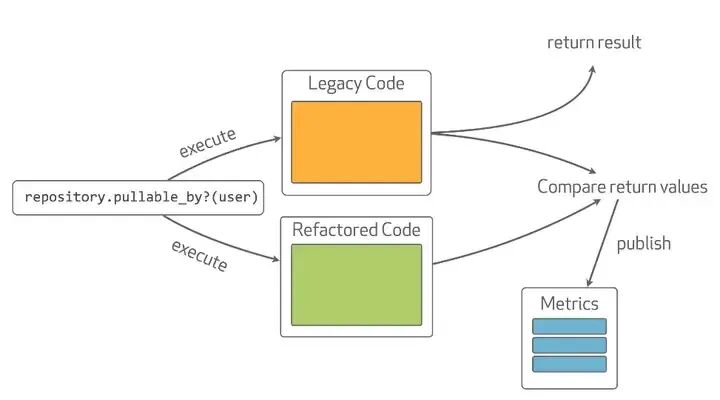
Uber 重构账户系统时就这么干,把线上真实流量复制一份灌进新系统,还乘上十倍做压测,新旧两条链路的结果一条条对,对不上的才捞出来看。GitHub 更早就在用 Scientist 这套框架,新老两份代码同时跑,用户只拿到旧代码的结果,所有不一致都写进日志。
把验证对象从代码换成行为,是这一整套方法论的分水岭。
同时修复速度论有个隐含前提:修复的净收益必须为正。
一个系统的复杂度越高,这个净收益越容易被吃掉。Lehman 几十年前就总结过,软件系统的复杂度只会单调上升,除非你主动投入重构。
承认这点,很多争论就消停了。你不需要一个 bug free 的系统,你需要的是 bug 的修复速度快过它产生的速度。
而要做到这一点,光堆模型没用,得在它外面围一圈约束。Anthropic 官方那套三 Agent 架构就是干这个的:生成器干活,评估器用真实点击去打分,分不够就打回重来,本质是让两个 Agent 互相证伪;再叠一层验证闭环,让 Agent 自己去读类型检查、lint、测试和运行时报错这些确定性信号,失败就自动返工。

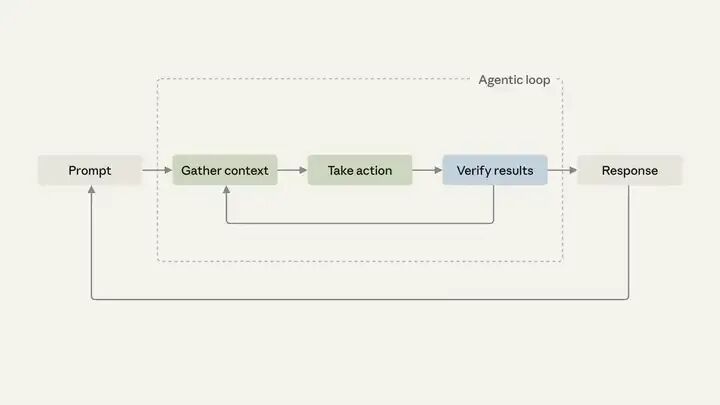
这套闭环能不能转起来,还取决于你有没有一双看得见线上真相的眼睛。日志、trace、指标铺到位,异常一冒头就知道在哪;铺不到位,Agent 再强也只能对着空气改。所以真把修得快做出来的团队,往往先补的是可观测性,而不是再买一个更贵的模型。
在这个系统里,模型只管生成和修,环境负责控制变量,自迭代框架负责收敛。
当然话说回来,这套东西对复杂系统是刚需,对简单系统反而是负担。
你的项目要是一堆Markdown加html(真见过那种算命和塔罗牌的项目),或者 Vercel 加 Supabase 就能跑通,那恭喜,你连自建 Harness 都省了。
可对大多数B端的业务代码来说,真正的难点在于能不能把生产环境,复制出一个敢接真实流量的影子,并且把这个环境释放给大模型去跑模拟,然后自动追踪结果再自动修复各种问题……
❝作者:Simon Zhang
原文https://www.zhihu.com/question/2022325433908119031/answer/2092049962318279005