ARTICLE · 1161141
AI 项目数据清洗全流程
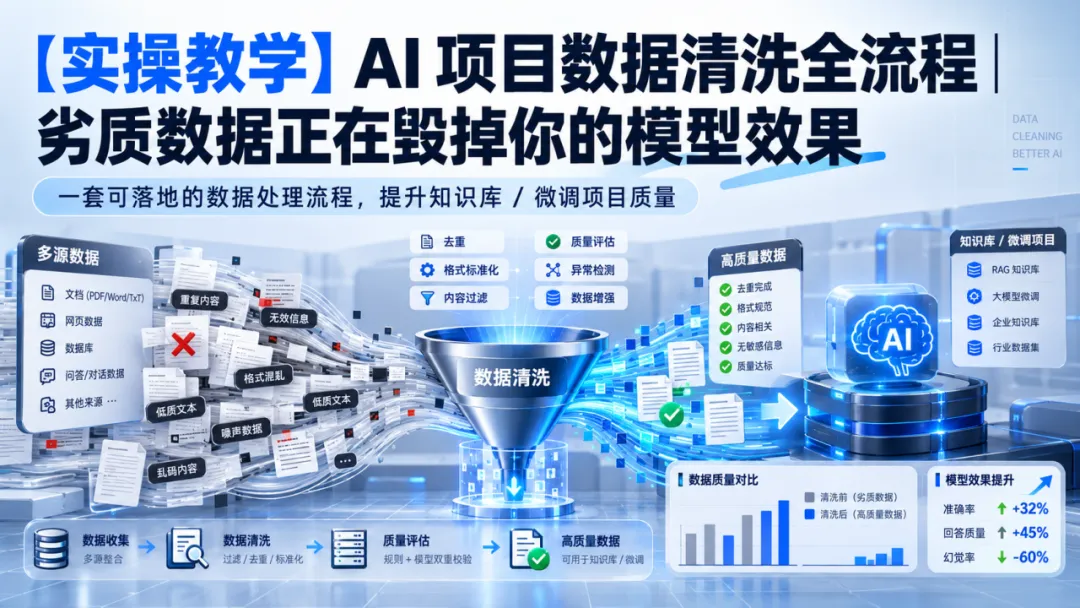
很多人做企业知识库、模型微调项目,投入大量算力、调提示词,可最终模型输出依旧混乱、幻觉多、答案前后矛盾。反复排查后才发现,问题根源不是模型能力不足,而是原始数据杂乱。脏数据、重复文本、无效冗余内容、错误信息,会直接污染模型。本文是实战教学分析,拆解 AI 项目数据清洗完整流程,讲解判定标准、实操步骤、常见坑,做知识库、微调训练都可以直接套用。
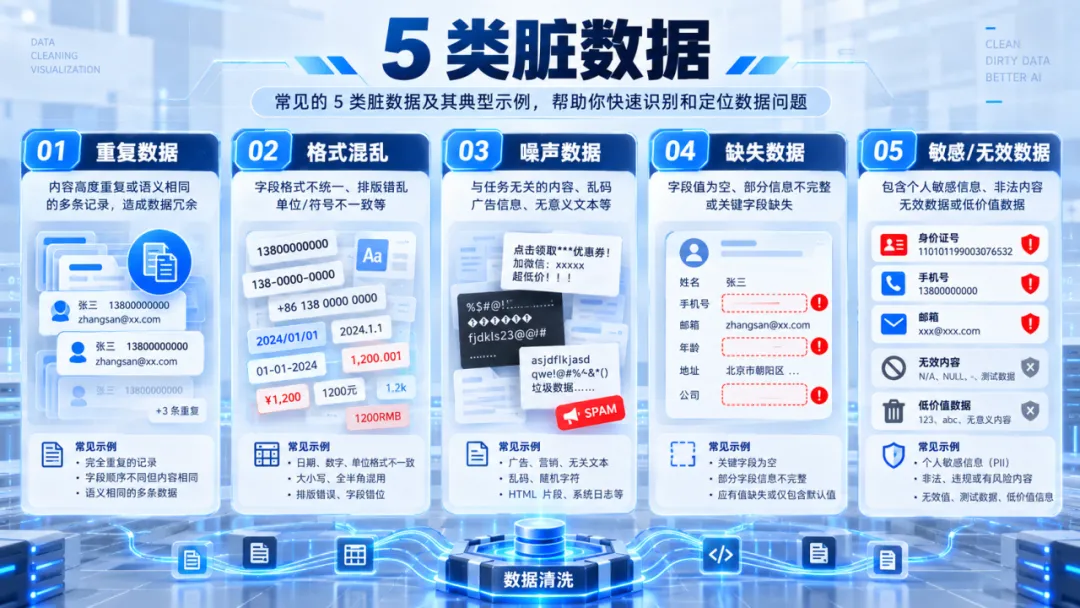
AI 项目里的 “脏数据”
先分清几类会严重影响模型效果的数据类型:
重复数据:多篇文档内容高度重合,反复录入,模型会重复学习相同信息,答案冗余。
噪声数据:网页乱码、页眉页脚广告、目录、页码、图片注释、换行空行。
矛盾数据:同一份资料里,对同一个问题给出两种不一样的结论,模型极易产生幻觉。
无效低质数据:碎片化短句、无意义闲聊、残缺不全的段落,缺少完整逻辑。
涉密违规数据:包含手机号、身份证、企业内部未脱敏机密信息,存在合规风险。
教学小结:数据清洗不是简单删除空格,核心目标:去重、降噪、消矛盾、脱敏、结构化。
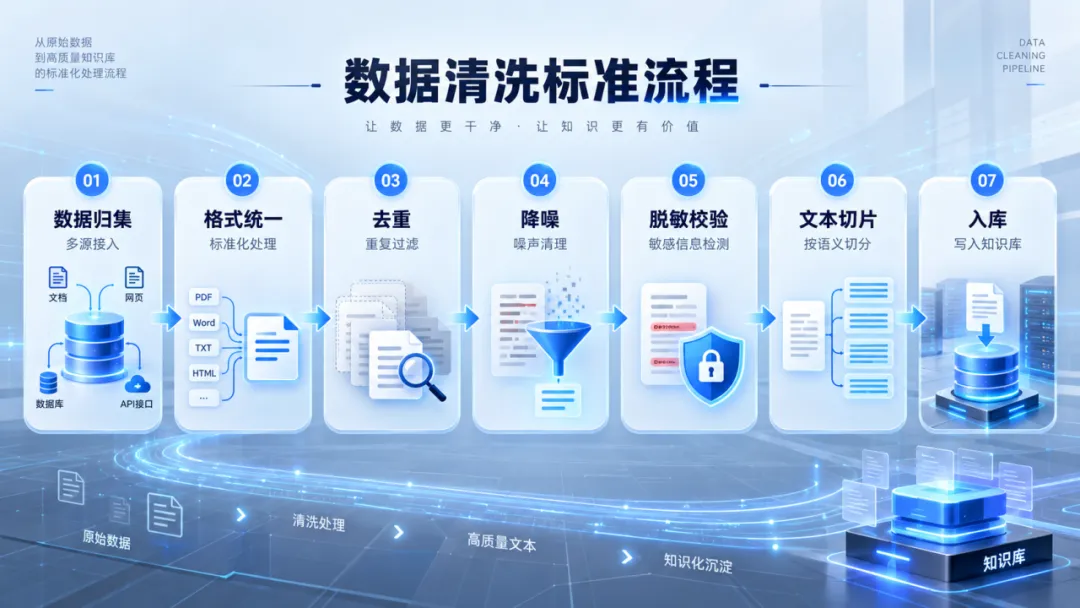
分步实操教学SOP
1
原始数据归集与格式统一
项目第一步,把多来源文档(PDF、Word、网页、Excel)统一转为纯文本。操作要点:
PDF 优先使用 OCR 提取文字,剔除图片水印、页眉页脚;
合并零散文件,统一编码,清理大量空行、特殊符号;
建立数据台账,记录每份文档来源、采集时间,方便溯源。
2
去重处理
两层去重策略:
粗去重:完全一模一样全文,直接删除重复副本;
语义去重:文本文字不完全相同,但表达的信息高度一致,保留一份最优版本。
实操提醒:不要只看文字字符,语义重复才是知识库项目最容易忽略的坑。
3
噪声过滤,剔除无效内容
批量删除:广告文本、目录、页码、版权声明、网页导航栏、无关备注。保留核心业务正文,把碎片化零散短句合并成完整段落。
4
数据脱敏 + 矛盾校验
脱敏:自动识别手机号、证件号、客户隐私信息,做掩码替换,规避数据合规风险。
矛盾校验:检索相同问题对应的多条答案,人工比对,删除错误版本,统一结论。
5
文本切片(分块)
清洗完成后,进行文本分段切片。推荐参数:单段 500-800 字,段落之间保留重叠 10%~15%。
原理:分段太长,向量检索精度下降;分段太短,丢失上下文,模型回答缺少完整逻辑。
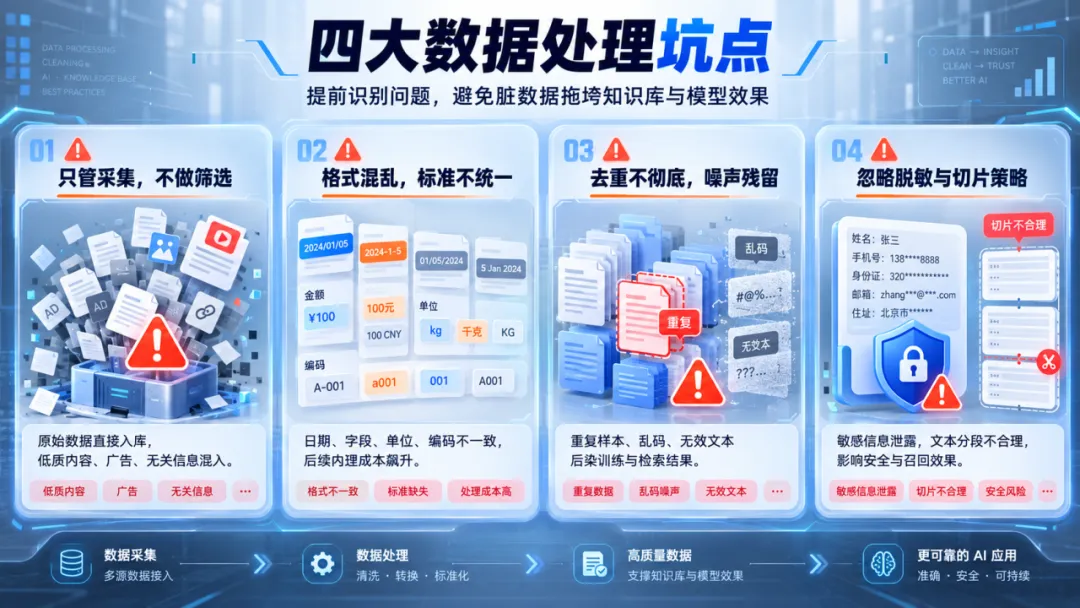
高频踩坑点分析
❌坑 1:跳过数据校验,直接入库分析:很多团队拿到文档直接向量化入库,文档里面的错误信息会被模型记忆,后续回答持续出错。数据质量,决定知识库的上限。
❌坑 2:切片大小一刀切,所有文档统一固定字数分析:技术文档适合短切片;合同、长案例适合较长切片。全部使用同一长度,检索效果大打折扣。
❌坑 3:只做字符去重,忽略语义重复分析:两篇文章用词不一样,但核心信息完全一致,向量检索会一次性召回多条相似内容,造成回答啰嗦混乱。
❌坑 4:脱敏环节简化,直接上线分析:企业私有知识库,一旦包含客户敏感信息,会带来信息泄露的合规风险。
在 AI 项目里,数据是底层地基
模型只是工具,数据质量决定最终效果
数据清洗不是一次性工作
属于长期维护任务
新增文档入库前,都要走这套 SOP
很多项目急于上线
简化数据处理流程
最后只能不断在提示词层面补救
事倍功半
💬互动话题:
你做知识库项目时
有没有遇到脏数据带来的模型幻觉问题?
欢迎评论区交流