ARTICLE · 1161302
AI 怎么看懂一个没有源码的应用?
本文为个人学习笔记,仅用于技术学习与研究。
复制一段笔记,粘到另一个位置。文字要跟过去,列表和块结构也希望保留下来。
对于使用者,这只是一次复制粘贴。对于准备做编辑器的人,问题就具体了:除了文字,还复制了什么?结构放在哪里?粘贴时,又怎样认出这是哪一次复制留下的数据?
如果拿不到应用的项目源码,只能拿到安装包,这些问题该从哪里开始?
REA 项目公开了一份 Notion 剪贴板调查案例。它从桌面应用发布包里定位接口,沿包装函数追到主进程,再结合历史 web 模块探针,解释了一种保存和恢复块结构的机制。
这个过程很适合用来理解 REA。它把本地分析能力接进 Agent,让调查可以从“解释一下这个功能”,逐步落到具体文件、调用关系和可核对的行为上。
我们就沿着这一次复制,看看一个应用怎样被读懂。
1. 先把安装包,变成可以调查的对象
第一步,是认出手里有什么。
原生程序主要发布机器码,需要从字符串、符号、引用、汇编和伪代码中寻找关系。JavaScript 或 Electron 应用的发布包,则可能保留压缩、打包后的脚本,仍然可以做语法分析。
Notion 案例选择的是 Desktop 7.6.1 的 Windows app.asar。ASAR 是 Electron 常用的应用归档形式,里面可以找到 JavaScript 文件与资源。
调查没有一开始就扫遍整个包。它先看 tab 对应的 preload:
.webpack/renderer/tab_browser_view/preload.jspreload 位于页面与桌面能力之间。页面需要写剪贴板,相关入口就可能经过这里。先找这个边界,能把一个宽泛的“复制功能怎么实现”,缩小为“页面调用了哪个接口,它把请求交给了谁”。
如果已经准备好这类提取目录,可以从静态分析开始:
rea analyze-javascript-application \ /path/to/.webpack/renderer/tab_browser_view \ --json > preload-evidence.json命令读取制品,恢复它能解析的模块和关系。这里不需要先启动目标应用。
REA 也提供其他入口:原生分析连接 Hopper、Ghidra 或 IDA 等引擎,运行目标则使用浏览器、Electron 或进程观察工作流。具体能力依目标、主机和提供方而定。项目说明[1]
在这套分工里,Agent 组织问题与后续调查,REA 承接分析操作并返回证据,具体引擎和解析器产生对应事实。对剪贴板这个问题,发布包中的 JavaScript 就是一个有用的起点。
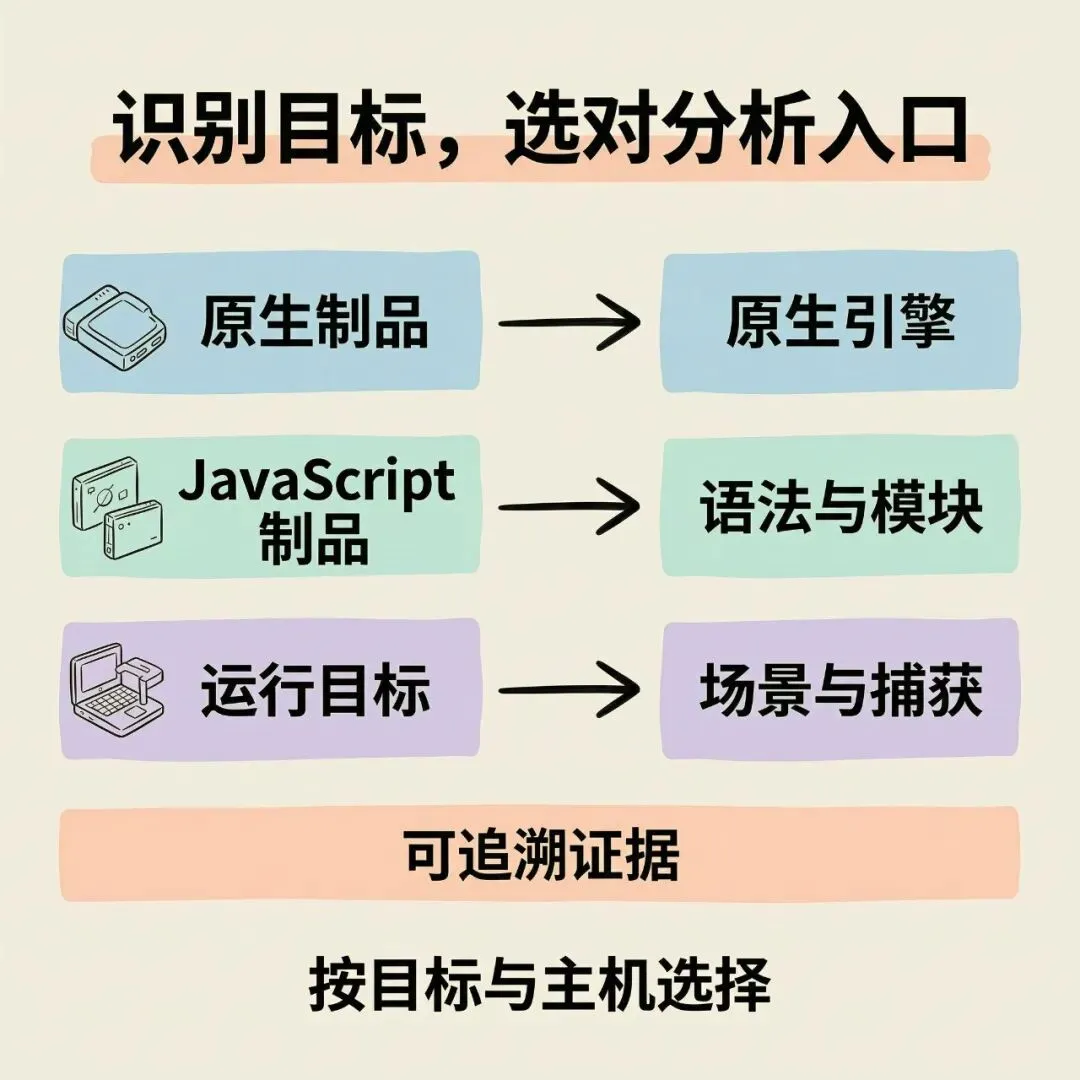
图解 1|识别目标,选对分析入口先识别目标的实际形态,再选择分析入口。Notion 的发布脚本属于 JavaScript 制品;原生引擎与运行捕获承担另外的观察任务。
2. 第一份结果,告诉我们哪里值得继续读
项目在 2026 年 10 月 7 日用 REA 4.1.0 检查了这份保存的 preload。结果定位到两处关键代码:暴露给页面的 API,以及发出 IPC 请求的调用。
IPC 就是进程间通信。在 Electron 里,页面调用与主进程里的桌面操作,往往通过它连接。
但这份结果没有直接给出一条完整剪贴板链路。几个关键字段是:
页面 API:__electronApiAPI 状态:dynamicIPC 操作:invoke频道表达式:e具体频道:null工具找到了入口与调用位置,却还没有解析出完整 API 成员和具体频道。它同时返回原始压缩脚本的源码范围,使调查能回到那几处代码继续读。案例来源与范围[2]
这个区别很重要。
invoke 的第一个参数可以是一个变量。只看到调用所在的位置,未必知道变量从哪里来;返回函数、闭包和拼接的对象,又会把实际名称藏到其他地方。
接着对这份局部图做 feature trace,API 种子能得到部分关系,具体剪贴板频道的种子却没有匹配。这个结果仍然给出了下一步:打开已定位的包装函数和 API 对象,找参数真正从哪里传入。
如果把“不知道频道”改写成一个猜测名称,后面就可能沿错误方向搜索;如果把“图里没有匹配”当成功能不存在,又会过早结束调查。
一份有用的工具结果,需要同时交代找到了什么,以及缺口在哪里。
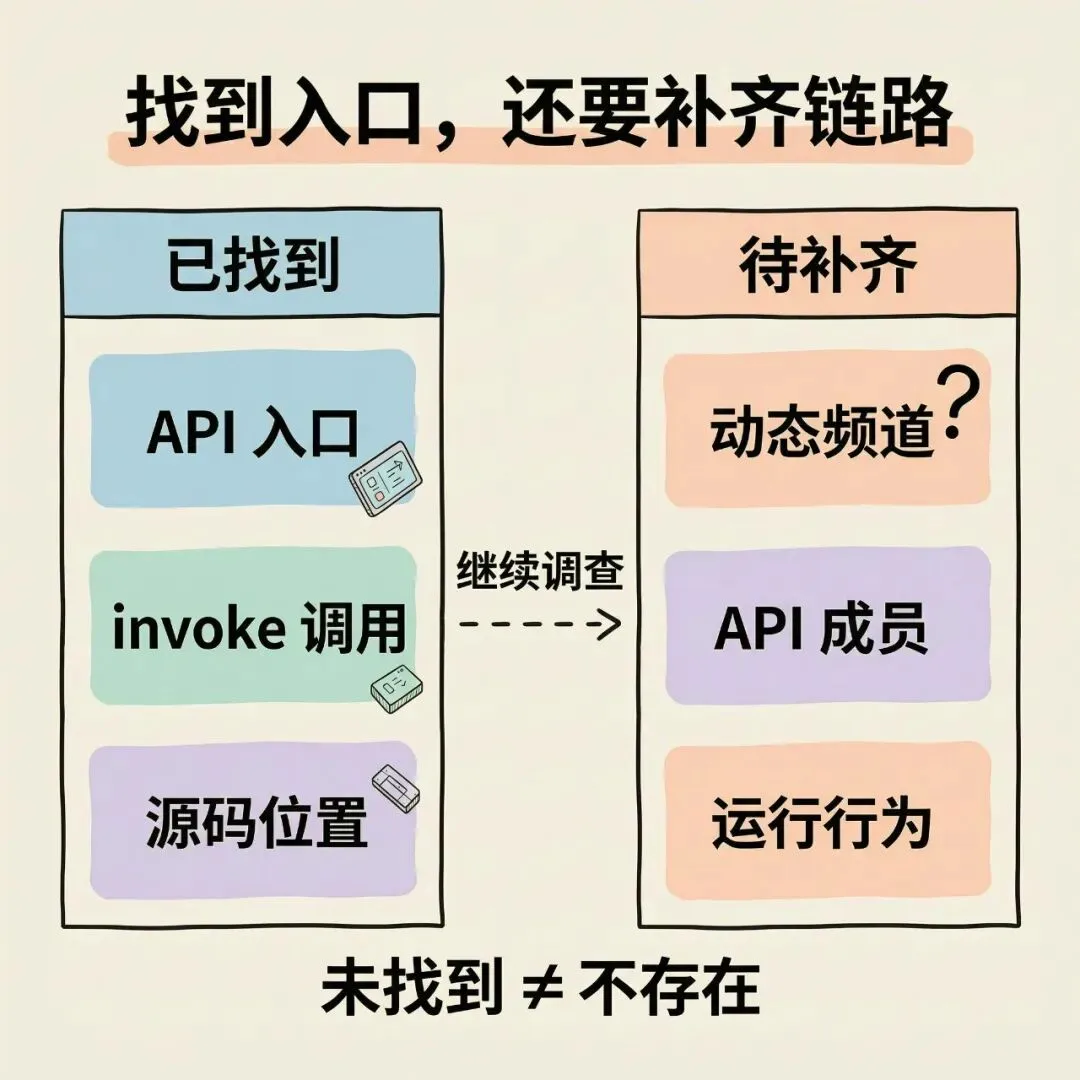
图解 2|找到入口,还要补齐链路局部静态结果定位了 API 与 invoke,但动态频道、成员和运行行为仍需补齐。未匹配到节点,不等于功能不存在。
3. 沿着一个频道,把页面接到系统剪贴板
继续读 preload,就找到了剪贴板成员的定义。项目公开案例把压缩变量展开、省略无关成员后,给出了这样的片段:
const clipboardApi = { write: invokerInMain("notion:clipboard:write")};这就有了一个明确的搜索目标:notion:clipboard:write。
再读 invokerInMain,可以看到它返回一个函数,把调用参数继续交给 IPC helper:
function invokerInMain(channel) { return (...args) => invokeInMainAndReturnResult(channel, ...args);}function invokeInMainAndReturnResult(channel, ...args) { return ipcRenderer.invoke(channel, ...args);}页面看到的 clipboard.write,背后因此多了一层转换:先把频道绑定进闭包,调用时再把数据发给主进程。
有了频道名,就可以去主进程的 bundle 找接收端。那里还有一层注册包装,最终使用 ipcMain.handle,对应的处理逻辑是:
handleRequestFromRenderer.addListener( "notion:clipboard:write", (event, data) => isNotionWebContents(event.sender) ? clipboard.write(data) : undefined);这里终于出现了 Electron 的剪贴板写入,也出现了发送方检查。来源符合条件时,处理函数才把传来的数据交给剪贴板 API。
一次页面调用,经过了 API 对象、preload 包装、IPC 频道与主进程接收端。相同的频道名把两侧连接起来,包装函数则解释了数据怎样穿过这几个边界。公开代码片段[3]
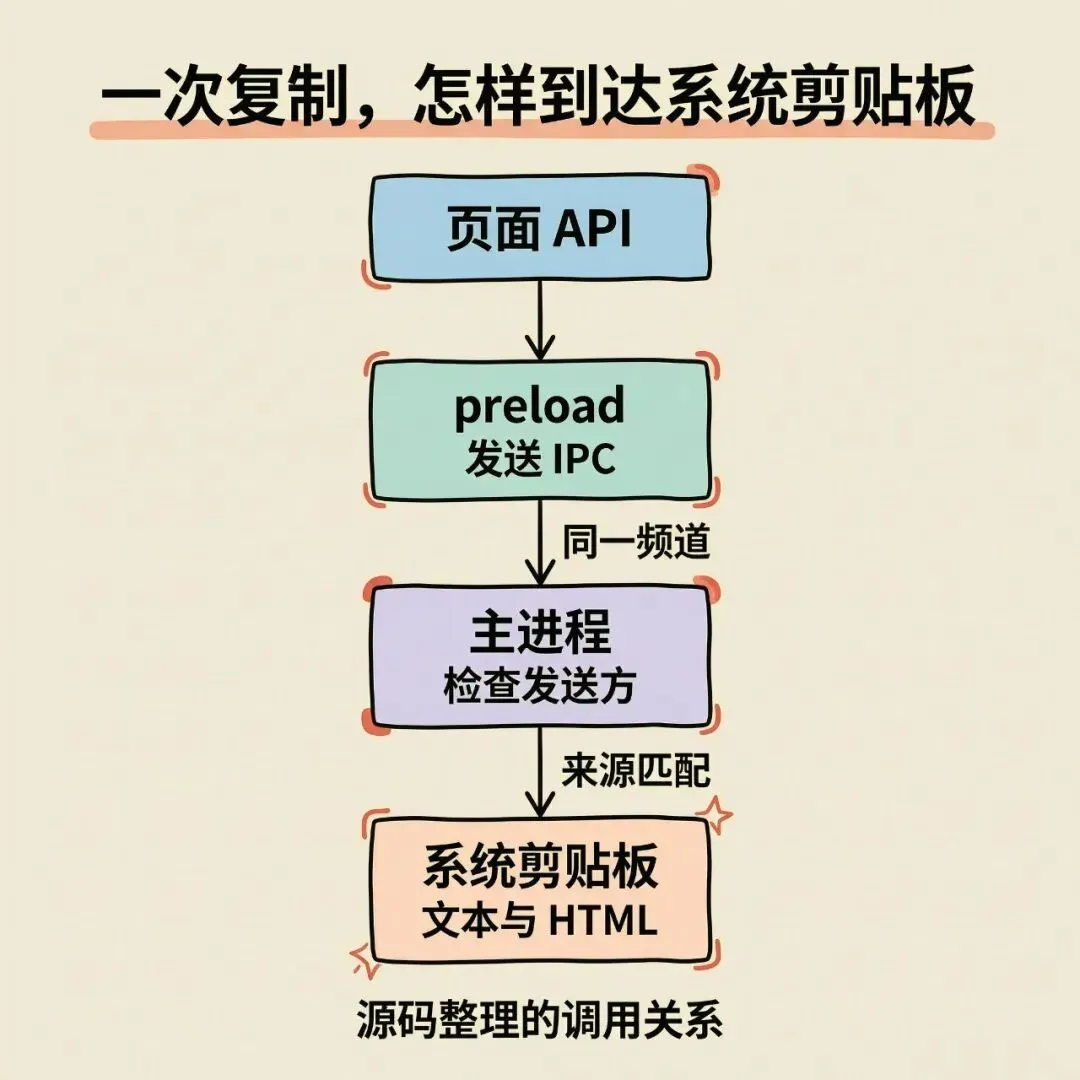
图解 3|一次复制,怎样到达系统剪贴板页面经 preload 发出 IPC,主进程接收后检查发送方,再调用剪贴板 API。频道 notion:clipboard:write 连接两端;这里展示的是源码阅读整理的关系。
这条路线结合了 REA 的位置线索与对代码的继续阅读。案例没有把它包装成自动追踪出的一张完整功能图,也没有声称这些片段来自一次被捕获的实际复制操作。
不过,问题已经推进了一步:我们知道了写入往哪里走,也知道了写入前有哪道检查。
接下来更有意思的,是那个 data 里面究竟有什么。
4. 块结构留在本地,剪贴板里放一个关联标识
如果只把文本写进剪贴板,普通文字已经足够。可要在编辑器里保留块结构,就还需要一份更丰富的数据。
项目案例中的历史 web-editor 模块,展示了这样一种组织方式:通用文本和 HTML 走系统剪贴板,专有的块数据另存在本地,复制 ID 把两者关联起来。
用“项目笔记”和一个示意 ID 表达,写给系统剪贴板的内容类似:
text: "项目笔记"html: "<p>项目笔记</p><!-- notionvc: <copy-id> -->"本地保存的复制数据,则带着对应 ID 和私有格式:
id: <copy-id>mimeTypes: text/_notion-blocks-v3-production → 结构化块数据<copy-id> 是说明用的占位符,不是一次实际复制的 UUID。关键关系是:HTML 里有一个标识,本地结构化数据也有一个标识。
粘贴时,读取 HTML 中的标识,再与本地保存的复制数据核对。匹配时,可以恢复私有块格式;本地条目过期或 ID 不匹配时,仍保留普通文本与 HTML。
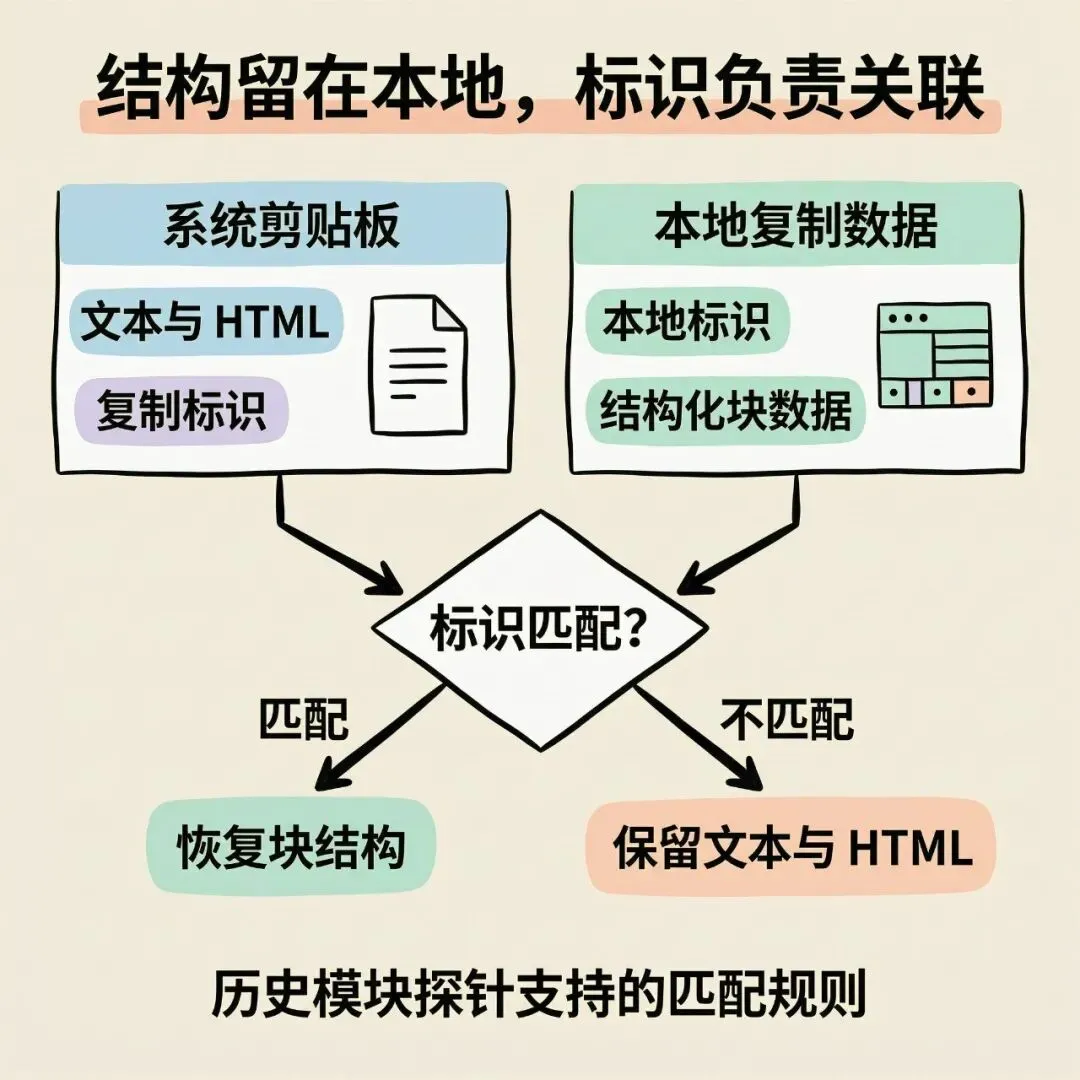
图解 4|结构留在本地,标识负责关联通用文本与 HTML 和本地块数据通过复制标识关联。历史模块探针支持标识匹配时恢复私有格式、旧条目失配时保留通用内容。
这样,普通接收方可以使用通用格式,了解私有结构的编辑器则有机会找回更丰富的数据。
ID 检查还避免了另一个问题。假设剪贴板已经换成新内容,本地却还保存着上一次的块数据,只检查“本地有数据”就恢复,可能把旧内容当成这次复制的结构。核对标识,才知道两份数据是否属于同一次复制。
这是从案例中可以借鉴的设计:为通用格式保留可用的退化路径,为专有结构保留明确的身份关联。
这部分依据是 2026 年 7 月 13 日缓存的 web 模块及已保存的 Node/JSDOM 探针。它与 Desktop 7.6.1 发布包是不同的制品身份;两侧名称能帮助解释分工,但不能合成同版本桌面应用的一次端到端实测。
5. 现在理解了什么,还需要验证什么?
沿着这个案例,我们得到的证据来自两个地方。
发布包静态分析和代码阅读,定位了桌面桥接路线;历史 web 模块探针,则检查了复制标识的匹配规则。
在记录的局部测试中,匹配 ID 的样本恢复了私有格式,旧本地条目的样本只保留文本和 HTML。探针使用提取模块、忠实展开的 helper 和替代环境 API,支持的是这条匹配策略,尚不能证明实际系统剪贴板写入或复杂块在桌面应用中的保真度。
如果要继续验证一个完整的复制粘贴功能,就可以按问题准备场景:
前两种有案例中的局部探针支撑。后两种,以及真实桌面应用的完整链路,仍需要相应实验。
REA 提供浏览器、Electron 和进程捕获等工作流。使用者声明目标、动作与观察项,工具记录指定条件下的行为,再把可比较的捕获交给比较工作流。页面状态和事件要按问题选择;涉及真实系统剪贴板时,还要准备能读取相应内容的观察或独立探针,不能用“点击成功”替代全部结果。运行场景契约[4]
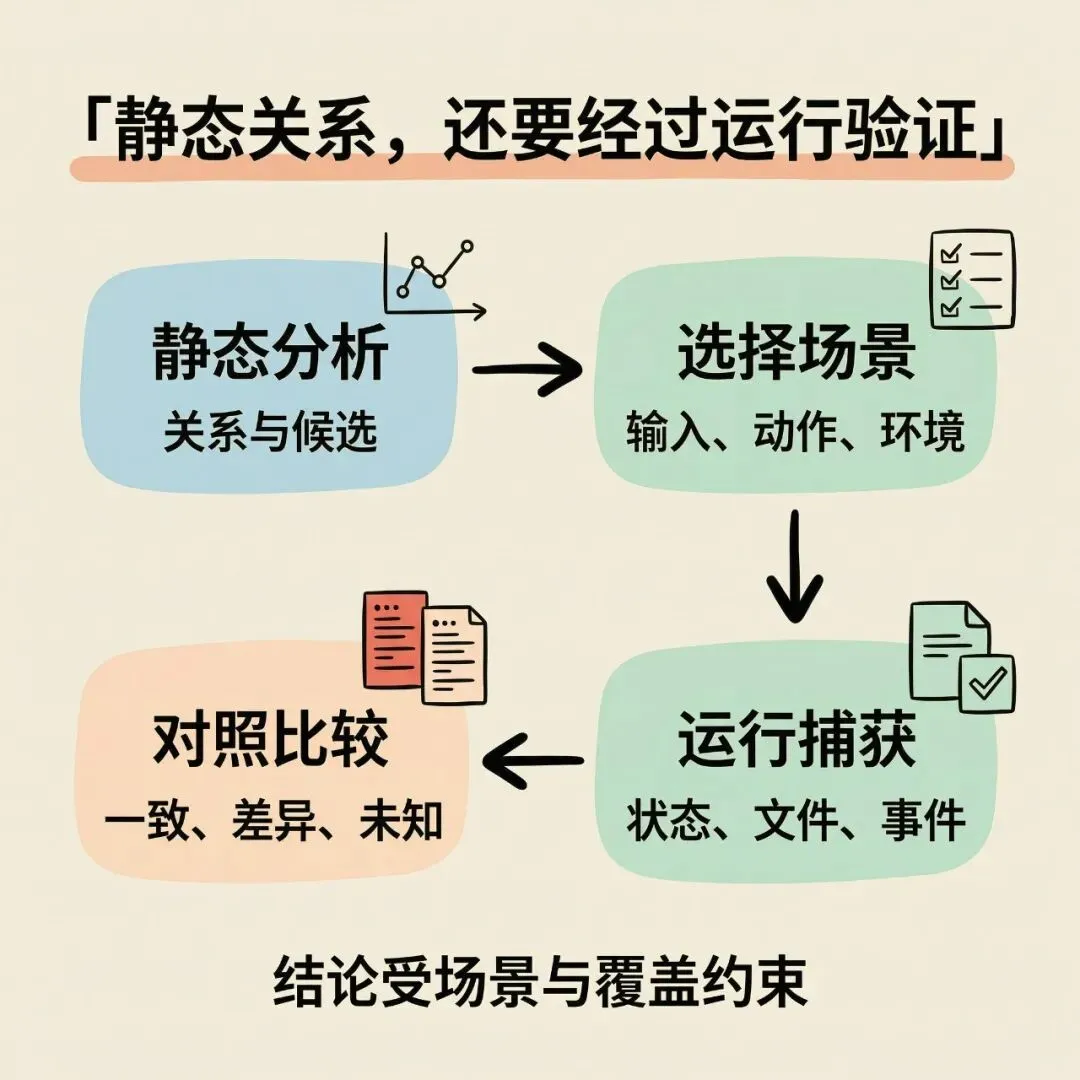
图解 5|静态关系,还要经过运行验证静态线索帮助选择场景,运行捕获记录具体条件下的行为。比较结论受场景、环境和覆盖范围约束。
也正因为来源不同,结果必须带着身份保存。
如果把桌面包的发现、几个月前缓存的 web 模块、一次局部探针都缩成一句“Notion 就是这样运行的”,版本、环境和验证范围就丢了。
REA 把分析记录组织成 Evidence。在 src/domain/evidence.ts 中,记录包含目标内容摘要、提供方、操作与参数、规范化结果、来源位置、判断类型、限制和前序证据链接。
observed、derived 与 inferred 要结合操作理解。从 AST 中直接识别出 invoke 是静态观察,不表示运行时发出过该消息;feature trace 的结果则明确使用推断类型,关联原始输入证据。Evidence 定义[5]
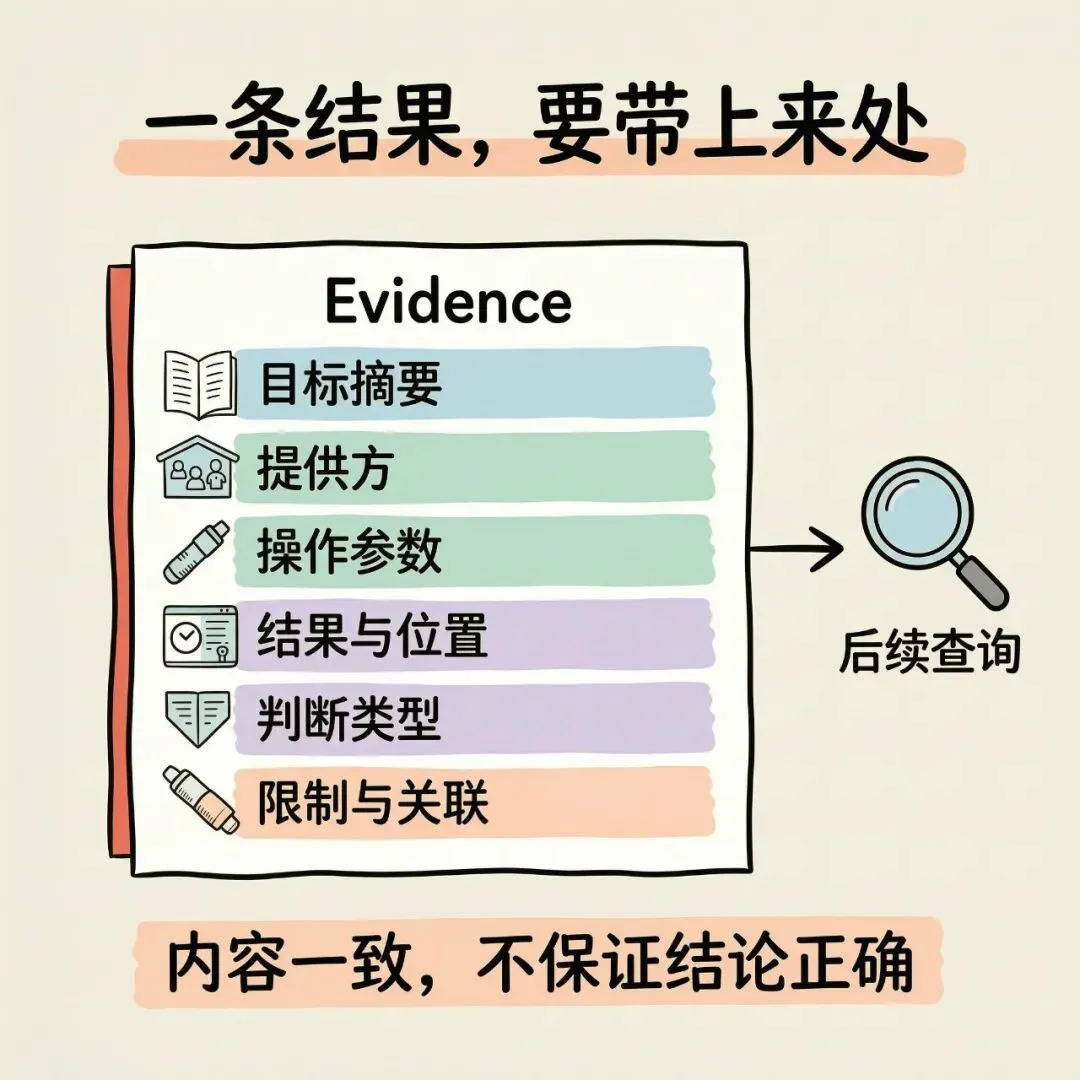
图解 6|一条结果,要带上来处Evidence 保留目标、提供方、参数、位置与限制,使后续查询能回到来源。内容摘要校验记录一致性,不能替代事实验证。
证据 ID 根据语义内容计算摘要,读取外部记录时重新核验,帮助发现记录身份与内容不一致。它校验的是记录一致性,不能替代事实验证。
MCP 连接里的 EvidenceLedger 还可以留存完整结果,让后续查询引用已有证据。大应用先看摘要,再通过 inspect_analysis_view 查模块或选定视图,既保留完整分析,也不必每次把全部结果塞进当前上下文。引用属于连接,close_binary 会清空留存;后续需要使用时,应先导出证据包。会话与留存契约[6]
证据不只是附在答案后面的材料。它还决定一个结论能适用于哪个目标、版本与条件。
6. 从这个案例,看 REA 的代码怎样组织
回到开源项目本身,会更容易理解它为什么分成几层。
CLI 与 MCP 负责不同调用入口。application 层共享分析、追踪、比较与证据留存工作流。提供方适配层连接具体引擎、格式解析和运行时观察。领域语义与契约定义各层共同遵守的事实和规则。架构图[7]
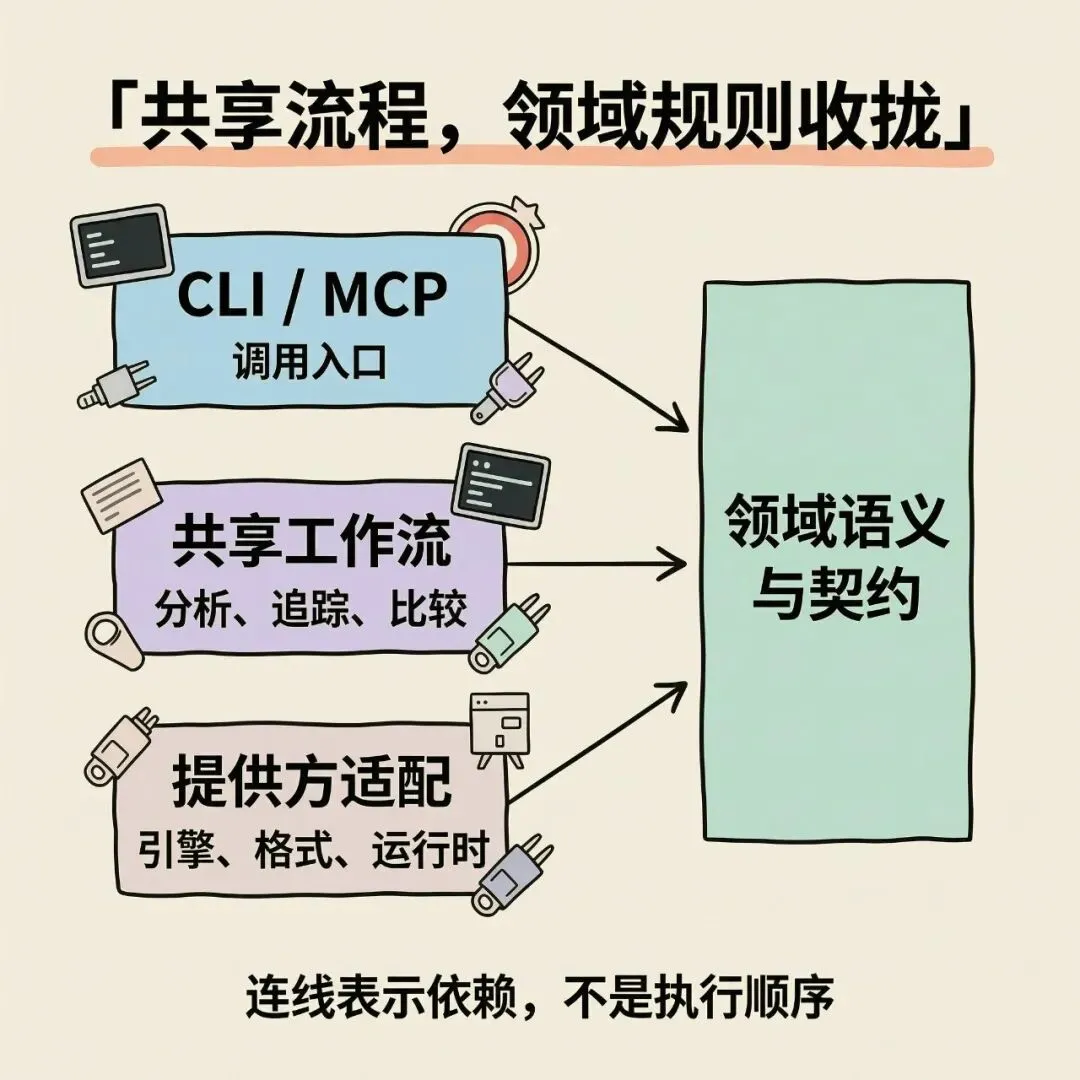
图解 7|共享流程,领域规则收拢CLI 和 MCP 共用工作流,具体协议留在提供方适配层,各层依赖领域语义与契约。连线表示依赖方向。
以 JavaScript 分析为例,CLI 与 MCP 都调用同一个 application service。制品读取、结果校验和 Evidence 创建在这里衔接,入口变化不要求另写一套分析逻辑。
它们的状态仍有区别:MCP 可以在连接里留存结果,单次 CLI 则依靠完整 JSON 记录继续工作。共享逻辑,同时保留各自的生命周期,是这里一个具体的工程选择。
公开工具也围绕调查问题组织:检查一个对象、发现候选、追踪关系、比较版本、捕获行为,分别承担不同任务。对于剪贴板案例,先拿到入口和源码位置,再沿着一个明确频道深入,就比把所有命令输出一次性发给模型更容易继续调查。工具设计说明[8]
未知也被当作可保存的工作项。记录里可以包含支持与反驳证据、需要的证据来源、建议探针及状态变化。动态频道未解析,就能留成下一步的问题;部分图中缺少某个节点,也不会自动升级为“确认不存在”。
这些设计可以迁移到数据库排障、日志分析或代码迁移:对象要明确,来源要保留,缺失覆盖要能表达,已有结果要能复用,下一步要指向一个具体缺口。
读源码时,可以从 evidence.ts 与 EvidenceLedger.ts 开始,再看 JavaScriptApplicationService.ts,最后追到 CLI/MCP 入口和提供方。先看一份结果怎样产生、校验与留存,再看工具目录,接口名字就有了上下文。
7. 把类似能力做进自己的编辑器,怎样验收?
理解这段复制机制后,我们可以给自己的块编辑器定一个清楚的目标:同时提供文本与 HTML,保存自有结构数据,用复制标识关联,并在无法恢复专有结构时保留通用内容。
具体块 schema 和私有格式可以由自己的产品定义。真正值得带走的是数据组织和身份检查的规则。
实现时,至少会出现几项要求:
• 文本与 HTML 写入后,普通接收方仍有可用内容。 • 标识匹配时,恢复的是对应那一次复制的结构。 • 本地条目过期、标记缺失或损坏时,退化行为清楚。 • 页面调用桌面能力时,保留规定的来源检查与权限边界。
这些要求要分别关联实现、用例和验证结果。一个 marker 解码函数测试通过,支持的是解析能力;要确认页面、IPC 与真实剪贴板协作正常,还要补上对应层次的运行证据。
REA 的 build_reconstruction_obligation_ledger 就把这类重建要求组织成可核对的清单。静态图产生候选义务;一项要求要闭合,还需要实现归属、规定用例,以及有对应证据来源和通过结果的验证器。缺失、矛盾或未解决问题会影响闭合。重建验收契约[9]
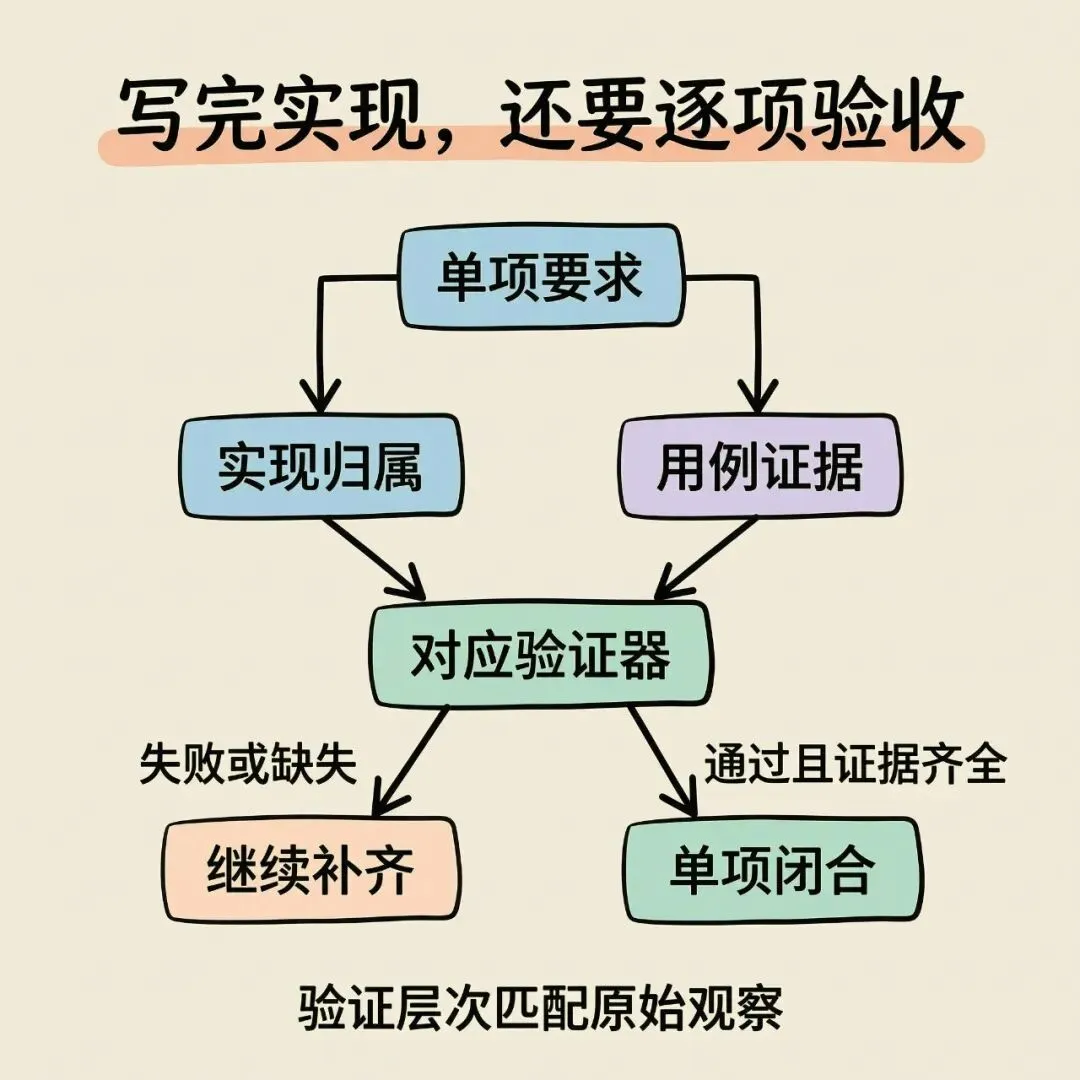
图解 8|写完实现,还要逐项验收一项要求对应实现、用例与验证证据。缺失或失败继续补齐,满足规定条件后才可闭合这一项。
验收目标和测试断言仍然需要设计。这份清单让“写完了什么”与“验证到了哪里”能对应起来,而不是仅凭一个函数存在,或一轮运行结束,就宣布功能完成。
沿着这个案例,可以把调查方法收束成五步:
确定目标:固定制品身份、版本与环境定位入口:找到 API、调用及源码位置沿线补齐:读包装函数,连接明确的对象与关系验证分支:为匹配、失配和错误路径准备场景逐项验收:关联实现、用例、结果和剩余问题最初,我们只知道按下复制后,希望另一端保留内容和结构。沿着接口、频道与数据标识往下走,才逐渐看到了三个不同问题:请求怎样到达桌面能力,结构怎样另行保存,两份数据怎样确认属于同一次复制。
REA 的价值,是把这样的调查组织成可以持续调用、回到来源、保留缺口的工作流。模型的解释因此有具体依据,实现也有了可以逐项验证的目标。
让 AI 理解一个应用,要让它沿着真实证据把问题问下去,也让最后的实现接受对应行为的验收。
参考资料
• REA:项目仓库[10]、本文对应源码提交[11] • REA:Notion 剪贴板案例页面源码[3]、案例来源与范围[2] • REA:JavaScript 应用工作流[12] • REA:Evidence 契约[5]、EvidenceLedger[13] • REA:MCP 会话与结果契约[6] • REA:架构图[7]、MCP 工具设计[8] • REA:浏览器场景契约[4]、进程捕获[14] • REA:重建验收清单[9]
引用链接
[1] 项目说明: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/README_zh.md[2] 案例来源与范围: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/website/evidence/notion-clipboard.md[3] 公开代码片段: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/website/public/showcase/notion/index.html[4] 运行场景契约: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/docs/browser-scenario-contract.md[5] Evidence 定义: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/src/domain/evidence.ts[6] 会话与留存契约: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/docs/mcp-contracts.md[7] 架构图: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/docs/architecture.mermaid[8] 工具设计说明: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/docs/tool-design.md[9] 重建验收契约: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/docs/reconstruction-obligation-ledgers.md[10] 项目仓库: https://github.com/morluto/rea[11] 本文对应源码提交: https://github.com/morluto/rea/tree/e4407dbed5dc24851f47532f5e3d75d5627d3e7d[12] JavaScript 应用工作流: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/docs/javascript-application-workflows.md[13] EvidenceLedger: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/src/application/investigation/EvidenceLedger.ts[14] 进程捕获: https://github.com/morluto/rea/blob/e4407dbed5dc24851f47532f5e3d75d5627d3e7d/docs/process-capture.md