ARTICLE · 1168160
Excel的边界:当数据量、整合与自动化超出能力时,为什么需要SQL?
前面七篇,我们从数据清洗、查找匹配、条件统计,一路走到透视表、图表和综合实战。有朋友说:“跟着走了一遍,感觉Excel能干的事比我想象的多。”
确实,Excel是数据分析的起点,但它不是终点。
今天这篇,我们不学新函数,而是聊一个更重要的问题:Excel的边界在哪里?什么时候该换工具?
一、先承认:Excel解决了很多问题
在前面几篇的案例里,我们用Excel完成了:
数据清洗:分列、去重、处理空值
查找匹配:把多张表拼在一起
条件统计:按多个条件求和、计数
多维度汇总:透视表拖拽出各种分析角度
可视化:折线图、柱状图、饼图
完整报告:从原始订单到业务日报
这些场景,Excel都处理得很好。对于几万行以内、以探索和呈现为主的数据,Excel的灵活性和直观性,甚至比写代码更高效。
但现实工作中,数据不会永远停留在几万行,需求也不会永远只是“手动看一份表”。
二、Excel的三个硬伤
(一)硬伤一:数据量一大就卡
Excel工作表上限约104万行(1,048,576行),但实际使用中,在复杂公式、全列VLOOKUP、数组公式、条件格式、透视缓存较多时,10万行以上就可能明显变慢。几十万行时,打开文件要等,筛选要等,透视表刷新要等,公式重算要等。
这不是Excel的问题,是设计定位决定的。传统本地Excel是桌面工具,计算主要在你的电脑上完成,内存和CPU是瓶颈。
需要说明的是,Power Pivot/数据模型可以承载超过工作表行数的数据,但仍受内存限制;如果Excel连接数据库或云端数据源,计算也不一定都在本机完成。
(二)硬伤二:数据分散,难以整合
真实工作中,数据很少在一张表里。订单在订单系统,用户在用户系统,商品在商品系统,日志在日志平台。Excel只能通过手动导出、复制粘贴、VLOOKUP匹配来整合。
如果每天都要重复这个流程,不仅耗时,还容易出错。
更准确地说,跨系统整合通常需要ETL、数据仓库、数据湖、联邦查询等能力;SQL往往是这些环节里用来查询和加工数据的语言,而不是数据集成工具本身。
(三)硬伤三:协作与自动化困难
多人同时编辑一个Excel文件,虽然Microsoft 365支持共同创作和版本历史,但版本冲突、覆盖、误改仍然常见。
数据更新后,透视表和图表通常需要手动刷新或打开时刷新,实时自动化能力弱。
每天重复同样的清洗和汇总,很难自动运行,需要调度器、ETL或BI平台配合。
权限控制方面,Excel虽然有工作表保护、IRM、敏感度标签、SharePoint/OneDrive权限,但相比数据库和BI的行级权限,细粒度控制仍然较弱。
这三个硬伤,在日常分析中会越来越明显。
三、一个分水岭:什么时候该用SQL?
不是所有分析都需要SQL。判断标准不是单一的“行数”,而是数据量、数据位置、更新频率、协作方式和计算复杂度的综合。下面是经验法则,不是绝对标准:
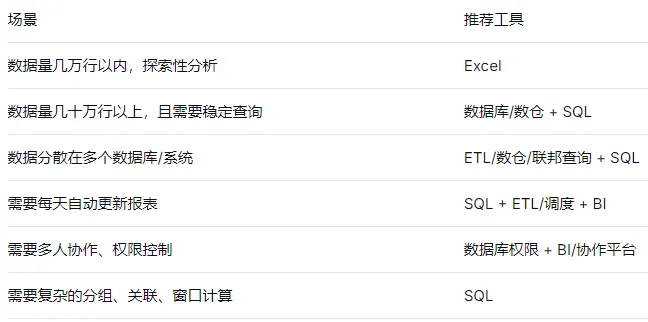
记住一个更准确的原则:
Excel擅长小数据量下的交互式探索和呈现;
SQL擅长在数据库内做集合查询、聚合和复杂关联。
当数据在数据库里,你不需要把它全部导出来再用Excel处理。你可以直接在数据库里完成清洗、筛选、聚合,只把需要的结果取出来。这样通常更快,也不容易把电脑卡死。
四、Power Query:Excel的“自动化清洗”补丁
在正式进入SQL之前,有一个工具值得了解:Power Query。
它是Excel内置的数据处理工具(Excel 2016+内置;2010/2013需要单独安装插件),定位是“轻量ETL”。你可以把它理解为一个“自动化的清洗流水线”:
从多个来源(Excel、CSV、数据库、网页)导入数据
记录每一步清洗操作:删列、筛选、替换、分组
下次数据更新后,一键刷新,所有步骤自动重跑
大部分清洗不需要写代码,但高级转换需要写M语言
如果你的工作场景是:数据量不算太大,但每天/每周都要重复同样的清洗流程,Power Query是一个很好的过渡工具。
但它也有边界:数据量大了会卡,复杂逻辑不如SQL灵活,多表关联虽然能做内、左、右、全、反连接,但在大数据量和复杂场景下不如SQL。所以它不能替代SQL,但能帮你从“手动清洗”过渡到“自动化清洗”。
五、SQL能解决什么问题?
SQL(Structured Query Language)是专门用来和数据库对话的语言。它解决的核心问题是:
从海量数据中,精准、快速地取出你需要的部分。
(一)用生活化的场景类比:
Excel是你家的冰箱,里面放着你一周的食材,你随时打开翻找。
数据库是大型超市的仓库,有几万种商品。你不可能把整个仓库搬回家,但你可以告诉仓库管理员:“给我拿三斤五花肉、两把青菜、一瓶酱油。”
SQL就是你跟仓库管理员说的那句话。
(二)用SQL,你可以:
从几百万行数据里,筛选出符合条件的那部分(在合理索引和数据库配置下通常很快)
把多张表按关联字段拼在一起
按任意维度分组汇总
计算排名、累计、同比环比(通常依赖窗口函数,旧版MySQL等不支持)
把复杂逻辑写成可复用的查询
为报表每天自动更新提供取数逻辑(自动运行还需要调度/ETL/BI)
这些能力,是Excel很难做到的。
六、从Excel到SQL,思维要转什么弯?
Excel是“所见即所得”:你看到单元格,直接操作。SQL是“先描述,再获取”:你先写清楚要什么,然后数据库返回结果。
这个思维转变,是初学者最大的门槛。但一旦转过来,你会发现SQL的逻辑其实很清晰:
Excel里,你用鼠标筛选、排序、透视。
SQL里,你用WHERE筛选,用ORDER BY排序,用GROUP BY分组。
两者只是表达方式不同,背后的分析逻辑是一样的。
七、一个过渡案例
假设你要分析“华东区9月销售额”。
(一)Excel做法:
导出订单表到Excel。 筛选区域为“华东区”。 筛选日期为9月。 用SUMIFS求和,或用透视表汇总。 做图表,写报告。
(二)SQL做法:
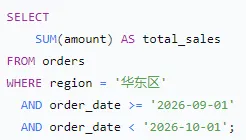
这里假设region字段的值就是“华东区”,order_date是日期或日期时间类型。一行查询,直接返回结果。数据量再大,在合理索引和数据库配置下通常也很快。而且这个查询可以保存下来,下个月改一下日期,直接复用。
八、初学者常见的误区
(一)误区一:觉得SQL很高深,不敢开始
SQL的基础查询非常接近自然语言。SELECT ... FROM ... WHERE ...,读起来就像英语句子。
(二)误区二:想把Excel的所有操作都用SQL实现
SQL擅长取数和聚合,但格式调整、图表呈现,还是Excel和BI更合适。两者是配合关系,不是替代关系。
(三)误区三:以为必须先把Excel学到精通才能学SQL
Excel能帮你快速建立分析逻辑,但它不是绝对前置条件。直接学SQL也可以,只是需要同时补业务理解和统计基础。没有分析逻辑,写SQL也只是在翻译需求,而不是在分析。
(四)误区四:学了SQL就丢掉Excel
实际工作中,SQL取数 + Excel/BI呈现,是最常见的组合。两个都要会。
Excel和SQL不是对立的,而是数据分析工具箱里的两把工具。
Excel让你灵活探索,SQL让你高效取数。
数据量小、以探索和呈现为主的时候,Excel够用;数据量大、数据在数据库里、需要稳定整合和自动化时,通常要用数据库/数仓 + SQL + ETL/BI的组合来补位。
从下一篇开始,我们正式进入SQL模块。不用担心,我们不会一上来就讲复杂的语法。我们会从“数据库是什么”开始,用Excel做类比,一步步走进SQL的世界。
你目前工作中,数据量大概是什么级别?是几千行、几万行,还是几十万行以上?有没有遇到过Excel卡死、文件打不开的情况?欢迎在评论区描述你的场景。