ARTICLE · 1168330
用AI自动化做的第一批公众号推文
以下内容你读起来肯定觉得怪怪的,确实是这样的,因为它是我让Codex把我和它的聊天记录整理成了一篇文章放到了这里,本来想删掉的,但想了一下,做一个纪念也挺不错。除了头条这里的这段手写的文字,其它内容都是AI自动抓取公开网络资料后写的内容,头条之外的那些老师们的介绍,就当福利送给兄弟们了。这个公众号的目的主要就是我测试AI自动化能力的试验场,我将尽力让AI定时自动搜集资料、自动分析发布我所感兴趣的内容:我关注的生命科学领域以及AI在其中的应用。
睿思AI · 工作流实践
从一场对话开始:公众号自动入稿的真实边界
把重复操作交给自动化,把内容判断留给人。这次,我们从一段真实的人机协作对话,重新梳理公众号内容工作的目标、边界与验收方法。
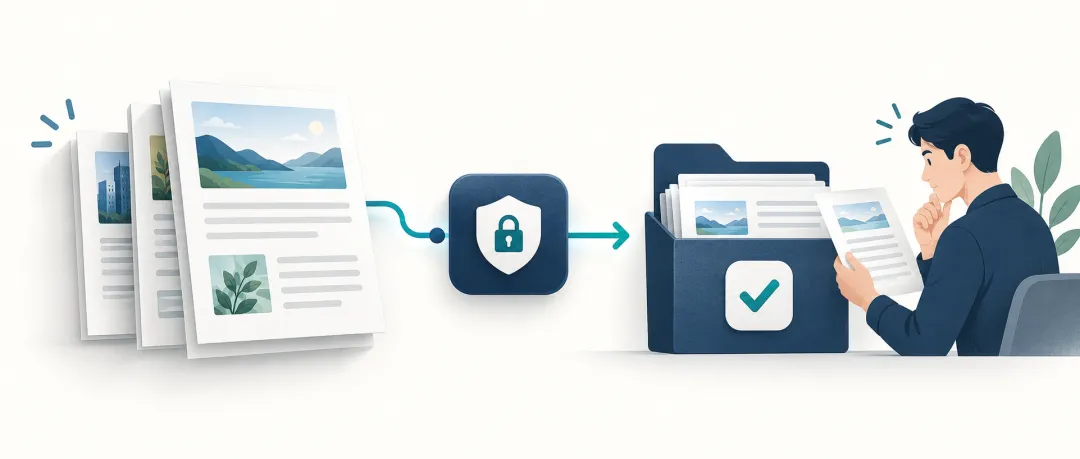
图|从文章材料到待审核草稿的工作流示意。AI 辅助生成的概念配图,不代表接口流程已经全部跑通。
我们真正想实现的,是把准备好的文章整理、排版并存入草稿箱,再由人确认。自动入稿、手机预览、正式发表和向粉丝群发,应当分别验收。
01 先把目标说清楚
起点是一个很常见的需求:文章已经写好,可能来自 Word、HTML、授权链接或直接粘贴的文字,希望有人把标题、正文、图片和封面整理成一条多篇图文,留在公众号后台等待审核。
这项工作包含的不只是“复制粘贴”。文章顺序要正确,图片不能遗漏,图注应紧贴对应图片,表格要便于手机阅读,封面也不能只剩原图中一个无意义的局部。对于文献解读,还必须保留研究设计、关键证据和局限,不能把“少写重复文字”误解为删除重要信息。
因此,我们把日常批次约定为八篇,按明确顺序组装;而本篇只是单篇接口验收稿。它的作用是检验接入流程,不能替代整批八篇的验收。
02 页面能打开,不等于自动操作能完成
此前的尝试中,后台页面曾经可以人工打开,也有过通过浏览器保存草稿的记录。但后续自动操作收到了站点安全策略拒绝。即使在个人设置里将网站设为允许,自动访问仍未恢复。
浏览器显示页面、智能体获得操作权限、网站接受一次具体操作,是不同的环节。仅凭一条报错,不能断言是网站封禁、账号权限不足,或某个代理设置导致。
排查中还出现过局域网 DNS 请求经过代理后超时的日志。它说明某次网络连接失败,却不足以证明这就是站点安全审核拒绝的原因。排查需要把时间、请求对象和返回结果对应起来,避免把同时出现的现象当成因果关系。
03 重新评估官方接口这条路线
讨论随后转向一个更清晰的问题:对于具备相应权限的服务号,能否由正式授权的接口完成素材上传和草稿写入,再由运营者在后台审核?
实施思路是:先验证账号凭据与调用环境,再处理正文图片和封面,构建排好版的文章内容,最后创建草稿并读取返回结果。账号认证、具体接口权限、图片要求和批次限制,都需要结合当前文档及实际返回逐项核实。
拟采用的流程
整理来源与内容 → 统一图文排版 → 准备正文图与封面 → 调用官方草稿接口 → 回读核验 → 人工审核
官方接口也不是把任意网页原样搬进后台的保证。正文样式需要在微信实际渲染环境下检查;后台已有模板能否直接被接口选择,尚未验证,不能提前承诺。这里的目标是稳定保留文章结构和阅读体验。
04 第一次接口检查,得到一个明确阻点
在获得账号信息和本地密钥文件的授权后,我们进行了正式接口认证检查。微信返回的结果是:本次请求的出口地址不在账号的 API IP 白名单中,认证未完成。
这次返回比笼统的“打不开”更具体。下一步应确认实际执行环境及其稳定出口,再由管理员核对白名单。本文不公开具体地址,也不展示任何密钥、访问令牌或内部文件路径。
管理员补充白名单后,接口认证及草稿读取检查已经通过。这说明调用链向前推进了一步,但认证成功不等于完整入稿成功。素材上传、草稿创建与回读需要继续逐项验证,八篇批次更应单独验收。
05 什么才算“做成了”
可靠的验收应能回答这些问题:后台是否确实出现目标草稿?标题与正文是否一致?正文图片是否完整可见?封面主体是否保留?修改是否写回正确篇目?失败后是否保留已完成内容,并避免生成重复草稿?
日常八篇批次还要检查文章数量、排列顺序及手机端阅读效果。只有凑够八篇并核对无误后,才进入约定的预览步骤。预览通过,也仍然保留人工决定是否发表或群发的环节。
这次实践的价值
自动化的价值,不只是省下几次点击,而是让输入、输出、错误位置和完成标准都可以核对。我们会继续推进,但每一项“已完成”,都应有对应的实际结果。
编辑说明:本文根据一次真实工作对话整理,经过去重与隐私处理,并非逐字聊天记录。排查中的推测未写成确定结论;接口功能以账号实际权限和当时的官方规则为准。