ARTICLE · 1177726
学习笔记丨MaxKB PPT/PDF文档整页转图工作流知识库方案
在企业知识管理实践中,长期存在如何有效利用沉淀在PPT和PDF文档中业务知识的难题。产品方案、投标材料、技术白皮书、培训课件——这些文档的共同特征是图文混排、版式复杂,难于高效利用。当我们尝试用AI知识库去处理这些文档时,传统RAG方案往往不尽如人意:多栏版式处理错乱、表格信息难以提取、架构图存在几何信息盲区,其问题根源并非是解析精度不足,而在于“文本化”路径本身就缺失了视觉维度的关键信息。
以MaxKB为代表的开源知识库平台,正在尝试破解这一难题。本文为您介绍一种基于MaxKB实现的视觉模型(VLM)的PPT/PDF整页转图方案。该方案尝试解决复杂文档在纯文本抽取路径下的失真问题,摒弃了传统的纯文本切分逻辑,转向对整页视觉信息的全量解析。
一、方案选型
要实现让AI看懂PPT和PDF文档的目标,本地渲染服务首先将PPT或PDF的每一页渲染为高清图像,再交由多模态视觉模型进行逐页多维特征提取,完整识别并理解页面中的文本、图表、原生图形、箭头指向及色块层级结构,最终将结构化理解结果写入知识库。在用户检索阶段,语义匹配直接命中目标页面,实现“精准答案+页面截图+原文定位”的联合输出。这一方案适用于以下高频复杂图文场景:
■ 解决方案输出:历史投标PPT入库,AI给出答案并定位至方案具体页面进行回复;
■ 制造业文档知识库:产品规格说明书、工艺手册PDF入库,产线人员用自然语言查技术参数;
■ 政务、教育与医疗领域的专业文档管理:政策汇编、教学课件、诊疗指南等典型图文混排场景。
我们将MaxKB PPT/PDF文档整页转图方案与其他同类技术路径进行多维度横向对比,核心差异如表1所示。
表1 PPT/PDF整页转图相关方案核心能力对比
对比维度 | MaxKB | MinerU-API | Coze |
PPT图形理解 | 视觉模型完整理解 | 仅抽取文字,图形丢失 | 依赖内置解析器 |
PDF多栏/表格解析 | 整页理解,布局完整 | 常出现顺序错乱 | 受限于解析器 |
私有化部署 | 全链路内网闭环 | 支持私有化部署 | 仅提供SaaS方式 |
数据安全 | 数据不出用户机房 | 需外调模型 | 数据上公有云 |
故障隔离 | 容器内独立渲染 | 解析故障影响问答链路 | 依赖平台SLA |
二、技术架构解析
MaxKB PPT/PDF文档整页转图工作流知识库方案的核心实现链路可以归纳为:文档上传→渲染转图→视觉模型解析→一页一段入库→自然语言检索。
1. 系统架构
本方案采用“MaxKB编排层、渲染服务层、AI模型层”三层解耦架构设计。各层级均支持独立部署,层间通过HTTP协议进行松耦合协同:
■ MaxKB编排层:负责工作流定义和状态流转,不执行重计算任务;
■ 渲染服务层:基于独立Docker容器构建的高性能转换服务,提供标准化的REST API;
■ AI模型层:视觉模型(VLM,例如Qwen-VL-Max)负责逐页理解并生成结构化描述。Embedding模型负责向量化。模型选型通过环境变量配置,不进行硬编码。
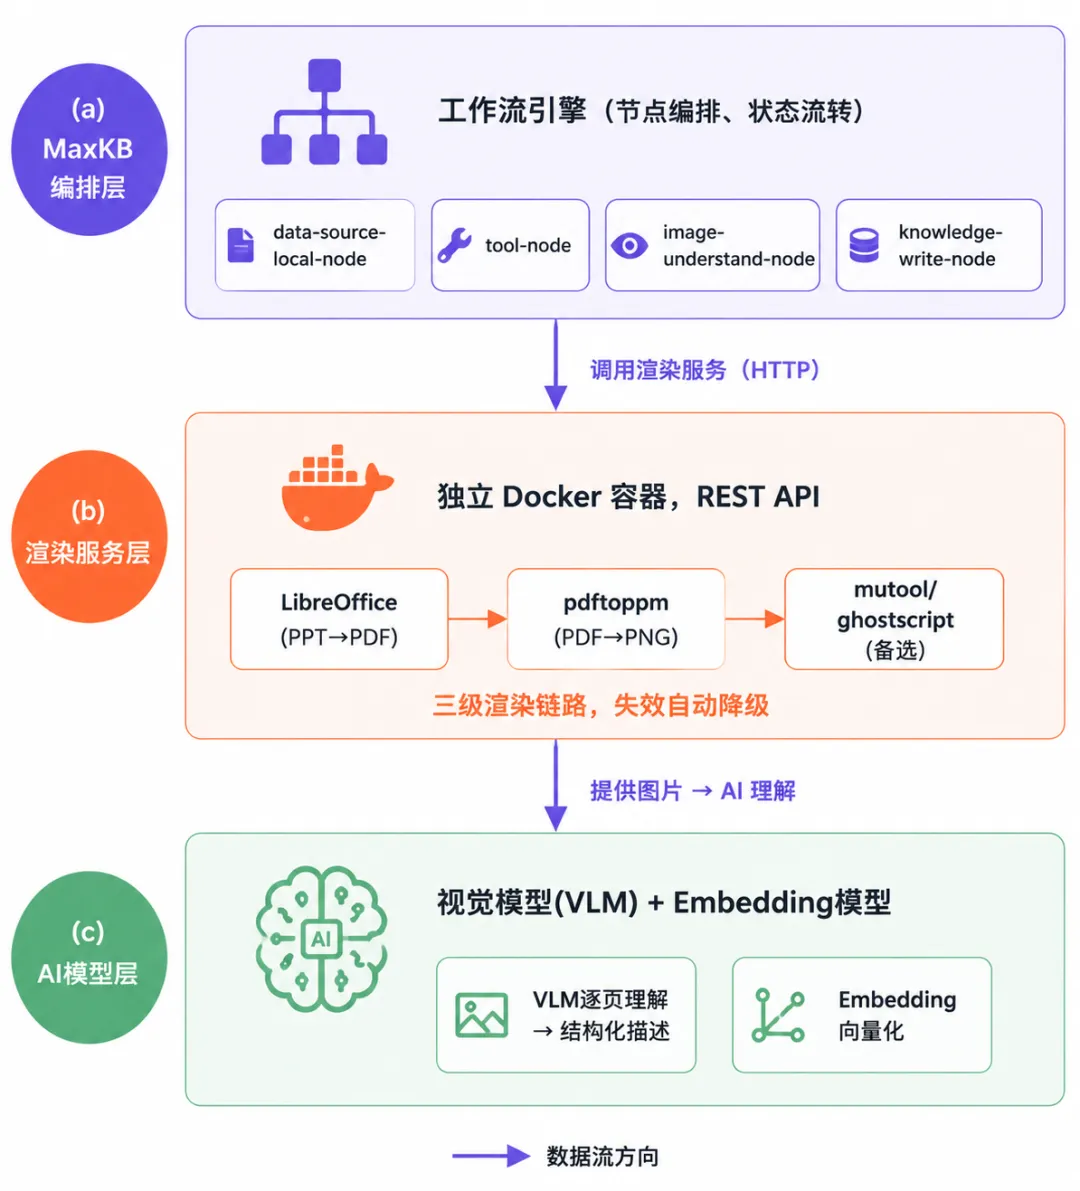
▲图1 MaxKB PPT/PDF文档整页转图方案系统架构
从文档上传到最终精准检索,文档整页转图工作流的全链路分为渲染、AI理解、知识库检索三个阶段,涵盖10个标准化步骤,具体如图2所示。
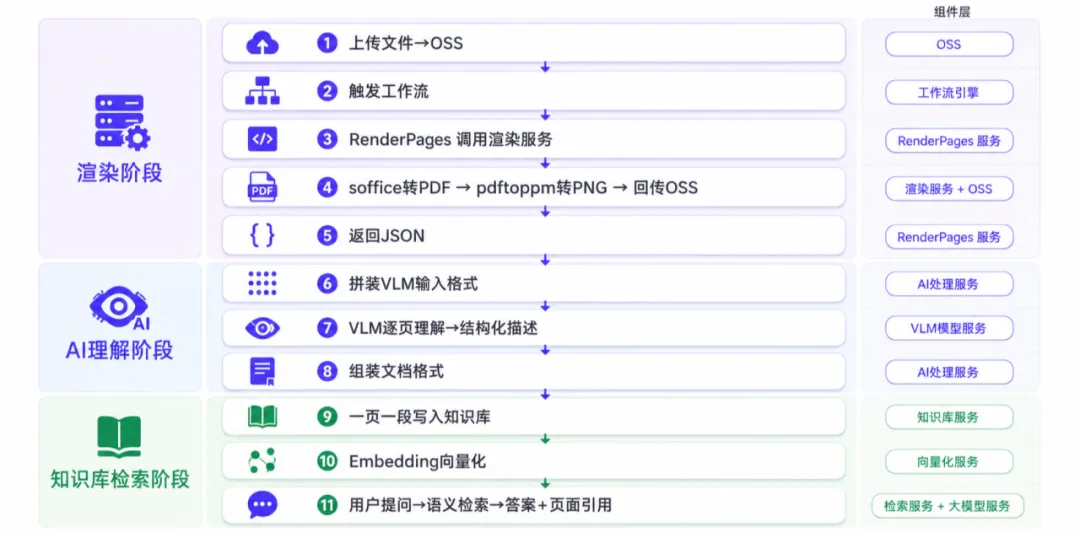
▲图2 MaxKB PPT/PDF文档整页转图完整数据流流程图
2. 关键技术决策分析
MaxKB PPT/PDF文档整页转图方案的形成,绕不开对渲染、理解、入库三个环节的取舍:
■ 拆分为独立渲染服务:MaxKB的tool-node运行在受限沙箱,无法安装LibreOffice、Poppler等系统级工具。此外,选用独立容器还能同时获得依赖隔离、故障隔离、独立扩缩与跨环境一致性四方面的收益;
■ 整页转图而非抽取嵌入图片:PPT里最有价值的架构图、流程图、SWOT分析,大多是“方框+箭头+文本框”拼出的原生图形,不是嵌入图片,抽不出来;即便抽出,也会丢失箭头方向、色块层级、标题与图表的位置关系等布局线索;
■ “一页一段”而非按字数切分:传统RAG按照字数切分,致使标题与核心内容容易被分入两段,从而引发检索命中时上下文断裂的问题。本文方案将每个PPT页面作为一个独立检索单元进行切分(页面标题+页面摘要+页面图片URL),保证用户命中的是语义完整的知识片段。
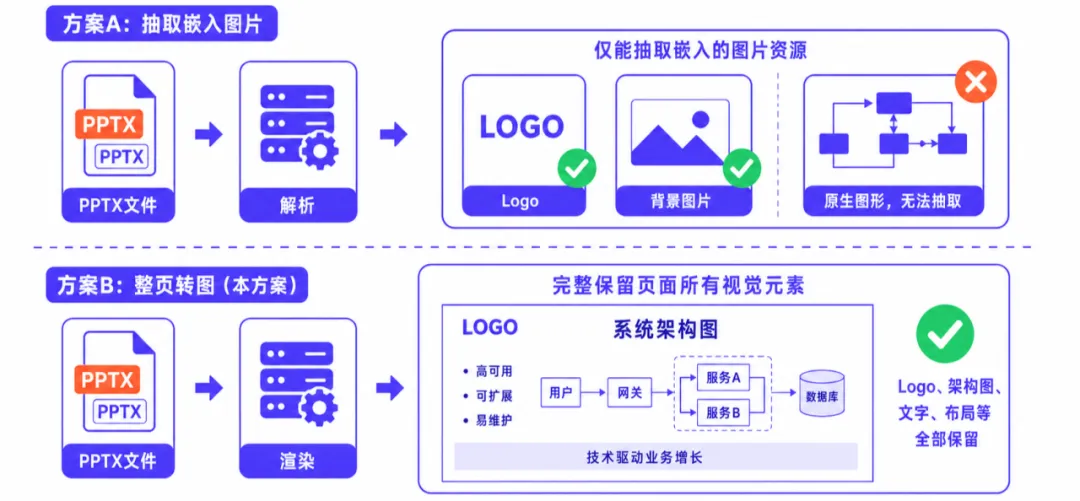
▲图3 整页转图方案与常见方案优势对比
三、效果验证与性能参考
在本地显示分辨率为160 DPI、渲染容器配置为8核16GB、引入Qwen3-VL-Flash模型的环境下,本方案的实测数据如表2所示。
表2 MaxKB PPT/PDF文档整页转图方案文档处理耗时参考
文档规格 | 处理耗时 | 说明 |
20页PPT(含文字图片架构图) | 约为40-60秒 | 大部分时间进行模型推理 |
50页PDF(双栏白皮书) | 约为4-5分钟 | 渲染和模型推理各占约一半时间 |
100页PPT(图文混排) | 约为10-20分钟 | 大文件处理建议调低DPI |
注意:以上为单文件串行处理表现,批量处理建议通过外部脚本串行调用。
完成文档导入后,在问答界面以自然语言提问,AI返回的不仅是文字答案,还会附上对应页面的截图与页面说明。实际复杂图文文档入库分段效果如下:
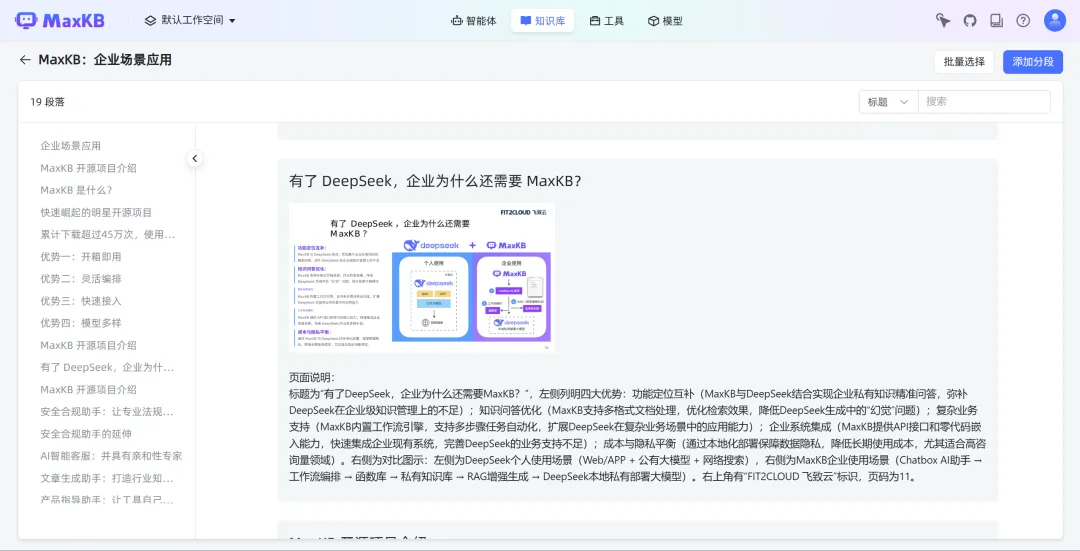
▲图4 复杂图文文档解析入库分段效果展示
四、方案部署
1. 环境要求
MaxKB PPT/PDF文档整页转图方案部署涉及两套环境,需要提前确认硬件软配置是否符合要求:
■ MaxKB侧:MaxKB v2.10.0 LTS版本或更高,并且已经配置LLM+Embedding+视觉三类模型和用于下载原始文件和回传页图的Bearer Token的管理员API Key;
■ 渲染服务宿主机:Linux AMD 64或ARM 64处理器、Docker 20.10以上版本,磁盘空间大于等于10GB,与MaxKB实现网络互通(也可以直接安装在MaxKB所在服务器)。
2. 操作步骤
第一步:启动渲染服务
1. 加载镜像(约1.2GB)sudo docker load -i ./maxkb-render-service_latest_linux-amd64.tar2. 验证加载成功sudo docker images | grep maxkb-render-service3. 准备 service 目录mkdir -p ./maxkb-render-service/data ./maxkb-render-service/logscp service/docker-compose.yml ./maxkb-render-service/4. 启动容器cd ./maxkb-render-service上传service文件夹里面的相关文件docker-compose -f docker-compose.yml up -d5.健康检查curl http://127.0.0.1:8085/health预期:{"code":200,"message":"ok","data":{"status":"ok"}}
第二步:导入工作流
相关工作流如图5和图6所示。对于超过60页的PPT/PDF文档,建议使用带循环版本的工作流。
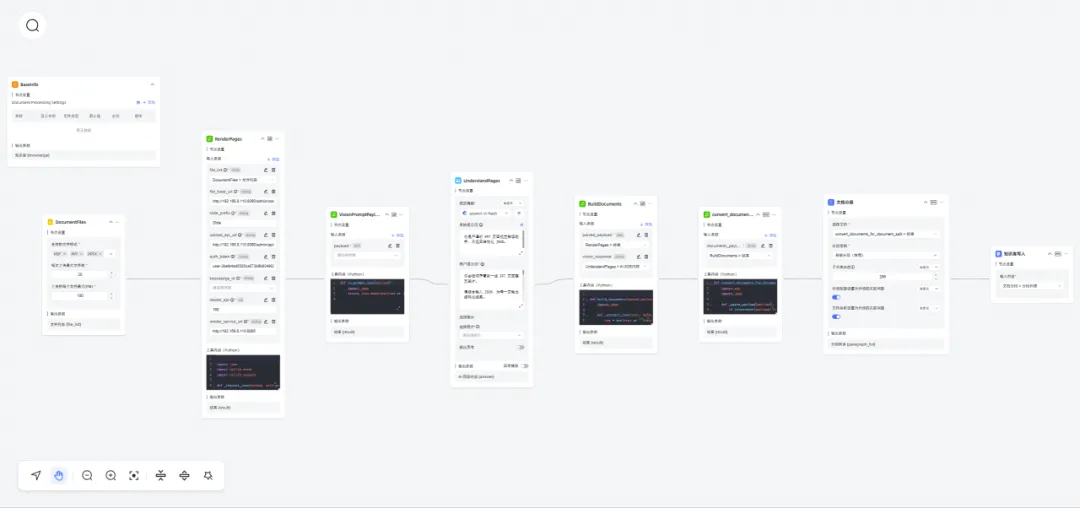
▲图5 MaxKB PPT/PDF文档整页转图工作流知识库
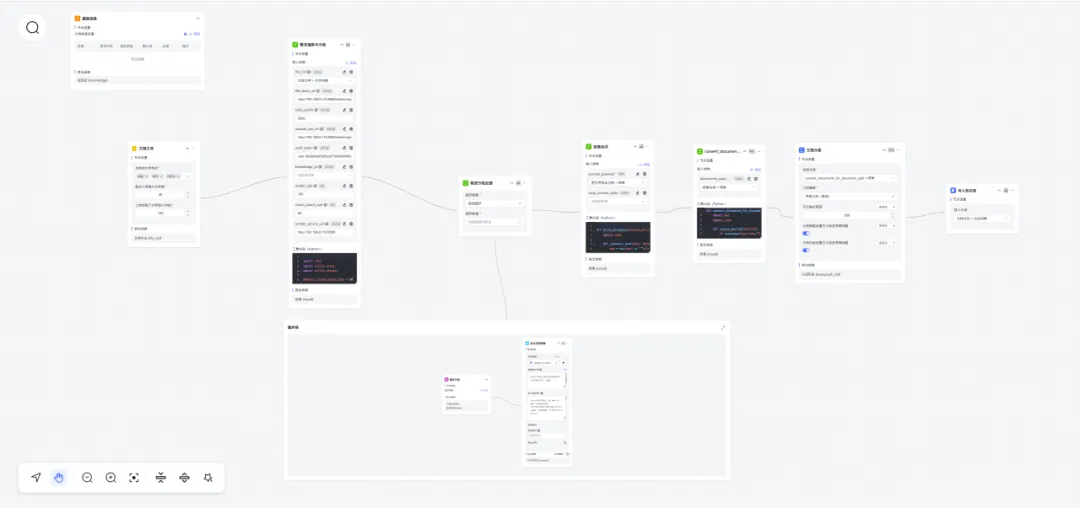
▲图6 MaxKB PPT/PDF文档整页转图工作流知识库(带循环体)
五、总结
MaxKB PPT/PDF文档整页转图方案以“全页渲染+视觉理解”替代了纯文本解析。这一方案将PPT/PDF逐页渲染为高清图像,由视觉模型统一识别文本、图表、原生图形与页面布局,并以“一页一段”的方式入库。
该方案与传统纯文本解析方案相比,各有优势。在处理纯文本为主的文档时,推荐使用传统的解析方案,以控制成本与入库速度;对于图文复杂文档处理场景,本方案在解析完整性、检索命中质量与私有化部署能力上均具有明显优势,是目前处理复杂文档的可行路径之一。
点击下方“阅读原文”,访问MaxKB的官网。