ARTICLE · 1179562
每天合入3万项改动,AI把开发工具也推着重做
同一天,Anthropic 讲了怎样应对每天超过 3 万项合入改动,LangChain 则分别更新了长任务的信息压缩和智能体日志搜索。把这些事放在一起看,代码产出已经能跑得很快,接住它的工具却开始吃力。写得更多之后,搬运、保留和检查都得跟上。
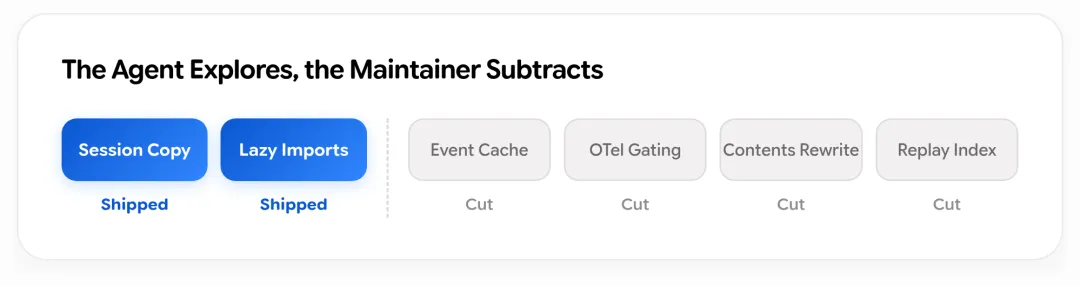
01 连夜提出六项优化,能留下的只有两项
留下的是会话复制和延迟导入的改动。被拒绝的方案,有的依赖脆弱的缓存状态,有的碰了第三方库的内部属性,还有的只在合成测试里显示收益。跑得快,还得算上以后会怎样坏。
更有意思的是测试。智能体跑过的 16892 项公开单元测试全部通过,谷歌内部仍有 25 个测试目标失败:移除某些模块导入后,原有测试模拟所依赖的访问位置被改掉了。团队随后用延迟访问的方式修复。表面没变的接口,连测试怎样找到它都要照顾。
这份复盘给我的提醒很具体:让 AI 多试方案有价值,维护者也要敢删。合成测试里赢了一次,不能把将来的兼容麻烦一并算成成功。
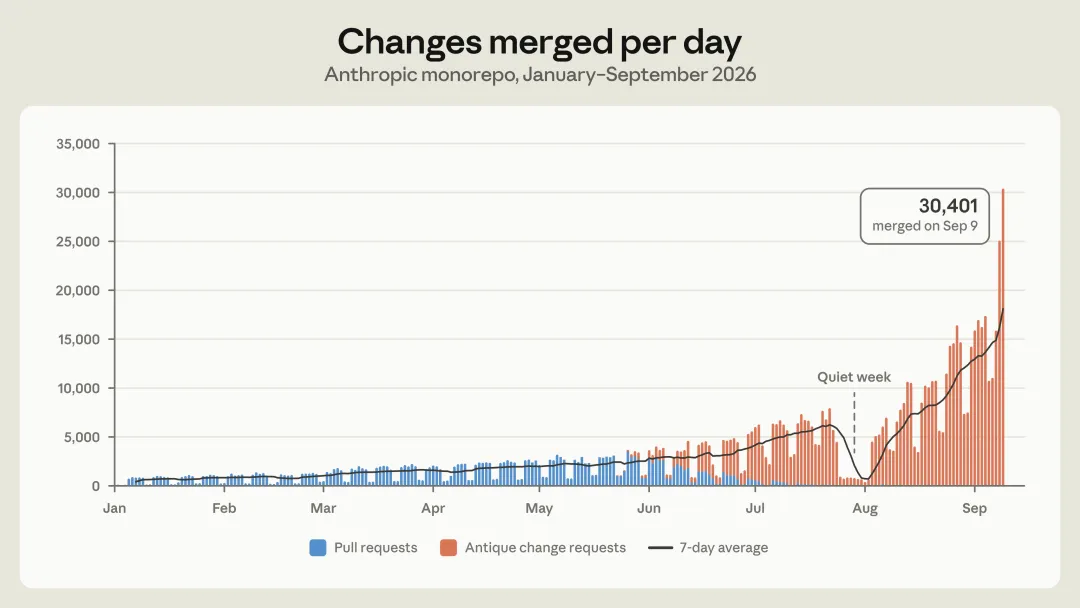
02 改动量涨了十多倍,版本管理先吃不消
压力不只来自提交。主分支历史接近 100GB,压缩后的工作副本超过 25GB,仅持续集成每天就要做约 2500 万次代码检出。智能体只改一小处,也可能先花时间把大量代码搬到工作环境里。写代码省下的时间,又花在搬代码上。
Scion 把长期在线的智能体和自动任务作为主要使用者:需要什么文件再向服务器取,许多差异和历史查询交给服务器处理。小任务不用总背着完整仓库出门,版本管理的做法也随之改变。
不过,Anthropic 明确承认这是很特殊的工作量,Git 对绝大多数仓库仍然合适。这不是劝普通团队明天换工具。我更在意的是:代码生产变快了,等待可能只是换了地方。
03 长任务先挑材料,压缩后仍能取回全文
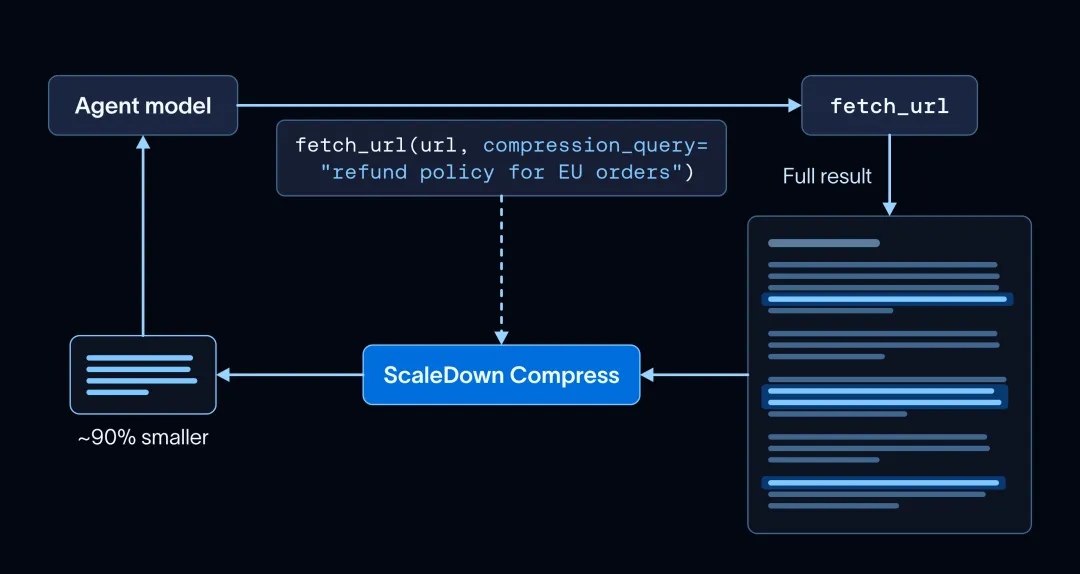
工具输出压缩的例子很直白:要查欧洲订单的退款条款,就在工具调用时写明这个问题。网页正常抓回来后,再挑出相关内容给智能体看。压缩结果会说明删减情况,并提醒需要全文时,可以不带压缩问题再调用一次。少读,但没有把回头查的路堵上。
对话概括也有退路:旧消息到达设定门槛后才归纳,近期消息继续保留;如果概括调用失败,原历史不动,任务继续。这些细节比单报一个便宜多少的数字更实在。压缩省下了阅读量,也多了一道选择材料的判断。
我会先看它有没有保住原文和关键约束,再看摘要有多短。尤其是退款条件、错误码、用户的原话,少几个字就可能换一个意思。省材料可以,不能省掉查证的机会。
04 日志能按行为搜索,没搜到却不等于没发生
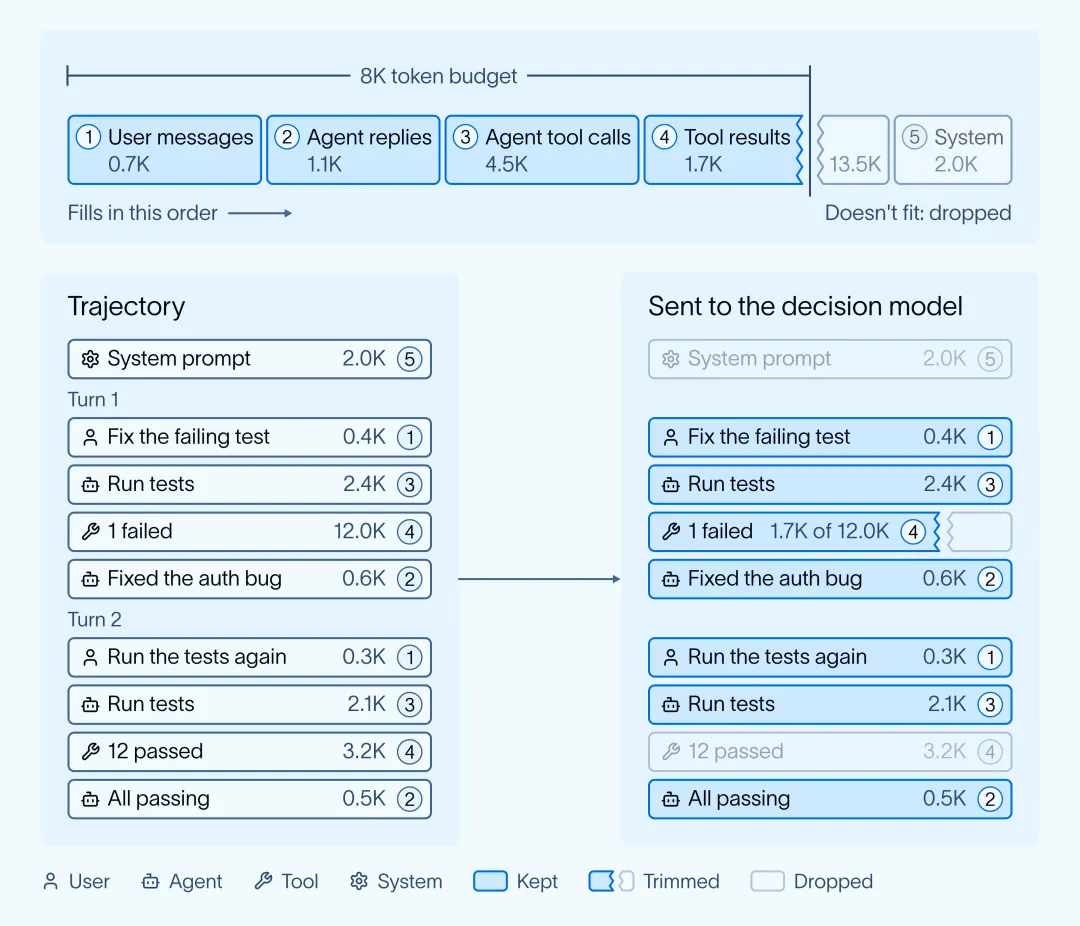
长日志有多难读?团队抽样了 150 个 Open SWE 会话,中位数约 7.2 万词元,其中约 85% 是工具输出;少数甚至超过百万。AI Search 会先去掉重复历史,再给每条轨迹分配 8K 的阅读预算:用户消息和面向用户的回复优先,其他内容依次填入,装不下就截断或舍弃。
这个取舍适合查很多对话行为,却有明显盲区。作者自己也说,智能体忽略工具错误的证据可能只在工具结果里,而这部分恰好可能没被完整保留。搜到了,可以顺着原始记录查;没搜到,不能拿来证明它从未出错。
这和上一节是一件事的两面:智能体工作时要挑材料,查它的工作时也在挑材料。工具能帮人缩小排查范围,不能把没读到的内容变成安全结论。
回到谷歌早上收到的那份改动:六项提议,最终保留两项。Anthropic 要让海量改动进得去,ScaleDown 要让长任务读得动,LangSmith 要让异常找得到。每一步都在做取舍,每一步也都可能漏东西。
我更愿意把 AI 写代码省下来的时间,留一部分给这些具体问题:搬了什么,删了什么,查过什么,还有什么根本没看见。能跑一整夜很好,第二天仍要说得清楚。
🔥 今日话题:你让 AI 连续干活时,最先遇到的麻烦是什么:等环境、忘前文,还是出了问题翻不到证据?
👇 点个「在看」,转给正在让 AI 接手更多代码工作的朋友。
Google for Developers(原始文章)
Anthropic(原始文章)
LangChain / ScaleDown(原始文章)