ARTICLE · 1184549
第一版 RAG:上传文档就能问,我用了不到 200 行
先把企业级架构设计好
先把最小那条
链路跑通
五个步骤 · 三个 Bean · 一条能问的链路
项目实战AI笔记
先别急着设计架构
专栏二 · 从零搭本地 RAG 第 1 篇(共 14 篇)
前三篇一直在讲选型和认知:为什么不引 Python、LangChain4j 到底给了什么、Agent 和聊天机器人的区别。
从这篇开始动手。
但我做的第一件事,不是设计企业级架构,而是让一条最小的链路先跑起来——上传一个文档,问一句话,模型能照着文档答上来。
理由很简单:企业级那套(混合检索、Rerank、权限、审计)我一项都还没验证过。链路都没通,谈优化是空谈。
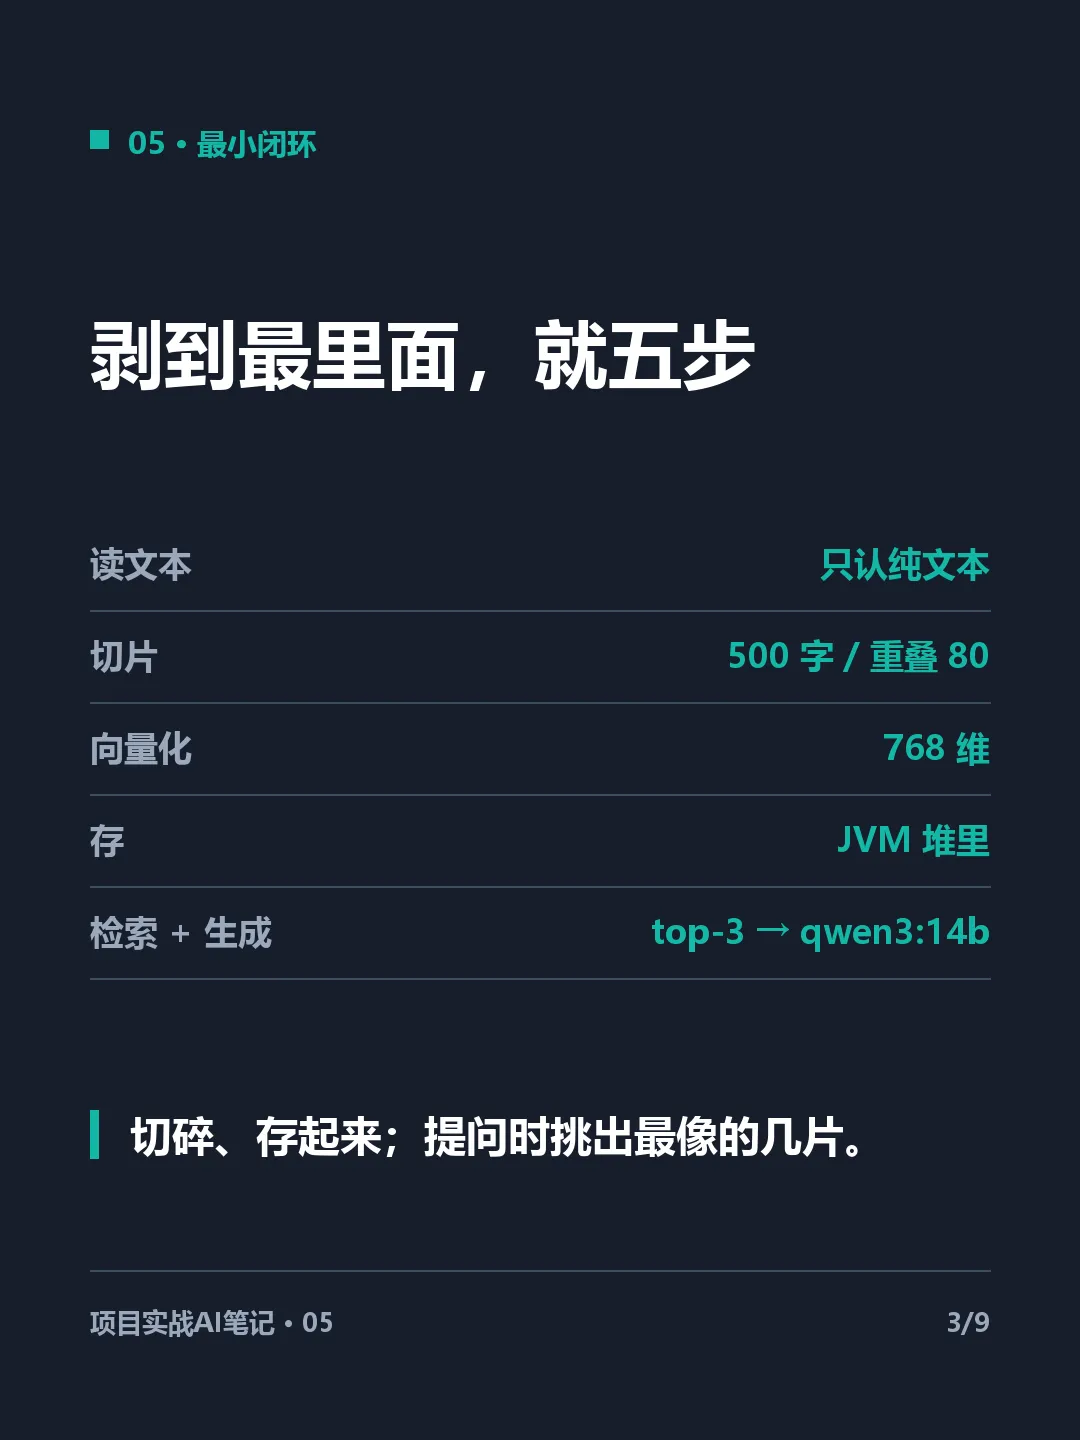
最小闭环,就五步
RAG 听着玄,剥到最里面就五步:
一句话:把文档切碎、变成向量存起来;提问时找出最像的几片,连问题一起塞给模型。
前后端连起来,就是一个能用的文档问答。
三个 Bean,撑起整条链路
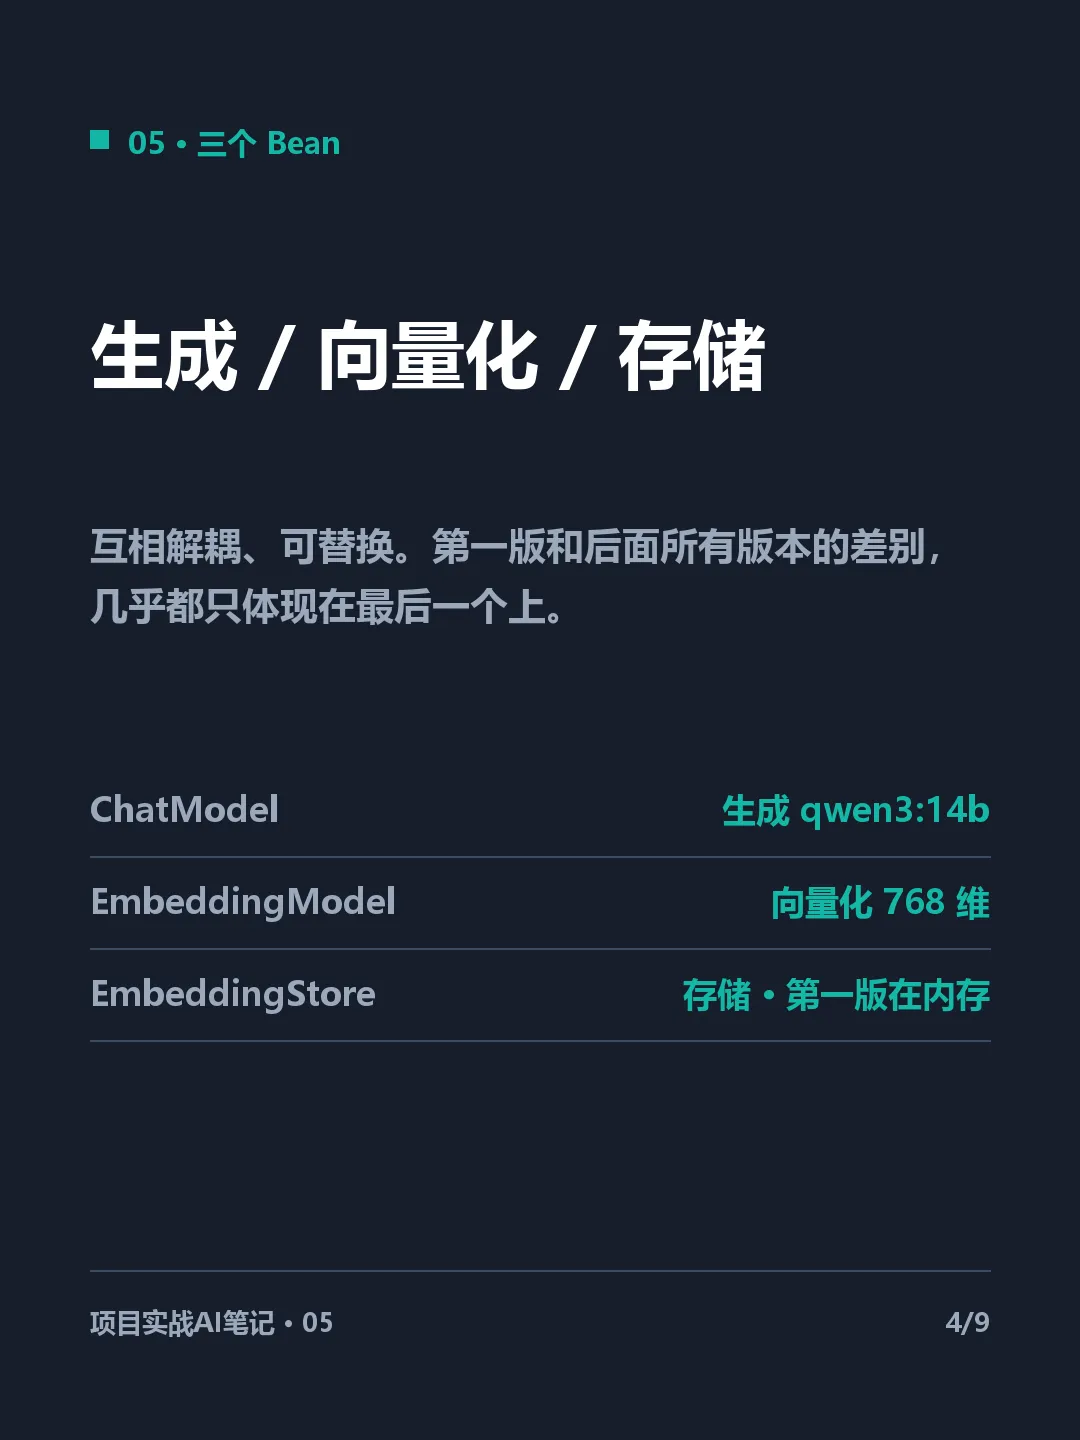
整个 RAG 的骨架在 RagConfig 里,就三个 Bean:
@Configuration
public class RagConfig {
@Bean
public ChatModel chatModel() { // 对话模型
return OllamaChatModel.builder()
.baseUrl(baseUrl) // localhost:11434
.modelName("qwen3:14b")
.timeout(Duration.ofSeconds(300)) // 本地模型首响慢,超时给足
.build();
}
@Bean
public EmbeddingModel embeddingModel() { // 向量化模型
return OllamaEmbeddingModel.builder()
.baseUrl(baseUrl)
.modelName("nomic-embed-text") // 768 维
.build();
}
@Bean
public EmbeddingStore<TextSegment> embeddingStore() { // 向量库
return new InMemoryEmbeddingStore<>(); // ← 就这一行,第一版
}
}
这三个 Bean 分别对应「生成 / 向量化 / 存储」,互相解耦、可替换。
第一版和后面所有版本的差别,几乎都只体现在最后那个 Bean 上。
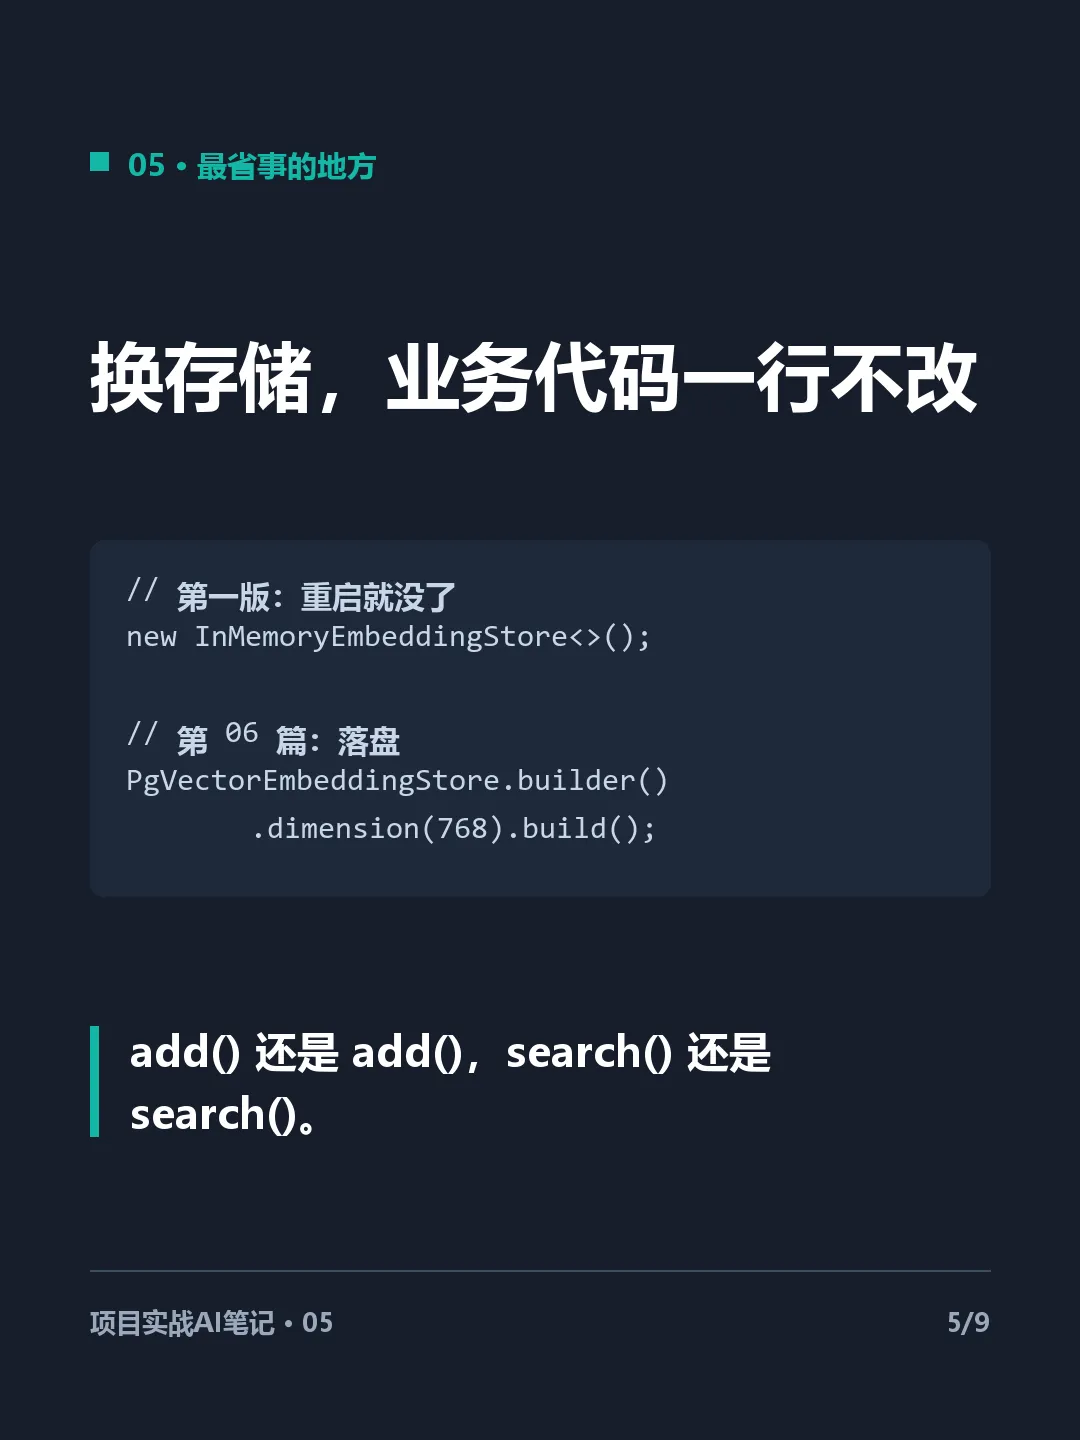
第 06 篇要干的事,就是把 embeddingStore() 这一行:
return new InMemoryEmbeddingStore<>(); // 内存,重启就没了
换成:
return PgVectorEmbeddingStore.builder() // PostgreSQL + pgvector,落盘
.host(pgHost).port(pgPort).database(pgDatabase)
.table("embedding_store").dimension(768)
.createTable(true)
.build();
业务代码一行不用改——add() 还是 add(),search() 还是 search()。
入库:切片 → 向量化 → 存
/**
* 入库:一篇文档 → 切块 → 逐块向量化 → 写入向量库。返回切块数。
*/
public int ingest(String text) {
List<String> chunks = split(text, 500, 80); // 固定窗口 500,重叠 80
int count = 0;
for (String chunk : chunks) {
TextSegment segment = TextSegment.from(chunk); // 切片 → TextSegment
Embedding embedding = embeddingModel.embed(segment).content(); // 调模型向量化
embeddingStore.add(embedding, segment); // 存
count++;
}
return count;
}
三个类型,对应三个动作:TextSegment(文本片)、Embedding(向量)、EmbeddingStore(库)。
到这里有个很关键的习惯:add() 是「往库里塞一行」,不是「覆盖」。所以第一版最大的隐患——同一份文档传两遍,库里就有两份。这事我在第 04 篇讲过(幂等去重),第一版是完全没有的。
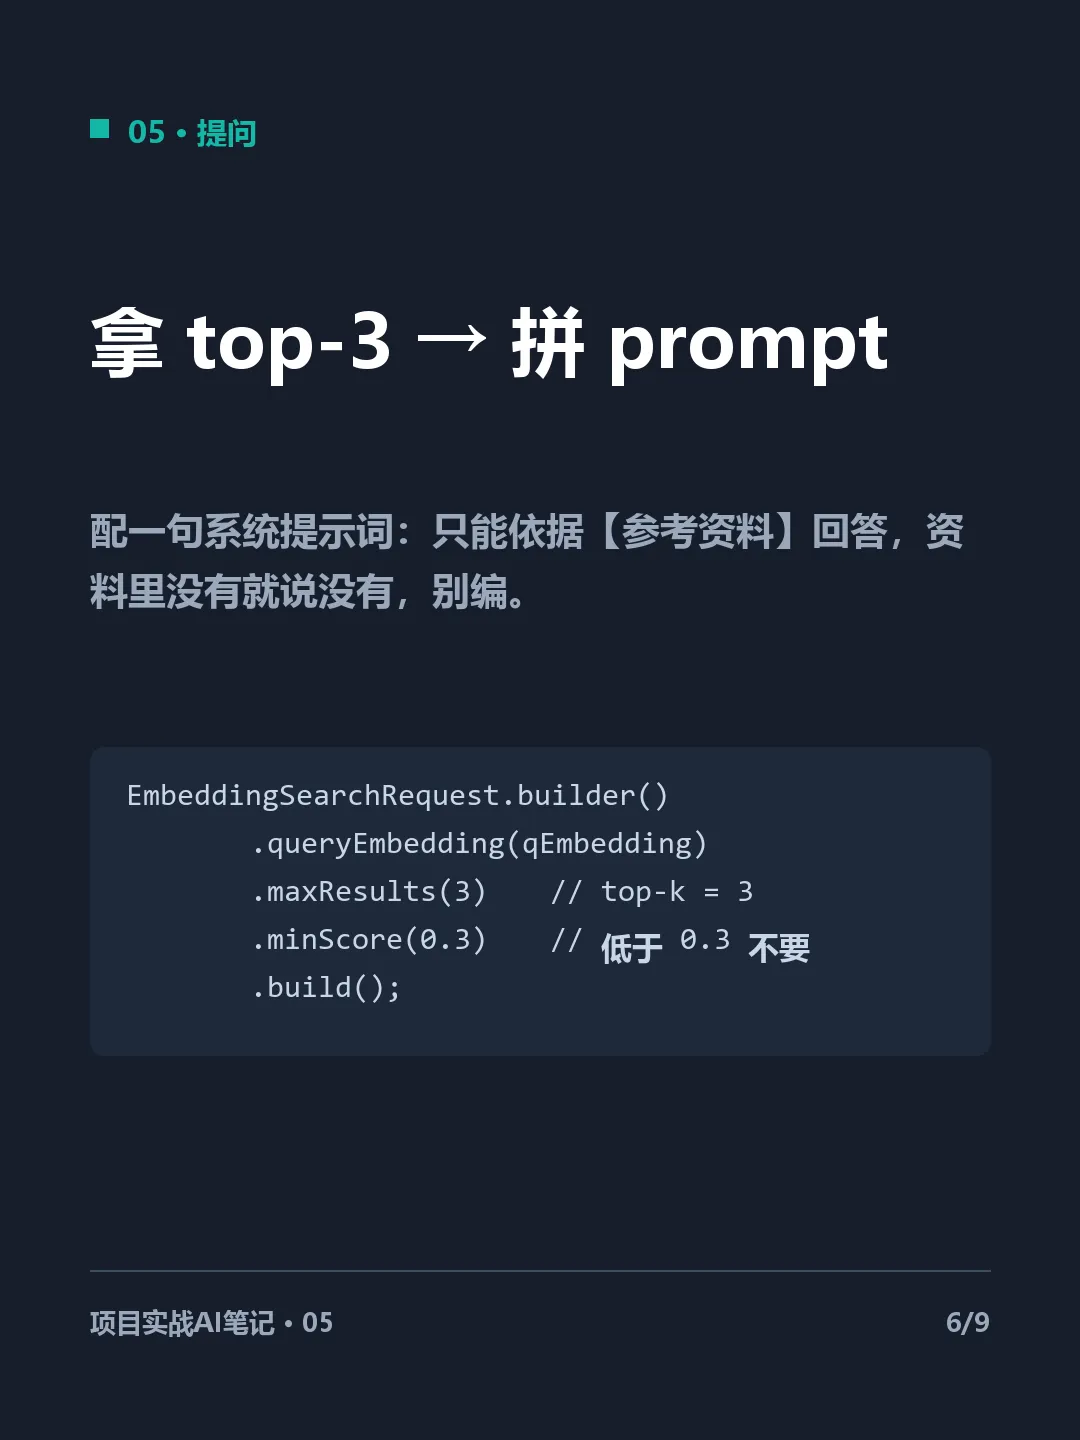
提问:拿 top-3 → 拼 prompt
public String ask(String question) {
// 1) 问题向量化:和入库时用的是同一个 embedding 模型
Embedding questionEmbedding = embeddingModel.embed(question).content();
// 2) 检索:交给 LangChain4j 封装的单路向量检索
EmbeddingSearchRequest request = EmbeddingSearchRequest.builder()
.queryEmbedding(questionEmbedding)
.maxResults(3) // top-k = 3
.minScore(0.3) // 相似度低于 0.3 的不要
.build();
List<EmbeddingMatch<TextSegment>> matches =
embeddingStore.search(request).matches();
// 3) 拼 prompt:把命中的片段拼成「参考资料」,连问题一起给模型
String context = matches.stream()
.map(m -> m.embedded().text())
.collect(Collectors.joining("\n\n---\n\n"));
return chatModel.chat(prompt(question, context));
}
配一句系统提示词就完事了,大意是:只能依据【参考资料】回答,资料里没有就说「没有」,别编。
这一版能答对问题,靠的就是这句话——它把模型从「凭记忆瞎编」摁回「照着材料说话」。
顺带说一个细节:这里的 minScore(0.3) 当时是真在起作用的(过滤低相似的片)。后来换成混合检索、分数换成 RRF 融合分之后,这个 0.3 的量级就对不上了,成了死代码——这个坑我在第 12 篇单独讲。
第一版到底有多糙
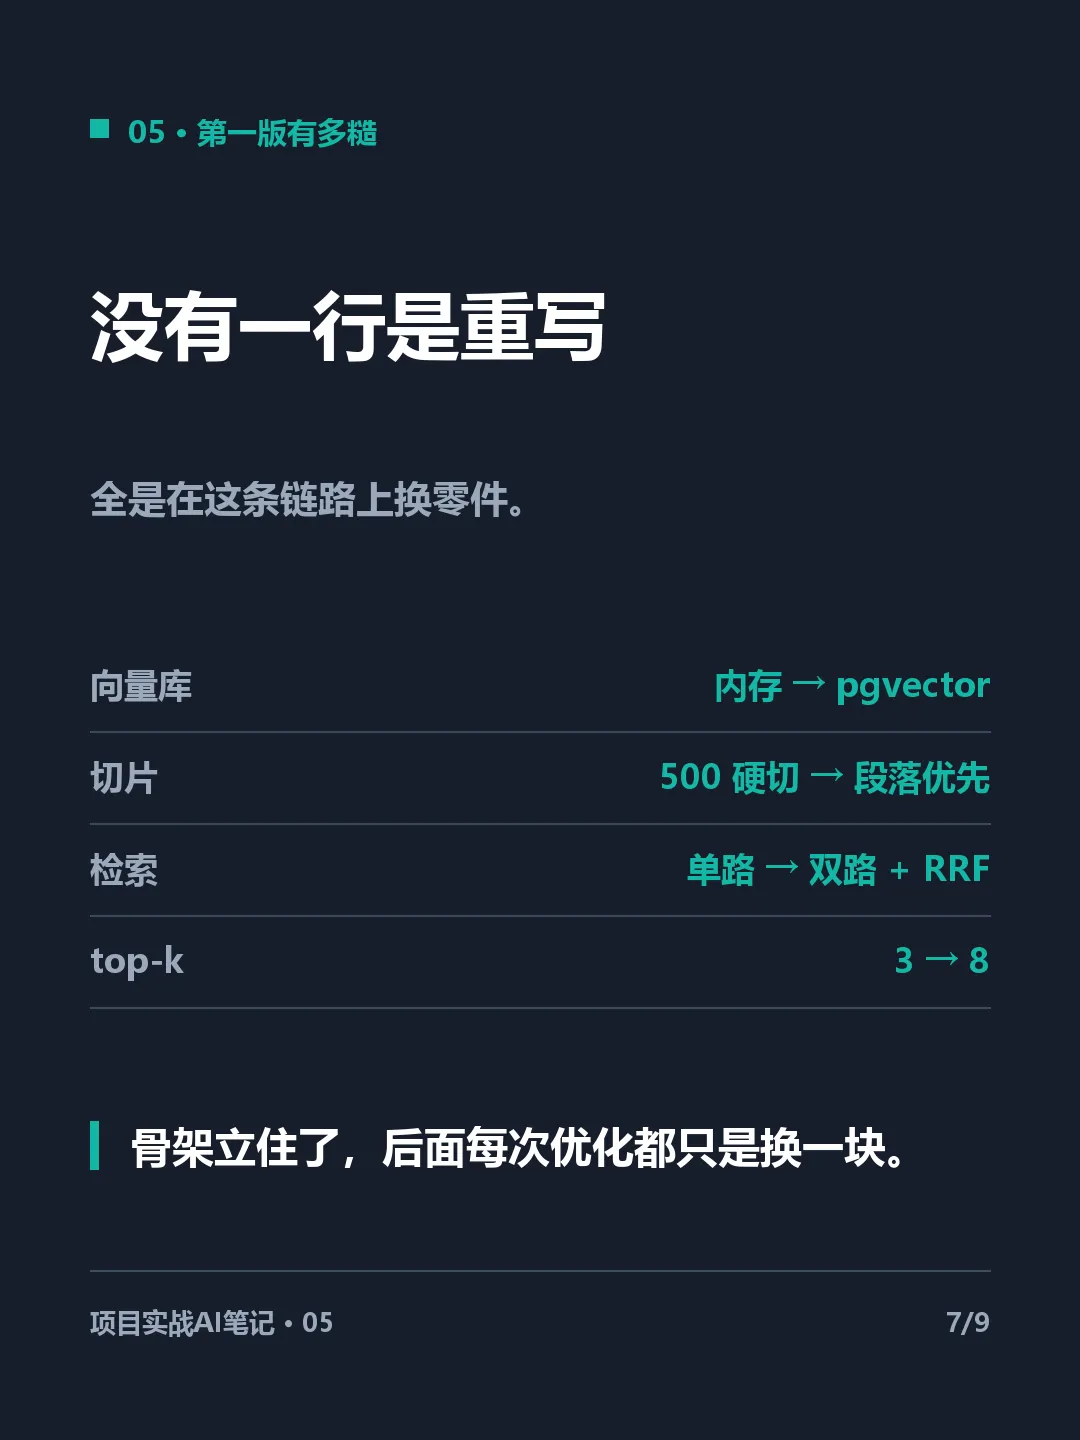
把第一版和后来每一处改动列在一起,你会看出一个规律:
看每一行都会发现:没有一行是「从零重写」,全是在这条链路上换零件。
这也是我坚持先把最小版跑通的原因——骨架立住了,后面每次优化都只是换一块。
它为什么「够用」
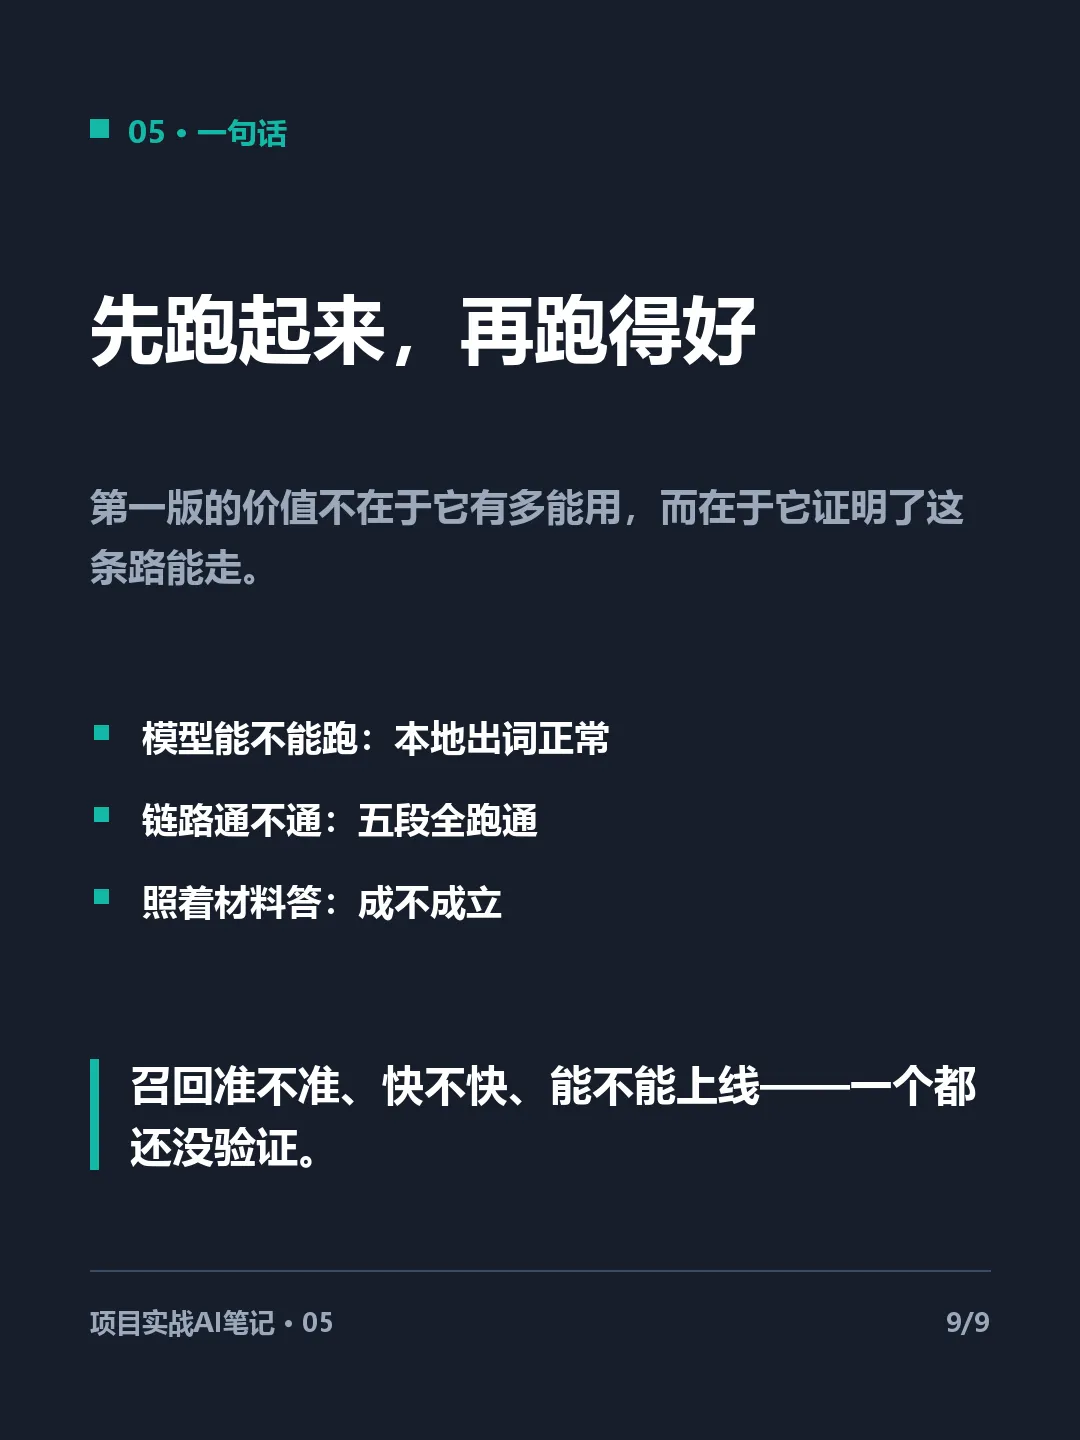
第一版够用,不是因为它好,是因为它把要验证的东西都验证完了:
模型能不能跑
qwen3:14b 在本地 Ollama 上出词正常、体验可接受
链路通不通
切片 → 向量化 → 存 → 召回 → 生成,每一段都跑通了
「照着材料答」成不成立
能引用到正确的片段,也会在资料不足时说「没有」
至于召回准不准、快不快、能不能上线——这些一个都还没验证。但没关系,那不是第一步该操心的事。
先让它跑起来,再让它跑得好。
顺序反了,就会陷在「调参调不明白」里——因为你连基线在哪都不知道。
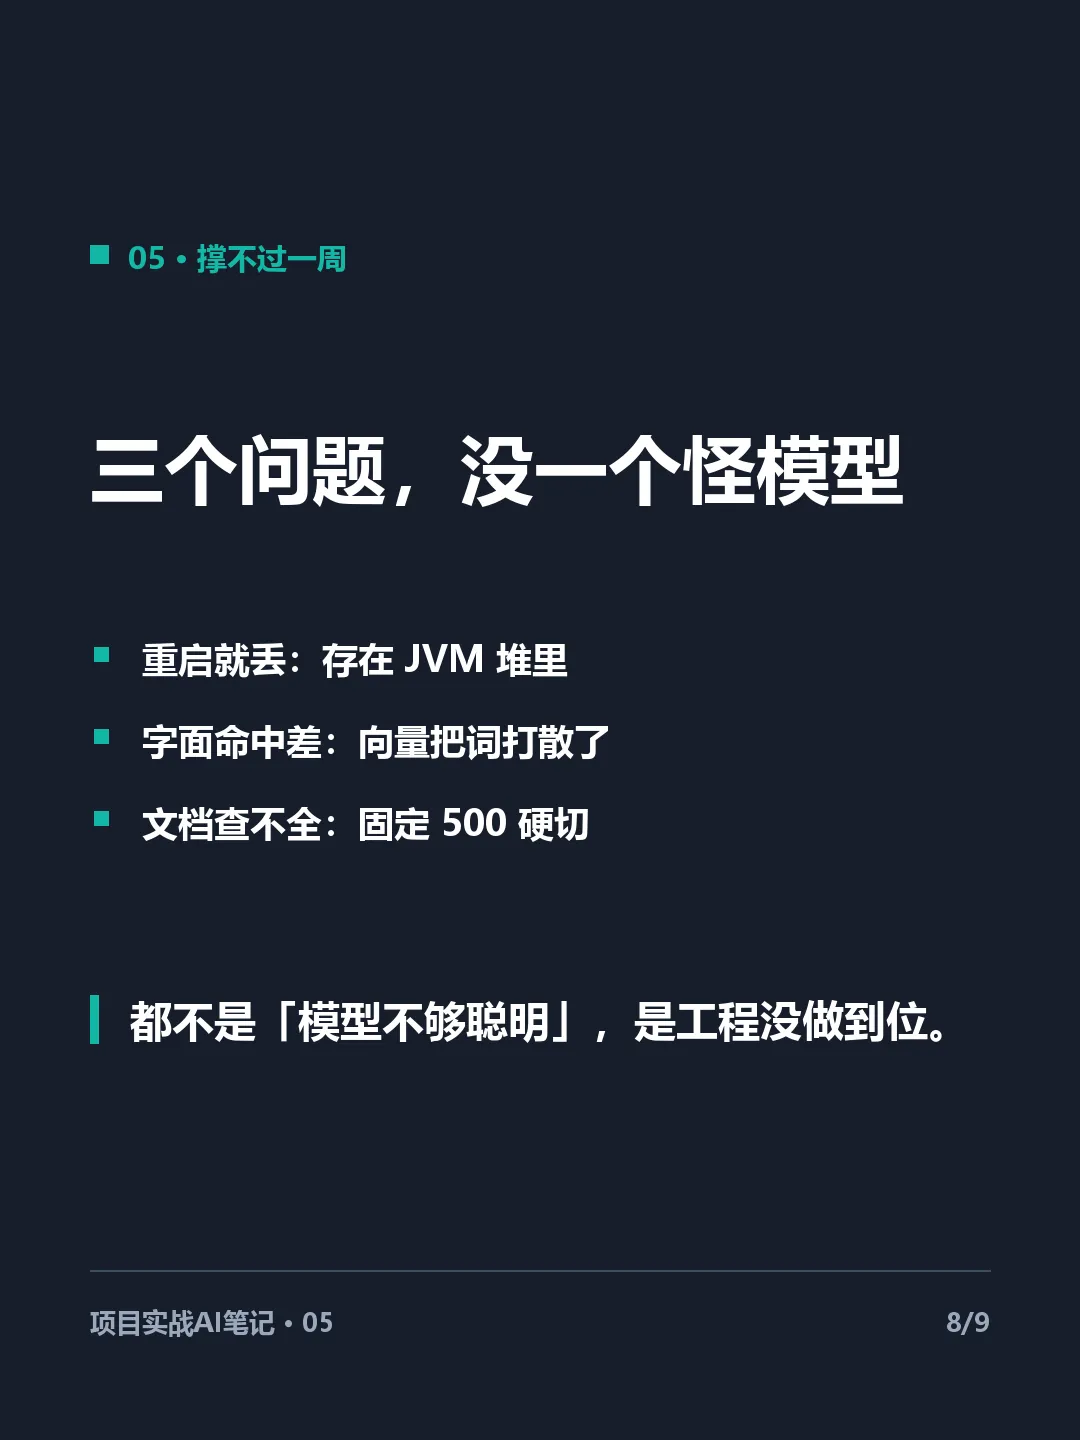
但它撑不过一周:三个问题
跑通那天我挺得意。真拿去用,一周之内被三个问题连着打脸:
① 重启就丢
InMemoryEmbeddingStore 存在 JVM 堆里,服务一重启,半个字都不剩,所有文档要重传。
→ 第 06 篇:迁到 PostgreSQL + pgvector
② 字面命中很差
单路向量只按语义排序。问「biz_order 这张表怎么用」,库里明明有这个词,但向量把它语义打散了,反而排不进 top-3。
→ 第 08~09 篇:加一路 pg_trgm 稀疏召回,再做 RRF 融合
③ 文档查不全
固定 500 字硬切,不认识「一张表的字段」是一个整体。问到某个表的字段,命中片段残缺、还混着别的表,模型只能回一句「资料中没有相关信息」。
→ 第 11 篇:改成段落优先切片;更彻底的做法是按表标题切
这三个问题很典型:都不是「模型不够聪明」,是工程没做到位。
一句话总结
第一版 RAG 的价值,不在于它有多能用,而在于它证明了这条路能走。
五个步骤 · 三个 Bean · 不到 200 行
把「文档问答」从一个念头,变成能跑的东西。
剩下的十几篇,都是在这条链路上逐个换零件——换存储、换切片、换检索、加权限、加流式。
附 · 一份整理好的完整资料
这份资料包,我整理好了
本来这篇只打算讲第一版那点代码。写的时候发现,真正卡人的不是「怎么写出来」,而是「写出来之后还差什么」。
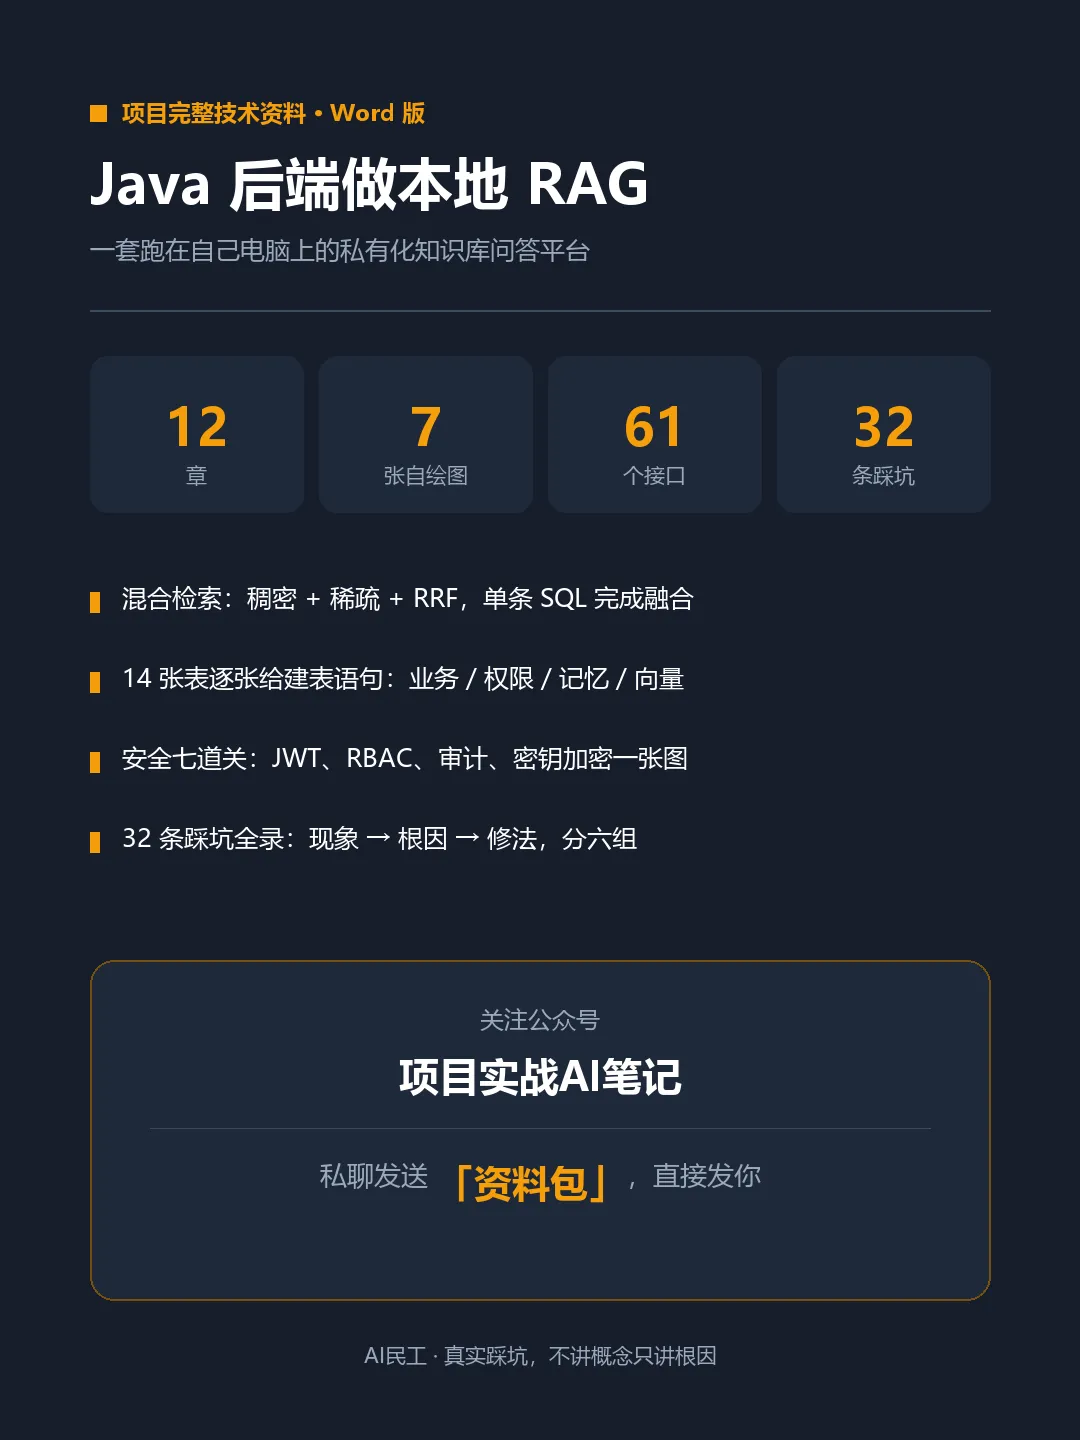
所以我把整个项目从头到尾理了一遍,做成一份 《Java 后端做本地 RAG · 项目完整技术资料》(Word 版,12 章,7 张自绘图)。不是概览,是能当手册查的完整版:
7 张图都是自己画的:分层架构、代码模块全景、数据模型 ER、入库六步、检索链路对比(单路 vs 混合双路 + RRF)、多 Agent 编排、安全七道关。
踩过的坑一条没删。到现在还没做的那几件事,文中也都如实标了出来——哪项是「方案已定、还没落地」,哪项是「完全没动」,都标了。
关注公众号「项目实战AI笔记」,私聊发送「资料包」,直接发你。
下期预告
内存向量库重启就没了:迁 PostgreSQL + pgvector 排坑
把 embeddingStore() 那一行换掉,业务代码一行不动。但装 pgvector 扩展这一步,我卡了整整一轮。
我是AI民工,一个写了多年 Java 的后端。
后面继续写 Java 老兵做 Agent ——真实踩坑,不讲概念只讲根因。
如果觉得这篇有用,欢迎转发给正在做 RAG 的同事——他们大概率刚跑通第一版,正准备踩这三个坑。