ARTICLE · 1194356
REA 实测:用 AI 逆向停更软件,边界到底在哪?
你有没有过这样的经历:手上有一款用得顺手的软件,功能刚好卡在你的需求上,可它已经好几年没更新了——官网打不开,更新服务器关停,提需求也没人理。它像一件还能用、却再也没人修的旧家电。
我们最近就遇到了这么一款。于是我们决定,试试能不能「读懂」它,再自己重写一遍。这篇就把整个过程、用到的工具,以及最重要的那部分——法律边界,一次性讲清楚。
01 先说工具:REA 是什么
REA,全称 Reverse Engineer Anything,直译「逆向工程万物」。它是一个开源的 MCP 服务器(同时提供命令行工具),采用 MIT 许可证,用 TypeScript 编写,以 rea-agents 的包名发布在 npm 上,作者是 morluto,官方仓库在 GitHub 的 morluto/rea。
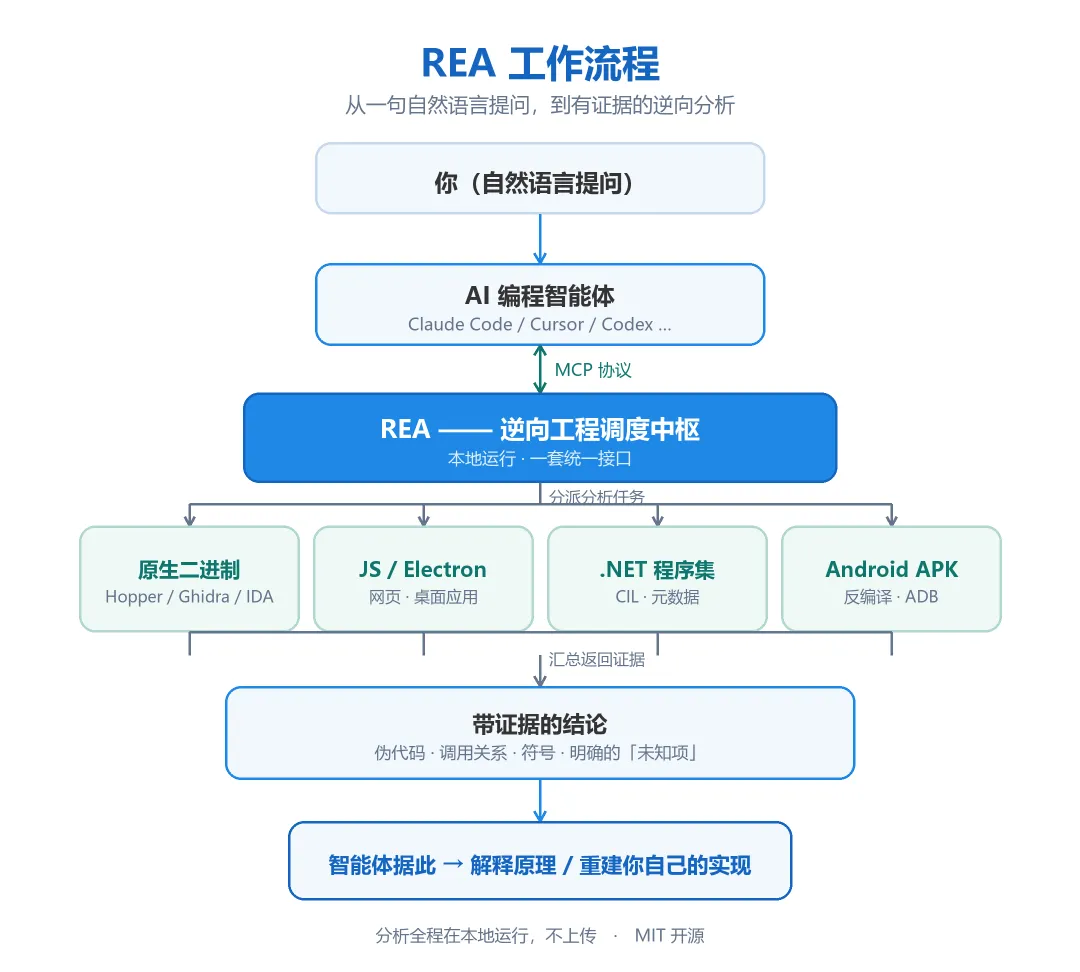
它不是反编译器本身,而是一个「调度中枢」:把 Hopper、Ghidra、IDA 这些专业逆向引擎,连同 JavaScript / Electron 解析、.NET 程序集读取、APK 反编译等十几种能力,统一封装成一组 AI 智能体可以直接调用的接口。
一句话说清它的价值:你看到某款软件有个想要的功能,想知道它到底怎么实现的——以前只能自己开 Ghidra,一行行啃汇编;现在可以用自然语言让 AI 智能体去查,它把相关代码定位出来,返回带证据的结论(伪代码、调用关系,以及「哪些地方它也没搞明白」的明确标注)。分析全程在本地运行,不上传。
安装也简单:
npx rea-agents setup前提是 Node.js 22.19 以上;想要做原生二进制分析,还得本机已经装好 Hopper、Ghidra 或 IDA。
02 我们逆向了一款软件
这段是重点。
这是一款 2018 年前后发布的专业客户端软件,Windows 平台,没有公开源码,开发者早已停止维护。我们用 REA 把它从头到尾看了一遍:它是什么技术栈、模块怎么划分、启动流程如何、联网更新走的是哪套协议。
一个很典型的发现:它「不升级」,并不是软件坏了,而是它写死的更新服务器早已下线——客户端发出去的请求,石沉大海。这类「死因」,靠猜是猜不出来的,只能从代码里找证据。
需要强调:这一步我们只做「理解」,没有改动它一个字节,没有卸载任何保护,也没有分发它。
03 然后,我们复刻了一个
理解之后,我们选了一条更干净的路:参考它暴露出来的功能与交互,用完全不同的技术栈,从零写一个自己的版本。
注意用词——是「复刻」,不是「复制」。我们没有搬任何一行原代码:原程序是 C++ 写的,我们的新版本用 C# 重写;它的界面资源、通信逻辑,我们只当作「需求说明书」来读,实现则完全另起炉灶。这种「只看规格、不抄代码」的做法,在业界有个专门的名字,叫干净房间(Clean Room)。
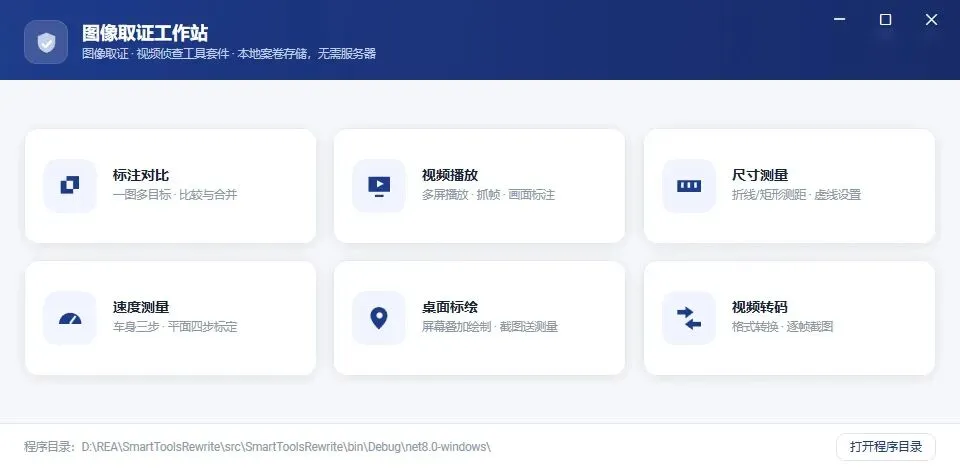
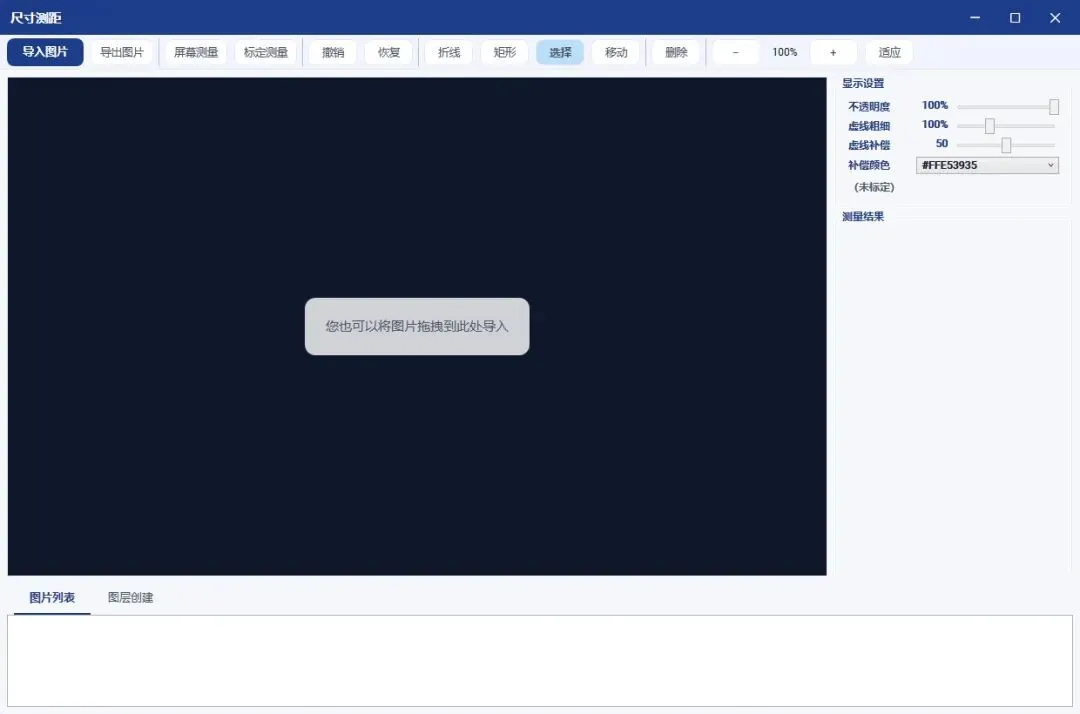
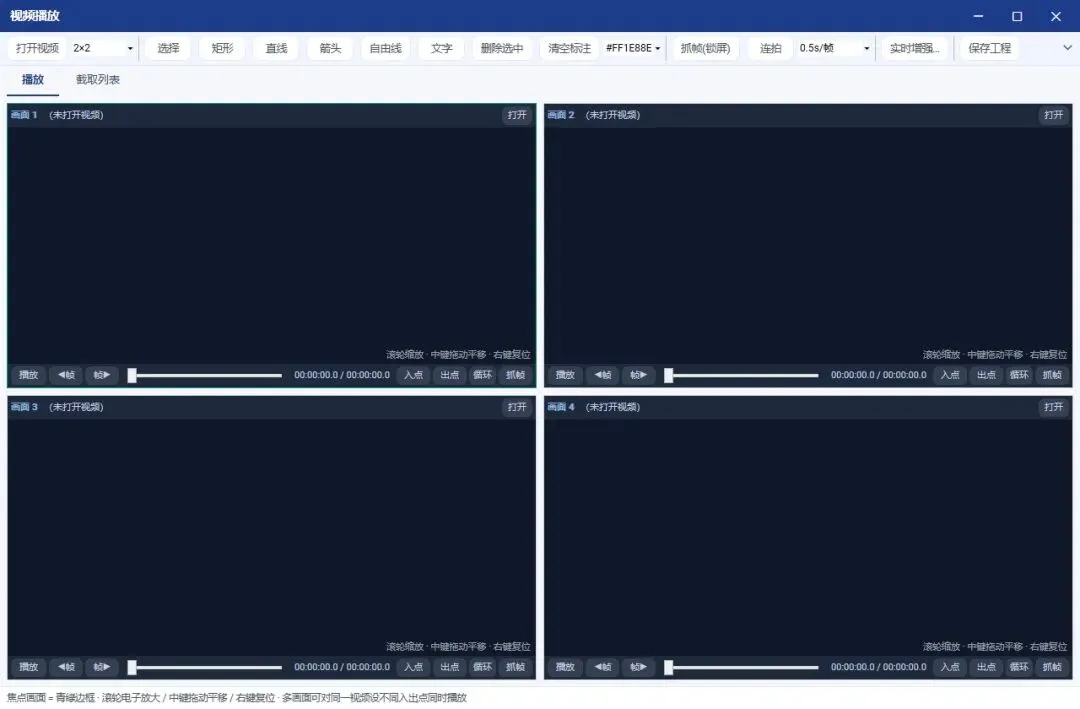
新版本做到了:离线播放、尺寸测量、速度测量、画面标绘、视频转码、图片标注,而且彻底去掉了对那台已下线服务器的依赖,插上就能用。
04 划重点:这条路的边界在哪
技术讲完了,但这段才是真正该记住的。反编译不等于可以随便抄,软件著作权是一道实打实的红线。
先纠正一个最常见的误解:著作权保护的是「表达」,不是「思想」。也就是说——
受保护的:源代码本身、它的具体写法、界面美术资源、文档。
不受保护的:功能、算法思想、操作方法、数据结构、交互逻辑。
所以「我想做一个和它功能一样的软件」本身并不违法;违法的是直接抄它的代码、资源,或者绕过它的技术保护措施。
具体来说,下面这几条线不能碰:
不能直接复制源代码。反编译出来的是「参考证据」,不是「素材库」。
不能绕过技术保护措施。破解加密、绕过授权验证、去除序列号机制——这才是最危险的一类,立法重点打击的对象。
不能去除或篡改权利声明。权利管理信息(作者署名、版权标识)动不得。
不能传播破解版或盗版。自己研究是一回事,对外分发是另一回事。
商业使用要格外谨慎。一旦涉及盈利、批量复制,风险量级完全不同。
那什么可以做?观察软件行为、研究文件格式、为实现互操作而做必要分析,通常落在合法空间内;而干净房间法——把「读代码的人」和「写代码的人」隔离开,读的人只输出功能规格,写的人完全不接触原代码——是业界公认最稳的路径。我们这次,走的就是这条路。
REA 本身是 MIT 开源的,工具完全合规;但你拿它做什么,责任在使用者自己。技术是中性的,边界却是清楚的。
— END —