ARTICLE · 1195418
GitHub 热榜精选:Agent插件开始管成本和上下文
GitHub 热榜精选:Agent插件开始管成本和上下文
Claude Code官方插件目录、科研技能库和Caveman排在前列。今天11个项目集中解决技能分发、上下文成本、语音生产和软件工程流程。
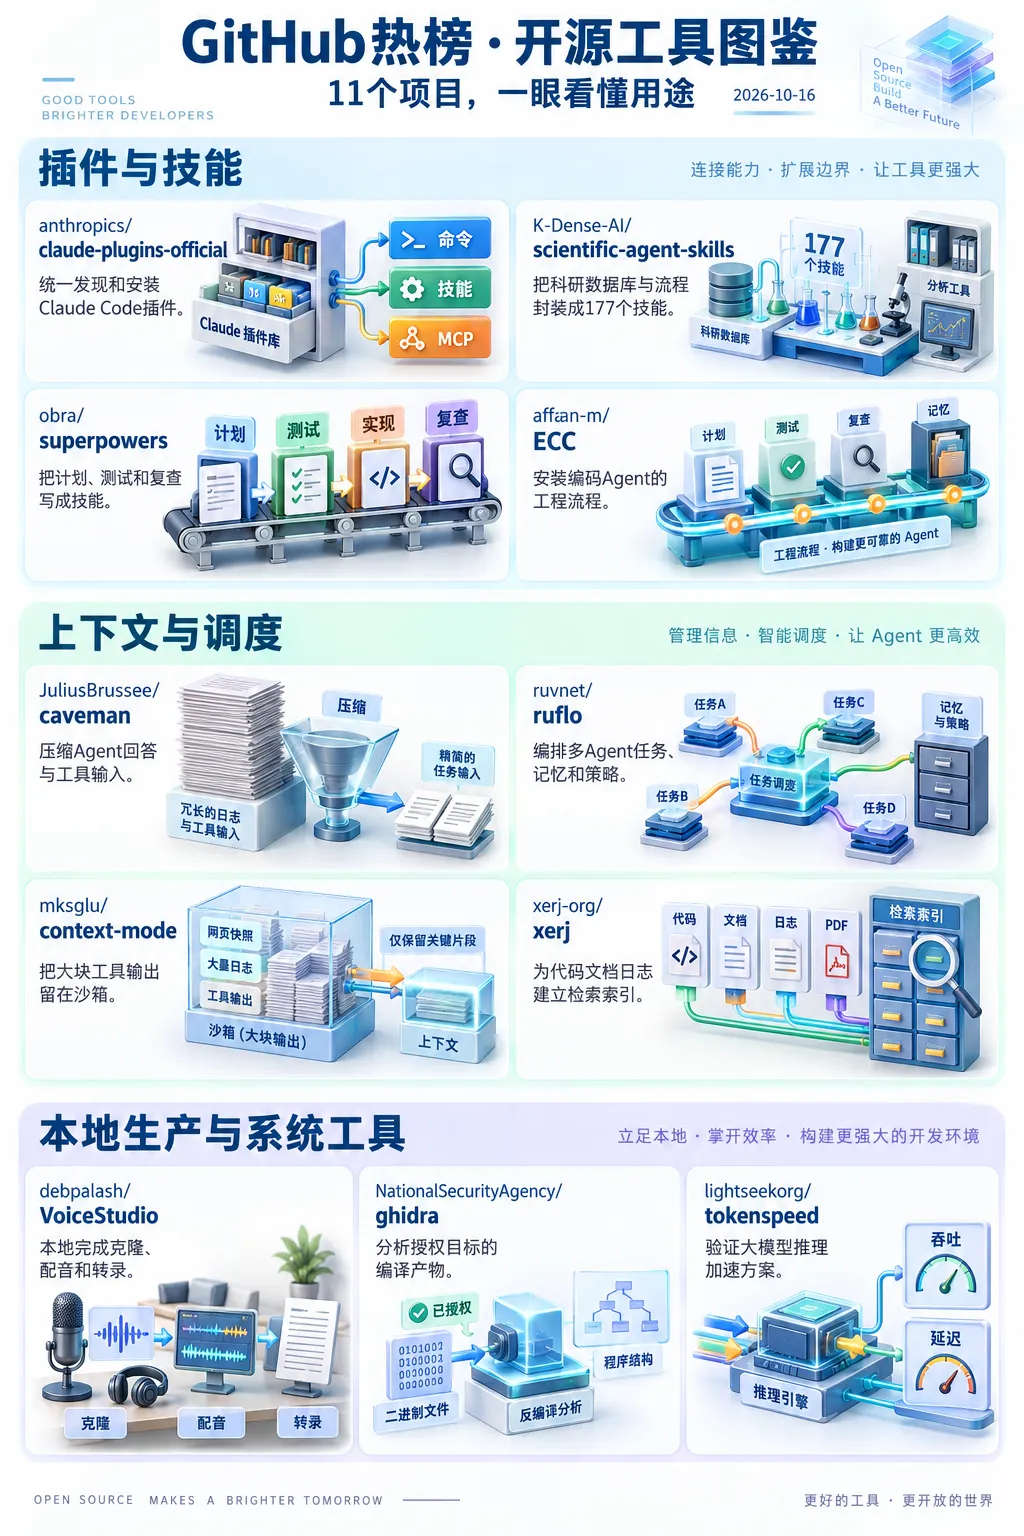
今天排在前面的项目都在削减 Agent 的日常损耗。官方插件目录管分发,Scientific Agent Skills 管科研步骤,Caveman 和 context-mode 则盯着输出长度与上下文占用。
anthropics/claude-plugins-official
 39,093
 4,324
这是 Anthropic 维护的 Claude Code 插件目录,既收官方插件,也接纳通过审核的第三方插件。插件可以携带命令、Agent、Skills 和 MCP 配置,安装入口统一了,能力边界却没有自动变安全。README 明确提醒:Anthropic 不控制第三方插件里包含的 MCP 服务、文件或其他软件,安装前仍要检查来源和权限。
官方目录解决了发现和安装,没替你完成供应链审查。第三方插件能带 MCP 和脚本,权限仍要逐项看。
项目地址:https://github.com/anthropics/claude-plugins-official
K-Dense-AI/scientific-agent-skills
 50,468
 4,489
这套仓库给科研 Agent 准备了 177 个可复用技能,覆盖生物信息、化学、医学、材料、数据分析和科研写作,并连接 100 多个科学数据库。它兼容 Cursor、Claude Code、Codex 等支持 Agent Skills 标准的客户端。科研团队能少花时间重复解释工具用法,但临床、药物和实验结论仍要由专业人员复核。
科研 Agent 缺的常常不是模型,而是数据库、工具和验证步骤。技能库能省重复说明,不能代替专业判断。
项目地址:https://github.com/K-Dense-AI/scientific-agent-skills
JuliusBrussee/caveman
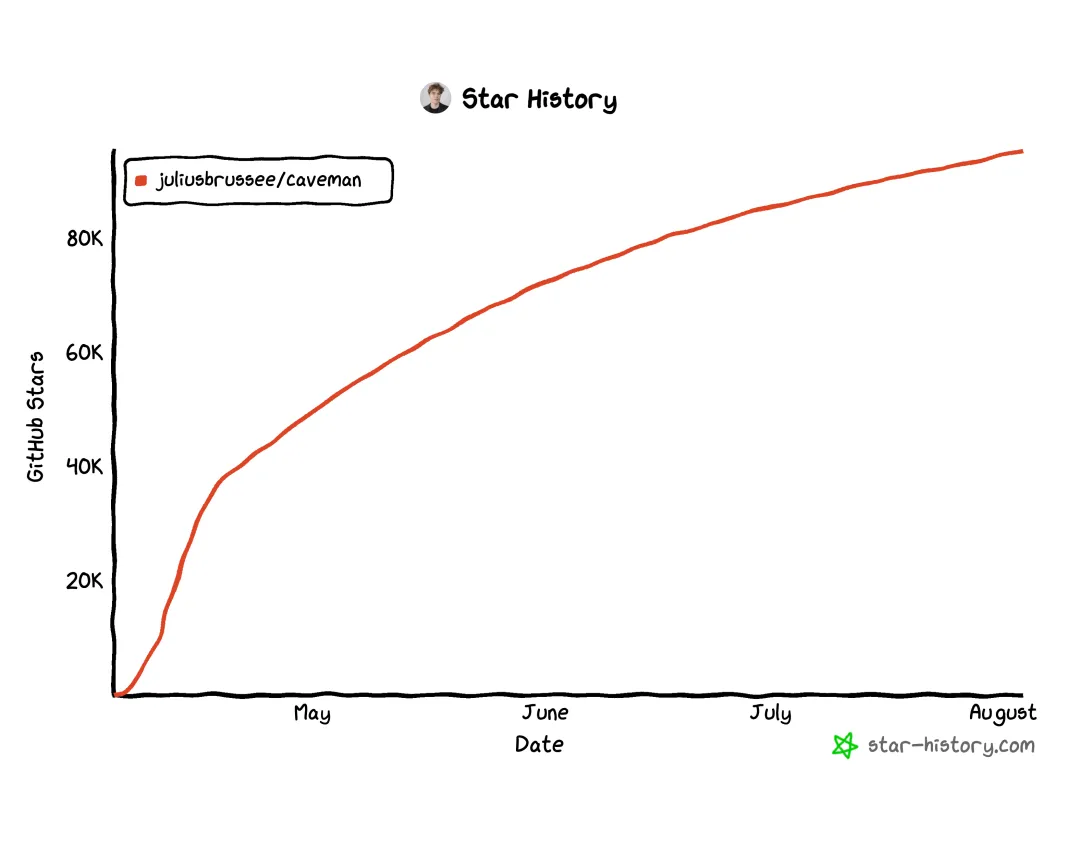
 112,539
 6,519
Caveman 同时压缩 Agent 的回答和工具输入:短答模式减少输出,日志、JSON、CSV 与测试结果先压缩再送进上下文,还提供模型与推理强度选择。项目公开了自己的测试方法,也承认 HTML 压缩和部分成本结论仍有局限。它适合上下文成本高的长会话,接管多种 Agent 配置前要先看清改动范围。
少说废话确实省钱,工具输出压缩更有价值。先在自己的任务上复测,别把仓库里的比例当成通用账单。
项目地址:https://github.com/JuliusBrussee/caveman
debpalash/VoiceStudio
 69,088
 7,564
VoiceStudio 把语音克隆、音色设计、视频配音、听写、转录和有声书制作放进一套本地桌面应用,覆盖 646 种语言。它能在自己的电脑上运行,也能通过本地 API 和 MCP 接进自动化流程。声音素材不必先上传第三方服务,但克隆他人声音仍需得到授权,各语音模型和输出还受各自许可证约束。
本地处理减少素材外传,声音权利问题却不会消失。能克隆,不等于可以随便克隆。
项目地址:https://github.com/debpalash/VoiceStudio
obra/superpowers
 299,893
 26,785
Superpowers 把编码 Agent 常见的软件开发步骤拆成可组合技能:先澄清需求,再写计划、测试、实现、复查和验证。它支持多种编码客户端,Hermes Agent 也在兼容列表里。团队想把“每次都靠提示词提醒”改成固定工程习惯,可以从这里借流程;代价是它会明显约束 Agent 的工作方式。
固定流程能让 Agent 少走回头路,也会让简单任务显得偏重。团队项目比临时脚本更适合它。
项目地址:https://github.com/obra/superpowers
ruvnet/ruflo
 75,122
 8,926
Ruflo 是面向 Claude Code、Codex 和其他 MCP 客户端的多 Agent 调度框架,提供任务路由、共享记忆、RAG、策略控制和可视化控制台。它适合把复杂工作拆给多个执行单元,也意味着更多运行组件和权限。README 提醒 mods 会以用户账号权限运行,安装前应审查代码和配置。
多 Agent 只有在任务能拆、结果能验时才划算。调度层越厚,权限和故障点也越多。
项目地址:https://github.com/ruvnet/ruflo
mksglu/context-mode
 29,795
 2,083
context-mode 专门处理编码 Agent 被日志、网页快照和批量文件挤满上下文的问题。它把大块工具输出留在沙箱,只把筛出的片段送回模型,并用 SQLite 保存文件修改、Git 操作、任务和错误。节省上下文很实用,接入点也很深:MCP 与 hooks 会改变工具路由,部署前要核对权限和许可证。
日志和网页快照是上下文的大户。把原始数据留在沙箱很实用,但它会深入工具调用链。
项目地址:https://github.com/mksglu/context-mode
NationalSecurityAgency/ghidra
 88,749
 9,902
Ghidra 是一套成熟的软件分析框架,能对 Windows、macOS 和 Linux 等平台的编译产物做反汇编、反编译、图形分析和脚本化处理。它常用于授权安全审计、恶意代码研究、兼容性排查和软件维护。工具能力很强,使用边界也很清楚:只分析自己拥有或获准检查的目标。
这是老牌工具,不靠 AI 标签吃热度。授权审计和分析场景里,它的插件与脚本体系仍很能打。
项目地址:https://github.com/NationalSecurityAgency/ghidra
affaan-m/ECC
 280,391
 41,702
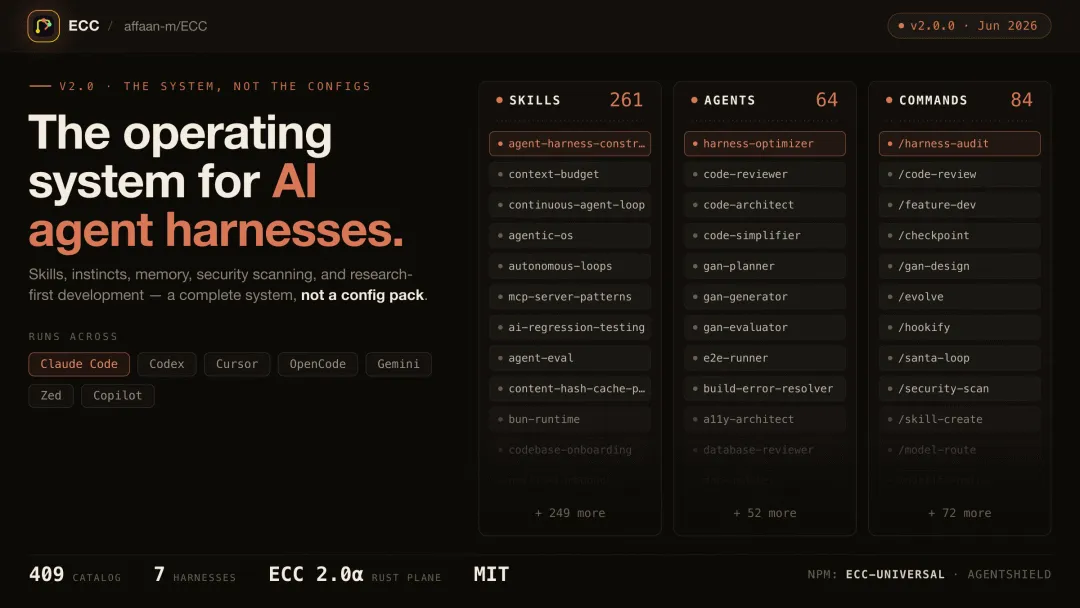
ECC 给编码 Agent 加上一套可安装的工程工作流,包含计划、测试、实现、复查、记忆、技能和配置安全扫描。它对 Claude Code 支持最完整,也提供 Codex 等客户端的适配路径。功能多,安装后会介入 hooks、规则和权限配置,适合愿意统一团队流程的人,不适合不看配置就直接全开。
它把工程习惯做成安装包,适合想统一规范的团队。组件太多时,先小范围启用比一次全开稳。
项目地址:https://github.com/affaan-m/ECC
lightseekorg/tokenspeed
 2,485
 336
TokenSpeed 是面向大模型推理的 Python 引擎,目标是提高 token 生成速度。当前仓库公开说明较少,许可证信息也未明确,因此更适合先做技术跟踪和本地验证,不宜只凭一句性能口号就替换现有推理服务。
仓库资料太薄,先看代码和基准再谈替换。推理引擎的快,必须同时说明模型、硬件和精度。
项目地址:https://github.com/lightseekorg/tokenspeed
xerj-org/xerj
 5,645
 309
XERJ 给代码、文档、日志和 PDF 建立自动索引,让 Agent 用检索代替反复 grep 整个目录,并提供与 Elasticsearch 兼容的接口。它适合代码库问答、知识检索和长期记忆;官方声称可减少大量 token,但仓库信息还不够完整,性能、资源占用和许可证需要在实际环境里核对。
索引一次、反复检索,适合大代码库。是否真省 token,要把建索引时间和资源消耗一起算。
项目地址:https://github.com/xerj-org/xerj
这些项目解决的麻烦很具体:插件散落、科研步骤难复用、日志撑爆上下文、语音素材不想上传云端。挑工具时先看它会改哪些配置、拿哪些权限,再看节省的 token 和时间能不能覆盖新增的维护成本。