ARTICLE · 1200946
VisProg 源码精读:GPT-3 写程序调度视觉模块,零训练怎么做组合视觉推理
VisProg 源码精读:GPT-3 写程序调度视觉模块,零训练怎么做组合视觉推理一张沙漠照片:两个人牵着三只骆驼。问「图里有多少人或动物?」,单步的视觉问答模型经常在这种要拆开数再相加的问题上翻车。VisProg 的做法是让 GPT-3 现场写一段六行小程序:先定位人、再定位动物、分别数框、用 EVAL 把两个数加起来。这个把语言模型当程序员、把现成视觉模型当积木的系统出自 Allen AI 的 Tanmay Gupta 与 Aniruddha Kembhavi 两人,2022 年 11 月挂 arXiv,2023 年 6 月在温哥华拿 CVPR 2023 最佳论文奖(当年投稿超 9000 篇,本奖与 UniAD 同届共获),官方代码在 allenai/visprog。我没有跑推理,下面把论文和代码放在一起读。 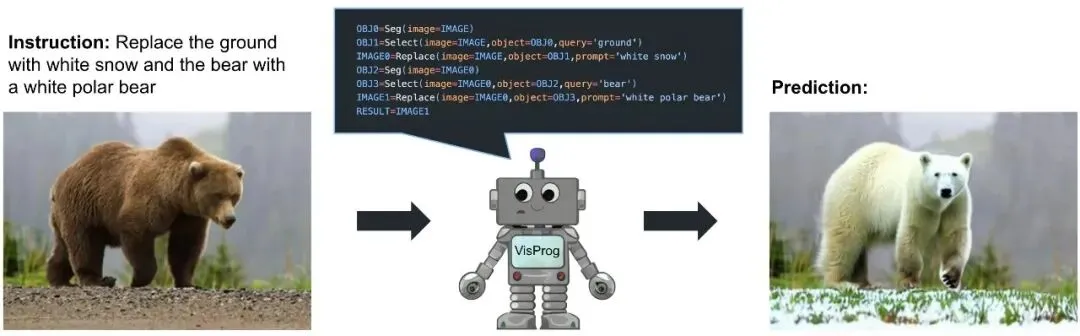
VisProg 解决的是「组合视觉任务没有训练数据」:多步推理、跨图推理、知识标注、语言引导编辑,端到端模型一个任务一份数据一套权重,长尾任务根本顾不过来。改法是把任务拆成两层——GPT-3 在少量示例提示下把自然语言指令翻译成 python 风格程序;解释器逐行执行,每行调用一个现成模型或函数(开放词汇检测、VQA、分割、CLIP 检索、Stable Diffusion 修补、python eval),全程零训练,语言模型和视觉模块都不微调。停在什么条件:上限被两头卡住——程序写错(GQA 上 16% 样本的错误来源)和模块本身不够强(NLVR 换更强 VQA 模块论文估理论提升上限 24%);四个任务里只有 GQA、NLVR 有公开基准,知识标注与图像编辑是自建评测。只想看一处代码,看 engine/step_interpreters.py 末尾的 register_step_interpreters,四个任务各用哪组模块、模块怎么拼装一目了然。 组合式视觉任务的老难题:要「定位戴头盔的人→裁出他左边→看看有没有小卡车」这种链式推理,端到端模型需要针对性的数据与监督。上世纪的神经模块机(NMN)路线想过让程序生成器与神经模块联合训练,但程序生成器本身要专门学。VisProg 赌的是两个前提在 2022 年同时成立:GPT-3 的上下文学习已经能照着示例写程序;视觉侧的现成模型(OWL-ViT、BLIP、MaskFormer、CLIP、Stable Diffusion)已经够好。中间缺的只是一层胶水——一个解释器、一张模块注册表、几份提示模板。 主线是「指令到程序到答案」。指令进 prompter 拼上示例,GPT-3 生成程序;解释器按行执行,行的输出变量存进程序状态,供后面的行消费;执行过程顺手生成一份 HTML 可视化轨迹(论文叫 visual rationale),每步的输入输出都嵌在网页里。README 里那个骆驼问题的真实输出就是六行:BOX0=LOC(image=IMAGE,object='people'),BOX1=LOC(...object='animals'),ANSWER0=COUNT(box=BOX0),ANSWER1=COUNT(box=BOX1),ANSWER2=EVAL(expr="{ANSWER0} + {ANSWER1}"),FINAL_RESULT=RESULT(var=ANSWER2)。 设计一:程序即推理链。每行一个模块调用,LOC 负责开放词汇定位、COUNT 数框、CROP_RIGHTOF 一类空间模块做纯几何裁剪、VQA 问局部问题、EVAL 算表达式、RESULT 收尾。答案之外还白送一份可读的中间过程。 设计二:模块注册表按任务拼装。GQA 用 LOC/COUNT/CROP_*/VQA/EVAL/RESULT;NLVR 只要 VQA/EVAL/RESULT 三件套;图像编辑换上 FACEDET/SEG/SELECT/COLORPOP/BGBLUR/REPLACE/EMOJI;知识标注是 FACEDET/LIST/CLASSIFY/TAG/LOC。换任务不改系统,只改注册表和提示文件。 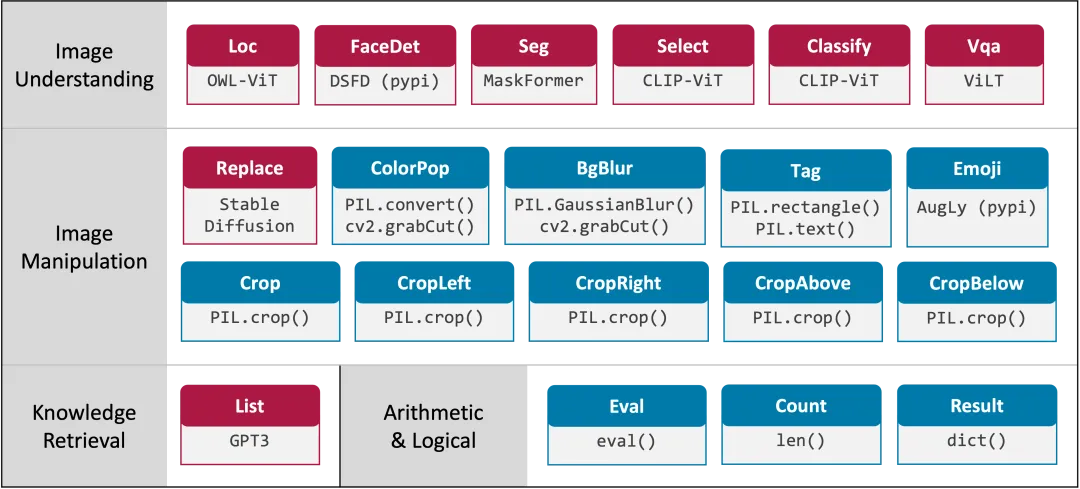
一个必要机制(论文无显式公式,用文字说):程序生成的可信度 p 由 GPT-3 返回的 token logprobs 算——截到结束符、对 token 概率取几何平均(代码里是 exp(mean(logprob)))。三个量:token 概率来自 API 的 logprobs 返回;结束符位置决定截断;聚合方式取均值。论文图 7 的多数投票实验里,五个 run 各自随机采样不同的上下文示例集,对同一问题取共识预测,效果稳定好于单 run。 入口链:notebooks/gqa.ipynb 先建 ProgramInterpreter(dataset='gqa') 与 ProgramGenerator(prompter),generator.generate(dict(question=...)) 生成程序,interpreter.execute(prog, init_state, inspect=True) 逐行执行并渲染轨迹。generator 在 engine/utils.py,解释器与全部模块在 engine/step_interpreters.py,提示模板在 prompts/gqa.py。 对照一:论文第 3 节的程序生成 ↔ engine/utils.py 的 ProgramGenerator: ```python response = openai.Completion.create( model="text-davinci-003", prompt=self.prompter(inputs), temperature=self.temperature, max_tokens=512, top_p=0.5, ...) prob = self.compute_prob(response) ``` 对应关系:prompter 就是论文「指令加少量示例」的拼装函数,GQA 的示例池是 31 条人工标注的指令-程序对;temperature 0.7、top_p 0.5、max_tokens 512 是采样设置;compute_prob 按 logprobs 算程序概率,供投票与诊断用。模型写死 text-davinci-003,换模型改这里一行。 对照二:论文图 2 模块表的 LOC 行 ↔ step_interpreters.py 的 LocInterpreter: ```python self.processor = OwlViTProcessor.from_pretrained("google/owlvit-large-patch14") ... encoding = self.processor(text=[[f'a photo of {obj_name}']], images=img, ...) selected_boxes, selected_scores = nms(selected_boxes, selected_scores, self.nms_thresh) ``` 对应关系:论文图 2 把 LOC 标为「开放词汇定位模块」,代码里就是 OWL-ViT large,查询文本拼成 'a photo of {object}';阈值 0.1、NMS 阈值 0.5 是构造函数默认值;COUNT 模块拿 LOC 的框直接 len(boxes),一行神经网络都不碰。CROP_RIGHTOF 一类空间模块是纯几何裁剪。所有模块统一 parse/html/execute 三段式:parse 用 python 的 tokenize 切程序行取参数,execute 跑模型写状态,html 生成轨迹卡片。 对照三:论文图 4 的视觉解释 ↔ execute(inspect=True) 分支——每个模块的 html() 把本步输入输出嵌进网页,vis_utils.py 负责 pil 图片转 base64 内嵌,串成完整执行轨迹,正是论文拿来做人肉错误分析与指令调优的那份 rationale。 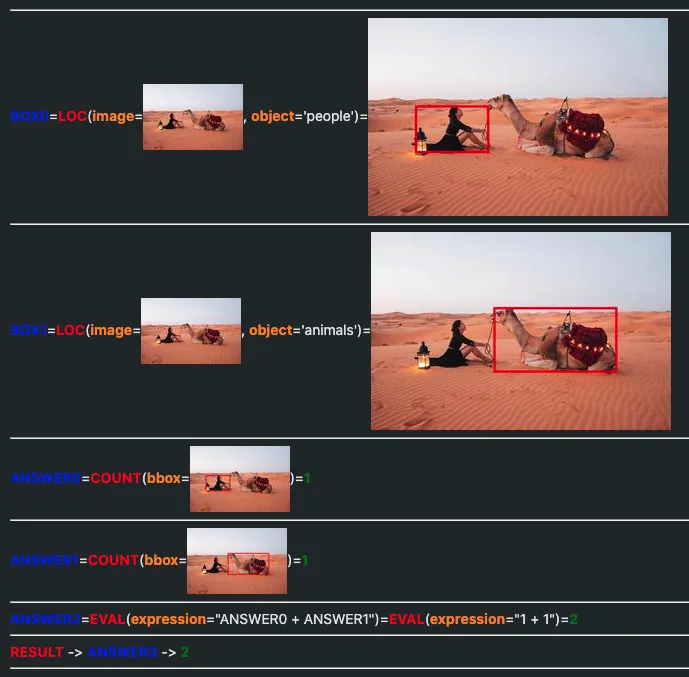
评测集:GQA 从 balanced val(每个细类型采 5 条)与 testdev(每个细类型采 20 条)按问题类型分层采样,覆盖约 100 个细类型——论文明说是为省 GPT-3 的钱;NLVRv2 用 250 条 dev 采样选提示、完整公开测试集报告;知识标注与图像编辑自建(107 条指令、65 张图,人工判语义正确性)。提示:GQA 31 条人工标注示例,投票设置每 run 采 24 条、共 5 个 run,另试 20 条精编提示(16 条真实 + 4 条针对失败案例补写的示例);NLVR 标注 16 条、精编 12 条。模块:LOC 走 OWL-ViT large,VQA 模块在仓库里加载 BLIP-vqa-capfilt-large(论文表格的 GQA 基线是 ViLT-vqa,这个差异下一节说);图像编辑的 REPLACE 用 Stable Diffusion 修补管线。语言模型 text-davinci-003,单次生成 max_tokens 512。最影响可比性的条件:GQA 是子集不是全量,五个 run 的投票把实际见过的示例数放大了 5 倍;论文没写评测硬件清单,从 notebook 形态看单卡可跑,我不往下猜。 按表分开说。表 1(GQA testdev 子集):ViLT-vqa 基线 47.8,VisProg 随机提示(24 条示例)48.2、五 run 投票 50.5(比基线高 2.7 个点)、20 条精编提示 50.0——精编提示用五分之一的计算追平投票。表 2(NLVRv2 完整测试集,零样本、从没在图像对上训练):ViLT-nlvr 微调上限 76.3,VisProg 精编 61.8、随机 61.3、投票 62.4。表 3(知识标注):原指令 tagging F1 63.7、定位 F1 80.6;看过 rationale 后改指令,tagging F1 75.7、定位 84.9。表 4(图像编辑):原指令准确率 59.8,改指令后 66.4。错误解剖(每任务人工看约 100 条轨迹):GQA 最大错误源是程序写错,占 16% 样本;NLVR 的天花板在 VQA 模块,换更强模型论文估最多再涨 24%;知识标注与图像编辑的瓶颈在 LIST 与 SELECT。图 7:上下文示例从少到多,GQA 与 NLVR 的验证集性能一路上升,NLVR 更早饱和——它的程序结构更简单,需要的示范更少。这些数字我都没有跑,全部出自论文表 1 到 4 与图 7、图 8。 已对应:程序生成器与解释器的分工(engine/utils.py 两个类);模块注册表按数据集返回不同字典(register_step_interpreters,正对论文图 2 的任务-模块表);parse/html/execute 三段式模块接口(README 的 COUNT 示例就是官方给的扩展示范)。实现补充:parse_step 用 python 标准库 tokenize 解析程序行,输出变量取第 0 个 token、模块名取第 2 个,参数按名值对解析——程序语法就是「变量=模块(参数=值)」,没有自造解析器;EVAL 模块把 xor 替换成 != 再交给 python eval,yes/no 与数字在进表达式前先转 python 字面量。版本差异不是缺陷:论文第 4.1 节写 GQA 的 VQA 模块基于 ViLT、表 1 基线也叫 ViLT-vqa,而仓库现在的 VQAInterpreter 加载的是 Salesforce/blip-vqa-capfilt-large——接口没变、底座换成了更强的 BLIP;我没有跑,无法断言哪个设置精确对应论文表格数字,读代码时按「模块即插即换」理解,这本来就是论文的卖点之一。 环境:conda env create -f environment.yaml 激活 visprog 环境;需要一个 OpenAI API key——注意代码写死 text-davinci-003,这个 2023 年代的老模型如今 API 侧还能不能调到,动手前先自己确认,不行就改 utils.py 里那一行换新模型。最小样例:notebooks/gqa.ipynb 从头到尾——填 key、载入 assets/camel1.png、问 How many people or animals are in the image?,看它生成六行程序、给出答案和 HTML 轨迹。成功标志:generator.generate 返回程序字符串、interpreter.execute 出 result 与 prog_state。容易看错的地方有三个:ProgramInterpreter(dataset='gqa') 与 dataset='nlvr' 注册的模块集不同,同一句话换数据集走的是不同模块;image_editing 和 ok_det 两个 notebook 还要拉 Stable Diffusion 权重和 augly 依赖,比 GQA 重得多,建议先跑 GQA;EVAL 直接用 python eval 执行拼出来的表达式,跑来路不明的程序行要留个心眼。 有证据的价值:零训练把四个任务串在一张模块表上,GQA 抬 2.7 个点、NLVR 零样本 62.4 对微调上限 76.3,还白送一份可读的执行轨迹——正是这份轨迹让「看错误在哪、改指令再跑」成为工作流,知识标注 F1 从 63.7 提到 75.7 就是这么来的;论文之后,LLM 编排视觉工具成了一个大方向,仓库 README 顶上挂的 CodeNav 就是同班人马的续作(迭代写代码、执行、看输出再改)。限制:天花板两头卡死,程序生成错误占 GQA 错误的 16%,模块能力封住 NLVR 的上限;GQA 为省钱只评了分层采样子集;知识标注与图像编辑是自建小评测,说服力弱于公开基准。推测部分:换上今天的语言模型与开放词汇检测,程序错误那一块应该能压下去不少,但论文没做这个实验,这是我的判断,不是论文结论。作为 CVPR 2023 最佳论文,它把「不训练」做成了系统级优点,适合连着代码一起读。 论文:Visual Programming: Compositional visual reasoning without training,arXiv 2211.11559,CVPR 2023,https://arxiv.org/abs/2211.11559 获奖核实:IEEE CS TC-PAMI「CVPR Paper Awards」官方页,https://tc.computer.org/tcpami/awards/cvpr-paper-awards/(2023 年 Best Paper Award:Visual Programming 与 Planning-oriented Autonomous Driving 两篇) 代码:https://github.com/allenai/visprog(main 分支,2026-10-17 访问;AI2 官方,论文作者 Tanmay Gupta 与 Aniruddha Kembhavi 维护) 要读的源码:engine/utils.py、engine/step_interpreters.py、engine/nms.py、prompts/gqa.py、notebooks/gqa.ipynb、vis_utils.py 项目页 https://prior.allenai.org/projects/visprog 与 AI2 博客(README 所列)
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
0.7