ARTICLE · 1214227
RichHF 源码精读:从打一个分到指出错在哪,CVPR 2024 最佳论文怎么把人评变成可学的信号
RichHF 源码精读:从打一个分到指出错在哪,CVPR 2024 最佳论文怎么把人评变成可学的信号文生图的老毛病谁都见过:手指多长一根、台灯浮在半空、提示词写「跳进河里」图里的人却站着。CVPR 2024 最佳论文 Rich Human Feedback 做的事很朴素:别只打一个总分,把「错在哪」也标出来,再教模型学会挑错。 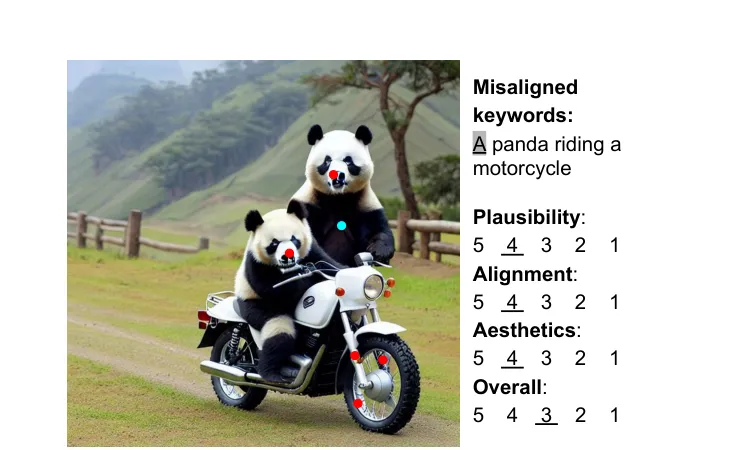
论文交付三样东西:一万七千多张生成图的富反馈数据集 RichHF-18K、预测反馈的多模态 Transformer RAHF、拿反馈改进生成的两条路径。富反馈指四类 5 级评分(合理、对齐、美感、总体)、两张热力图(伪影、图文错位)、一串词级标签。 数字上:测试集合理性分数预测 PLCC 0.693,错位热力图全样本 MSE 0.00303,不到 CLIP gradient 基线 0.00817 的一半;预测分数筛数据微调 Muse 后,六人盲评 51.8% 认为更好、16.8% 认为更差。 冷水先说:官方开源只到数据侧——数据集 tfrecord 加两个解析对齐脚本,RAHF 本体和训练微调代码都没放出。想快速看懂,读 parse_tfrecord_file.py 一个文件就够。 论文自己的人工评估结论难看:Pick-a-Pic(五十多万张 SD 系变体生成图)里只有约 10% 完全没有伪影和不合理,毛病集中在结构崩坏、物理说不通、图文各说各话。 现有评价工具不给这些信息:IS、FID 是分布级指标,对单张图无话可说;ImageReward、PickScore、HPS 再准也是一个标量,差在哪、哪个词没画出来都不体现;问答式评测细但贵,也不定位。 离得最近的先行工作(Zhang et al., ICCV 2023)只标伪影区域;按论文的梳理,错位、错词和四类评分一起收进一个数据集是头一份——评价到不了「怎么改」,改进生成只能盲筛。 主线一句话:把人挑错的过程原样搬进数据——标注者看图和提示词,点伪影点和错位点、点选画错或画漏的词、打四个分,三人各标一遍合并成训练目标,让模型预测全部。 合并规则值得记:点标注不取交集,每个点铺成半径为图高二十分之一的圆盘热力图,三人再逐像素平均——都点过的位置自然变亮,手滑被平均掉;四个分数取平均,错词多数投票。选样用 PaLI 的 VQA 预筛(照片级真实、五类目平衡),从 Pick-a-Pic 抽 17K 做训练验证,加测试集共 18K。 再让一个模型同时输出三样。RAHF 用 ViT 编码图像、文本嵌入编码提示词,两组 token 拼接过自注意力双向融合(文字向图判错位,图像向文解错词)。三组头分头出活:热力图头把图 token 重排成特征图过卷积、反卷积加 sigmoid;分数头过卷积和线性层;错词头是 T5X 解码器,训练目标是给错词缀「0」后缀的改造版提示词。 变体两种:multi-head 七个任务各配一头;augmented prompt 只留三个头,提示词前拼任务字符串(如「implausibility heatmap」)按任务切换。训练损失是三项加权和: L = λ1·L_heatmap + λ2·L_score + λ3·L_sequence 只解释三个量:L_heatmap 是热力图逐像素 MSE,L_score 是分数的 MSE 回归,L_sequence 是错词序列的 teacher-forcing 交叉熵;λ 是权重,数值正文没给。 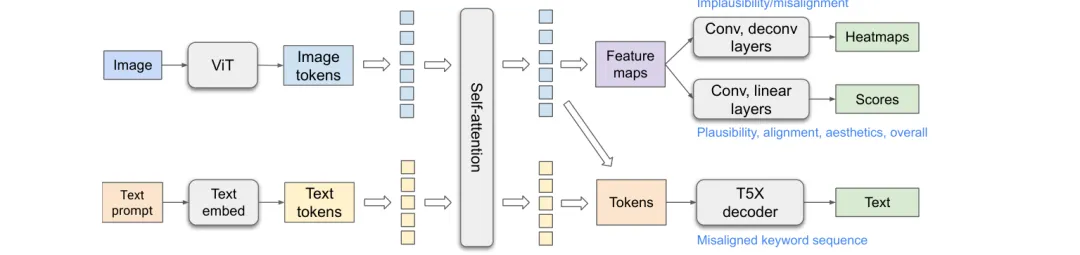
读法先说清:官方仓库 richhf_18k 文件夹只有两个 Python 脚本,都在数据侧,没有入口到推理的调用链,RAHF 模型侧没开源;两处对读,代码逐行读过、没跑。 第一处,论文第 3 节说数据集含两张热力图、四个细粒度分数、一串错位词标签,对应 parse_tfrecord_file.py 第 34 到 54 行: artifact_score = feat_map['artifact_score'].float_list.value[0] misalignment_score = feat_map['misalignment_score'].float_list.value[0] artifact_map = feat_map['artifact_map'].bytes_list.value[0] artifact_map = tf.image.decode_image(artifact_map, channels=1).numpy() 四类评分逐字段落进 tfrecord:aesthetics_score、artifact_score、misalignment_score、overall_score;README 写明分数越高越好,artifact_score 高表示伪影更少,对应标注界面的 Plausibility 栏。热力图按代码注释是 512×512、值域 0 到 255 的单通道图,正是点标注铺圆盘三人平均的产物;filename 注释写明可映射回 pick-a-pic 数据集,对上论文 3.3 节的选样来源。默认行为与实验选择要分清:读一条就 break、路径写死 train.tfrecord 是演示行为;三人平均和多数投票在标注平台侧,没随代码放出。 第二处,错词标签怎么对齐到词,match_label_to_token.py 第 35 到 44 行: delimiters = ',.?!":; ' pattern = '|'.join(map(re.escape, delimiters)) tokens = re.split(pattern, prompt) misalignment_label = [int(l) for l in misalignment_label.split(' ')] assert len(tokens) == len(misalignment_label) 这几行回答「错词标注的粒度是什么」:按标点和空格把提示词切成词序列,一条空格分隔的 0/1 串逐词对应,0 表示这个词画错了(解析脚本注释原话:0 misaligned、1 aligned),与模型侧错词缀「0」后缀正好咬合。assert 长度相等是一道一致性闸门:发布数据里标签数与切词数严格相等。 数据:RichHF-18K,论文口径 16K/1K/1K,README 精确口径17,760 = 15,810 训练 + 995 验证 + 955 测试;图本体不在数据集里,只有文件名,要回 Pick-a-Pic v1 对取。 优化对象 RAHF 改自 Spotlight,预训练混入 WebLI 图像描述;16K 训练、1K 验证调超参,步数学习率硬件都放补充材料。基线:两个微调 ResNet-50(分头预测分数和热力图)、现成 PickScore、现成与微调 CLIP、CLIP gradient。 生成侧:Muse(masked transformer 家族,与标注图的 SD 系不同)对 12,564 个提示词各生成八张,每提示词取预测分最高的一张、过固定阈值(合理分示例 0.8)进微调集,论文称这是简化版 DPO;另一路把美感分当 classifier guidance 加到 Latent Diffusion。 最影响可比性的:基线多是现成或轻度微调模型,和专训的 RAHF 容量、待遇不对等,领先幅度看语境;同条件比较只在两个变体之间。 分数预测(表一):合理性分 augmented 版最好,PLCC/SRCC 0.693/0.681;美感分 multi-head 0.605/0.591 略胜 0.600/0.589;对齐分 multi-head 0.487/0.500 高于 0.474/0.496;总体分两版打平。现成 PickScore 的合理性分只有 0.0098/0.0280。两个变体各占两样最优,拼不出全面更好。 伪影热力图(表二):全数据 MSE 上 ResNet-50 的 0.00996 好于 multi-head 的 0.01216,augmented 的 0.00920 又反超 ResNet-50——论文的解释:七个头共用一套特征图难以兼顾,拼任务字符串后按任务切换。非空真值上 augmented 的 NSS 3.085、AUC-Judd 0.913;空真值 69 例。 错位热力图(表三):本模型全数据 MSE 0.00303/0.00304,CLIP gradient 是 0.00817;空真值子集更悬殊,0.00006/0.00015 对 0.00551;空真值 144 例。论文承认错位热力图更难学,归因边界模糊、标注噪声大。 错词序列(表四):F1 43.3 对 43.9;查准 62.9/61.3,查全只有 33.0/34.1——找得准、漏得多。 生成改进(表五):六个人对 100 个新提示词盲评,微调后的 Muse 显著更好 21.5%、略好 30.33%、差不多 31.33%、更差合计 16.84%(评的人只有六位)。图八图九的定性例子(微调前后、guidance 前后、热力图成 mask 重绘)我没有复现。 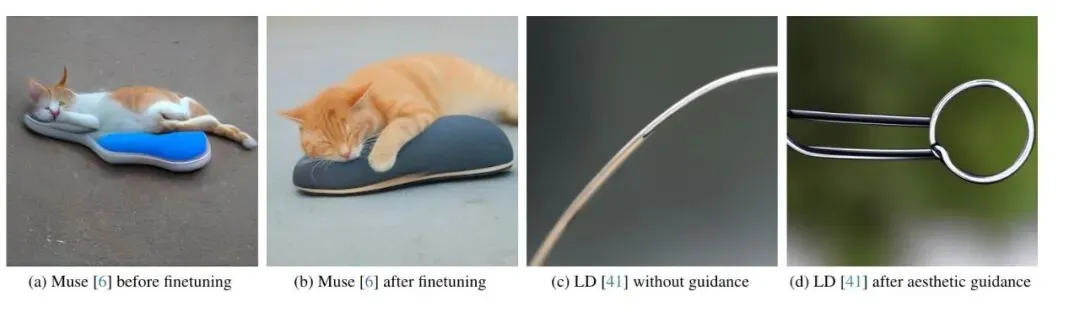
已对应的:反馈维度体系对 tfrecord 八字段,错词粒度对切分对齐函数,数据来源对 filename 注释与 README 的 Pick-a-Pic v1 说明;三人平均和投票在平台侧、不在代码里。 如实说明:官方放出的是数据侧,RAHF 模型、损失实现、Muse 微调管线都没开源;想跑模型,要么照论文自己搭,要么找社区复现(非官方)。 只是配置选择的:示例脚本的写死行为是定位使然。口径差异记一笔:论文表二表三标题写「995 test samples」,README 写 955 测试、995 验证,总数一致单项对不上,复现切分按 README 走。 环境:Python 3、TensorFlow、absl。数据集仓三个 tfrecord 存在 Git LFS 里,先装 LFS 再克隆,否则拿到指针文件。 最小样例走数据侧:克隆数据集仓拿 train.tfrecord,改对解析脚本的路径跑起来,应打印一条样本的文件名、四个分数、两张 512×512 热力图形状和词级标签串;标签串配 Pick-a-Pic 提示词喂给 match_label_to_token.py,得到词与 0/1 配对;artifact_map 叠回原图,肉眼核对点标注。模型侧要自己搭 ViT 加 T5X、三组头和加权损失,超参不在正文。 成功标志:解析脚本打出热力图形状与值域注释,对齐脚本的 assert 不报错,字段非空。容易看错的是 artifact_score 的方向:越高越好、越高伪影越少,反过来理解后面全错;同理 0 标的是画错的词。 有证据的价值:同一张崩坏的图,单标量只能排序,热力图加错词能直接说「这只手崩了」「yellow 没画出来」;跨家族改进有正面证据:标注来自 SD 变体,改进落在另一架构的 Muse,盲评偏向微调版。数据资产干净:八字段、三人标注、词级标签与切词数严格相等,接入门槛很低。 限制也明摆着:模型侧零开源,RAHF 和微调实验没法原样复跑,精读只能到数据管线为止;数据全部来自 Pick-a-Pic v1,对这两年新出的模型家族覆盖率如何(推测)要打问号。 落到操作上:数据集是真资产,模型是论文级描述。想用它,先把 15,810 条训练标注解析通、词级标签对齐跑顺,再决定要不要照论文把 RAHF 搭出来。 论文:Rich Human Feedback for Text-to-Image Generation,CVPR 2024(Best Paper Award),https://openaccess.thecvf.com/content/CVPR2024/html/Liang_Rich_Human_Feedback_for_Text-to-Image_Generation_CVPR_2024_paper.html arXiv 版:arXiv 2312.10240 官方代码:https://github.com/google-research/google-research/tree/master/richhf_18k(master 分支,2026-10-19 访问) 数据集仓库:https://github.com/google-research-datasets/richhf-18k(tfrecord 走 Git LFS) 对读脚本:richhf_18k/parse_tfrecord_file.py、richhf_18k/match_label_to_token.py
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
05 实验配置
06 结果怎么看