ARTICLE · 1219473
Field AI CEO Agha→再多数据也治不好机器人幻觉
「Ali Agha on Robot Hallucinations, Physics, and Real-World AI」
2026.07
共同学习,终身成长
记录AI跨越虚实的每一步演化
若有帮助,欢迎关注、点赞、转发支持^ ^
Brian Heater 在芝加哥 Automate 展会的现场录制里采访 Field AI 创始人兼 CEO Ali Agha——一个做过火星直升机、带四足机器人钻进火星模拟洞穴、拿过 DARPA 地下挑战赛城市阶段全球冠军的人。这是一次关于"幻觉"的对话,只不过主角不是聊天机器人,而是要在建筑工地里干活的真实机器人。当整个行业都在把 ChatGPT 的配方搬进物理世界——用一个大模型吞下图像和 LIDAR、直接吐出下一个动作——Ali 的判断是:
Field 因此把自己定义成一家卖"大脑"的软件公司,这个大脑已经跑在 34 种不同形态上、横跨三大洲数百个现场执行数千次任务;本篇最值得看的,是他如何用十年空间与野外机器人的积累,把"边缘情况"从长尾变成架构的第一性设计前提。
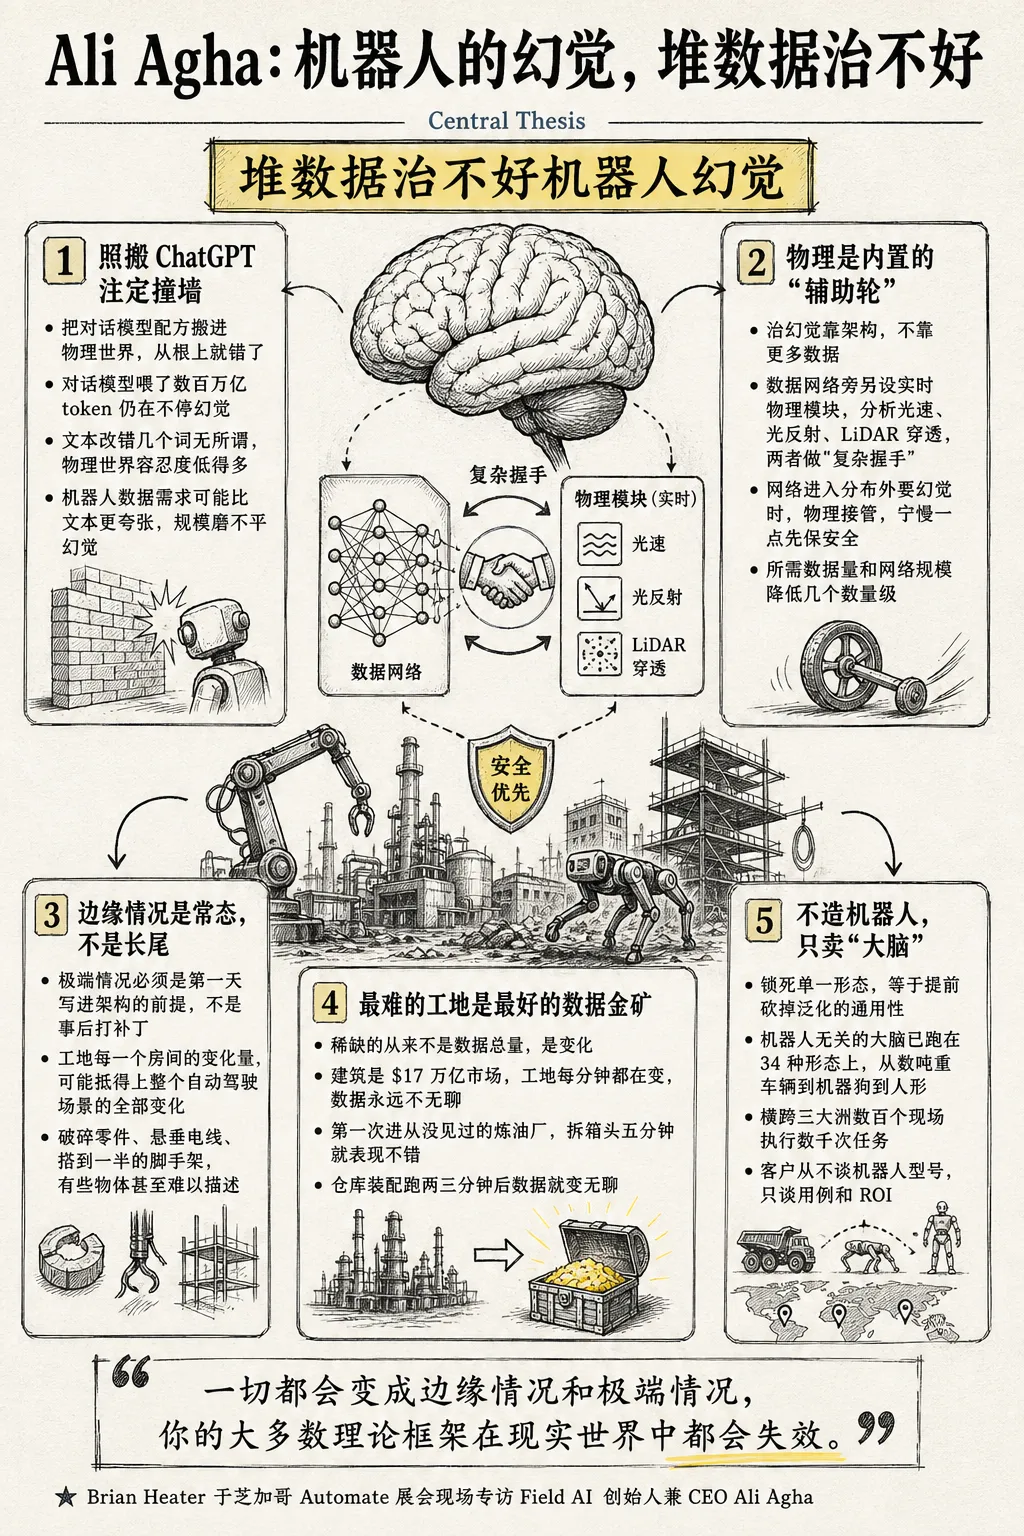
照搬 ChatGPT 注定撞墙:把对话模型的路线搬到机器人——用一个单体大模型吞图像和 LIDAR、生成下一步最优动作——不仅数据需求可能比文本的数百万亿 token 更夸张,而且即便如此仍会不停幻觉。文本里改错几个词无所谓,物理世界的风险容忍度低得多,所以 Ali 拒绝把幻觉当成一个能靠规模解决的"数据问题"。
物理是内置的"辅助轮",不是更好的仿真数据:Field 在数据驱动网络旁边放了一个实时算法模块,分析光速、传感器、光反射、LiDAR 穿透来推断当下的物理,两者做"复杂握手"——当网络进入分布外、要开始幻觉时,物理模块接管,宁可慢一点也先保证安全。副作用是所需的数据量和网络规模都降低几个数量级。
建筑工地是最好的数据金矿:Field 不挑最容易的仓库搬箱,而是从工地、油田、灾后现场这类最难的环境入手——$17 万亿市场、每分钟都在变、数据"永远不无聊";第一次进从没见过的炼油厂,靠工地积累的变化迁移过去,拆箱头五分钟就能表现不错。
Ali 的履历本身就是论据。15 年前他在 MIT 认识联合创始人 Shy(后者去了 DeepMind 做基础模型),随后带着算法进了 Qualcomm,把自主方案塞进 Snapdragon 这种轻量低功耗处理器——NASA 正是看中这一点找上门,最终 Mars Helicopter 带着 Qualcomm 芯片飞上了火星。在 NASA JPL,他成为空中移动团队负责人,发起十多个项目,其中两个演化成了 DARPA 挑战赛。真正的转折是野外部署:他们完成了人类历史上第一次让足式机器人在没有人工干预、没有地图、没有 GPS、没有任何预定义信息的情况下深入火星模拟洞穴数公里;在 DARPA 地下挑战赛峰值时一次派出 11 台机器人(4 台足式、4 台轮式、3 台飞行)进入完全未知的地下工业环境,团队一度 70-80 人,疫情前拿下城市阶段全球冠军。外界习惯把自主能力的进步看成自动驾驶的线性延伸,忽略了 DARPA 把问题从"有路、有 GPS、有先验"一路推到"零先验信息"这一次范式跳跃——而正是这十年让他得出一个结论:一旦进入现实世界,一切很快就会偏离正常状态,你的大多数理论框架都会失效——没有高斯噪声,没有线性系统,没有预定义路径。这句认识,就是 Field AI 的地基。
“everything is going to become edge case and corner case and most of your theoretical frameworks break in the real world.”
“一切都会变成边缘情况和极端情况,你的大多数理论框架在现实世界中都会失效。”
自动驾驶圈把边缘情况当成 99.999% 之外那一小撮长尾,先在实验室做出方案,再到现实里加封装、加安全防护"打补丁"。Ali 说这套顺序本身就是错的:把极端情况当事后补救,等于假设你的实验室架构能迁移到现实。他给的对照极其具体——自动驾驶虽然不能优化世界,但世界有结构:车道数量已知、出口位置已知、有 GPS、要面对的物体是汽车行人人行道这类有限集合;可一旦进了建筑工地,每一个房间的变化量,可能就抵得上整个自动驾驶场景的全部变化——破碎的零件、悬垂的电线、滴落的水、搭到一半的脚手架、正在安装的楼梯、四处走动的人,有些物体你甚至难以描述它是什么。当机器人的最大市场(TAM)本质上是"像人一样被塞进为人设计的非结构化环境、一对一或一对多地放大人的产能"时,边缘情况就不再是要收尾的长尾,而必须是第一天就写进架构的前提。
“with that hundred trillions of tokens of data in conversation are you still hallucinate all the time... when it comes to real world and physical world the tolerance is much much lower.”
“即便用了数百万亿个对话 token,系统不还是一直在幻觉吗……而到了现实世界和物理世界,容忍度要低得多。”
把这个领域放进二维坐标系:一条轴是泛化(约等于数据),一条轴是架构(约等于可部署性与安全)。多数人只看第一条轴,直接把 ChatGPT 的成功平移——拿一个大型单体神经网络,把词语文本换成图像和 LIDAR 扫描,训它生成下一步最优动作。Ali 指出这套复制里藏着一个被忽略的前提错误:对话模型之所以能容忍幻觉,是因为语言的风险容忍度高——你可以改掉文章里的几个词;物理世界抽走了这层容忍度,而数据需求只会更夸张。文本需要数百万亿 token,机器人的变化更多、需要多少没人知道,可即便喂到那个量级,幻觉依然存在。所以 Field 不接受"把它当数据问题、用规模去磨平幻觉"这条路——问题不在数据不够,而在架构默认了一个物理世界不允许的容错前提。
当人们谈物理,通常指仿真:搭一个尊重物理规律的仿真环境,生成更好的数据。Ali 说那和他讲的物理是两码事——把物理烘进仿真,得到的还是"更好的数据",本质仍是纯数据驱动的方案,只是数据质量更高而已。Field 的做法是在数据驱动网络之外,另放一个很重的算法模块,在系统移动时实时分析光速、传感器、光反射、LiDAR 的穿透特性、摄像头与 IMU,用算法直接推断周围的物理;这个模块和数据驱动模块做一次"复杂握手",判断数据驱动的部分何时进入没见过的状态要开始幻觉,而物理部分何时有十足把握、可以说"这件事交给我"。这背后是十年硬功夫——他们求解过 Fokker–Planck 方程这类偏微分方程,用它刻画随机微分方程上的概率分布如何演化,从而算出走左路还是右路各自的不确定性。把这些算法信息通过正确的 tokenization 放到网络内部正确的位置,网络就不必从零学起:他用了个比喻,这像是给学骑车的孩子装上辅助轮,模型因此知道自己能力的边界在哪、一旦开始偏离就有指标提醒它"我要幻觉了,慢下来、多看看、多收点数据"。误区就在这里——很多人以为"加物理"是让数据更干净,实际 Field 是让物理成为一个会实时算账、会举手的活模块,而不是喂进去就冻住的先验。
地下 900 英尺、灰尘、雾、烟、忽明忽暗的光照——感知退化环境恰好是物理最能发力的样板。直觉是:光线这么差,得靠更强的神经网络硬看懂每一帧。Ali 说这正是搞反的地方:不同波长的传感器行为不同——热成像能穿透灰尘,LiDAR 对雾和尘有各自的退化曲线,RGB 相机在低照度下吃力——你可以不靠神经网络理解每一个细节,而用物理去算这些传感器之间的共识、差异和相关性。他给的机制极其具体:系统会盯着某个矩阵的特征值,当特征值显示"基于 LiDAR 的定位组件即将退化、即将失效",热成像或 RGB 就顺势接管;每个通道都带着自己的不确定性,系统据此给它们分配权重、决定谁说了算。这一整套计算对神经网络只是"建议"——数据驱动模块仍是主角,但它现在同时看到原始数据和这些物理算出的表征,学得更快、用的数据更少、韧性更强。错的不是"用神经网络",错的是让神经网络独自去重做物理本可以直接算出来的那部分。
Field 用了四种数据源——仿真、视频、遥操作,以及真正改变局面的第四条:机器人在真实客户工作流里采集的数据。但这里有个人人都懂的死结:你说要靠部署去采数据,可没有数据又训不出能部署的模型,两者互为前提。Ali 承认——这个先有鸡还是先有蛋的困境,对端到端单体方案确实成立,因为它一切都以数据为基础,你得攒够海量数据才能做一个小众应用,还未必治得好幻觉,于是陷入不断推迟的恶性循环。Field 绕开它靠的还是架构那一环:当机器人撞上分布外、从没训练过的东西,数据驱动组件本该开始幻觉,此时物理组件介入,让它慢一点、效率低一点但保持安全;而这份安全恰恰让机器人能从那个"它此前不了解的要素"里采到数据,这些数据又最大程度地推动模型演进。飞轮因此从第一天就转起来——而且他强调一切都在端侧完成,不连云、不用 5G、不靠 Wi-Fi,全部跑在机器人本体上。
“in construction, the data is never boring. Every hour, it gets better.”
“在建筑业中,数据永远不会变得乏味。每过一个小时,它都会变得更好。”
隔壁人形机器人论坛的共识是先做仓库和工厂,因为家庭"太不规则、太难"。Ali 反其道而行,理由不只是建筑是个 $17 万亿、极度渴求提效的大市场,更在于数据质量:工地每分钟、每小时都在变,数据丰富度远超他们部署过的任何领域。他点破了"先挑简单环境攒数据"的隐藏代价——装配应用跑个两三分钟,安保或物流跑上数小时数天,数据就"不再有意思"了,因为你要的永远是分布外的、新的东西,而结构化环境很快把新意榨干。他举了个硬例子:第一次进一家石油天然气炼油厂,此前从没有过这类环境的任何数据,但机器人第一天表现就相当不错——因为它在无数工地上见过足够丰富的变化,拆箱部署的头五分钟就能对一个从没见过的炼油厂形成足够理解;三个月后自然更好。而且这套数据无需雇几千人去改环境或遥操作,自主系统每分每秒都在把 PB 级数据灌进训练集。真正稀缺的从来不是数据总量,是变化。
越来越多以训练大型 Physical AI 模型起家的公司开始自建全栈、下场造人形机器人——他点名了 Rode AI 和 Genesis。Ali 明确说这不是 Field 的方向(虽然"不排除将来某天做")。他的理由来自一线触点:客户几乎从不说"我要那款机器人",谈的永远是用例——"我想解决这个问题、提高 ROI、给这台机器人加三只手、再多一根手指、把双臂装到轮式底盘上"。他看到的趋势是趋同越来越少、分化越来越多,所以把自己锁进单一形态反而缩小机会。Field 因此是一家卖"大脑"的软件公司,这个与机器人无关的大脑今天已经跑在 34 种不同形态上、从数吨重的大型车辆到小机器狗到人形机器人,其中相当一部分已由付费客户在真实场景使用。锁死一个模型看似聚焦,实则是把"泛化"这件事的通用性提前砍掉了——正如结尾那句:要实现泛化,最终需要的是很强的通用性。
“特征值"细节——系统不是靠神经网络硬看懂灰尘和雾,而是用矩阵特征值判断 LiDAR 定位快要退化、然后让热成像接管。这说明"物理"在 Field 这里是一个会实时算账、会举手说"这个交给我"的活模块,而不是喂进模型就冻住的仿真数据,和大多数人理解的"物理仿真"完全不是一回事。第二个改变判断的是数据观:行业默认数据越多越好、先挑仓库搬箱攒数据,但 Ali 说装配任务跑两三分钟后数据就变无聊,最难的工地反而每小时都在产出分布外样本——稀缺的从来是变化,不是总量。还有先有鸡还是先有蛋那段:它其实只是单体数据驱动方案的陷阱,换个架构就不存在——很多"必须先有数据才能部署"的行业共识,可能只是被错误架构逼出来的伪命题。”
本文译自公开演讲原文,仅供学习交流,版权归原作者所有。译文可能存在偏差或遗漏,不代表原作者立场,欢迎指正。本文不构成投资建议和商业行为。