ARTICLE · 1228604
从会用 AI 到能开发 AI:我的学习路径与 NVIDIA NCA 认证实践
有段时间,我的简历上写着“熟练使用AI工具”。
那会儿我确实用得挺溜。ChatGPT帮我写代码,Midjourney出图,各种Prompt技巧也摸得七七八八。然后有一天,我刷到一个国内某大厂的AI工程师JD,要求里写着:“熟悉Transformer架构,有RAG系统开发经验,了解模型量化与推理优化。”
我看着那几个词愣了好一会儿。RAG(检索增强生成,让大模型“查资料”再回答的技术)知道是什么,但真要从零搭一个?Transformer结构读过一篇介绍,但Attention机制的矩阵运算我说不清楚。量化?我只知道模型文件有个4bit版本,跑起来省显存。
我用了两年AI,结果发现自己对AI一知半解。
这篇文章想聊聊,从那个懵的时刻开始,我是怎么一步步把知识体系补起来的,以及为什么最后选了NVIDIA NCA认证当阶段性验收。
第一阶段:我以为会用就是懂
大概在AI大模型刚火起来那阵子,我和很多人一样被ChatGPT震到了,开始大量使用各种AI工具。那段时间效率确实高,写代码有Claude辅助、写文档有AI润色、搜资料也不再愁。我甚至觉得,AI时代的开发者就该这样——用好工具就行,底层原理交给模型厂商去操心。
这个想法在我第一次尝试“定制化”需求时彻底崩了。
当时我们团队想做一个内部文档的智能问答,要能检索公司内部知识库,不是随便调个API聊天。我去研究,发现搜索结果全是“RAG”、“Embedding”、“向量数据库”之类的词。Embedding我大概知道是把文字变成数字向量,但具体怎么选模型、向量维度对检索质量有什么影响——完全不知道。
折腾了一个月,拼拼凑凑跑起来了,但效果一塌糊涂,问一个问题经常答非所问。我改了无数Prompt,也换了好几个开源库,始终找不到根本原因在哪。
那会儿我终于明白一个道理:会用工具,不等于理解工具。底层知识没有,调参调到天黑也不知道方向。
第二阶段:补课补到怀疑人生
于是过了一阵子,我开始系统地补基础。神经网络、反向传播、注意力机制(Attention,让模型“关注”输入中重要部分的核心机制)、Transformer架构……
这段时间是我学AI以来最痛苦的阶段。
卡得最久的是Transformer里的自注意力机制(Self-Attention)。理论看了好几遍,就是不知道它“为什么管用”。后来我换了个思路——把Attention的计算过程手写了一遍,硬算了一个最小的矩阵乘法例子,才真正想通:它本质上是在计算序列中每个词对其他词的“相关性权重”,让模型理解上下文,而不是孤立地处理每个词。
想通那一刻,以前想不明白的事开始有线索了:上下文越长,模型通常需要处理的计算量就越大;RAG 则通过检索外部资料,把相关信息补充到模型的上下文中。它们不是同一种机制,但都与系统如何利用上下文信息有关。原理通了,再看那些工具,处处都解释得通。
但这个阶段也有明显问题:学的东西比较散。今天看LLM原理,明天研究向量数据库,后天又去啃CUDA(NVIDIA开发的并行计算平台,让GPU能跑AI任务的关键技术)基础。没有系统框架,总觉得自己学了很多,又说不清自己到底什么水平,心里发虚。
第三阶段:真刀真枪,用项目检验自己
又过了一段时间,我逼自己开始做实际项目。
第一个项目是RAG知识库系统。
用Python + LangChain + 向量数据库从零搭了一个能检索公司内部文档的问答系统。第一个月上线效果还是不理想,后来我系统研究了文档切分策略(chunk size对检索质量的影响远比我想的大)、Embedding模型的选择(中文文档用专门的中文Embedding模型效果差异显著),以及Prompt的结构化设计。第二版上线后,我测试的问题中,检索命中情况和回答相关性都有明显改善,同事开始真正用起来,这才算踏实了。
第二个项目是本地大模型部署实验。
我买了一张二手显卡,开始折腾Llama、Qwen、DeepSeek这些开源模型的本地部署。这个过程中我第一次真正接触到显存管理、模型量化和推理框架(vLLM、Ollama等)。量化是用较低位宽表示模型权重或部分计算,例如将 FP16/BF16 权重压缩到 4-bit,从而降低显存占用与带宽压力,实际的精度损失取决于模型、量化方案和具体任务。中间踩了无数坑:显卡驱动版本不对跑不起来、量化格式不兼容、批处理配置不当导致推理速度拉胯……每个坑都让我多懂了一点底层。
第三个项目是Agent流程实验。
尝试用AutoGen和LangGraph搭了一个多Agent协作原型,让几个模型分工合作完成复杂任务。这个项目让我意识到:Agent难的不是单个模型能力有多强,而是任务怎么拆、状态怎么管、异常怎么处理,这些全是工程问题,跟AI研究是两码事。
这三个项目做下来,我感觉自己从“会用 AI 工具”走到了“能开发 AI 应用”。但我也意识到知识体系还是有很多空洞,需要一个更系统的方式来梳理和验证。
从会用工具,到理解原理,再到独立做出项目。
为什么选NCA认证来做验收
在考虑认证之前,我也比较过不同体系的证书。Google Cloud 的机器学习认证更强调在其云平台上设计、构建、部署和监控机器学习方案;NVIDIA NCA 系列则有生成式 AI 大语言模型和多模态生成式 AI 等不同方向。它们的定位不同,选择时应该看认证内容是否符合自己的学习目标,而不是简单比较哪张证书更有含金量。
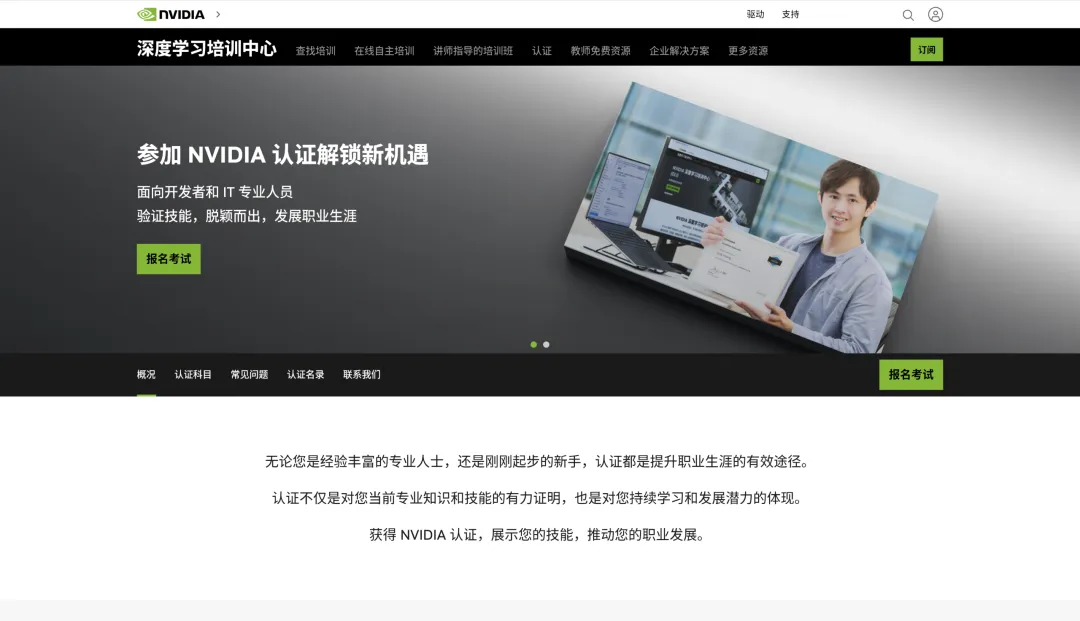
NVIDIA 官方认证入口:https://www.nvidia.cn/training/certification
NVIDIA 官方认证页面,面向开发者和 IT 专业人员,提供 Associate 和 Professional 两个级别。
根据官网最新信息,NVIDIA认证体系目前分为 Associate(NCA) 和 Professional(NCP) 两个级别,覆盖生成式AI、数据科学、AI基础架构等方向。对开发者来说最相关的几个:
考试为线下进行,中国区公布的考点包括北京、上海、苏州和深圳,支持中文或英文作答。通常可以在考试结束时看到通过或未通过的结果,24小时内收到邮件通知;通过考试后,电子证书也会在24小时内发送到邮箱。数字徽章通过 Credly 获取,可以分享到 LinkedIn 等职业社交平台。此外,NVIDIA 还提供官方认证名录,供外部查询持证人的认证信息。具体考试时间和考点安排,以官网最新公告为准。
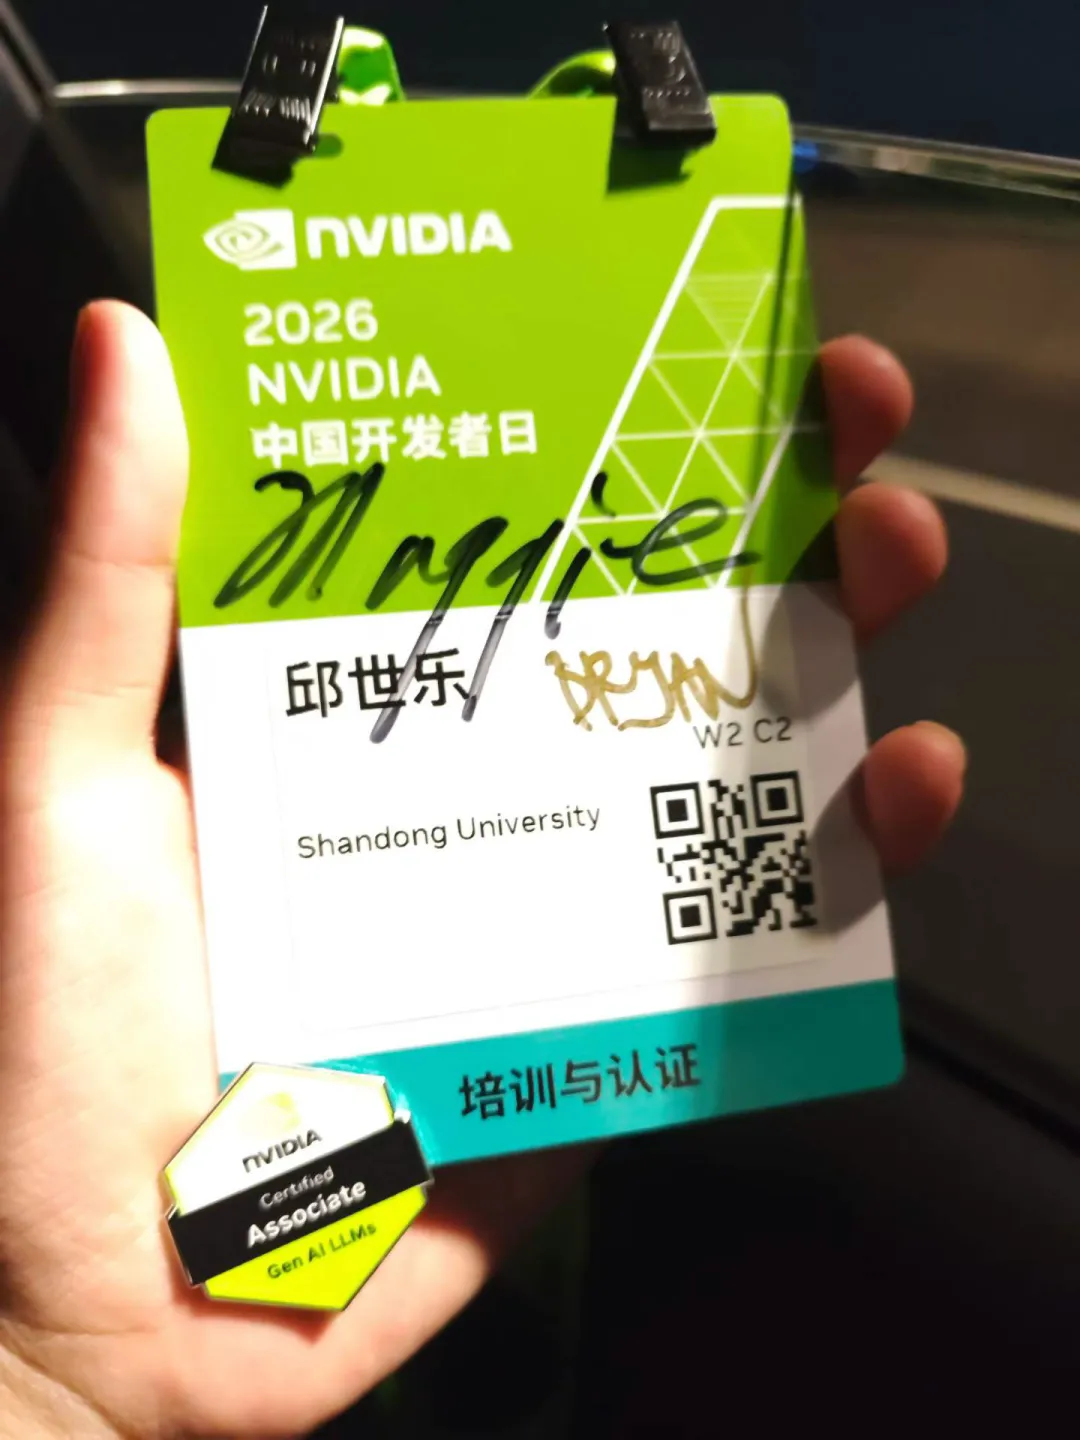
学习之外,也给自己留下一份真实的阶段记录。
对我来说,NCA-GENM的价值在于,它把生成式AI的基础知识、多模态数据、实验设计、软件开发、性能优化与可信AI等主题组织成一份可以系统复习和检验的清单。至于RAG、Agent和模型部署,我更多是通过实际项目来积累经验。认证是阶段性验收,而不是项目能力的替代品。备考时间大概4-6周,NVIDIA DLI(Deep Learning Institute)官方有配套课程,官网还特别提供了**“生成式AI认证一站通关”**学习路径。当前官方页面说明,开发者用户可免费领取一门价值最高600元的在线自主培训课程,部分课程提供云端实验环境。具体领取资格、课程范围和活动期限,以官网说明为准。
对职业发展的帮助,我的看法比较实际:认证可以提供一个可验证的学习成果,但不能替代项目经验,也不能保证获得某个岗位。它的价值在于帮助自己系统梳理知识,并向外部提供一个能力参考;具体认可程度仍取决于岗位要求和用人单位。
一个开发者为什么需要了解NVIDIA生态
这里不想列技术名词清单,只想说一个逻辑:
当前大量主流生成式 AI 训练和推理工作负载依赖 GPU,其中 NVIDIA 是重要的软硬件生态之一。
这意味着,CUDA(并行计算平台)绕不开——想搞懂AI性能瓶颈,就得从它入手。TensorRT 也很重要,它可以通过计算图优化、精度模式选择和内核优化等方式提升推理效率。不过实际收益取决于模型、GPU、输入形状、批量大小以及原有的推理配置,不能简单地说所有场景都能提速数倍。你不必从零写CUDA内核,但同一个模型在不同配置下推理速度差好几倍,总得知道差别出在哪,这就要对底层计算有点基本概念。
NVIDIA生态的价值,不在你把这些工具玩得多精,而是它们构成了AI应用工程化的底层技术体系。懂了这套技术体系,与 AI 基础设施团队沟通会更顺畅,遇到性能问题也知道先查哪儿。
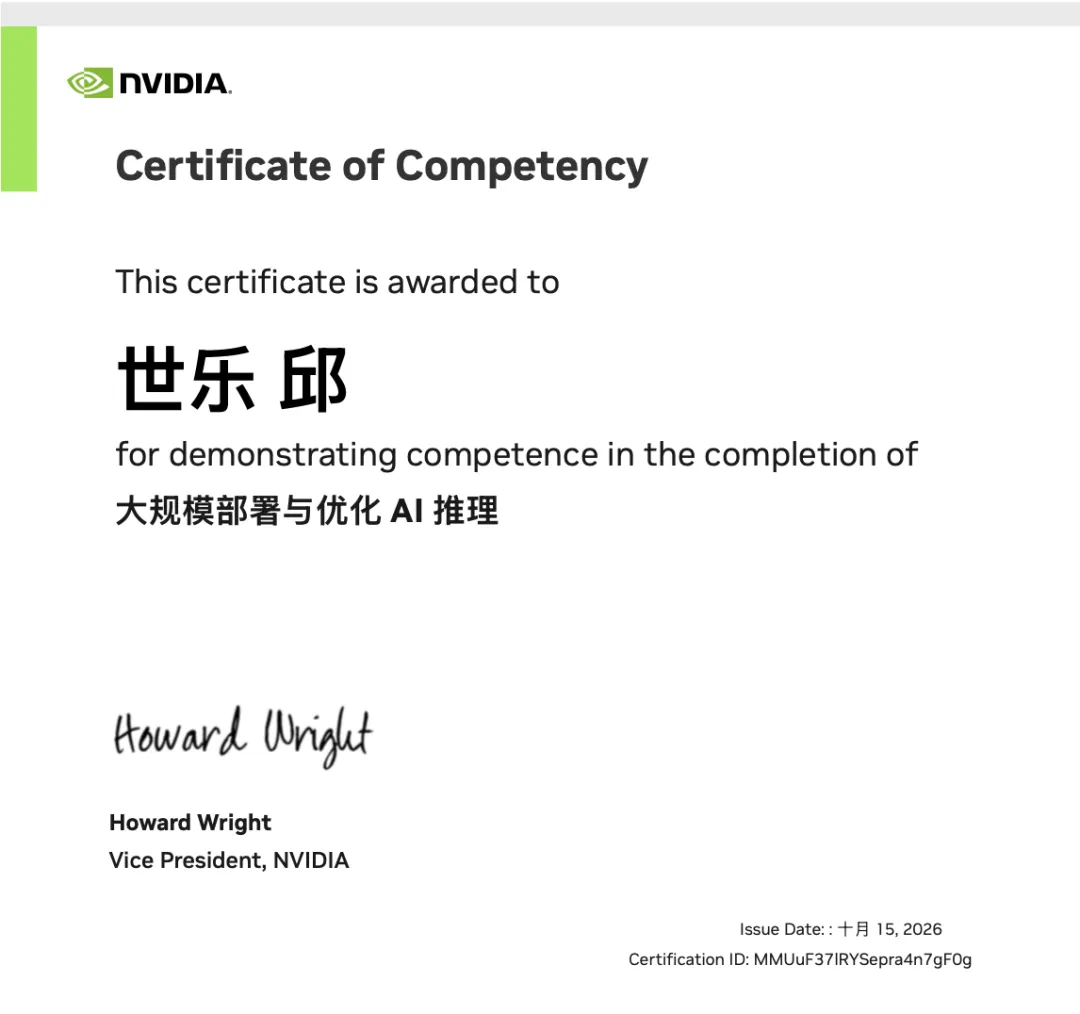
NVIDIA 能力证书(Certificate of Competency):大规模部署与优化 AI 推理。
几条我觉得真正有用的建议
一、从复现一个RAG系统开始。
不要只是调API聊天,也不要上来就啃数学。RAG系统覆盖了AI应用开发的完整链路:文档处理、Embedding、向量检索、Prompt工程、结果评估。做完一个能真正用起来的RAG,对AI应用开发的理解会上一个台阶。推荐用LangChain或LlamaIndex作为框架起点。
二、原理补课要找对入口。
推荐Andrej Karpathy在YouTube上的“Let's build GPT”系列——他从零用Python实现一个迷你GPT,代码量不大但逻辑极清晰。比看十篇“Transformer原理详解”的博客管用。看完再配合李沐的《动手学深度学习》做练习,基础就差不多立住了。
三、本地跑模型,哪怕只有一张普通显卡。
有条件的话,买张二手显卡折腾一下本地部署。量化模型、推理框架、显存管理——这些在纸面上永远没有亲手踩坑来得印象深刻。没有GPU预算,Colab和国内的AutoDL也够用,成本不高。
四、备考NCA,优先使用NVIDIA DLI官方资源。
从官方考试大纲和学习指南入手,明确各主题的考察范围,再根据薄弱环节选择推荐课程。第三方资料可以作为补充,但要注意核对版本、准确性和时效性。
结尾
从那次看JD看懵开始,到现在大概两年多。我没法说自己已经“懂AI”了——这个领域变化太快,没人敢这么说。但我至少知道自己现在处于哪个位置,下一步要补什么,什么是真实的能力边界。
这种“知道自己在哪”的感觉,比“感觉学了很多”要踏实得多。
知道自己走到了哪里,也知道下一步要往哪里走。
你现在在AI学习的哪个阶段?是还在工具层徘徊,还是正在啃原理,还是已经在做项目了?欢迎评论区聊聊,我们互相对个位置。