ARTICLE · 1228601
AI芯片设计:混合精度如何一条数据通路吃下 FP32 到 FP4
先说结论:这颗 16×16 的 weight-stationary 脉动阵列,在 TSMC 28 nm、1 GHz 下做到 FP32/BF16/FP8/FP4 峰值 0.5/1/2/4 TOPS,全格式(含 INT 与 MX)路由后单元面积 3.27 mm²、峰值功耗 1.85 W,FP4 每操作 0.45 pJ。它想回答的不是"能不能支持多格式",而是两个更硬的问题:共享一条数据通路时,吞吐怎么随位宽等比缩放;以及支持 MX 块尺度,到底要多付多少面积和能耗。
论文来自 University of Washington(Jiayi Wang、Kearnan Bishop 共同一作,Ang Li 通讯),ICCD 2026 接收,arXiv 2610.19645。
一、一个模型里早就不止一种精度
论文开篇列的例子很能说明问题:DeepSeek-V4 在注意力和 MoE 内部就混着用精度——KV 在 RoPE 维度保 BF16、其余用 FP8,lightning indexer 用 FP4 算注意力,MoE 专家权重存 FP4、反量化到 FP8 再算。Nemotron 3 Ultra 干脆按算子分配:路由专家 NVFP4、共享专家与 Mamba mixer FP8、注意力与 embedding BF16,KV cache 是 FP8。Kimi K2 Thinking 的专家量化到 INT4。
低精度省显存、省带宽、提高有效算力,但同时压缩动态范围与尾数,精度仍然是敏感选项;而长归约又要求高精度累加,所以生产系统普遍保留 FP32 累加。
硬件侧的对照是商用矩阵引擎:H100 的 Tensor Core 覆盖 BF16/FP16/FP8/FP32-class/INT,B200 增加 FP4 与 MX,TPU7x 与 Trainium3 也都在多个低精度模式上给出接近等比的吞吐,累加仍是 FP32。论文表 1 把这些产品按"相对自家 BF16 的倍数"归一化:H100 的 FP8 是 2×、B200 的 FP4 是 4×、Trn3 的 MXFP8/MXFP4 都是 4×。
于是架构目标很清楚:多格式 + 近似等比的吞吐缩放 + FP32 累加。但公开文献里,"用什么微架构机制实现"和"多加一种格式要付多少钱"这两件事一直没被认真表征。这篇论文就是补这两块。
二、为什么不能每种格式复制一条通路
最直接的多格式实现是给每种格式复制一条独立数据通路。面积、布线、控制逻辑一起膨胀,而且工作负载很少同时跑满所有格式,复制出来的硬件大部分时间在闲置。
第二个坑来自 MX。OCP MX 把每 32 个元素划成一块,共享一个 E8M0 指数(纯 2 的幂)。一个 PE 覆盖的跨度超过一个 MX 块时,相邻块的部分和不能直接相加——它们带着不同的尺度。朴素做法是每列保留两个 FP32 状态(块内累加器 + 跨块运行和),再在每个块边界放一个专用 FP32 加法器。这条"第二累加通路"就是 MX 支持的主要开销。
MFSA 的两个设计正好对应这两个坑:PE 级用点积累加器(DPA)共享宽数据通路,阵列级用 OBSR 把块尺度折进运行累加器的指数域。
三、机制一:把 FMA 换成点积累加器
传统脉动阵列的叶单元是一次 FMA。MFSA 的叶单元是一个点积累加器(DPA),一次吃 k 个窄操作数、出一个高精度结果,k 随位宽变化:1 路 FP32/INT16、2 路 BF16/FP16/INT8、4 路 FP8/INT4、8 路 FP4。这样吞吐就随精度等比放大,而 PE 之间的连线和部分和网络不用为低精度加宽。
数据通路有五个部件:指数处理路径;以 24×24 可重构乘法器为核心的尾数乘法路径(可切成 2、4、8 个窄乘积,各自带加法树);对齐移位器(把乘积尾数与累加中的 FP32 尾数对齐);76 位宽的累加器;以及输出前的归一化/舍入级。
76 位这个数字值得停一下:24 位 super-mantissa,加 2 位 guard/round/sticky,再加 FP32 动态范围对齐所需的余量。乘法器产出 k 个 carry-save 形式的乘积,由共享加法树在不中途舍入的前提下归约;carry-save 结果经一个移位器对齐到 FP32 累加器的运行指数;最后一颗 round-to-nearest-even 舍入器产出下一个 FP32 部分和。
也就是说,k 个乘积只做一次 IEEE-754 归一化和一次 RNE,而不是 k 次。这就是 DPA 相对"级联 k 个单格式 FMA"的面积优势来源,而且 k 越大优势越大。
整数支持走的是"蹭槽位":INT16 用 FP32 的 24×24 乘法器(k=1),INT8 用两路 FP16 点积通路(k=2),INT4 用四路 FP8 通路(k=4,正好——E4M3 的 lane 有 4 位有效数:3 位存的尾数加隐含位)。乘法器和累加器原样复用,整数只多出符号扩展、有符号/无符号选择和一个绕过 FP 归一化的输出 mux。代价是:同宽度的 INT 只有 FP 的一半速率(INT8 追平 BF16/FP16,而不是追平 CFP8)。
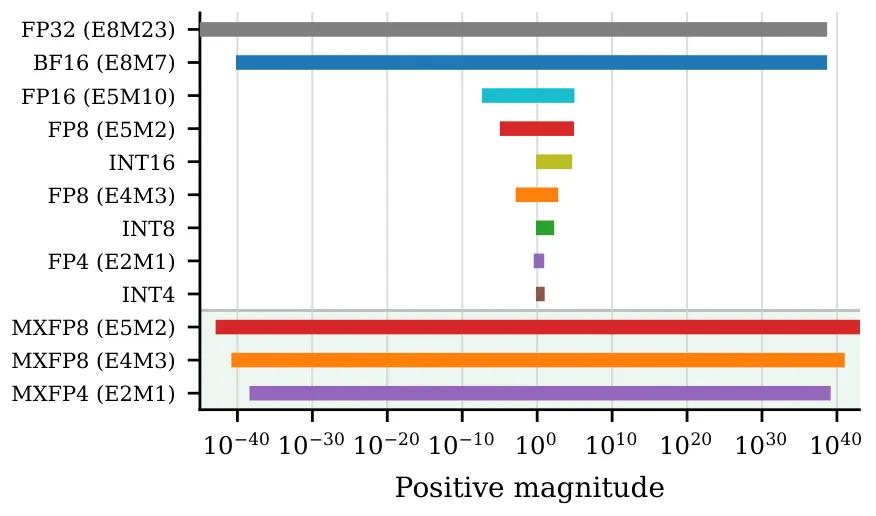
图 1:横轴是正数量级范围(10 的 −40 到 40 次方量级),每一行是一种格式的编码。FP32 与 INT4 的动态范围差了十几个数量级,MX 格式则靠共享块指数把 FP4/FP8 的量级整体平移——这张图解释了为什么"一个数据通路通吃"必须把指数处理单独拎出来做。
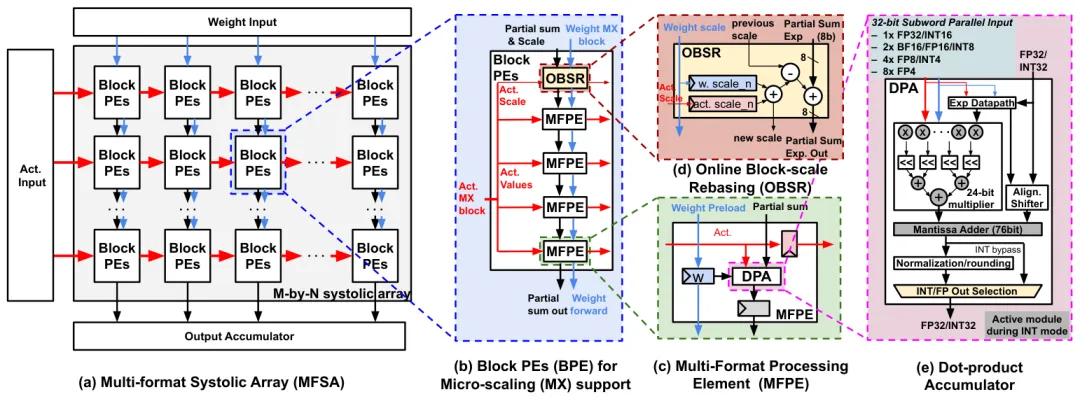
图 2:(a) 顶层 M×N 脉动阵列,权重从上方预载、激活自西向东带行偏斜流动、部分和沿南北向级联;(b) 四个纵向相邻的 MFPE 加一个北边界 OBSR 组成 BPE——MXFP4(k=8)正好一个 BPE 一块,MXFP8(k=4)跨两个 BPE;(c) MFPE 内部:DPA 加指数/对齐/归一化;(d) OBSR 单元只做指数域的加减;(e) DPA 内部:24 位乘法器切成多路、共享加法树、76 位累加。
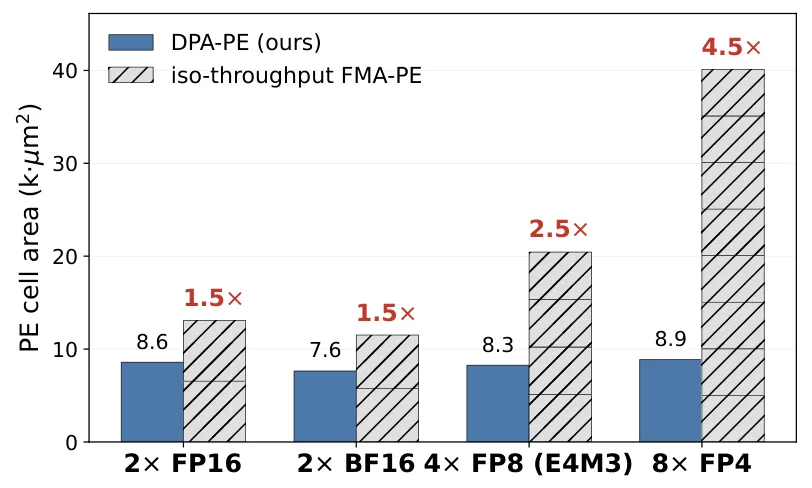
图 3:每组左边是 DPA-PE,右边是把 k 个单格式 FMA 单元级联起来、做到同吞吐同延迟的基线。2 路 FP16 与 2 路 BF16 都是 1.5×,4 路 FP8 是 2.5×,8 路 FP4 是 4.5×。柱高分别是 8.6、7.6、8.3、8.9 千平方微米(DPA 侧)。差距随 k 变大,正是"把一次归一化摊到 k 个乘积上"的直接后果——低精度推理恰好是 k 最大的区间。
四、机制二:OBSR,把块尺度加进指数
MX 的点积可以写成两层:块内是 32 个低精度元素的乘积和(DPA 已经算完),块间是每块一个 2 的幂尺度。
朴素脉动实现要为每个块边界维护第二个 FP32 累加字和一个跨块加法器。OBSR 的做法是:在累加新块之前,把继承下来的累加器重定标到新块的尺度,于是两者共享同一个尺度、可以直接在原有 FP32 级联上相加——不需要第二累加器,也不需要跨块加法器。
一般情况下,"除以旧尺度再乘新尺度"并不便宜,可能比它替掉的加法器还贵。OBSR 之所以便宜,是因为 MX 的块尺度是 E8M0,也就是纯 2 的幂:乘除 2 的幂等于给 FP32 的指数字段做整数加法,尾数一位都不动。
实现上它维护一个运行累加器 S 和一个 10 位有符号的运行尺度 s_cur,两者共同表示 V = 2^s_cur × S。到块边界时:先把进入的两个块尺度合成一个 2 的幂(一次加法),再把 S 重定标(只改指数字段,一次减法加一次加法),最后更新 s_cur。两次加法、一次减法,尾数不动。
特殊值也处理了:E8M0 的有限编码是 0x00–0xFE,0xFF 是保留的 NaN 码(没有零和无穷编码),NaN 尺度会以 quiet NaN 穿过 FP32 累加器;重定标绕过 ±0 与 Inf/NaN,越界时夹到 FP32 的边界(上溢到 ±∞,下溢冲刷到零)。MXFP6 则靠运行时 recast 到 MXFP8 支持。
代价是:S 存的是 V 除以 2^s_cur,如果某个块的尺度离累加历史太远,S 会被夹住,而"另存一个 V 的 FP32 累加器"不会。论文说真实 trace 上没发生过,后面用 168 个 GEMM 验证了这一点。
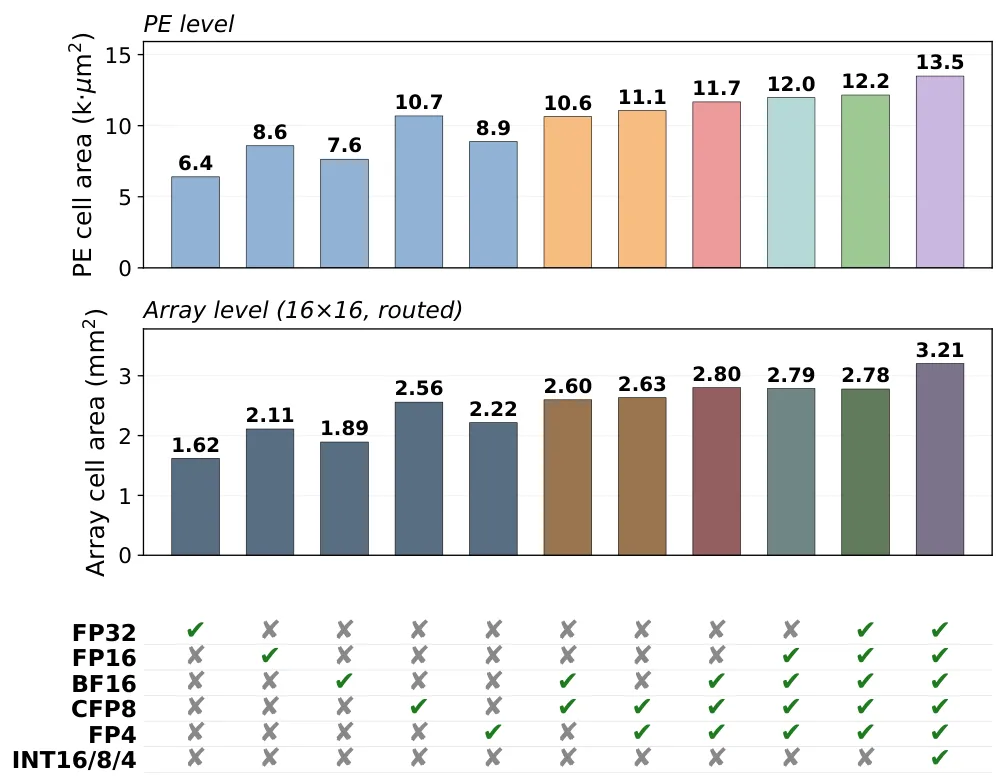
图 4:横轴从左到右逐步打开格式。PE 级(上)从 6.4 千平方微米涨到 13.5;阵列级(下)从 BF16 的 1.62 mm² 到 BF16+CFP8 的 2.60,全 FP 六格式 2.78(+6.9%),再加 INT16/8/4 到 3.21(再 +15.4%)。共享数据通路的好处就在这里:加 FP32、FP16、FP4 三种格式只多 6.9%,因为它们是复用而不是复制。
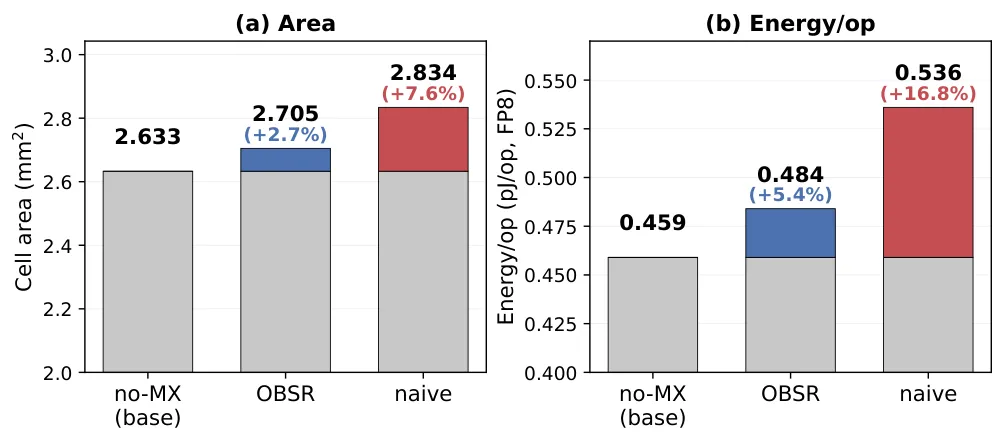
图 5:左图面积,右图 FP8 每操作能耗。无 MX 基线 2.633 mm² / 0.459 pJ;OBSR 2.705(+2.7%)/ 0.484(+5.4%);朴素双累加器 2.834(+7.6%)/ 0.536(+16.8%)。折算下来,OBSR 把 MX 的增量面积砍掉 64.2%、增量能耗砍掉 67.5%。全格式阵列上 MX 只再加 1.8%,得到 3.27 mm²。
五、数值:168 个真实 GEMM 上的 ULP
OBSR 与朴素方案的区别不只是硬件,还有加法顺序:朴素方案先把每块 32 个乘积归约成一个 FP32 块和,再顺序累加 N/32 个块和;OBSR 保留原始脉动阵列的累加顺序,等价于直接顺序累加 N 个乘积。
作者用 4 个模型(Qwen2.5-0.5B/1.5B/3B-Instruct、SmolLM2-1.7B-Instruct)的 prefill 与 decode trace,取了 168 个 GEMM,覆盖投影层(down/up/o_proj,三个解码深度)与注意力的 QKᵀ、P·V,上下文 74 到约 430 token,FP64 按绝对值升序累加作为黄金参考。
结果:MXFP4 与 MXFP6 E2M3 上两种方案逐位一致(块和恰好可被 FP32 精确表示);MXFP8 上投影 GEMM 的 p95 差在 6 ULP 内,注意力 GEMM 在 0.62 ULP 内。两者没有谁稳定更接近黄金值——朴素方案略多一点情况更近,因为它的块内归约更接近成对求和。阵列规模从 16 行到 256 行、prefill 与 decode 两条路径,p95 曲线几乎重合;大 ULP 离群只出现在 FP64 参考接近零(相消)时,最坏绝对误差低于 3×10⁻⁵,比 MX 量化本身的底噪小至少 395 倍。
对抗性构造(跨块动态范围极宽、交替符号相消、离群值、接近非规格化的尺度)能触发 2,242 次 clamp,MXFP4/MXFP6 的偏差约 10⁻² 量级,MXFP8 E4M3 能到 8.19×10³。但真实 trace 的块尺度分布 σ 只有 0.7–1.4,合成扫描要到 σ≈32(乘积铺满 FP32 整个指数范围)才开始出现 clamp。
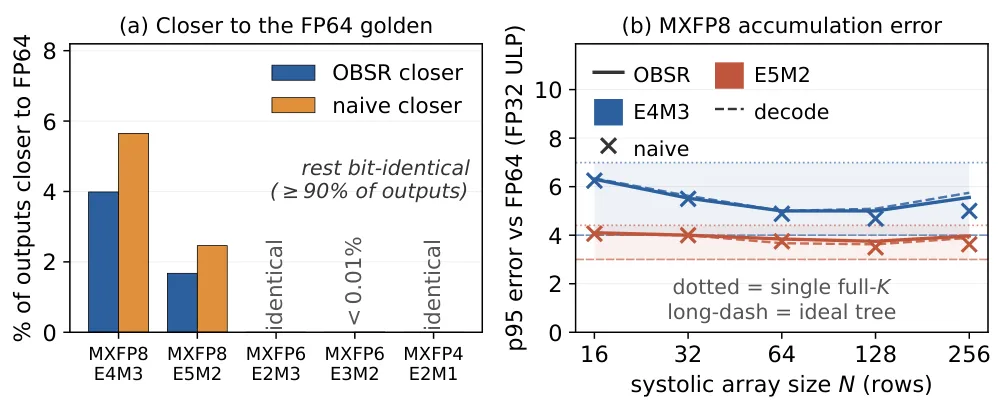
图 6:(a) 输出严格更接近 FP64 黄金值的比例——OBSR 与朴素互有胜负,MXFP4/MXFP6 是逐位一致,MXFP8 两者都落在少数几个百分点内;(b) p95 误差随阵列行数(16 到 256)的变化,两条虚线分别是"单次全长 K 累加"和"理想树形归约",实线是 OBSR 与朴素 E4M3/E5M2——四条曲线几乎重合(解码与 prefill 都在内)。
六、全格式的价目表
几个可以直接读出来的结论:吞吐严格按 2 倍阶梯走(0.512 → 1.024 → 2.048 → 4.096),对应每 PE 每周期 2/4/8/16 GOPS;功耗几乎不随格式变(1.72–1.89 W),所以能耗基本就是吞吐的倒数;MX 模式的数字与同宽度非 MX 完全一致——块尺度支持没有在吞吐或能耗上留下痕迹。
面积链条也清楚:BF16 阵列 1.62 mm²,BF16+CFP8 基线 2.60,全 FP 六格式 2.78(+6.9%),加 INT 3.21(累计 +23.5%),再加 MX 3.27(累计 +25.7%,其中 MX 本身 +1.8%)。
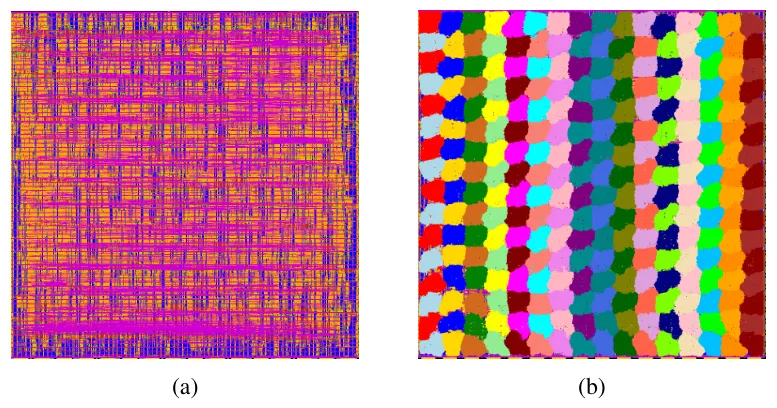
图 7:(a) 布线后的裸片,2.40×2.40 mm²;(b) 同一张图把 256 个 MFPE 逐个阴影标出,可以看出阵列的规则性是面积效率的前提。signoff 单元面积 3.27 mm²,核心利用率 59%,MFPE 延迟 4 个周期。
与唯一的 MX 单元级对比对象 Vmxdotp 比:MFSA 的 MXFP8 是 0.63 TOPS/mm²、1.11 TOPS/W、0.90 pJ/op,MXFP4 是 1.25、2.21、0.45;Vmxdotp 在 12 nm 下是 0.69 / 0.75 / 1.33 与 1.37 / 1.57 / 0.64。MFSA 的单位面积算力略低,但单位功耗算力高约 1.5 倍——注意 Vmxdotp 只是 FPU,不含阵列、存储和布线,两者不是同一层级的东西,论文自己也标注了这一点。
七、两个边界讨论:NVFP4 与整数
NVFP4 的分数尺度。 OBSR 吃的是 E8M0,纯 2 的幂可以直接加进指数。NVFP4 用的是 16 元素一块、E4M3 分数尺度,整体套用会需要 OBSR 支撑不了的乘法器。论文的办法是把尺度拆成指数与尾数:s = 2^e × (1.m),2 的幂那一半照旧走 OBSR,分数那一半 µ = (1.m_a)(1.m_b) 是一个 8 位整数,折进 MFPE 内部的 FP4 点积——先把四条 lane 的量级加起来,再用一次 11×8 乘法乘 µ,最后并入 FP32 加数。按分配律这个折叠是精确的,不需要除法器,尺度级联仍是 E8M0 宽度。代价:同时支持 OCP MX 与 NVFP4 额外 +11.8% 面积、+7.3% 功耗;朴素做法要 +25.1%/+24.0%,逐 PE 反缩放要 +15.6%/+15.7%。
整数为主的边缘推理。 因为 INT 蹭的是 FP-2X 的槽位,同宽度只有 FP 一半速率。如果模型以整数为主,可以加一条独立的 INT 点积通路把整数吞吐翻倍,代价是每 PE 多 1.39 千平方微米(+10.3%)。这是个明确的取舍,而不是设计缺陷——论文没有藏。
八、批判:这些数字该怎么读
面积是 cell area,不是 die area。 3.27 mm² 是 signoff 单元面积,裸片是 2.40×2.40 = 5.76 mm²,核心利用率 59%。跨设计比较时这两个数会被混用,看到"3.27 mm²"要先问是哪个。
不含 SRAM、NoC、控制器。 论文明确说商用芯片的报告包含存储、控制、片上网络与内存控制器,直接比不合适,所以不与 TPU/Trainium/Dojo 比。这也意味着 0.5–4 TOPS 的绝对值不能拿去和任何商用加速器对比——它只是一颗 16×16 的算术阵列加布线。
功耗方法学是 RTL 级。 Cadence Joules + 后端寄生 + 门级 GEMM 波形,激励取自 Qwen2.5-7B prefill 的 post-RMSNorm 分布(不是均匀随机),报的是激活流窗口内的峰值稳态功耗,排除复位、权重预载和排空周期。这个口径对"稳态吞吐"合理,但会低估真实负载里格式切换、预载与空闲的代价。
基线是合成功率/面积等价物。 "同吞吐级联 FMA-PE" 是作者按同吞吐同延迟拼出来的对照,不是任何已流片的单格式 PE;它证明了 DPA 的结构优势,但不能直接换算成"某商用 PE 会小 4.5 倍"。
阵列太小,缩放结论靠推断。 16×16 只有 256 个 PE;论文说 OBSR 的增量开销按"每块 PE 行"重复,所以比例与阵列规模无关,128×128 时被固定成本(时钟树、全局信号)略微稀释。这个推理合理但没有 128×128 的实测。
精度实验的覆盖有限。 4 个模型最大 3B,上下文 74–430 token,没有长上下文;MXFP8 的 ULP 结论不能外推到 32K 以上、激活分布更极端的场景。作者自己也承认,大 tile 商用引擎(128×128)里"专用块归约通路"可能是刻意的精度优化选择,朴素基线正是那种组织。
没有公开 RTL。 我检索了 GitHub,没有 MFSA 的仓库,连它依赖的 TransDot 也没有公开实现(论文引用为 arXiv 2605.07245)。面积/功耗数字只能复述,无法在本地重跑综合。
九、给做低精度硬件与算子的人四条经验
1.多格式的边际成本,取决于"共享什么"。 共享乘法器与累加器、把差异压到指数处理和一个输出 mux,加三种 FP 格式只花 6.9%;一旦要加整数符号扩展和独立吞吐,立刻变成 15.4%。设计前先决定"哪些格式必须同速",这决定了要不要第二条通路。
2.块尺度存在哪里,决定 MX 贵不贵。 存在累加器指数里(OBSR)= +2.7% 面积;存在第二个累加器里 = +7.6%;存在每个 PE 的乘法器前 = 更贵。E8M0 是纯 2 的幂这件事,是整个技巧成立的前提;换成 E4M3 分数尺度,就得把尾数折进点积(+11.8%)。
3.格式切换不该冲刷流水。 南北向部分和级联恒为 FP32/INT32,格式选择只是一条旁带信号,切换时在飞的部分和不用排空。对编译器/运行时意味着:可以在同一张图上连续发不同精度的 GEMM tile,不必为每次切换付排空代价。
4.看这类论文先问三个数:cell 还是 die、含不含 SRAM/NoC、功耗是 RTL 估算还是流片实测。 三个都答清楚,数字才有可比性。
附:本地能验的部分
RTL 跑不了,但 OBSR 的数值机制和论文的算术是可以验的(脚本在 ~/papers/mfsa/verify_obsr.py):
指数域加等于精确的 2 的幂缩放:对 20 万个随机 float32、41 个平移量(−20 到 +20),"把指数位加 d"与 ldexp 的结果 41/41 组逐位一致。这证明 OBSR 那个"只加指数"的操作在数值上是精确的,不是近似。
OBSR 与朴素双累加器对比:200 组随机 MXFP4 点积(K=2048,块尺度 σ=1)200/200 逐位一致,与论文"MXFP4 逐位一致"的结论吻合;200 组随机 MXFP8 也是 200/200 一致。论文在真实激活上观察到 MXFP8 有少数 ULP 差异,我这里没复现出来——因为随机数据的 32 项块和恰好能被 FP32 精确表示,差异本就不该出现。这反而说明:论文那点 ULP 差异来自真实激活的指数分布,不是机制缺陷。
面积/能耗算术可复原:OBSR 2.7%/5.4% 对朴素 7.6%/16.8%,降幅正好 64.2%/67.5%;FP 六格式 +6.9%;INT 追加 +15.5%(论文 15.4%);3.27/2.60 = +25.8%(论文 25.7%)。
吞吐等比:0.512/1.024/2.048/4.096 TOPS ÷ 256 PE @1 GHz = 每 PE 2/4/8/16 GOPS,说明"等比缩放"不是宣传语而是表里的硬约束。
一句话总结这篇论文的价值:它把"多格式支持要花多少钱"从一句定性的"会很贵",变成了一张可以逐项对账的价目表——FP 格式 +6.9%,INT +15.4%,MX +1.8%,NVFP4 再 +11.8%。做架构评审时,这种表比任何峰值数字都有用。