ARTICLE · 1228904
「AI渗透测试+Pentest-AI拆解:漏洞必须机器复现,Agent说了不算」
一份漏洞赏金提交被打回来,理由只有一句:无法复现。作者把 AI 扫出来的三条高危贴了上去,附了截图和请求包,triager 试了两次,什么都没发生。
这类提交最近变多了。模型能写出一份看起来很专业的报告,能编出请求、响应、甚至编出命令输出。问题不在它说得像不像,在于它说的东西没有人重新跑一遍。
这期拆 0xSteph/pentest-ai,一个把「没证据就不算漏洞」写进代码的开源 AI 渗透测试工具。它的赌注很直接:模型可以提出候选,但只有机器判据能给它一个 verified。
截至 10 月 22 日核实时,它在 GitHub 上 1762 星、325 fork、3 个未关 issue,MIT,Python,2026 年 4 月 4 日建仓,10 月 9 日最后推送。GitHub 最新 release 是 v1.5.0(10 月 7 日),但 PyPI 上的 ptai 还停在 1.4.1.post1(9 月 12 日),要求 Python 3.10 到 3.14。
这两个版本号后面会单独说,因为它直接影响你装到的是哪一套。
它是什么
一句话:把 AI 客户端接到一套真实的渗透流程上,再让一个不依赖模型的判据决定哪条发现算数。
它有三种用法:作为 MCP 服务器接进 Claude Code、Codex、Cursor、VS Code;作为 CLI 直接跑;或者放进 CI。模型负责调查和推理,判据负责判真假。仓库 README 写得很清楚:模型不能给出 verified,第三方扫描器的输出在判据重新证明之前也不算数。
仓库自己的能力清单是这么写的:65 个 probe,其中 64 个是 HTTP;28 个判据实现;203 个工具封装,但只有 20 个会把工具输出解析成结构化 finding;52 个 MCP 工具;18 个专职 agent。
18 个 agent 按目录分得出来:侦察、Web、API、云、AD、移动、无线、提权、凭证测试、浏览器、社会工程、漏洞扫描、利用链、PoC 验证、检测规则、报告、选择、LLM 红队。
这些数字是清单,不是战绩。仓库自己也这么说:有 probe 不代表有验证配方,有工具封装不代表输出能变成 finding,有 agent 不代表覆盖所有目标类型。
单次 LLM 运行不是证据
docs/why-verification.md 里引了一组实验:同一个固定靶场,四个模型各跑 100 次,完全利用成功率从 25% 到 85%,差异只取决于换了哪个模型,目标一次没变。
仓库同时标注了这些文献是自动检索来的,引用具体数字前要核对原始来源。这个提醒本身值得记一笔:它在用别人的研究支撑自己的设计,但没有把别人的数字当成自己的结论。
真正的问题是模型会编。编不存在的命令、编扫描器没有的功能、把想象中的输出当成执行结果,而且给它机会自我纠正也还在编。所以「AI 说它挖到了」只能算一条候选,除非有东西重新跑一遍。
这也是它和很多 AI 渗透工具的分界线。多数工具把模型的结论当结果,它把模型的结论当输入。
裁决是一份有校验的契约
代码在 engine/receipt.py。回执是一个冻结的 Pydantic 对象,只有三个 verdict:candidate、verified、refuted。
关键在一条校验:
@model_validator(mode="after")def_verified_needs_an_oracle(self) -> Receipt:ifself.verdict == Verdict.verified andself.oracle_kind isNone:raise ValueError("a verified verdict must name the oracle_kind that earned it; ""an LLM assertion is not a verdict" )一个 verified 回执必须说出是哪种判据给的,否则对象根本构造不出来。注释里写得更直白:LLM 不能把 verdict 断言出来。
判据在枚举里归成七类,按强度排:artifact(利用写进一个唯一文件或行,再读回来)、canary(植入的密钥只在利用后出现)、oast(带外回调,证明盲打类漏洞)、differential(受害者和攻击者会话不一致)、server_state(服务端可读回的状态,比如扣款总额)、idempotent_replay(PoC N 次里复现 N 次)、unescaped_reflection(输入未转义地反射回来)。
最后这一类单独列出来,是因为它只证明「没被转义」,不证明 XSS 会执行。注释里专门写了:下游消费者按 oracle_kind 取值,就不会把一次反射重新叙述成「XSS 已验证」。
重复次数也不是拍脑袋的。REPLAY_N_BY_INTENSITY 写着:stealth 2 次、safe 2 次、normal 3 次、aggressive 5 次。
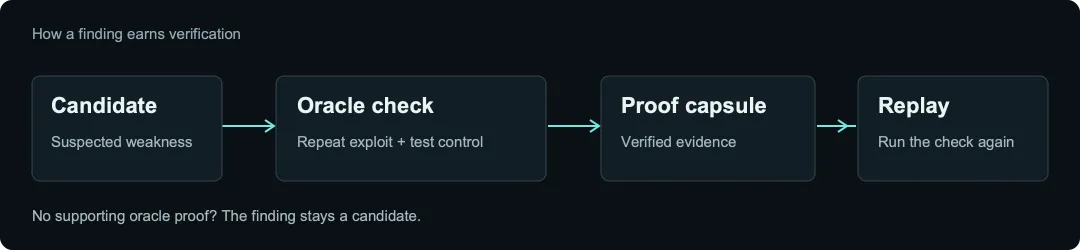
engine/verifier.py 里还有一句很关键:判据没通过是弃权,不是反驳。重放没中、OAST 没回调、差分被拒,都只能说明「没能重新证明」,结论回到 candidate。refuted 留给未来真正的反驳判据。
所以这套东西里没有「安全」这个结论。一次扫描没命中,不等于目标干净。
三个判据怎么工作
差分判据在 engine/oracles.py 的 _DifferentialReadOracle。它开两个互不相关的账号,各自独立的 session 和 cookie jar,两个都能读到受害者的完整记录,N 次里 N 次成立才算过。
这个设计有点意思:两个刚注册的账号不可能同时拥有受害者的对象,所以只要两个都能读,就是接口根本没校验归属。不需要知道任何一个账号自己的 id,也不需要持久化 session 或密钥,配方里只带受害者 URL 和期望的 id。
代价是注册账号本身是写操作。所以在 safe 强度下它直接弃权,注释写的是「让发现保持诚实的候选,而不是靠创建数据换一个 verdict」。
可信头判据是 WITH 和 WITHOUT 的差分:带上伪造头,受保护路径返回 2xx 且不是空壳;去掉头,返回 401 或 403。两个条件同时成立才算过。
如果一条路径对两种请求都返回 200,说明它根本没做门禁,判据弃权,而不是给一个假阳性。这句注释我觉得比很多工具的「检测到疑似漏洞」诚实。
HTTP 请求走私判据更细。它在验证时用唯一 token 现场拼 CL.TE,走原始 asyncio.open_connection,因为 aiohttp 会规范化、不允许一个请求同时带冲突的 Content-Length 和 Transfer-Encoding,根本表达不出这个 desync。
Content-Length 按字节算,不按字符算,否则多字节 token 会把声明的长度算短,截断夹带的那一段。只有 DESYNC-SMUGGLED:<token> 在响应里回来才算过。https 直接拒绝,不会把明文打到错误的端口。
MCP 暴露判据重发一次 JSON-RPC 的 tools/list,确认 jsonrpc 2.0 和 result.tools 回来。错误泄露判据重发同一段畸形 JSON,确认框架、堆栈或调试标记回来。
这些判据有一个共同点:证明的是「这个效果能重放」,不是「这个模式像漏洞」。
证据要能自己重放
engine/capsule.py 是这套设计的落点。一条 verified 发现会打成一个胶囊:finding 的 id、标题、目标、严重级、漏洞类、证据(截断到 2000 字符)、验证配方,加一份回执。
胶囊带一个 integrity_sha256,算法是把胶囊去掉这个字段后按规范化 JSON 序列化再取 SHA-256。代码注释把边界写得很清楚:这是防漂移,不是真实性。改动过就对不上,但任何人都能给一个伪造胶囊重算这个值,所以它不证明是谁做的。
它故意不签名。真实性来自重放:第三方拿胶囊对着活目标再跑一次判据,看 verdict 能不能重新成立。这不是「相信我」,是「你自己跑」。
重放本身也有攻击面。胶囊 JSON 可能是敌对的,配方里的 URL 会让工具发真实请求,所以 replay_capsule 是 fail-closed 的:调用方必须给 allowlist,否则直接拒绝,没有隐式的「随便重放」模式。
这里有个很容易漏的细节:范围门不能只看 finding['target']。大多数判据是从配方的 url、victim_url、url_template 里取请求地址的,只 gate target 会留一个 SSRF 洞——敌对胶囊把 target 设成允许的主机,配方却指向别处。
所以门会检查 target 加三个配方 URL 字段里的每一个 host,全部在 allowlist 里才放行。只有一个 host 时,再给 session 挂一个 strict_scope,让底层原语层也拦住跨主机请求,算第二道防线。
残余风险也写明了:allowlist 比的是主机名,不防 DNS rebinding,也就是一个被允许的域名在请求时解析到内网 IP。它把这个放在人工重放的模型下接受,但写出来,而不是暗示没有。
OAST 类型的胶囊还有一个例外:带外回调不能按需重新触发,原来的 collaborator 已经没了。所以这类发现是「历史上验证过」,不能现场重放,要重新起一个 collaborator 再打一次。
范围不是建议
engine/scope.py 的第一句注释是:强制点在 SecurityTool.execute(),不在 agent 层。原话是「即使一个产生幻觉的 LLM 也绕不过这一层」。
范围检查支持通配符、CIDR、排除项、端口;排除优先;域名会解析成 IP 再判一次;没有 allow 列表时,strict 模式直接拒绝,只有 permissive 模式才放行。违规会记进 ScopeViolation 列表并打 warning。
这块在 1.5.0 之前是有洞的。CHANGELOG 写得很清楚:之前只有 playbook 路径建了 ScopeEnforcer,默认 ptai start 的 scope=None,也就是默认运行没有 CIDR、通配符、排除和 fail-closed 约束。
1.5.0 把默认 start、campaign、认证扫描、resume、retest、live 和 agent loop 全接上了,并且至少对自己的目标 fail-closed。跑之前还会弹一个 preflight,把 in-scope、excluded、强度、auto-auth、strict-scope、OAST 这些风险设置列出来让人确认;--ci、--yes 或 stdin 不是 TTY 时跳过。
漏洞赏金那条链也接上了:ptai bounty import 把项目的 in-scope 资产变成 allow,out-of-scope 变成 ! 排除,排除优先;移动应用、仓库、智能合约这类非网络资产报成 skipped,不会假装扫过。
凭证不进模型上下文
认证扫描用 auth profile。一个 profile 是一组命名参数,指向凭证来源,而不是把凭证本身放进去:支持环境变量、1Password、HashiCorp Vault、AWS Secrets Manager。
配置文件是 ~/.pentest-ai/auth-profiles.yaml,每次写入强制 0600,权限更宽就拒绝加载。MCP 那侧只传 profile 名字,密码在服务端解析,不经过 LLM 的上下文。
这条改动在 CHANGELOG 里标成「推荐所有 MCP 用户升级」:之前原始密码会跟着 MCP 请求进 Claude、Cursor、Desktop 的上下文。另外还有一个 SecureCredential 内存类,在 repr、str、format、json、pickle 时都会脱敏。
对做 AI 安全的人来说,这个方向比「在系统提示里加一句别泄密」靠谱:密钥根本没进上下文,提示注入就没有东西可偷。
上手
最省事的是 pipx:
pipx install ptaiptai setup --mcpsetup --mcp 会问你要不要接检测到的所有受支持客户端,保留已有注册;--dry-run 可以先看它要改什么。它不装客户端、不登录、不下载模型、不配 Ollama,模型由你的 AI 客户端提供,MCP 服务器自己不要模型 key。
想先看证据流程,跑内置演示:
ptai demo它扫一个内置的漏洞应用,用判据验证埋进去的洞,从一条胶囊里现场重放一条,再跑同一批加固后的路由,报 0 findings。变的只有修复。
本地模型走 Ollama:
export PENTEST_AI_LLM_PROVIDER=ollamaexport PENTEST_AI_MODEL="你装的模型名"ptai start https://你授权的目标 --no-sync漏洞赏金那条链:
ptai bounty import --platform hackerone --file scope.json --out program.scopeptai start acme.com --scope-file program.scope --intensity stealthptai bounty report <engagement-id> --platform hackerone --out submissions/进 CI 是两件事,不要混:
ptai start https://你授权的目标 --ci --fail-on verified --no-syncptai export <engagement-id> --sarif pentest.sarif--fail-on verified 是 start 的闸门,--sarif 是 export 的选项,不是 start 的选项。构建失败时如果还想要证据,先留着 engagement id,再单独 export。
实测数字
仓库给了两组公开的对照,方法都写在 docs/benchmarks/ 里。
一组是干净应用:tests/cleanapp 是一个零漏洞的靶场,路由长得可攻击但实现是对的——查询参数化、跳转有 allowlist、登录真校验密码、文件路由沙箱化路径、评论输出转义。跑完整确定性扫描,ptai 报 0 个假阳性;CI 里还有八个 case 盯着这条线,回归就挂构建。
另一组是蜜罐:公开子集在 CI 里断言 10/10;私有 20 个 bug 的一轮抓到 19/20,精确率 100%。
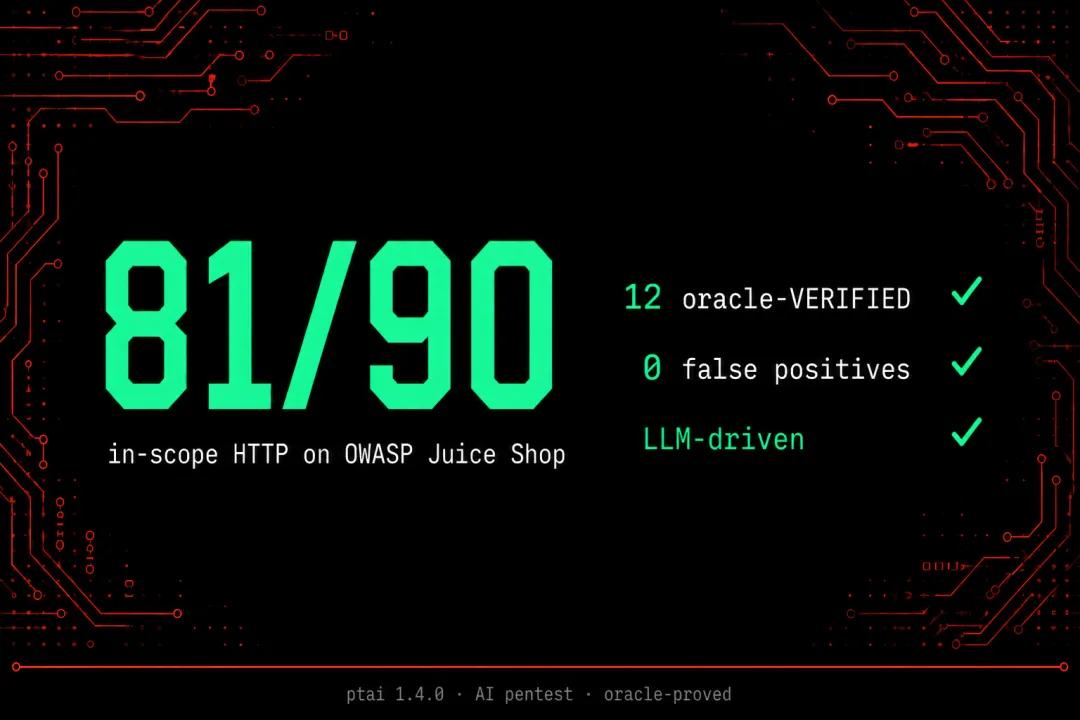
Juice Shop 那张表要带版本看。表里 ptai 是 0.13.0,不是现在的 1.4/1.5:未认证 88 条发现、覆盖 5 个 OWASP 2021 桶、46 条 critical+high、抽样假阳性 0%、2 分 48 秒;同一张表里 ZAP 2.17.0 是 593 条、假阳性 46.6%,Nuclei 3.8.0 是 1 条,HexStrike v6.0 引导到搜索接口是 15 条、假阳性 60%。认证后 ptai 是 87 条、45 条 critical+high、解掉 18 个 challenge、53 秒。
这些数字只能说明那个版本在那个靶场上的表现。仓库自己也说,benchmark 的发现数、challenge 完成数和判据验证数是三种不同的度量。
避坑清单
第一坑,默认 agent 模式的发现可能根本不落库。开放 issue #58(2026 年 9 月 13 日)写得很具体:默认 agent_mode=True 的 ptai start 不管模型多能干,最后都是 agent loop produced 0 findings; escalating to orchestrator pipeline,CLI 还会把锅甩给模型。
作者用 DeepSeek 通过 OpenAI 兼容端点复现了:模型每轮都选了合理的动作,真找到了 SQLi、JWT alg:none、IDOR,但 handler 只写 WorkingMemory,不写 FindingsDB,于是 CLI 每次都看到 0 findings 然后升级。别把「0 findings」当成目标干净。
第二坑,PyPI 落后于 GitHub release。pipx install ptai 现在装到的是 1.4.1.post1,而 scope 默认接入是 1.5.0 的改动。issue #62 说 ollama 的 e2e 单元还在阻塞发布,所以想用 1.5.0 的默认范围强制,得从仓库装或者等 PyPI 更新。
第三坑,胶囊不签名。integrity_sha256 只证明没被改过,不证明是谁做的;任何人能给伪造胶囊重算一个。真实性只能靠你自己重放。
第四坑,OAST 胶囊不能按需重放。原来的 collaborator 已经没了,只能起一个新的再打一次;别把「不能重放」当成「验证失败」。
第五坑,没命中是弃权,不是「安全」。verdict 只有 candidate 和 verified,refuted 还没实现;一次扫描没命中不等于应用安全。
第六坑,覆盖有限。203 个工具封装里只有 20 个会把输出解析成 finding;65 个 probe、52 个 MCP 工具、18 个 agent 都不等于覆盖所有目标类型。有些集成只给原始输出,不给结构化发现。
第七坑,裸 OAST 回调只证明请求离开了目标,不证明造成了危害。严重级默认压到 medium,直到有 impact 步骤复现真实影响。
第八坑,safe 强度下差分判据直接弃权,因为它要注册测试账号;这不是判据坏了,是它拒绝用写操作换 verdict。
第九坑,DNS rebinding。重放的门比的是主机名,不防一个被允许的域名在请求时解析到内网 IP;这是写在代码注释里的残余风险。
适合谁
适合做授权渗透、乙方交付、漏洞赏金的人,尤其是那些被「AI 说挖到了但复现不了」折磨过的团队。它把交付物从一份报告变成一条能重放的证据,客户或 triager 可以自己跑。
也适合想把 AI 输出接进 CI 的团队:--fail-on verified 加 SARIF,闸门只认判据验证过的发现。
不适合想一键全自动、不打算人工复核的人。它自己说得很清楚:这不是一个完全自主的 AI 渗透测试器,也不声称是。模型协调和推理,判据决定什么是真的。
下次有人给你看一份 AI 挖到的洞,先问三句:哪个判据复现的,N 次里成功几次,胶囊能不能在我机器上重放。三个都答不上来,那还是一条候选。