ARTICLE · 1237329
全模态数据治理:从文档、图纸、音视频到 AI Ready 数据资产
全模态数据治理:从文档、图纸、音视频到 AI Ready 数据资产企业过去谈数据治理,重点常常在结构化数据:主数据、指标口径、数据仓库、报表链路。到了 AI 时代,这个范围明显不够了。 模型和智能体真正需要的上下文,大量存在于非结构化和多模态材料里:制度文件、项目文档、设计图纸、扫描件、照片、会议录音、培训视频、巡检视频、试验曲线、日志截图、专家批注。 这些资料过去可以静静躺在档案系统里。现在不行了。只要企业希望 AI 能回答业务问题、辅助分析、生成报告、执行任务,就必须把这些资料转成 AI 可理解、可检索、可追溯、可授权的数据资产。 这就是全模态数据治理的价值。 很多企业已经有文档管理系统、影像系统、图纸系统、对象存储和视频平台。但这些系统主要解决“存得下、找得到、能下载”的问题,不解决 AI 使用问题。 AI 需要的不只是文件本身,而是文件里的结构和语义。 一份 PDF 里有哪些章节,哪些表格,哪些结论,引用了哪些规范?一张图纸里有哪些部件、标注、版本和变更记录?一段会议录音里谁提出了问题,谁给出了承诺,哪些事项需要跟踪?一段巡检视频里出现了哪些对象、异常和时间点? 如果这些信息没有被解析、切片、标注、关联和治理,AI 只能拿到一个大文件。文件存在,不代表数据可用。 全模态数据治理要做的第一件事,是把不同格式的数据转成统一的语义对象。 文档要拆成标题、段落、表格、图片、引用和附件。图纸要关联项目、专业、版本、对象和变更。音频要转写成文本,并保留说话人、时间戳和置信度。视频要抽取关键帧、事件片段和对象标签。图片要识别场景、设备、缺陷、文字和拍摄信息。 这些语义对象再进入统一治理层:目录、标签、权限、血缘、版本、质量评分、生命周期、责任人。 只有这样,AI 才能在回答问题时知道:这段依据来自哪份文件,属于哪个项目,是否是最新版本,当前用户是否有权限查看,质量评分是否足够高。 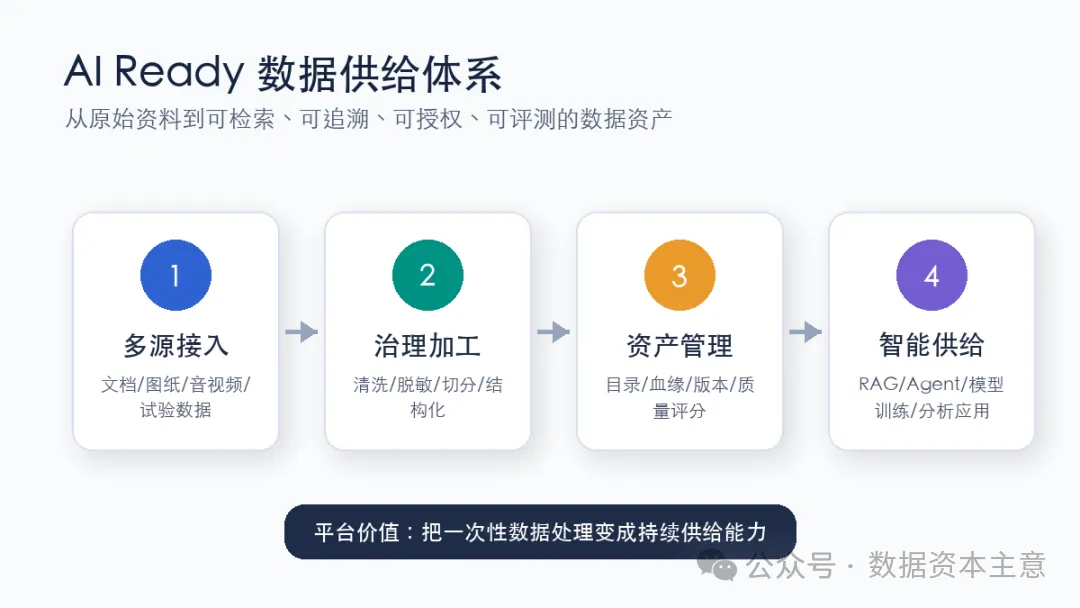
图:AI Ready 数据供给体系 传统搜索只需要把资料找出来。AI Ready 数据资产还要支持模型理解和行动。 第一,要能被精准检索。资料切片不能太粗,否则答案不聚焦;也不能太碎,否则失去上下文。 第二,要能被安全调用。不同角色看到的资料范围不同,AI 检索也必须继承这个边界,不能因为接入模型而绕过原有权限。 第三,要能被追溯解释。AI 给出结论时,要能展示引用来源、文件版本、片段位置和加工链路。 第四,要能持续更新。图纸改版、制度修订、视频新增、会议纪要补充,都要能触发资产更新和索引重建。 第五,要能支持评测。不同切片策略、解析模型、标签体系会影响 AI 输出效果,平台要能用业务问题集持续验证。 在工程建设场景里,AI 可以基于方案、图纸、纪要和规范辅助审查风险点。但前提是图纸版本清楚,会议承诺可追踪,规范条款可引用。 在装备运维场景里,AI 可以结合手册、工单、巡检图片和维修视频辅助诊断。但前提是设备编号、故障码、历史维修记录和视频片段能够关联。 在科研场景里,AI 可以理解论文、实验记录、仪器数据和图像结果,帮助研究人员进行文献对照和假设生成。但前提是数据来源、实验条件和处理流程可追溯。 在集团知识管理场景里,AI 可以回答制度、合同、项目经验和专家问答。但前提是知识资产有权限、有时效、有版本、有责任人。 全模态数据治理不应该变成一堆单点工具:一个 OCR 工具、一个转写工具、一个图片识别工具、一个向量库、一个知识库。如果能力割裂,治理信息就会断掉。 更合理的方式,是建设统一的 AI 数据准备平台,把多模态解析能力作为入口,把语义加工和治理作为中台,把 RAG、Agent、模型训练和智能分析作为出口。 这样,企业每接入一种新模态,都能复用同一套权限、血缘、版本、质量和评测机制。全模态数据才不会停留在“技术展示”,而能成为可运营的数据资产。 未来的企业知识资产,不会只存在于文档里。它会分布在图纸、视频、录音、图片、日志和业务系统之间。谁能把这些内容治理成 AI Ready 数据资产,谁就能让行业 AI 真正看懂业务现场。
一、全模态不是“什么都存”
二、从文件治理走向语义治理