ARTICLE · 1237748
我用 AI 逆向工程 Excel 动态数组引擎:从 Spill 到 LAMBDA,再到一张"业务推理引擎"的蓝图
这不是一篇 Excel 技巧文。这是一次对表格计算范式的逆向解构。
一、起点:动态数组为什么让整个 Office 团队重写了计算引擎
如果你只把 =FILTER() 当成"高级查找",那你还没摸到它的边界。
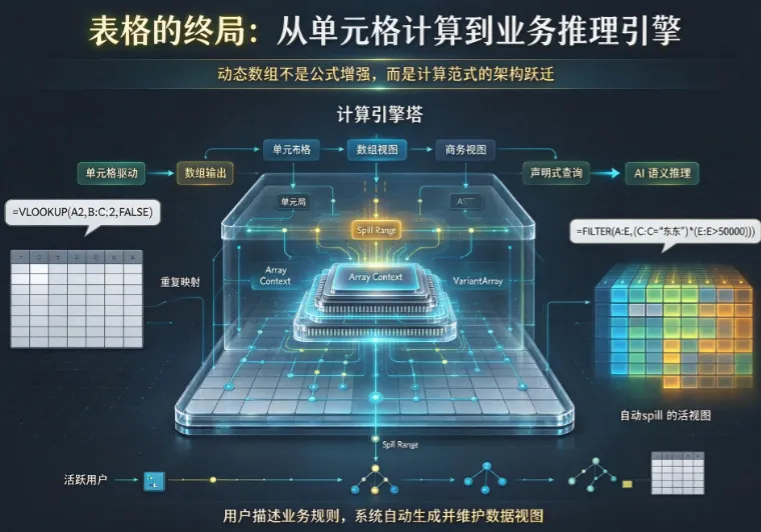
传统 Excel 的计算模型是单元格驱动的——每个格子是一个独立求值单元,公式之间通过引用形成有向无环图(DAG)。这个模型跑了 30 年,直到动态数组(Dynamic Arrays)出现,微软被迫改写了整个求值管线。
核心变化只有一句话:从"单值输出"切换到"数组输出 + 自动 Spill 布局"。
这看似只是返回值类型变了,实际上牵动了整条链路:
- 解析层
:公式不再只产出标量,AST 的叶子节点要能承载 VariantArray - 执行层
:引入"数组上下文"(Array Context),运算时自动广播(Broadcasting),对标 NumPy 的 vectorize 语义 - 布局层
:新增 Spill Range 管理器,负责分配连续内存区域、检测 #SPILL!冲突、处理溢出区的自动扩缩容 - 引用层
: #运算符让下游公式能引用整个溢出区,形成"活的数据视图"
这意味着:Excel 从命令式电子表格,进化成了声明式数据查询引擎。
=FILTER(A:E, (C:C="华东")*(E:E>50000)) 本质上是一条 SQL:SELECT * FROM table WHERE region='华东' AND revenue>50000。只不过结果不是存在数据库里,而是直接渲染到网格上,并且源数据变了,结果自动刷新。
这就是为什么我说动态数组是 Excel 近十年最重要的架构升级——它把"表格"变成了"视图"。
二、逆向工程:如果让 AI 从零复刻一个动态数组引擎
我给 AI 的 prompt 不是"写一个 Excel 替代品",而是:
"基于现代编译器架构,设计并实现一个支持动态数组溢出的表格计算内核,要求兼容 FILTER / UNIQUE / SORT / MAP / REDUCE / LAMBDA / LET 语义,并暴露插件接口允许注入自定义业务函数。"
AI 给出的架构设计,核心分五层:
1. 词法与语法分析层
公式文本 → Token 流 → AST(抽象语法树) 关键难点:处理隐式交集(Implicit Intersection)的向后兼容——老公式期望单值,新公式期望数组,同一个 A1引用在不同上下文含义不同解决方案:引入"预期返回值类型"标注,在 AST 节点上做多态分发
2. 数组执行引擎
核心数据结构: SpillResult { data: NdArray, shape: (rows, cols), anchor: CellRef }广播规则:标量自动扩展为与操作数同形的数组;形状不兼容时报 #CALC!惰性求值:对 MAP/REDUCE等高阶函数,采用惰性迭代器模式,避免中间数组的 O(n²) 内存爆炸LAMBDA的实现本质是闭包——捕获自由变量,生成可重复调用的匿名函数对象
3. Spill 布局管理器
每个数组公式绑定一个"锚点单元格" 求值完成后,根据输出 shape 计算目标区域 检测目标区域是否被非空单元格阻塞 → 阻塞则标记 #SPILL!,释放已分配区域上游数据变更时,重新触发 DAG 中依赖节点的增量重算
4. 函数注册表
内置函数库:FILTER / UNIQUE / SORT / SEQUENCE / RANDARRAY / MAP / BYROW / BYCOL / REDUCE / SCAN / LAMBDA / LET 插件接口:允许外部注入自定义函数(对标 Excel 的 LAMBDA + Name Manager,但开放为 SDK)
5. 持久化与版本
公式 DAG 快照序列化 支持时间旅行调试:回放任意历史版本的求值状态
AI 写到第三天,在日志里留了一句:
"动态数组本身不难,难的是在 30 年技术债上做非破坏性升级。微软工程师是真的硬。"
确实。你以为只是"返回多个值",实际上是在一个为标量设计的系统里,硬塞进了一套完整的数组计算管线。
三、跨界思考:如果在这个引擎上做 Excel 不敢做的事
Excel 的约束是通用性——它不能假设你是做财务的、做供应链的、做 SaaS 增长的。但一个"AI + 动态数组"的复刻项目没有这个包袱。
以下是我列的"扩展层"设计,每一个都对应一个真实工程痛点:
1. 类型系统与脏数据自愈
Excel 的单元格本质是无类型 Variant。这导致:
"00123"被自动转为 123(丢失前导零语义)13800138000被科学计数法化为 1.38E+10合并单元格破坏了一维数据的连续性 日期存储为序列号,但用户常输入文本格式的日期
扩展方案:引入可选的列级类型标注(类似 Pandas 的 dtype),在计算引擎前加一层类型感知的 ETL 管线。对常见脏模式做自动修复:前导零保留、手机号字符串化、日期模糊解析(支持 "2026年3月" / "2026-03-01" / "3/1/2026" 统一归一化)。
2. 表格 Diff 引擎
两个版本的表格对比,Excel 只有"比较文件"这种粗粒度功能。
扩展方案:基于公式 DAG 的节点级 Diff。精确到:
哪个单元格的公式被修改(AST 级别的差异) 哪个 Spill 区域的输出形状变了 哪行数据因为上游条件变化而进入/退出 FILTER 结果
实现思路:对两次快照的 DAG 做拓扑排序后的逐节点 hash 比对,输出结构化 Diff JSON,前端渲染为红绿高亮。
3. 时间旅行求值回放
扩展方案:在持久化层记录每次重算的触发链(哪个单元格变更 → 哪些节点失效 → 重算后的新值)。提供一个时间轴 UI,可以拖拽回放到任意历史时刻,看到当时的完整表格状态。这对财务月末对账、数据异常溯源是杀手级功能。
4. 业务语义层(Business Semantic Layer)
这是最值得展开的一点。
Excel 函数操作的是数据值,但业务决策需要的是业务概念。比如"活跃用户"——在你们公司,它可能是"近 30 天登录 ≥ 2 次且完成 ≥ 1 笔交易的去重用户 ID"。这个定义在 Excel 里只能硬编码进每个公式。
扩展方案:引入领域特定语言(DSL),允许定义业务实体和规则:
entity User {
  is_active: login_count(last_30d) >= 2 && txn_count >= 1
  ltv: sum(revenue) where user_id == self.id
}

view ActiveUserReport {
  source: User
  filter: is_active == true
  group_by: city
  aggregate: count(), avg(ltv)
}
底层编译为动态数组公式,但上层是业务语义。AI 可以直接从自然语言需求生成这个 DSL,再编译为引擎可执行的数组操作。
5. 公式自然语言接口
=MAP(SEQUENCE(100), LAMBDA(x, IF(x<=10, "A"&x, "B"&x))) 这种写法,对非程序员极不友好。
扩展方案:在计算引擎上层加一层 NL-to-Formula 翻译器。用户输入:"给 A 列每个值前面加前缀,前 10 行加 A,后面加 B",AI 生成公式并附带解释。更进一步:AI 直接操作引擎的 AST 接口,绕过公式文本层,用代码生成代码。
四、底层认知:AI 时代,表格计算的本质是什么
写到这里,我想回到一个更根本的问题。
Excel 动态数组的出现,本质上是在承认一件事:人类不应该手动管理数据的形状和流向。
你写 =VLOOKUP(A2, B:C, 2, FALSE) 然后往下拖 5000 行——这是在用人类的重复劳动去模拟一个本该由机器自动完成的映射操作。动态数组把这件事干掉了。
但这还不够。
真正的终局是:用户描述业务规则,系统自动生成数据视图,视图自动维护自身的一致性。
这其实就是数据库物化视图(Materialized View)+ 电子表格的交互范式 + AI 的语义理解能力的融合体。
AI 在这里的角色不是"帮你写公式"——那是 Copilot 级别的玩具。AI 的真正价值是:
- 理解业务上下文
(你们公司的"活跃用户"到底怎么定义) - 生成计算图
(把业务规则编译为 DAG) - 自适应演化
(数据源变了、规则改了,自动调整下游视图)
Excel 做不到这些,因为它是一个通用工具,不能假设你的业务语义。但一个由 AI 驱动、基于动态数组引擎的专用系统可以。
五、结语:下一个十年,表格的终局
我让 AI 逆向复刻 Excel 动态数组,不是为了做一个"开源 Excel"。
是为了验证一个判断:
表格软件的未来不是"更好的格子",而是"更聪明的视图"。
当 AI 能理解你的业务语义,当计算引擎能自动管理数据流向,当 Spill 区域能像活细胞一样自我调整——你面对的就不再是"电子表格",而是一个业务推理引擎。
到那时,VLOOKUP 会像汇编语言一样——有人懂,但没人手写。
而你现在花三天背的 SUMIFS 嵌套技巧,AI 三秒就能生成、三毫秒就能执行、三分钟就能根据新需求重构。
所以真正该练的技能不是"公式背得熟",而是:
能不能把模糊的业务需求,清晰地翻译成计算逻辑。
这是 AI 替代不了的。至少目前。