ARTICLE · 1238415
会"聊天"的诊断 AI 走进真实门诊
THE LANCET · 前沿速递
会"聊天"的诊断 AI 走进真实门诊:1452 次就诊中,AMIE 交出了怎样的答卷?
对话式诊断人工智能在门诊初级保健中的前瞻性可行性研究
The Lancet · 2026年10月8日在线发表 · DOI: 10.1016/S0140-6736(26)01535-7
如果有一天,你走进社区门诊之前,先和一个 AI "聊"了一轮病史,它会问诊、会给出可能的诊断、会建议下一步检查——然后这份对话记录被交给你的家庭医生,作为就诊参考。听起来像科幻,但它已经在波士顿的一家学术医学中心真实发生了。
2026 年 10 月 8 日,The Lancet 在线发表了 Google 与 Beth Israel Deaconess Medical Center(BIDMC)合作的一项前瞻性可行性研究:让患者面向的对话式诊断 AI——Articulate Medical Intelligence Explorer(AMIE),在真实世界的急诊型初级保健(urgent care)就诊流程中,与真实患者展开临床对话。这是迄今首批在真实、主动求医的患者身上,检验 LLM 患者面向对话系统安全性与对话质量的注册研究之一。
一句话结论
在医生实时监督下,AMIE 与真实患者的对话没有触发任何一次预设安全中止,对话质量被临床评估者高度评价;管理计划整体质量与人类医生相当,但在"成本效益"和"可行性"上人类医生更优。患者对 AI 的态度在交互后明显改善,并在就诊后保持。研究强调:这仍只是可行性证据,远不足以支持 AI 自主诊断。
一、研究背景:为什么必须到"真实世界"去验证
初级保健是大多数医疗咨询的起点,也是 AI 介入最有可能放大系统效率的环节。全球初级保健医生(PCP)短缺、患者老龄化与多病共存、长期疾病管理日益复杂,共同推动了对话式 AI 的投资热潮。
然而,"在实验环境里表现优异"不等于"在真实诊室里安全可用"。既往证据多来自标准化病人(演员)模拟或受控的远程医疗场景:患者面对 AI 系统(症状检查器、分诊工具、非 LLM 聊天机器人)时表现参差,临床效果有限。作者团队在系统综述基础上指出,既往研究几乎没有评估过"把可能的诊断直接呈现给真实患者"这一高风险动作的安全性与质量。
此前反复出现的担忧包括:幻觉或过度自信的输出、分诊不足、不一致的管理建议,以及患者判断 AI 医疗建议的能力。正是在这样的缺口下,研究团队把 AMIE 从模拟推向了真实门诊。
二、研究设计:三步流程 + 医生"盯屏"实时监督
这是一项前瞻性、单中心、单臂可行性研究,在 BIDMC 下属学术初级保健机构 Healthcare Associates(HCA)开展。研究按 TRIPOD-LLM 报告规范撰写,并在 ClinicalTrials.gov 预注册(NCT06911398)。
每位患者的研究流程分为三个明确步骤:
▶ 第 1 步:与 AMIE 文本对话患者在原定急诊就诊前 0–5 天远程登录,通过同步文本界面与 AMIE 对话。全程由一名 BIDMC 认证内科医生担任"AI 监督者",通过共享屏幕的视频通话实时旁观患者–AMIE 对话,随时可中止。
▶ 第 2 步:患者就诊 PCP患者按计划看 PCP(线下或远程),此时 PCP 已可查看 AMIE 的对话转录与自动摘要,作为就诊准备材料。
▶ 第 3 步:8 周后图表审阅与评估从病历中提取"仲裁参考诊断",并由三名独立临床评估者,在盲法且随机化的方式下,分别对 AMIE 与 PCP 的对话质量和管理计划进行评分。
研究的技术底色:AMIE 基于 Gemini 2.5 Pro(知识截止 2025 年 1 月)构建,未做任何领域特定微调。在完成 53 例交互后,因研究基础设施算力限制导致明显延迟,系统基础模型被切换为 Gemini 2.5 Flash,延迟显著降低。由于预注册仅限定了"交互与工作流"而未限定模型版本,这一切换未被认定违反方案。
监督者的介入不是随意判断,而是基于四项预设中止标准:① 对自伤或伤人的即刻担忧;② 患者因 AI 交互出现显著情绪困扰;③ 监督者基于对话识别出潜在临床伤害;④ 患者明确要求结束会话。对话结束后,监督者会立即与患者视频"复盘",澄清信息、纠正任何错误或幻觉。
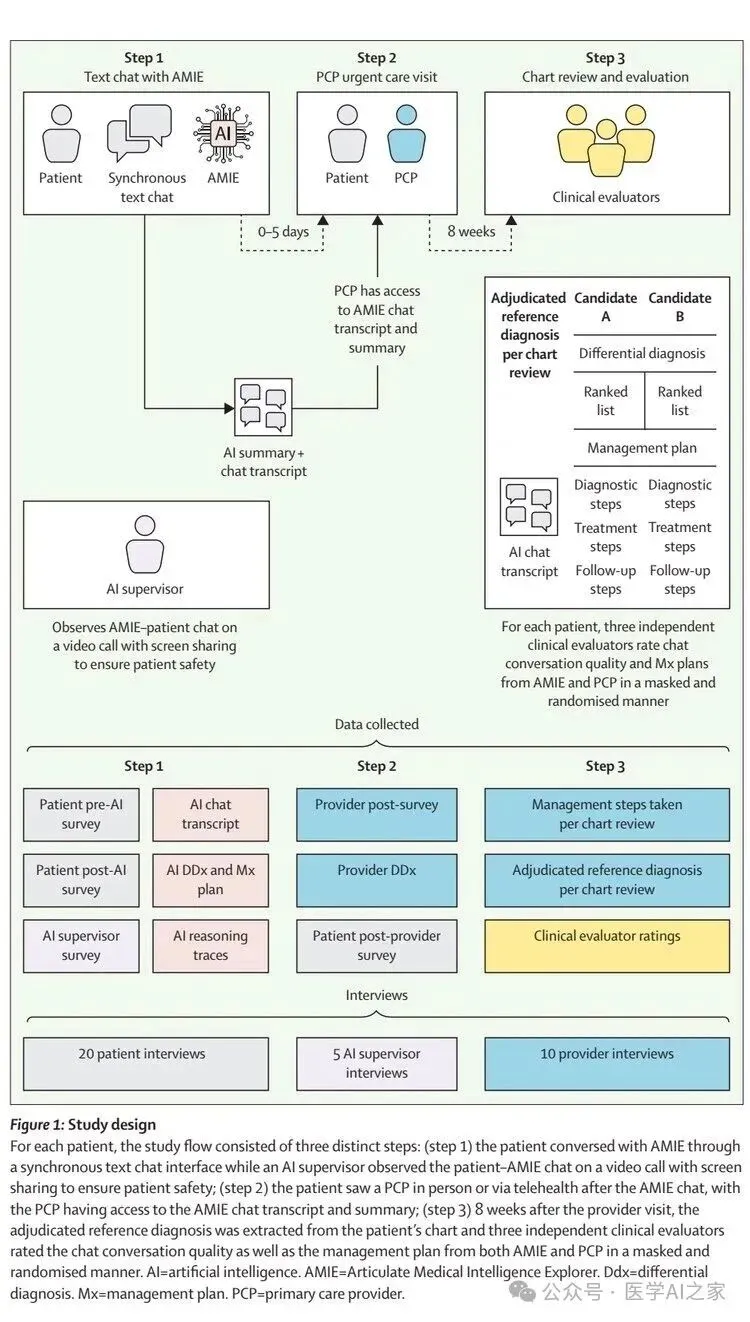
图 1 研究设计:三步流程——患者先与 AMIE 文本对话(AI 监督者共享屏幕实时旁观),再就诊 PCP(PCP 可查阅 AMIE 转录与摘要),8 周后由三名独立临床评估者盲法随机评分
入组与排除:入选者需为 HCA 的既有患者、≥18 岁、EHR 记录中英语为主要语言、已激活在线患者门户,并有笔记本或台式机(不能用手机)远程使用 AMIE;须为单一主诉的急诊初级保健预约,且经门诊分诊人员判定无需急诊救治。出于伦理考虑,排除已知怀孕者和心理健康相关主诉(AMIE 未在既往模拟研究中验证过精神科场景)。入组持续至 200 名患者签署同意或完成 100 次完整对话,以先到者为准。
三、研究结果
3.1 参与者流程:从 1452 次就诊到 98 例分析
研究期间 HCA 共安排了 1452 次急诊就诊。流程为:140 名患者口头同意 → 其中 20 人未完成同意书 → 114 人开始 AMIE 交互 → 14 人因方案偏离或技术问题未完成(含 2 人使用手机、1 人键盘问题、1 人屏幕共享问题、2 人无法进入在线会议、1 人笔记本电脑问题、5 人系统不可用,以及 2 人在对话中触及排除标准——1 例怀孕、1 例心理健康)→ 100 人完成 AMIE 交互(完成率 88%)→ 2 人未完成 PCP 就诊 → 最终 98 人同时完成 AMIE 与 PCP 就诊,纳入分析。
值得注意的是,两名未按时就诊的患者,事后图表审阅显示他们后来都看了 PCP,且未因错过预约造成伤害。
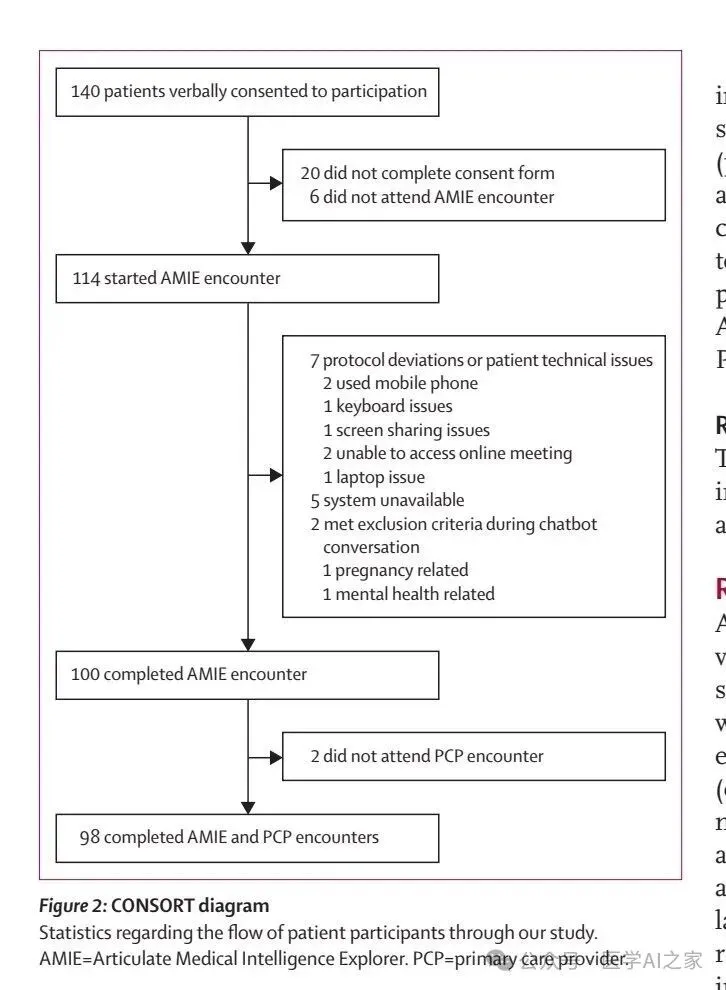
图 2 CONSORT 流程图:患者从筛选、口头同意、开始交互到最终纳入分析的完整流向
人群特征(98 例已完成者):参与者在年龄上明显偏年轻——51%(50/98)不到 50 岁,而研究期间该门诊全部急诊就诊中超过六成由 60 岁以上患者构成;女性占 68%(67/98)、白人占 49%(48/98),而同期总就诊人群女性占 71%(1034/1452)、白人占 54%(787/1452)。健康素养与技术素养均为"高"者各占 46%。这一特征提示样本并不能完全代表真实世界的广泛人群。
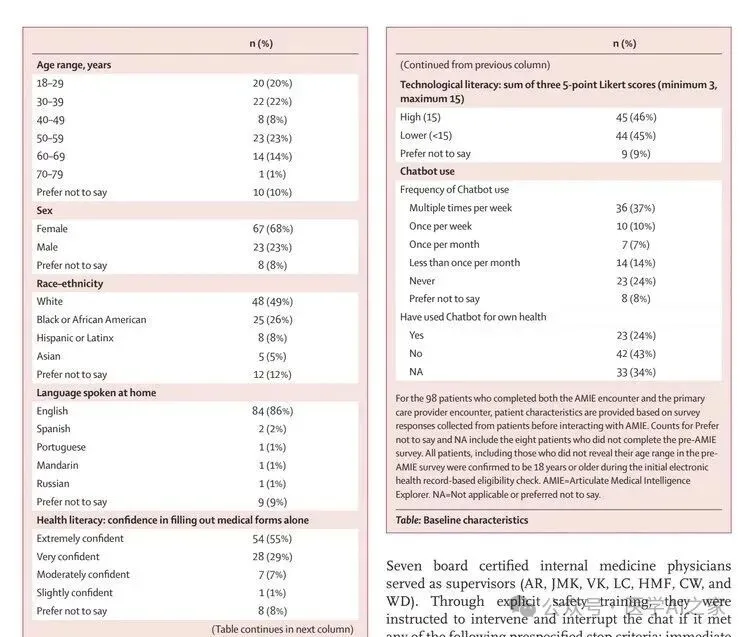
表 1 98 例完成 AMIE 与 PCP 双重就诊患者的基线特征(年龄、性别、种族、健康与技术素养、聊天机器人使用情况等)
3.2 安全性:零次安全中止,但并非零风险
在所有患者–AMIE 交互中,按四项预设安全标准,监督者未启动任何一次对话安全中止(0 次)。这与既往其他真实世界对话式 AI 评估中"安全干预率低"的发现一致。
但研究中仍记录到:
⚠️ 1 次幻觉:AMIE 把患者提供的一个手术日期说成"将来",而事实上该日期在对话当天已经过去。
5 次监督者补充临床信息:其中 3 例 AMIE 将恶性肿瘤列入可能诊断,监督者事后补充安慰,说明 AMIE 是在形成一份涵盖"不能漏诊"疾病的广谱鉴别清单,并提供了患者错过 PCP 就诊时的应急方案;另 2 例分别涉及进一步澄清症状以排除潜在急症、以及澄清何时应寻求急诊救治的标准。
3.3 对话质量:医生给出高分,患者整体认可但"信任"偏低
从临床评估者视角,AMIE 的对话在 17 项标准中,被评"favourable 或 very favourable"的比例高达 87%–100%。从患者视角,在 16 项标准中,积极评价比例为 48%–96%——绝大多数标准表现良好,唯独两项偏低:「信任信息保密」与「诚实可信」。
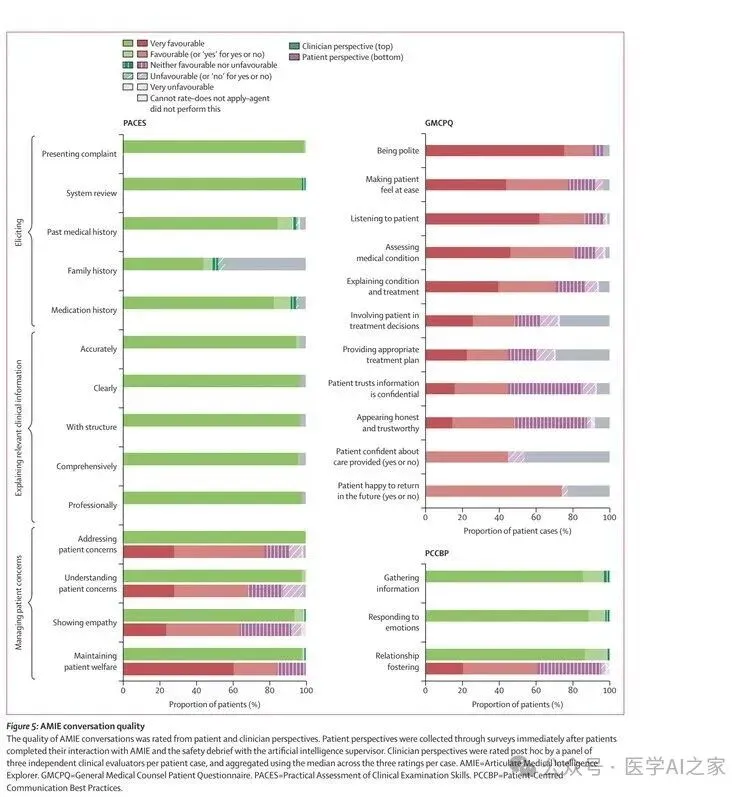
图 5 AMIE 对话质量:上方为临床评估者(PACES/GMCPQ/PCCBP),下方为患者视角。可见患者对"信息保密"与"诚实可信"两项的评分明显低于其他维度
在医生与患者都评分的四项 PACES 维度(关注患者关切、理解患者关切、展现共情、维护患者福祉)上,医生对 AMIE 的评分一致高于患者。作者指出,这种分歧与更广泛的"医患沟通评分不一致"文献相符——两组视角本就相关性很低。而在"礼貌、让患者放松、倾听、解释病情与治疗"等方面,患者评分普遍较高。
3.4 患者态度:交互后改善,就诊后维持
研究采用改编自 GAAIS 的 GAPFAIS 量表(9 项,含正向与负向两个子量表),在三个时间点测量患者对患者面向 AI 的态度——交互前(pre-AI)、交互后(post-AI)、就诊后(post-provider):
正向子量表:3.62(pre-AI,n=90)→ 3.84(post-AI,n=89)→ 3.81(post-provider,n=88);整体 Friedman 检验 p<0.001,交互前后 p<0.001,交互后 vs 就诊后 p=0.56。
负向子量表:2.90(pre-AI)→ 3.13(post-AI)→ 3.12(post-provider);整体 p<0.001,交互前后 p<0.001,交互后 vs 就诊后 p=0.93。
两个子量表均在与 AMIE 交互后显著改善,并在就诊后保持稳定(未回落)。研究者同时提醒多项解读限制:GAPFAIS 是 20 项 GAAIS 的改编子集,删去了若干载荷较高的负向条目,可能降低了对某些负面维度的敏感度;三次重复测量同一量表可能引入"练习/重测偏差";该量表尚未独立完成心理测量学验证。
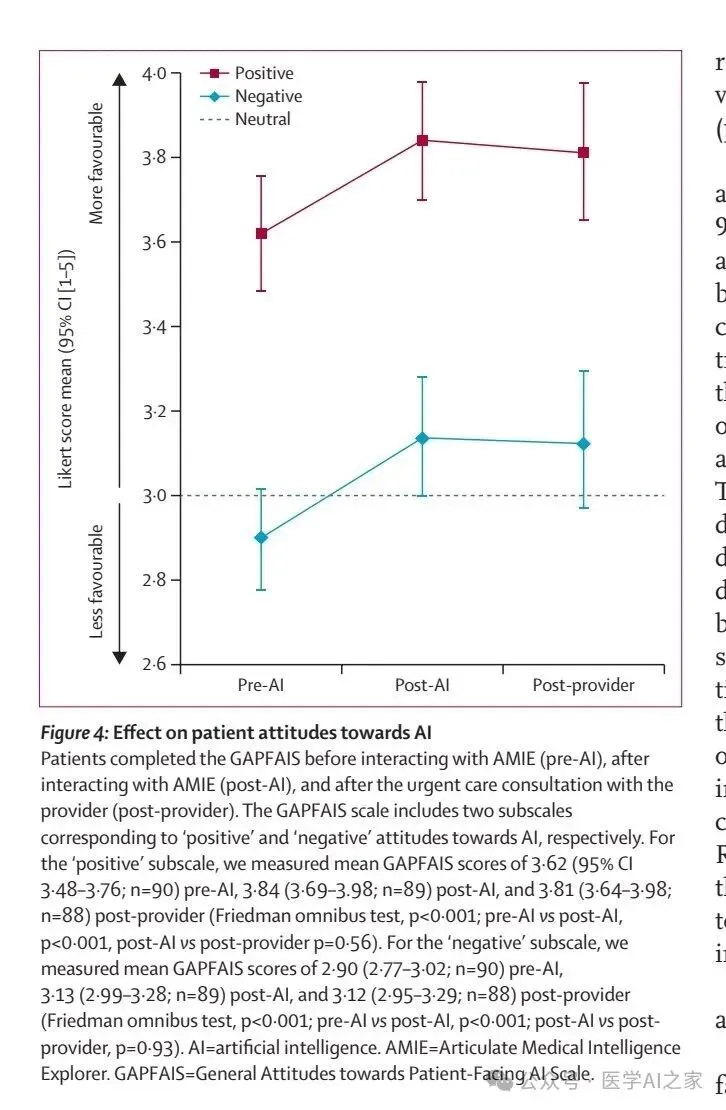
图 4 患者对 AI 的态度变化:正向与负向子量表的均值评分(含 95% CI)在交互后上升,就诊后保持
3.5 临床推理与管理计划:整体相当,细节人类更优
管理计划对比(盲法随机):临床评估者认为两者质量相当的占 48%(47/98);偏好 AMIE 的占 26%(25/98,其中 20 例"slightly better"、5 例"much better");偏好 PCP 的占 27%(26/98,21 例"slightly better"、5 例"much better")。评估者准确猜出计划来源的比例为 59%(58/98)。
逐项评分(favourable 或 very favourable):
| 97%(95/98) | <0.01 | ||
| 100%(98/98) | <0.01 |
诊断准确率(top-k,基于 Bond–Graber 评分 ≥4):在前 7 个候选诊断中命中仲裁参考诊断的比例为 90%(88/98),前 3 个为 75%(73/98),首位即命中为 56%(55/98)。诊断一致性评分 κ=0.76–0.80(substantial 一致性);PACES κ=0.61–0.94,PCCBP κ=0.41–0.54,管理计划比较 κ=0.28–0.58。
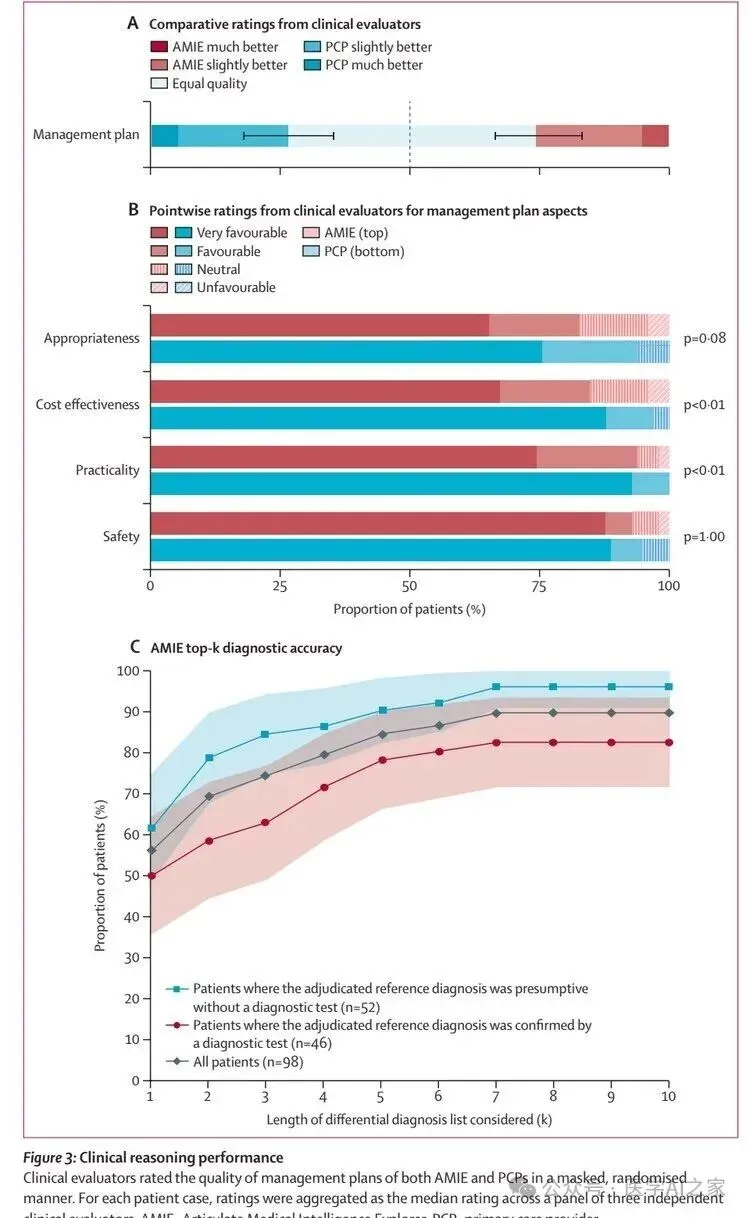
图 3 临床推理表现:A 两组管理计划比较评分;B 管理者计划各维度逐项评分;C AMIE 的 top-k 诊断准确率(全体 / 检验确认亚组 / 推测性亚组)
3.6 PCP 视角:多数认为有帮助,但出现过 1 例"可能有害"
PCP 问卷完成率最低,为 61%(60/98)。在这 60 例中,44 例表示在就诊前有机会查看 AMIE 转录或摘要。其中:75%(33/44)认为用 AMIE 准备急诊就诊"非常有帮助或有些帮助";57%(25/44)表示 AMIE 可能改变了他们的行为。
但有 1 例被评为"somewhat harmful":该例 AMIE 的鉴别诊断包含淋巴瘤,就诊时 PCP 推断患者可能因此产生焦虑,事后认为该交互具有某种伤害性。此外,有 3 例 PCP 在自由文本中担心,AMIE 转录可能带来过早诊断封闭(premature diagnostic closure)的风险。
四、讨论:意义、警示与局限
作者认为,这是首个在真实门诊工作流中、面向主动求医的急诊初级保健患者、并明确向患者呈现可能诊断的 LLM 患者面向对话式诊断 AI 注册研究。研究显示:在人类医生监督下,AMIE 的部署在流程上是可行的,交互完成率高、随访到诊率高,且未触发安全警报。
以下几个要点尤其值得关注:
① 技术门槛真实存在。约 7% 的入组患者因设备相关问题无法完成,且由于招募时已筛掉设备不足者、人群偏年轻高素养,这一比例很可能被低估。扩展至移动端与语音检测预计能缓解部分障碍。
② 监督效应不可忽视。实时监督可能带来"霍桑效应"——患者知道被观察,可能减少对抗性提示(如故意拿出网上搜索的"证据"),从而让安全性表现看起来更好。
③ 信任是核心难题。医生对 AMIE 的沟通评分普遍高于患者。真实世界中的"信任"评分明显低于模拟环境;AI 医疗信任被认为与人类医生关系密切相关,也需通过重复交互逐步建立。
④ 诊断锚定风险。AI 监督者与 PCP 都提醒,把 AI 诊断引入工作流存在诊断锚定/过早封闭的实施风险;未来需要人机交互试验来限制自动化偏差。
研究局限:单臂、单中心、样本量小(100 例);人群偏年轻、健康与技术素养高,代表性有限;排除了孕妇和心理健康人群,仅纳入单一主诉患者;缺乏对照组,加之经济激励、实时监督与新技术的"新鲜感",用户接受度评分可能被高估。此外,管理计划评分使用的是经 LLM 重新格式化后的版本(用于评分者盲法),该转换对 AI 或人类可能有利也可能不利,方向难以先验判断。AMIE 缺乏 EHR 与体格检查、多模态信息(语音语调、皮疹照片等),其诊断表现"很可能被当前条件低估,也可能通过更深的系统集成而增强"。
五、意义与展望
研究传递出两个方向的信息。一方面是乐观的可行性信号:对话式诊断 AI 可以在真实、受监督的临床流程中安全地开展对话,甚至向患者呈现可能诊断,这意味着 AI 与患者的交互有望从"简单信息收集"走向"协作与咨询"。
另一方面是清晰的边界:现有证据不支持 AI 用于自主诊断、分诊或管理。作者明确指出,本研究尚不足以证明 AI 已准备好进入"human-on-the-loop"(人工兜底)的自主工作流,但为未来的多臂随机对照试验提供了必要的可行性基础——这些试验需要评估患者结局、诊断安全、医患沟通、医生工作量、公平性、成本,以及安全使用所需的监督强度。
从"人在环中(human-in-the-loop)"走向"人工兜底(human-on-the-loop)",需要重新设计监督方案(如从实时医生监控转向紧密的医生随访),并考虑模型自报置信度是否足以用于分诊、以及如何建立监测不可行时患者自报伤害的机制。用一句话概括:这是一块重要的垫脚石,但通往诊室的路还很长。
文献信息:Brodeur PG, Koshy JM, Palepu A, et al. Conversational diagnostic artificial intelligence in ambulatory primary care: a prospective feasibility study. The Lancet. Published online October 8, 2026. DOI: 10.1016/S0140-6736(26)01535-7.
试验注册:ClinicalTrials.gov NCT06911398