ARTICLE · 1243892
优化|数学软件是如何求解线性方程Ax=b ?
作者:陈宇文,牛津大学在读博士生
编者按
对于大家来说,我们从学会多项式开始就得和求解矩阵方程打交道。大学之前靠手算,到了大学阶段我们学会了使用科学计算软件,然后只需要输入简单的一行指令,就可以轻轻松松求解方程组那么它在优化算法中有什么样的作用呢?实际应用时候又会出现什么样的问题呢?
优化和线性系统求解实例
优化问题和求解线性系统是紧密相关的。对于如下的优化问题,
的KKT条件就是
对于二次规划中常用的算子分裂法[1],[2]和内点法[3],算法的每一个周期其实也是需要求解如下的线性系统
而且求解线性系统往往是算法中最耗时的一部分,决定了一个优化算法的最终收敛速度。
线性系统求解方法
在数学上求解线性系统是很直观的,因为,那么我们计算逆矩阵然后乘上b似乎就解决了。这主要会带来几方面问题:
(1)求解A矩阵的逆将会很费时;
(2)即使是稀疏矩阵,它的逆矩阵也往往会丧失稀疏性,需要更多的内存来进行存储;
(3)当矩阵的条件数很差(ill-conditioned)时,这种方式的求解很可能会带来很大的误差。
求解线性系统一般分为两种方法。一种是直接法,先对矩阵进行分解(factorization),然后通过分解矩阵进行反向求解(back-solve)。另外一种是迭代法,通过不断的矩阵乘法和加减法得到最后的解。
基于矩阵分解的直接法
针对矩阵的特殊结构,代码底层会调用不同的矩阵分解方法。Julia的LinearAlgebra模块自动调用方法如下[4]: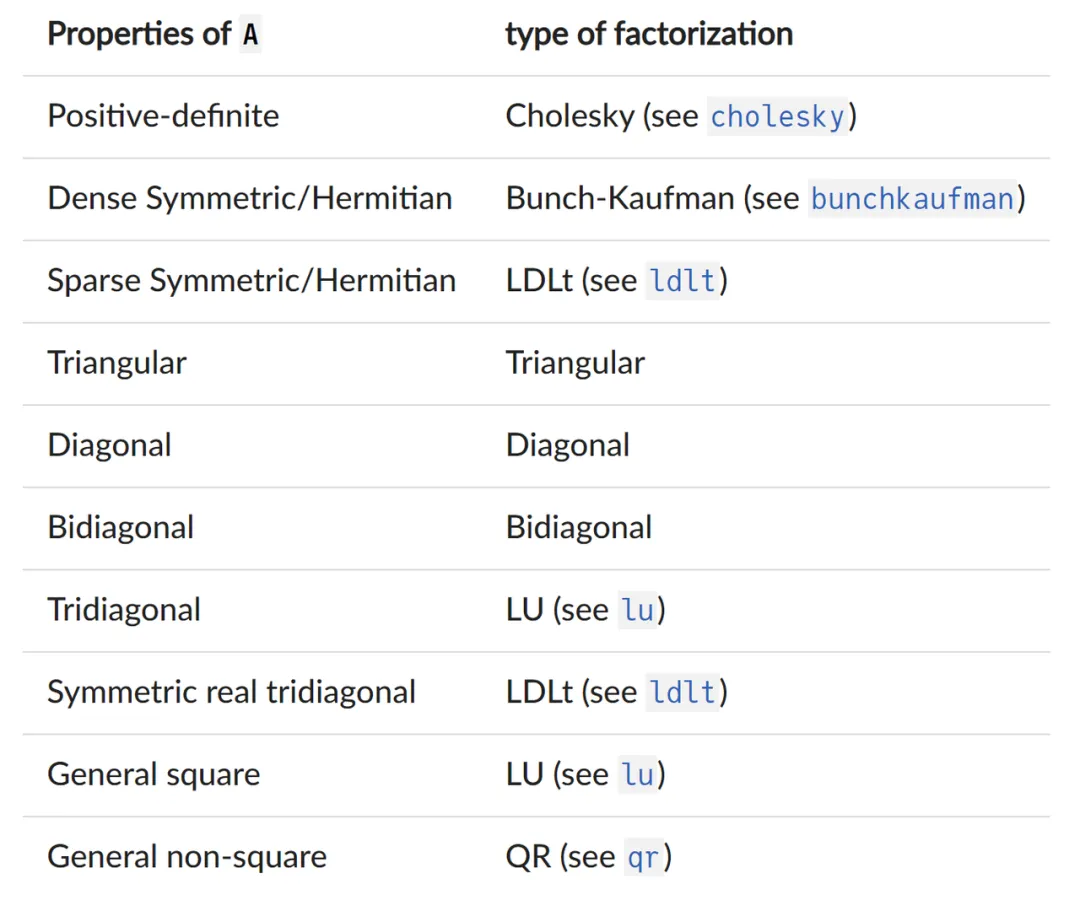
我们在这复现一段相关的Julia代码:
using LinearAlgebran = 10m = 8P = rand(n, n)P = P' * P + 0.1*IG = sprand(m,n,0.2)d = rand(m)d[1:3] .= 1e9d[6:end] .= 1e-9 A = [P G'; G -diagm(0=>d)] #生成矩阵 A = [P G'; G -D] A = A + A'R = factorize(A) #ldlt分解typeof(R) 返回的结果将为
BunchKaufman{Float64, Matrix{Float64}, Vector{Int64}}可见对于正定对称矩阵,此时factorize()函数自动选择了BunchKaufman LDL分解。此时求解x的值可以调用得到,得到的效果和是一样的。
另外矩阵的稀疏性也会决定矩阵方法的使用。如果运行如下代码
using SparseArraysR = factorize(sparse(A)) #ldlt分解typeof(R) 此时会采用稀疏形式的LDL分解,并且调用的是不同的SuiteSparse包。
SuiteSparse.CHOLMOD.Factor{Float64}type: LDLtmethod: simplicialmaxnnz: 80nnz: 80success: true感兴趣的同学也可以参考matlab文档 (Algorithms部分)了解分解方法选取的逻辑图,https://uk.mathworks.com/help/matlab/ref/mldivide.html#bt4jslc-6。
现在最常用的求解线性系统的包应该还是LAPACK(配合BLAS进行矩阵乘法运算),但是LAPACK本身是用Fortran语言写的。所幸的是,LAPACK现在基本都有在不同语言下的接口。感兴趣的同学可以参考不同语言下相关的调用方式
•Python:https://docs.scipy.org/doc/scipy/reference/linalg.lapack.html
•Julia:https://docs.julialang.org/en/v1/stdlib/LinearAlgebra/#LinearAlgebra.LAPACK
直接法的优势是数值性能很稳定,然后一个矩阵一旦完成分解后,可以重复高效的利用矩阵分解进行计算,如SCS[1],OSQP[2]的底层算法。
基于迭代的间接法
间接法是另外一大类常用的矩阵求解算法。跟基于矩阵分解的直接法一样,也有很多基于矩阵的结构对应设计的间接求解线性系统的方法,下图截取自Julia的IterativeSolvers.jl的包: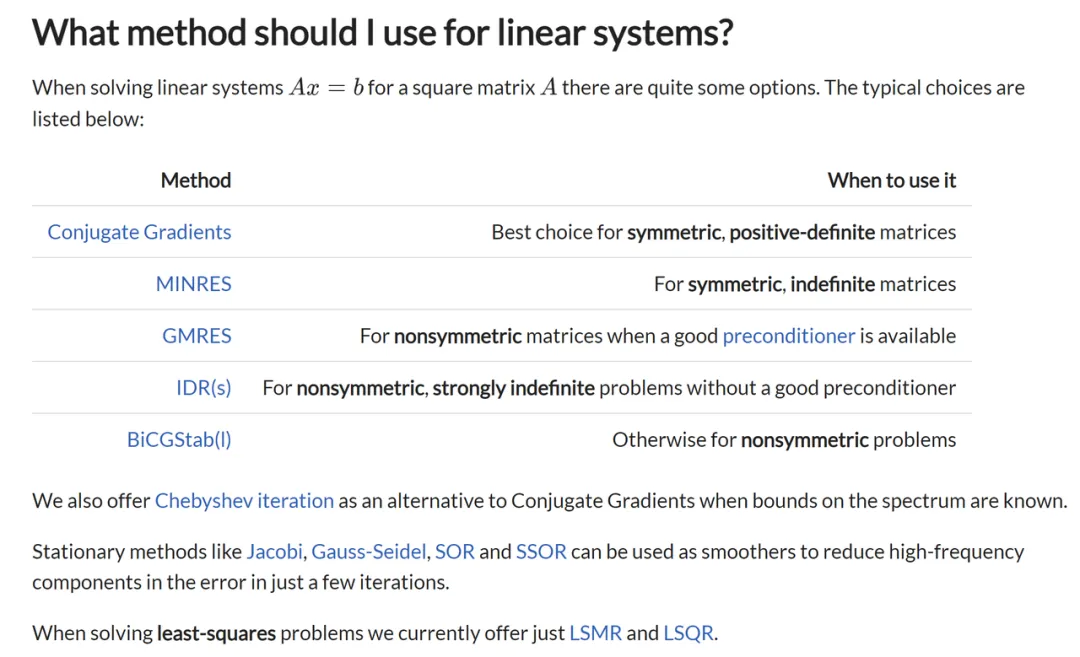
稀疏性
在实际使用中,我们也需要考虑矩阵的稀疏性,如果矩阵本来是稀疏的,但是没有设置成稀疏类型,程序底层也会自动选取非稀疏形式的矩阵分解。当运行如下代码时:
using LinearAlgebra, SparseArrays using BenchmarkTools #记录时间的包 A = Symmetric(sprandn(1000,1000,0.01)) #1000 x 1000 矩阵,稀疏性为0.1~0.2 A = A + 0.1*I #避免不满秩 Ad = Matrix(A) @assert issymmtric(Ad) #确保矩阵是对称的 typeof(A) # Symmetric{Float64, SparseMatrixCSC{Float64, Int64}} @btime factorize(A) # 28.833 ms (74 allocations: 6.58 MiB)# SuiteSparse.CHOLMOD.Factor{Float64}# type: LDLt# method: simplicial# maxnnz: 191629# nnz: 140279# success: true typeof(Ad) # Matrix{Float64} @btime factorize(Ad) # 60.418 ms (8 allocations: 15.76 MiB)# BunchKaufman{Float64, Matrix{Float64}, Vector{Int64}}可以看到上述代码中,当使用稀疏矩阵时,矩阵分解时间约为28.833ms,但是如果使用非稀疏矩阵类型,的矩阵分解时间就变成了60.418ms。
具体选取稀疏矩阵类型还是非稀疏类型取决于实际矩阵的稀疏性。如果我们将上述代码矩阵稀疏性提高10倍,则有如下结果:
A = Symmetric(sprandn(1000,1000,0.1)) # A的稀疏性变成之前的10倍 A = A + 0.1*I #避免不满秩 Ad = Matrix(A) @assert issymmtric(Ad) #确保矩阵是对称的 @btime factorize(A) # 161.359 ms (74 allocations: 25.00 MiB)# SuiteSparse.CHOLMOD.Factor{Float64}# type: LDLt# method: simplicial# maxnnz: 473377# nnz: 431513# success: true @btime factorize(Ad) # 62.464 ms (8 allocations: 15.76 MiB)# BunchKaufman{Float64, Matrix{Float64}, Vector{Int64}}可以看到,非稀疏矩阵分解时间几乎不变,而稀疏矩阵分解的时间反而远大于非稀疏矩阵分解的时间。
优化问题中如何求解系统(3)
这时候,如果我们回过头去看(3)中的矩阵,它本身是quasi-definite的,并且大部分实际问题下都是稀疏的,这样就非常适合使用LDL分解法[5]。许多求解器的底层都是默认使用这个矩阵分解方法。
数值实验
最后,我们对于公式(3)中定义的矩阵进行了数值实验(Julia源码),为了能有更直观的对比效果,我们人为的生成了一个条件数很差的矩阵。
using LinearAlgebra, SparseArraysn = 10m = 8P = rand(n, n)P = P' * PV, D = eigen(P)D[1:5] .= 1e-6D[6:end] .= 1e6P = V * D * V'G = sprand(m,n,0.2)d = rand(m)d[1:3] .= 1e9d[6:end] .= 1e-9 A = [P G'; G -diagm(0=>d)] #生成矩阵 A = [P G'; G -D] A = A + A'cond(A) # 返回条件数(Condition Number)= 1.0000000013286812e18#ldlt分解F = ldlt(sparse(A))invA = inv(A)x = zeros(m+n)x[10] = 1e-5x[15] = 1e5b = A*xx1 = invA*bx2 = F\b#Ax=b系统误差res1 = norm(A*x1-b,Inf) # res1 = 4.304065664004539e-7 res2 = norm(A*x2-b,Inf) # res2 = 2.9103830456733704e-11nnz(sparse(A)) #A中的非零项有136个nnz(sparse(invA)) ##invA中的非零项有290个 (很接近18x18=324)实验结果表明,当条件数很大时(例如),通过直接的逆求解得到的误差将会比用矩阵分解法得到的大很多,并且矩阵中非零项接近于矩阵的维度本身,丧失了潜在的稀疏性。
对于同样的问题,我们再利用迭代法GMRES求解同样的方程:
using IterativeSolversx3 = gmres(A,b)res3 = norm(A*x3-b,Inf) # res3 = 9.188644068589468e-5可以发现对于条件数很差的矩阵,如果不做任何处理,那么迭代法最终求解的精度将很差。改善迭代法收敛精度可以通过从一个很好的初始值进行迭代来进行改善:
x4 = deepcopy(x1) #拷贝已知的x1 = A^{-1}b的值作为迭代法初始值,此时误差为4.304065664004539e-7 gmres!(x4,A,b)res4 = norm(A*x4-b,Inf) # res4 = 8.273806188044642e-14 可以看到,如果迭代法具有很好的初始值,那么收敛精度也是可以很高的!
另外一种改善迭代法精度的方法是采用preconditioning方法改善矩阵的条件数,使得迭代法能有更好的收敛结果,在这儿就不做详细论述了。此外,对于不同矩阵结构迭代法的选取(以及preconditioning),感兴趣的同学可以参考matlab文档https://uk.mathworks.com/help/matlab/math/iterative-methods-for-linear-systems.html。
两种方法的优缺点
那这两种方法各有什么优缺点呢?看看ChatGPT给出的回答:
下面是每种方法的优缺点:
直接法:
优点:
•可以保证唯一解(如果存在)
•对于小到中等规模的线性方程组可以非常高效
•通常只需要固定数量的运算就可以计算出解
缺点:
•对于大型线性方程组来说,可能会非常计算密集,特别是对于稠密矩阵来说
•舍入误差可能会累积,影响解的精度
•对于病态矩阵来说,无法处理得很好
间接法:
优点:
•可以高效地处理大型和稀疏的线性方程组
•如果矩阵病态或奇异,可能比直接法更精确
•可以轻松地并行化以利用多个处理器
缺点:
•可能需要更多的迭代才能收敛,这可能会非常计算密集
•对于某些矩阵或初始猜测,可能无法收敛
•收敛速度可能取决于矩阵的特性,对于某些矩阵可能会很慢
总的来说,选择直接法还是间接法取决于线性系统的特性、问题的规模以及所需的精度级别。在实践中,可以结合使用直接法和间接法来高效而精确地求解线性方程组。
嗯...的确是这么回事。
PS: 一般来说只要不是超大规模矩阵,大家平时采用基于矩阵分解的直接法就足够了。
参考文献
[1] O’Donoghue, B., Chu, E., Parikh, N., Boyd, S.: Conic optimization via operator splitting and homogeneous self-dual embedding. J. Optim. Theory Appl. 169(3), 1042–1068 (2016)
[2] B. Stellato, G. Banjac, P. Goulart, A. Bemporad, and S. Boyd, “OSQP: an operator splitting solver for
quadratic programs,” Mathematical Programming Computation, vol. 12, no. 4, pp. 637–672, 2020.
[3] S. J. Wright, Primal-Dual Interior-Point Methods. Society for Industrial and Applied Mathematics, 1997.
[4] https://docs.julialang.org/en/v1/stdlib/LinearAlgebra/#man-linalg-factorizations
[5] Vanderbei, R.: Symmetric quasi-definite matrices. SIAM J. Optim. 5(1), 100–113 (1995)
微信公众号后台回复
加群:加入全球华人OR|AI|DS社区硕博微信学术群
资料:免费获得大量运筹学相关学习资料
人才库:加入运筹精英人才库,获得独家职位推荐
电子书:免费获取平台小编独家创作的优化理论、运筹实践和数据科学电子书,持续更新中ing...
加入我们:加入「运筹OR帷幄」,参与内容创作平台运营
知识星球:加入「运筹OR帷幄」数据算法社区,免费参与每周「领读计划」、「行业inTalk」、「OR会客厅」等直播活动,与数百位签约大V进行在线交流
文章须知
关注我们
FOLLOW US
微信公众号后台回复
加群:加入全球华人OR|AI|DS社区硕博微信学术群
资料:免费获得大量运筹学相关学习资料
人才库:加入运筹精英人才库,获得独家职位推荐
电子书:免费获取平台小编独家创作的优化理论、运筹实践和数据科学电子书,持续更新中ing...
加入我们:加入「运筹OR帷幄」,参与内容创作平台运营
知识星球:加入「运筹OR帷幄」数据算法社区,免费参与每周「领读计划」、「行业inTalk」、「OR会客厅」等直播活动,与数百位签约大V进行在线交流
文章须知
作者:陈宇文,牛津大学在读博士生
责任编辑:翁欣
微信编辑:疑疑
文章由『运筹OR帷幄』原创发布
如需转载请在公众号后台获取转载须知
关注我们
FOLLOW US