ARTICLE · 1257720
AI搜索越来越多,答案却未必更准确:LongHarness让Agent追踪证据更正
多文档问答的失败不一定是没找到证据。agent可能已经读到正确数值、发现旧值有误,最后计算却仍沿用旧值;继续搜索还会把相关事实埋进更长的历史。LongHarness是一套不额外训练模型的运行框架(harness),试图把“文档说了什么”和“目前据此得出什么结论”分别维护,减少这种证据与结论脱节。
同一个agent管理两份显式状态:证据库(EvidenceBank)保存带来源的事实,结论状态(Conclusion State)保存已成立的判断、有依据的假设和仍缺的信息。缺口指导下一轮检索,新证据再用于修改判断。它没有把约一亿token的语料一次塞进模型,也没有丢弃交互历史;增加的是可持续引用、可更正的状态。
[图2:LongHarness概览] agent通过搜索和阅读访问外部文档,分别更新证据库与结论状态。证据更正后,需先观察入库结果,再在后续交互中修改相关结论;最终答案引用当前有效证据及其来源。
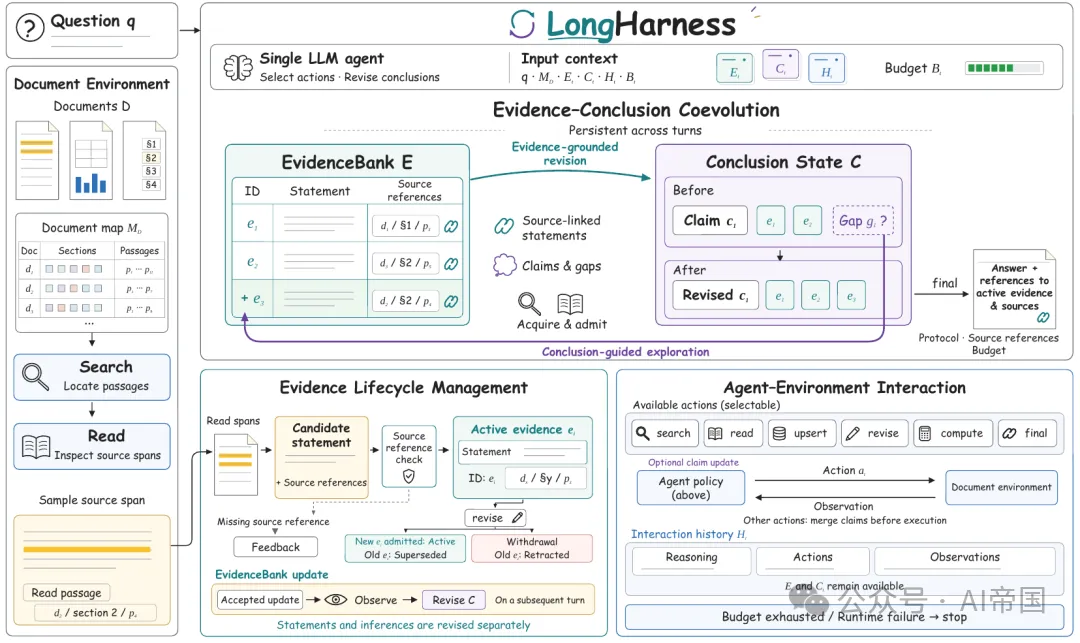
图2
证据更正生成新记录,相关结论仍要由agent主动修改
检索结果只用于定位,不能直接当成可引用证据。agent必须先读取原文、取得来源标识,再提交带来源的事实;入库成功后才可引用。修正事实会新建有效记录,将旧记录标为已替代;撤回则让旧记录失效而不新增替代项。旧版本仍留在修订记录里,但不能再作为计算和最终提交所声明的证据。
这套检查确保引用指向已读且有效的来源,不保证事实转述正确。控制器不会自动改写依赖旧证据的结论,也不验证计算式里的字面数值是否等于所引来源。agent仍须观察更正、更新推断和引用,并核对计算输入。把文档事实与判断分开保存,提供的是检查和修订路径,不能当成语义正确性的证明。
[图4:GLM-5.3-Flash在OfficeQA Pro V1上的证据生命周期比较] 80个月支出的几何平均案例中,Codex识别到4400这一更正,却仍返回使用4100得到的4958.09;LongHarness核对、修订后返回参考值4962.46,数值单位均为百万美元。该案例前者未过精确匹配,但误差约0.088%,仍在5%容差内;不同操作步数不能直接换算加速比。
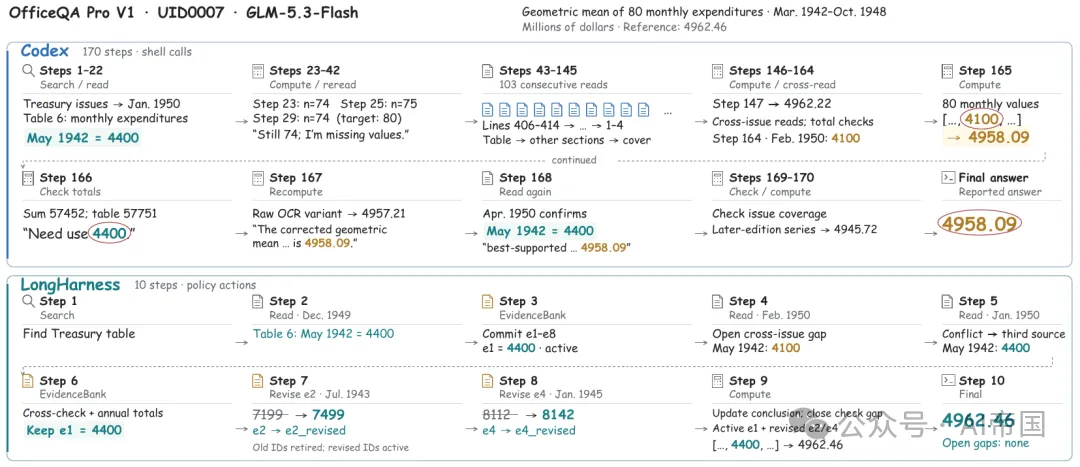
图4
GLM的V2优势为18.9个百分点,换Qwen后缩至1.1个百分点
OfficeQA Pro V1有133题、697份文档,语料约一亿token;V2有90题、1,435份文档,更强调跨来源统计。直接推理基线已用BM25检索相关段落到256K窗口,但不能交互追查。同为GLM-5.3-Flash,V2精确匹配从4.4%到LongHarness的61.1%;更接近的Codex对照为42.2%,差18.9个百分点。精确匹配要求数值和格式符合答案,不等同于5%容差成绩。
换成Qwen3.8-Flash,LongHarness在V2为51.1%,Codex为50.0%,差距仅1.1个百分点。主表每套配置只运行一次,不能将GLM上的幅度视作任意骨干的稳定收益;直接推理到61.1%的增量也包含多轮检索与工具交互,不能全部归给状态管理。各harness固定骨干、题目和语料,但工具接口与资源限制并不相同。
[表1:四项基准的主要结果(%)] OfficeQA Pro分别报告精确匹配与5%相对误差内准确率,另两项为AA-LCR及LongBench v2的Long子集。每项harness结果为单次运行;AA-LCR的直接模型分数来自公开评测,harness分数在本研究中另行评估。
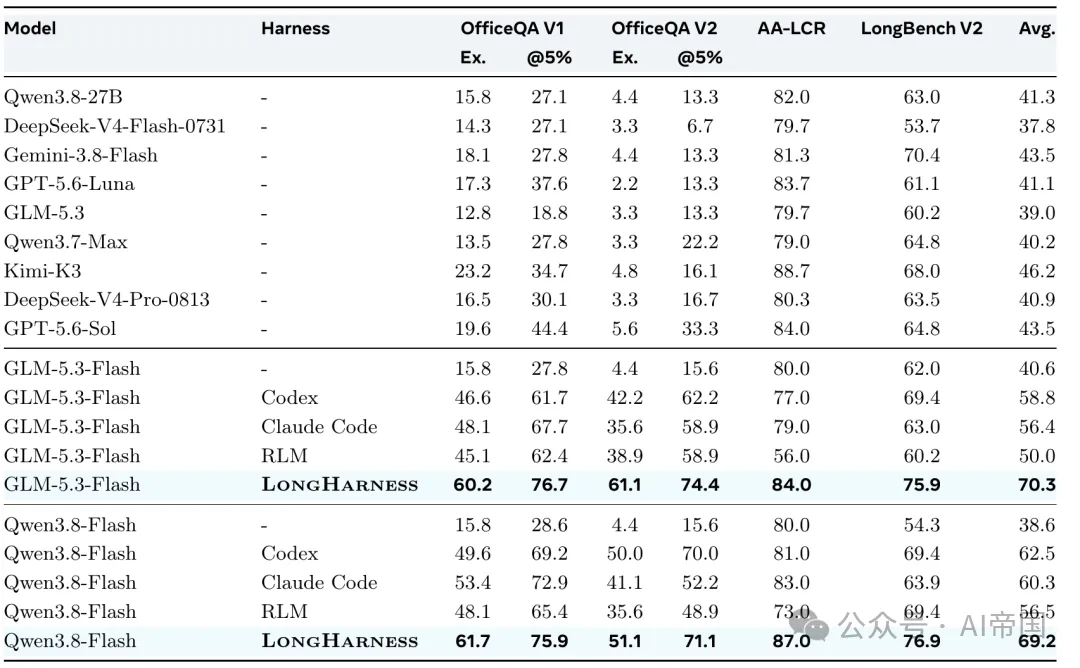
表1
只追加证据或改用普通笔记,V2结果均低于完整设计
更有针对性的证据来自组件消融。保留结论反馈、但只准追加证据而不修订撤回时,GLM的V2精确匹配从61.1%降到51.1%;保留证据库、移除结论状态及其检索反馈时为51.7%。将结构化结论改成可编辑普通笔记后为53.3%。这些对照支持“能更正事实”和“明确维护判断与缺口”的作用,收益并非仅来自多留一份笔记。
三次复跑则检验主结果有多大波动:GLM在V2的LongHarness均值为59.63%,样本标准差1.28个百分点;Codex为41.11%,标准差4.00个百分点。主表的61.1%不是三次均值。复跑仍支持该设置下的优势,但没有把所有骨干和消融重复验证,也不足以证明任何文档系统都会获得相同幅度。
[表2:GLM-5.3-Flash在OfficeQA Pro V1和V2上的消融结果] 五种变体分别改变持久状态、证据与结论联动、证据修订、结论缺口检索指令和笔记结构。下降量按舍入前结果计算;表中不是三次复跑均值,也不能将不同变体的下降量相加作为组件独立贡献。
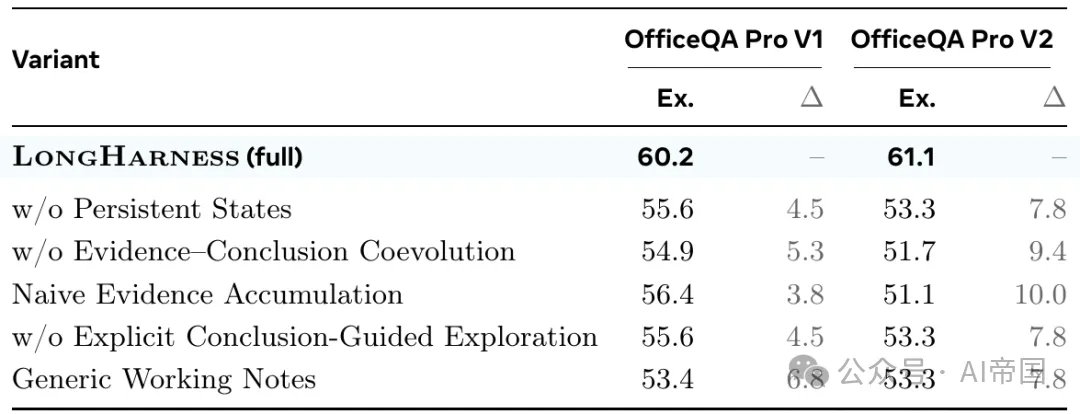
表2
交互轮数增长较少,但完整历史仍会占用上下文
GLM从V1换到V2时,LongHarness的模型轮数中位数从22增至30,Claude Code从21增至116,Codex从19增至43。明确保留已有事实和未决缺口,为减少重复找证据提供了合理解释;这仍是运行轨迹证据,不能直接推出token账单或耗时下降。不同框架每轮执行的操作、读入内容和推理量并不一致。
LongHarness上限为200轮、60次搜索,累计读取一百万token、单次最多16,384 token;Codex与Claude Code各限200轮及200次工具调用。累计读取预算不是单次上下文容量:LongHarness每次请求仍携带完整历史与当前状态,客户端不自动压缩或截断。上下文过长的请求若重试后仍失败,任务会终止并计错;显式证据库没有消除长历史的容量和成本约束。
[图3:GLM-5.3-Flash在OfficeQA Pro V1和V2上每题模型轮数的分布] 蓝色虚线与橙色实线分别对应V1、V2,圆圈为中位数。LongHarness两版分布变化较小;横轴是模型轮数,不是工具调用次数、耗时或费用。
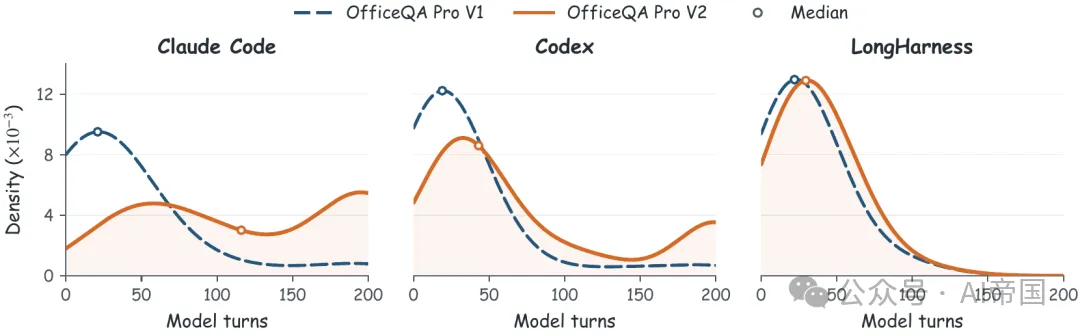
图3
LongHarness补足更正到结论的衔接,部署仍需事实与计算验收
LongHarness适合需要跨文档取数、反复核对版本并据此推理的问答流程。两套骨干的对照、组件消融和纠错案例共同支持:检索之外,还要持续维护哪些事实有效、哪些结论依赖它们,以及哪个缺口值得继续查。若现有agent经常已经发现更正却没有用于答案,可把证据版本和结论状态纳入对照实验,而不只增加搜索次数。
采用这套设计仍须验收事实转述、引用与结论是否相符,以及计算输入的数值、单位和精度。来源标识合法不能替代这些检查,更正也不会自动传播到全部推断。现有结果限于指定模型、题库和交互协议,没有给出统一实测费用或耗时优势;已有资料能放进上下文、问题无需追查时,也不能据此断言复杂的持久状态一定值得增加。
📄 原文标题
LongHarness: Advancing Agentic Reasoning over 100M-Token Corpora via Stateful Evidence Management
🔗 原文链接
https://arxiv.org/abs/2610.13075