ARTICLE · 1274073
【Kafka 源码手记】03 Kafka 架构总览
上一篇我们聊了 Kafka Log 的结构,结尾留了一个问题:单机的 Log 设计得再优秀,受制于单机存储容量上限,一台机器难以装下一个公司的活动数据,也无法做到高可用,一旦宕机,服务就会停止。所以 Kafka 必须把 Log 做成分布式的——那么问题就是,Log 应该怎么拆、怎么复制、怎么在机器故障后继续工作?
这一篇我们要回答的就是这个问题,但在回答之前,我们先把镜头拉远:不看具体每个部分的实现,而是看一下 Producer、Broker、Consumer、Topic、Partition 这几个天天挂在嘴边的词是怎么配合到一起工作的,看它们如何咬合成一条完整的链路。看完之后,这些问题的答案会自然浮现出来。
Producer、Broker、Consumer、Topic、Partition 这几个角色,如何协作成一条完整链路?
一条消息从发出到被消费,中间到底经历了哪几步?
每个角色各管什么、不管什么——智能放在哪一端?
一条消息的旅程:全系列的地图
这里我直接把答案给出来。假设 Topic orders 有 3 个 Partition、每个 Partition 3 个副本,一条带 Key 的消息从发出到被消费,要走完这样一段旅程:
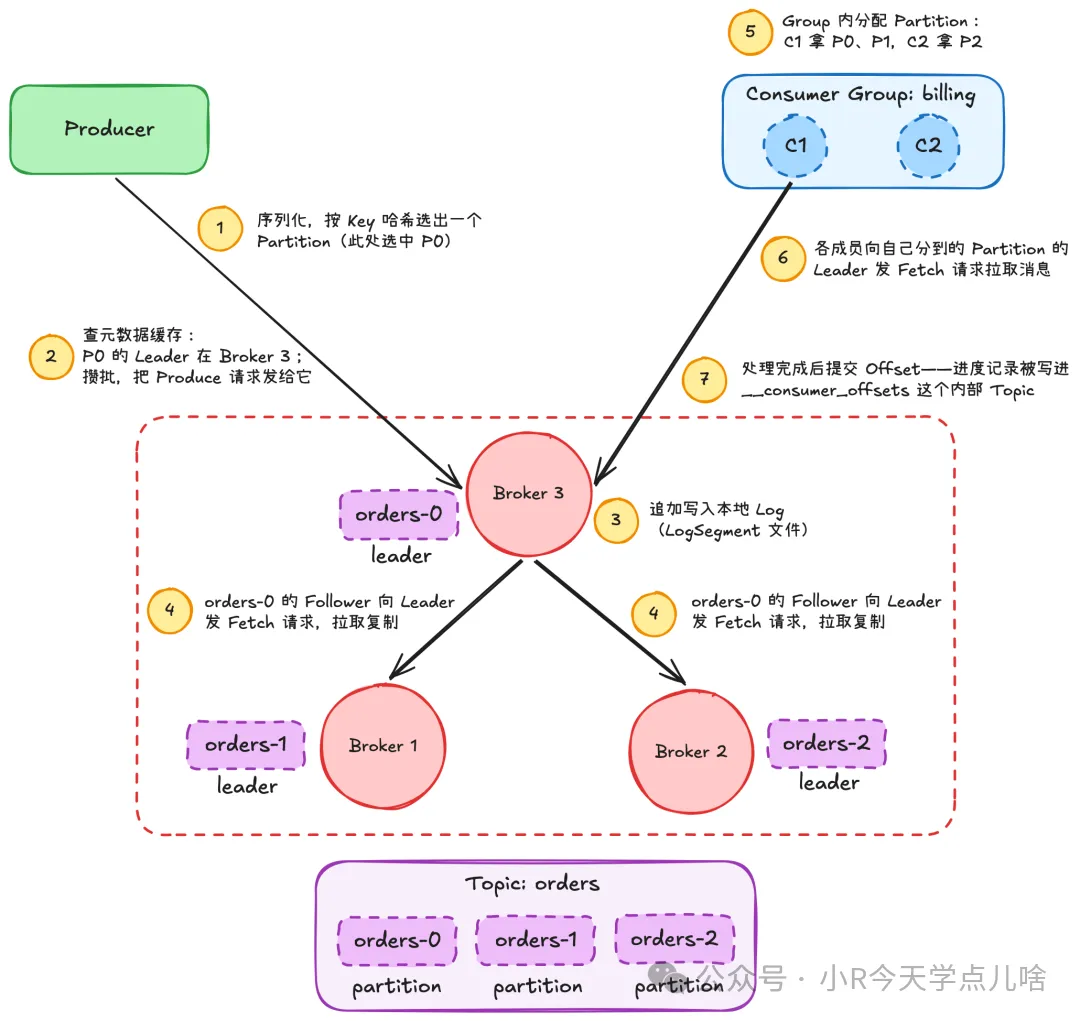
大体上可以分为七步。第 ② 步的「选 Partition」和第 ⑤ 步的「分配 Partition」是两回事:前者在 Producer 端决定消息去哪,后者在 Consumer 端决定谁来读哪,中间的 ③ ④ 两步只管把数据可靠地存住。
这张图就是整个系列的地图。后面每一篇,本质上都是在放大其中一格:③ 的写入路径和 LogSegment 管理在讨论存储引擎时会详细聊,④ 的复制与 Leader 选举则会在副本与高可用章节讨论,① ② 的攒批、路由、重试会在探讨 Producer 机制时深入研究,⑤ ⑥ ⑦ 的消费、Rebalance、Offset 提交则划分到 Consumer Group 部分。本篇只是给读者一个整体上的认识。
没怎么接触过 Kafka 的人对 Kafka 的印象可能是「一堆概念名词」,相信有了这张图,我们可以发现这些名词之间是有一条明确的因果链的:因为分区是数据分布的单位,所以路由要按分区来做;因为每条消息只属于一个 Partition,所以并行度就等于 Partition 数;因为副本以 Partition 为单位,所以容错也以 Partition 为单位。下面把这些逐个铺开。
角色分工:智能的客户端,简单的 Broker
从图中我们最先感受到的,是职责的分布方式:Kafka 把大量「智能」放在了客户端,Broker 反而相对简单。
先看 Producer。发消息之前,它要自己完成序列化、选 Partition、攒批三件事。选 Partition 的决策链在 clients/src/main/java/org/apache/kafka/clients/producer/KafkaProducer.java:1469 的 partition 方法里,逻辑是三级:
显式指定了 Partition 就直接用;
没指定、但配置了自定义 partitioner 就交给它;
否则走内置的分区逻辑——对有 Key 的消息调
BuiltInPartitioner.partitionForKey做哈希,没有 Key 就返回UNKNOWN_PARTITION交给攒批逻辑去定。
注意一个细节:BuiltInPartitioner 并不是 Partitioner 插件,类注释(BuiltInPartitioner.java:33-34)特意声明它只是个工具类、由攒批侧的 RecordAccumulator 直接调用——分区决策和攒批是缠在一起的,聊到 Producer 时会详细展开。「没有 Key 的消息去哪」不是随便扔的,4.x 的默认策略叫 adaptive sticky partitioning(BuiltInPartitioner.java:36 的类注释):先粘住一个 Partition 攒批,批满了或超时了再换下一个。也就是说,连「负载均衡」这件事都是客户端自己在做。
再看 Consumer。它是纯拉模式:自己发 Fetch 请求,自己处理消息,自己决定什么时候提交 Offset。读到哪了这件事,消费者心里有数,Broker 不替它记。
那 Broker 管什么?收到 Produce 请求就往对应 Partition 的 Leader 副本追加(ReplicaManager#appendRecords),收到 Fetch 请求就从 Log 里读(ReplicaManager#fetchMessages),再加上配合复制和协调。它不决定消息属于哪个分区——那是 Producer 定好的;不追踪每个消费者读到哪——那个进度本身也是消息,写在 __consumer_offsets 这个内部 Topic 里(对,协调状态也走 Log,上一篇的哲学贯彻得很彻底)。
有个细节让我停下来确认了一遍:Follower 副本的同步,走的也是 Fetch。也就是说 ④ 和 ⑥ 在 Broker 这一侧是同一条读路径,副本同步不过是「特殊的消费者」。这个设计的意味先记下,展开留到「副本与高可用」部分。
「智能客户端、哑 Broker」不是一句口号,而是一组可以逐条验证的分工:路由在客户端,进度在客户端(提交到 Topic),Broker 集中火力做存储和复制。为什么这样分?对比参照一节再回来谈。
Topic 与 Partition:逻辑名与物理目录
图里 orders 这个 Topic 被拆成了 orders-0、orders-1、orders-2 三个 Partition。这个拆分不是比喻,是物理事实:每个 Partition 的每个副本,落在哪台 Broker,就是那台机器上的一个目录,上一篇见过的 .log、.index、.timeindex 文件就躺在里面。Topic 只是个逻辑名字,它没有对应的物理实体——你找不到任何一个叫 orders 的目录或文件。
kafka-topics.sh --describe 的输出,本质上就是这张物理对应关系的一览表:Leader 列告诉你每个 Partition 的 Leader 副本在哪个 Broker 上,Replicas 列列出全部副本的位置,Isr 列是其中跟得上进度的那部分。动手实践一节会看到真实输出,这里先把对应关系讲清楚:
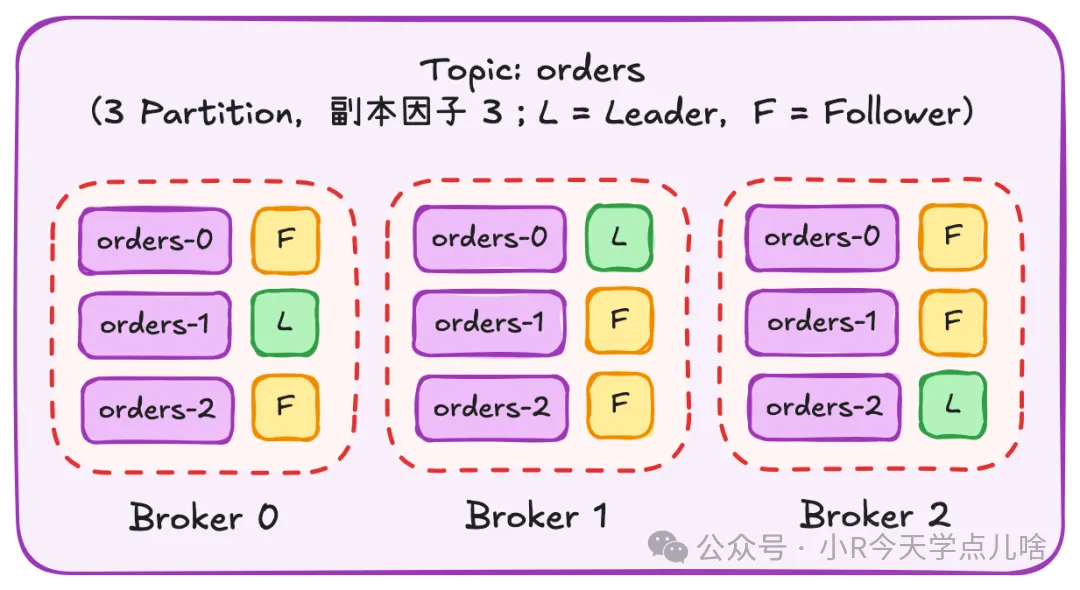
注意两点。
同一个 Partition 的多个副本一定分布在不同 Broker 上——都放一台机器上就没有容错可言了。
Leader 的分布是打散的(P0 在 Broker 3、P1 在 Broker 1、P2 在 Broker 2),这样读写压力不会堆在一台机器上;至于怎么打散、谁来定,属于「副本与高可用」部分的话题。
顺带一提,4.x 的 --describe 输出比老版本多了 Elr 和 LastKnownElr 两列(对应 TopicPartitionInfo.java:44-45 里的 eligible leader replicas 概念,KIP-966 引入),本篇实验里它们是空的,知道有这回事即可,容错细节同样在后面再讨论。
Broker 内部:一次请求路过的地方
下面把 Broker 这个盒子打开一条缝。打开的方式很直接:看 Broker 进程是怎么被装配起来的——core/src/main/scala/kafka/server/BrokerServer.scala 的 startup 把所有部件 new 出来并串在一起。
我们以一条 Produce 请求的视角走一遍:
网络层的
SocketServer(BrokerServer.scala:274 装配)负责接连接、读字节;请求进队列,由一组KafkaRequestHandlerIO 线程(:480 装配,类在 KafkaRequestHandler.scala:88,线程循环里receiveRequest取请求)消费;线程把请求交给协议入口
KafkaApis(:455 装配),它按请求类型分发——Produce 走handleProduceRequest(KafkaApis.scala:396),Fetch 走handleFetchRequest(:563),Offset 提交走handleOffsetCommitRequest(:273),入组走handleJoinGroupRequest(:1376);Produce 最终落到
ReplicaManager(:347 装配)的appendRecords(ReplicaManager.scala:637),再交给LogManager管理的本地 Log——也就是上一篇拆解过的那套LogSegment文件。
其余部件也做一个简单的介绍:
ReplicaManager管所有本机副本的读写与复制状态;LogManager管所有本盘 Partition 目录的生命周期(core 里只剩这一个 Scala 存储文件,存储主体已 Java 化,「存储引擎」部分会展开);GroupCoordinatorService(GroupCoordinator接口的实现,BrokerServer.scala:672 装配)管消费者组的成员关系与 Offset,TransactionCoordinator管事务,各自细节都在「Consumer Group」部分展开;还有
KRaftMetadataCache(:209)缓存本 Broker 看到的元数据视图。
翻 Partition.scala 的时候有个小发现:老资料里的 Replica 类在 4.x 已经不存在了,副本状态并进了 Partition.scala:163 的 Partition 类——八股文还在问 Replica,而源码已经把它删了。
这些名字本篇全部到此为止,具体的展开都留待后面的文章。鸟瞰的意义在于:以后任何一篇钻进某个组件时,你能够知道它在整个架构图上的哪个位置。
客户端与 Broker 怎么说话
之前那张架构图里的第 ② 步有个环节我没细说:Producer 怎么知道 P0 的 Leader 在 Broker 3 的?我们可以分两层来看这个问题,篇幅有限,本篇我们只说到第一层。
第一层是协议。Client 与 Broker 之间跑的是 Kafka 自己定义的二进制协议,直接架在 TCP 上:请求头里带 API key 和 API 版本号,Broker 按版本回应,新旧客户端与新老 Broker 可以混搭。这套协议的细节(都有哪些 API、版本怎么协商)是「连接与请求处理」部分的主题。
第二层是元数据。客户端维护着一份元数据缓存(clients/src/main/java/org/apache/kafka/clients/Metadata.java:67),里面是「每个 Partition 的 Leader 在哪个 Broker」这样的映射;它需要拉取和刷新,也会过期出错。注意一个容易被忽视的事实:bootstrap.servers 只是入口门牌,客户端连上任意一个 Broker 拉到元数据之后,后续是直连各 Broker 的。这套寻址模型的完整故事,正是下一篇的内容——所以这里点到为止。
元数据归谁管:KRaft 一句话
还有一个角色图里没画:Controller。它管的是集群的元数据——Topic 有哪些、Partition 的副本放在哪、谁是 Leader,这些「数据的数据」总得有个权威。
4.x 的答案叫 KRaft:元数据由 Controller 组成的 Quorum 仲裁,实现就是 metadata/src/main/java/org/apache/kafka/controller/QuorumController.java:175 的 QuorumController 类。最妙的一点是存储形式:元数据的变更本身被写进一条 Raft 复制的 Log,即内部 Topic __cluster_metadata(固定 partition 0,见 Topic.java:30-31);每个 Broker 通过 KafkaRaftManager 订阅这条 Log、用 MetadataLoader 把变更加载进本地的 MetadataCache(装配点在 SharedServer.scala:291 和 :324)。换句话说,元数据的存储也 Everything Is A Log——上一篇的哲学连控制面一起收编了。Broker 之间对元数据的最终一致,就转化成了「大家消费同一条 Log 到相同位置」的问题。
部署 KRaft 集群时你会遇到两种配法——静态的 controller.quorum.voters 把 Voter 地址逐个写死(本篇实验用的就是这种),动态的 controller.quorum.bootstrap.servers 让 Quorum 自行形成(KIP-853),QuorumConfig.java:58 起的注释写明前者是旧式配法、与动态配法互斥。KRaft 的内部机制(Raft 怎么选主、snapshot 怎么打)是后面单独文章的主题;它取代掉的 ZooKeeper 模式,留到「从 Zookeeper 到 KRaft」部分作历史叙述。本篇只需要一句话:元数据也有一条 Log,Broker 是它的消费者。
这个系列接下来怎么走
地图有了,这一系列我会按照「沿消息的生命周期推进」这一路线完成。先看数据落地的样子(存储引擎:LogSegment、索引、retention 都在 02 篇埋了钩子),再看它如何被复制和保护(副本与高可用),然后回到发送端(Producer 的攒批、路由、幂等、事务)和消费端(Consumer Group 的分配、Rebalance、Offset)。可靠性和顺序保证是两个横切专题,分别在单独的篇章中回过头来把前面的线索收拢。
动手实践:搭一个三节点集群
这篇的实验会比前两篇的要”重“:这篇文章中涉及到了「分布」这件事,单容器无法实现。所以我们用 Docker 起一个 3 Broker 的 KRaft 集群(每节点 process.roles=broker,controller,即混合模式),完整可复现脚本我会贴到文末的附录,环境变量的骨架照着官方的 docker/examples/docker-compose-files/cluster/combined/plaintext/docker-compose.yml 抄,只是把 compose 换成了裸 docker run;跟官方的差异交代清楚:副本因子相关的值按三节点做了调整(offsets 与事务 Topic 的 RF 从 1 改成 3、事务 min.isr 改成 2),share-coordinator 相关两行与实验无关没抄,组重平衡初始延迟清了零,并显式关掉自动建 Topic(KAFKA_AUTO_CREATE_TOPICS_ENABLE=false,让每个 Topic 都从明面上的命令出生)。官方 compose 里那行 KAFKA_LOG_DIRS 我也没抄——当时没多想,这个疏忽的后果要到「看物理目录」一节才显形。先起集群:
管理命令统一从容器内执行,走 --bootstrap-server kafka-1:19092。先确认控制面活着:
(CurrentVoters 原本是一整行 JSON,为了排版折成了三行,内容原样。)三个 Voter,Controller Quorum 完整——这次 Raft 选出了 3 号当 Leader,选主机制本身是第 52 篇的事。建 Topic,然后立刻看那张「物理对应一览表」:
和我上面画的分布图完全一致:Leader 打散在三个节点上,Isr 暂时就是 Replicas 的全部(刚创建,都跟得上)。Replicas 的顺序也不是随便排的,第一位就是所谓的优先副本。Elr / LastKnownElr 两列空着,如前所述,KIP-966 的新概念,此处不管。至于 Configs 里的 min.insync.replicas=1:不是我设的,建 Topic 命令里没有任何 --config。用 kafka-configs.sh --describe --all 查这个 Broker,会发现这条配置的来源标着 DYNAMIC_DEFAULT_BROKER_CONFIG——集群级的动态默认值,而且是 Controller 写进元数据 Log 的:ELR 启用时(就是上面 Elr 两列),首次激活的 Controller 会补写一条集群级 min.insync.replicas 配置,值取静态默认的 1(ActivationRecordsGenerator.java:97-104,调用点 QuorumController.java:1166-1171)。所以照上面的步骤复现,这行输出会一模一样。输出里两个看不懂的地方——Elr 空列和这条多出来的 Config——原来竟是同一个 KIP 的故事。「配置有来源之分」这件事,后面讲 min.insync.replicas 与 ISR 的关系时还会聊到。
接着验证旅程的第 ① 步:同 Key 恒同 Partition。发 6 条带 Key 的消息(alice 三条、bob 两条、carol 一条),消费时把 Partition 打出来:
alice 的三条全在 Partition 0,carol 的一条在 Partition 2——同 Key 恒同 Partition,哈希路由亲眼可验。(alice 和 bob 恰好都哈希到 0,只有几个 Key 时撞上是正常的,不代表有 Key 也乱跑。)
还有个顺带的收获:消费顺序是 carol 打头。我把 alice:10 先于 carol:30 发出去,但两条走了不同的 Partition,谁先被消费到取决于各自的 Fetch 时机——Partition 之间不存在全局顺序,顺序只在 Partition 内部成立。后面的「顺序保证」专题我们再回过头来讨论。
然后看物理目录——前面漏抄 KAFKA_LOG_DIRS 的后果在这里显形了。我按 02 篇的肌肉记忆直奔 /tmp/kraft-combined-logs,扑空;进容器在渲染出的 /opt/kafka/config/server.properties 里 grep log.dirs,仍旧一无所获。回头读镜像的渲染代码才想明白:02 篇的单容器是零环境变量裸起,走镜像内置模板 /etc/kafka/docker/server.properties(log.dirs=/tmp/kraft-combined-logs 就写在那里面);这次为了让三节点互相认识设了一堆 KAFKA_ 变量,而渲染逻辑是「只要环境变量产出任何配置行,内置模板就被整体绕过」(KafkaDockerWrapper.scala:146-154)。我没设 KAFKA_LOG_DIRS,渲染结果里自然没有 log.dirs,于是落到 Kafka 的原生默认值 /tmp/kafka-logs。同一个镜像、两次实验、两个数据目录,差别不在镜像,在配置的来源。
(我手动重排过版面,条目是原样的。)三台机器目录结构一模一样:orders-0/1/2 全在(副本因子等于节点数,每台都持有全部分区),__consumer_offsets 50 个分区目录也全在,外加 __cluster_metadata-0 和几个目录级的 checkpoint 与 meta.properties(先不展开)。三台的差别不在「有哪些目录」,在「谁是 Leader」——这正是本节想确认的认知:目录是副本,Leader 是身份。
顺便看看 __cluster_metadata-0:.log、.index、.timeindex、leader-epoch-checkpoint、partition.metadata,外加一个 quorum-state——和普通 Topic 同构的 segment 文件。元数据真的是一条 Log,前面「元数据归谁管」一节的论断在磁盘上坐实了。
最后对比同一个 Partition 的 Leader 与 Follower 侧。本轮 orders-0 的 Leader 在 kafka-3,kafka-1 是 Follower 之一(每轮创建 Topic 时副本怎么摆会有轮换,所以下面的命令对任意两台都成立):
(两台的输出逐项一致,日期时间戳略去。)同一个 Partition,Leader 与 Follower 侧文件完全同构,.log 都是 186 字节。Follower 侧的数据不是「另一个格式」,就是同一份 Log 的复制。
收尾前加一场故障演练,检验「怎么容错」。kafka-2 此刻担任 orders-2 的 Leader,把它停掉:
三个变化:
P2 的 Leader 从 2 换成了 3;
三行的
Isr都把 2 踢了出去;而
Replicas列原样不动——副本放置计划没变,变的只是谁当 Leader。
这期间再发一条 alice:{"amount":99}、再消费一次,一切照常(它仍落在 Partition 0)。重启 kafka-2,十来秒后:
Isr 恢复成三成员,但 P2 的 Leader 停在 3 不动——它没有立刻迁回「原本该在」的 2。为什么不迁、什么时候迁、Isr 的进出依据是什么,都是「副本与高可用」部分的正题,这里先记下现象。
再补一个验证:此刻三台机器上 orders-0 的 .log 全部是 272 字节——比刚才多了 86 字节,正是故障期间写进去、之后又被重启节点追平的那条 alice:99。复制在正常时无感,出事时也不掉链子。
对比参照:智能放在哪一端
拿「智能放在哪一端」这把尺子去量 RabbitMQ 和 Kafka,两条路线立刻分开。
RabbitMQ 把智能放在 Broker。客户端只要把消息交给 Exchange,路由规则(binding、routing key 的匹配)在 Broker 端解释执行,消息进了哪条 Queue、什么时候投给哪个消费者、没确认怎么重投——全部状态和决策都在服务端。客户端因此很简单:连上去、publish、收下就确认。
Kafka 把智能放在客户端。路由规则退化成一句哈希,于是可以整个下放给 Producer;消费进度下放给 Consumer 自己提交;Broker 端既不解释路由,也不维护每个消息的投递状态,剩下的事就是追加写、复制、按 Offset 读。
但与其说谁更聪明,不如说约束不同。RabbitMQ 的约束是路由表达力与队列语义:routing key 要支持模式匹配这类灵活规则,匹配天然得在中心做;队列语义是「取走即删、逐消费者投递确认」,Broker 必须替每条在途消息记账。这两件事放不进客户端,所以智能只能堆在服务端,代价是 Broker 的复杂度和中心化压力。Kafka 的约束是存储吞吐:目标是把每秒百万级事件顺序落盘,Broker 端每多一个逐条决策就多一分瓶颈,所以规则被预先简化——分区先切好、路由就一句哈希、读取只认 Offset——简单到客户端完全可以自己执行。智能下放换来的,是 Broker 可以做得极简、极快、极好扩展。
同一个问题(消息从 A 到 B),两种约束,两种放法。判断一个消息系统(或者任何分布式系统)的行为特征时,「智能在哪一端」比功能清单有用得多。
工程启示
用好 Kafka:把客户端当作生产系统的一半来对待。 这一篇最该带走的运维直觉是:Kafka 的客户端不是简单的驱动,它承担着元数据缓存、分区路由、攒批、重试这些实打实的职责。推论有三条。排查问题先看客户端:消息「为什么去了那个分区」「为什么延迟高」「为什么重复」,答案多半在客户端版本和参数里(partitioner 的选择、batch.size 与 linger.ms 的配比),不在 Broker。客户端版本要当作依赖严管:路由策略、元数据刷新行为随版本演进(比如上面提到的 adaptive sticky partitioning 就是后来才有的默认行为),混版本客户端的行为可能不一致。客户端占用的资源要计入容量:它常驻线程、缓存、连接,不是零成本。
设计借鉴:以固定并行度单元做横向扩展。 Kafka 的高吞吐、可扩展、可容错,最终都收敛到同一个原语——Partition。它是并行度的单位(Consumer 最多和 Partition 一样多)、扩展的单位(Partition 摊到多台机器)、容错的单位(副本、Leader 选举都以 Partition 为粒度)。这个模式的可迁移性极强:分库分表里的分片、一致性哈希里的虚拟节点、Flink 的并行 subtask、Iceberg 的 partition,骨子里都是同一件事——把大问题预切成固定数量的单元,单元再映射到机器;并行度在切分时就定了,扩容扩的是机器对单元的承载,而不是单元本身。代价也一致:单元数一旦定低,事后就发现改不动了——Kafka 加 Partition 会打乱 Key 的路由,别的系统多半也有各自的连锁反应——用这套模式前,先想清楚并行度上限。
小结
这一篇把 02 篇结尾的分布式之问推进了一步:拆,是按 Partition 切,一个 Partition 一个目录;复制,是 Follower 向 Leader 发 Fetch 拉取,同一条读路径顺便服务了消费者;容错,是 Leader 挂掉后由 ISR 中的副本接替,Replicas 不变、Leader 换人。Producer、Broker、Consumer 的分工也明确了:智能在客户端,Broker 专注存储与复制;连元数据和消费进度,都被收编成了 Log(__cluster_metadata、__consumer_offsets)。全系列的地图画完,后面的每一篇都是放大其中一格。
但图里还有一个环节我们没讲完:第 ② 步 Producer「查元数据缓存」查到的那些 Leader 位置,最初是从哪来的、怎么保持新鲜?bootstrap.servers 明明只写了一个地址,客户端怎么找齐了整个集群?下一篇从这扇门进去。
下一篇:客户端如何找到 Broker。
附录
Kafka 源码手记
跟着源码,把 Kafka 一次讲透
长按识别 · 一起读源码