ARTICLE · 1285801
RAG 全流程拆给你看:从一份文档到一句答案
一、先说清楚为什么需要 RAG
第一是知识滞后。LLM 参数海量,预训练和微调要花相当的物力与时间,商用模型还得过安全测试与风险评估,所以它的知识永远停在某个时间点。
第二是知识缺失。在专有领域,它学不到所有专业细节,面对专业提问时给不出可靠回答。
第三是幻觉。生成时「胡言乱语」,表现为错误陈述、编造事实、复杂推理出错,或者在复杂语境下理解不了。成因有四个:
▪︎ 训练知识本身有偏差,错误信息被学进去又在输出里复现
▪︎ 训练时过度泛化,把普通模式套到特定场合
▪︎ 没真正学到数据深层含义,需要深入理解的任务就出错
▪︎ 缺乏某些领域知识,碰上就编造不存在的信息
在金融和医疗领域,这个代价会被放大:一次金额评估错误、一次诊断失误,哪怕只出现一次都是致命的,而且非专业人士很难识别。目前还没有能百分之百解决这种情况的方案。
二、RAG 是什么,值不值得用
RAG(Retrieval-Augmented Generation,检索增强生成)的基本思想,是把生成式大模型和实时信息检索结合起来,给它补充来自外部的相关数据和上下文,让生成内容可以依赖实时、个性化的知识,而不是只吃训练数据。
说白了,相当于在它回答时给一本参考书。
它的适用边界很清楚:当需求集中在用大模型回答特定私有领域的知识,且知识库足够大时,除了微调,RAG 就是最有效的那条路。
优点很具体:比提示词工程有更丰富的上下文和数据样本,不用用户交代太多背景就能给到预期答案;比模型微调更能保证时效性和可靠性;还能在一定程度上保护业务数据隐私。
代价也得认:每次问答都涉及外部系统检索,响应时延相对更高;引用的外部知识会消耗大量 Token。
三、两条流水线:一条离线,一条在线
典型 RAG 分两个阶段。索引阶段先离线建好:从各种数据源加载数据 → 把文档切成小块 → 对文本块做嵌入 → 存储向量。检索生成阶段每次提问都走一遍:根据用户输入检索相关文本块 → 大模型拿着包含问题和检索结果的提示生成回答。
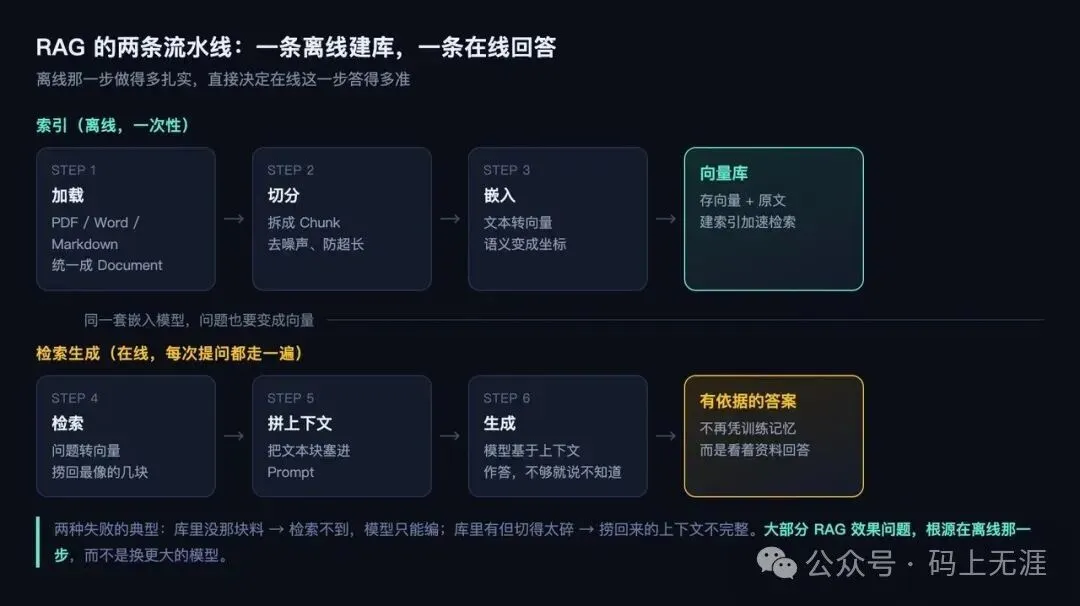
下面按这六步逐个走,每一步都给能直接跑的代码。
四、加载:先把各种文件变成 Document
数据源格式很杂,文本、Markdown、PDF、Word 都有。LangChain 集成了大量文档加载器,且它们都实现了 BaseLoader 接口,提供 load(一次全部加载)和 lazy_load(延迟加载)两个方法,产物统一是 Document 对象。
Document 只有三个属性:page_content 是文本内容,metadata 是元数据字典(来源、页码等),id 是可选标识。后面所有环节都围着它转。
Markdown 是半结构化的,用特定语法标出了标题、段落、列表。Unstructured 的解析流程是:先按 Markdown 结构切,标题会被切成单独的 element;同一标题下的文本再按段落(\n)切成多个 element。
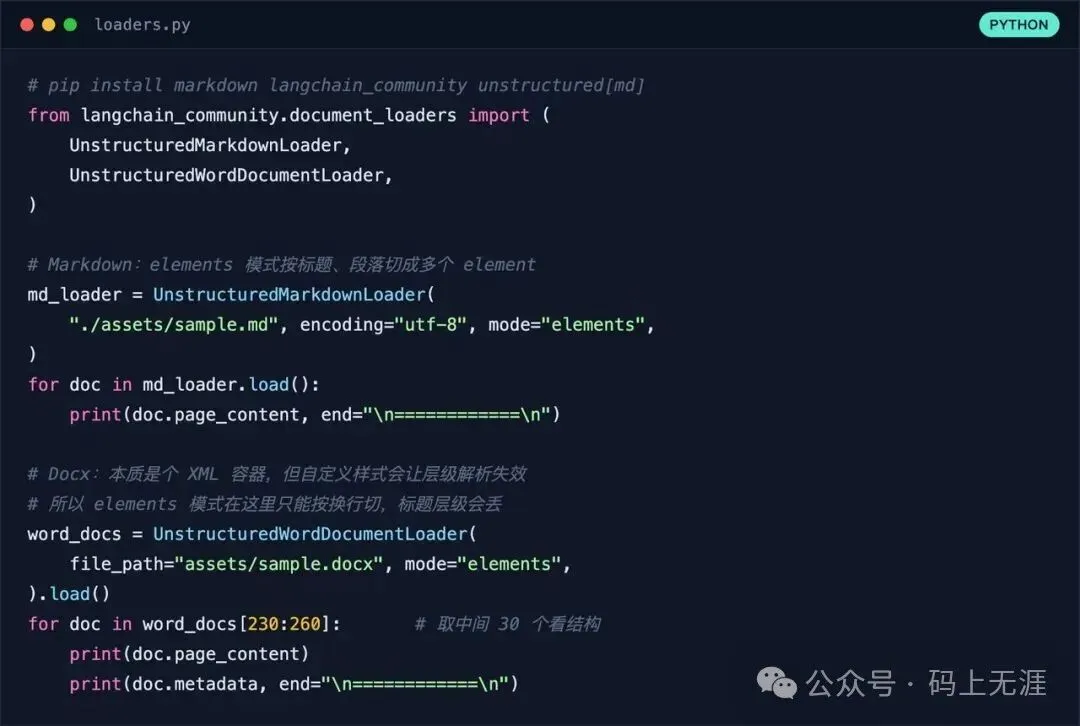
Docx 麻烦在另一处:它本质上是 XML 容器,标签严格规定了层级,但 Word 允许你自定义标题样式——往往只是正文样式加了些手动格式,解析库无法按统一标准识别。所以 Unstructured 对 docx 只能按换行切,标题层级会丢。标题敏感的文档得换工具。
PDF 最难:扫描版、电子文本版、混合版,单列双列甚至竖排,还夹着表格、公式、页眉页脚。这里推荐 MinerU——开源,把 PDF 转成 Markdown / JSON,可配 VLM 模型(MinerU2.5 在多项基准测试里达到 SOTA),支持本地 Docker 部署,也能调官方 API。
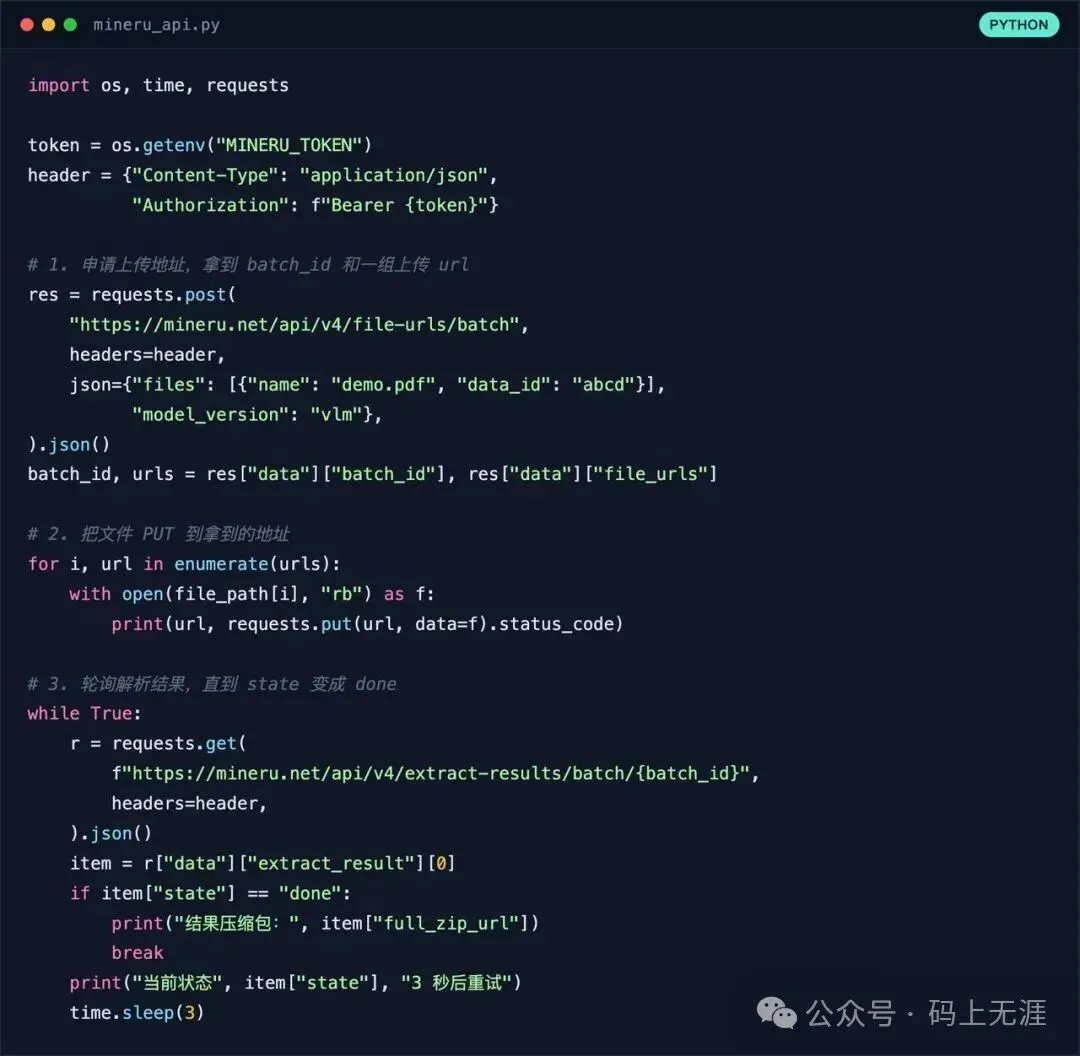
解析完会拿到一个 Markdown 文件,再交给 Markdown 解析器继续走下一步——这是最省事的接法。
五、为什么必须切分
第一个原因是噪声。如果答案就在某个 Document 里,把整篇塞进 Prompt 并不是好选择——里面大量无关信息会干扰生成。有研究发现,模型虽然能处理长文本,但在利用长上下文方面存在明显不足:当关键信息位于中间时,性能会显著下降。
第二个原因是长度。Document 太大,输入时会被截断,信息直接缺失。
所以答案是把文档切成 Chunk,存储和检索都以块为基本单位。三种切分策略各有取舍:
▪︎ 按固定字符数或 Token 数切:简单,但可能从句子中间切断
▪︎ 递归多分隔符切:尽量不超长度限制,同时保住完整句子
▪︎ 语义切分:比较相邻句组嵌入向量的距离,在语义变化处切;语义保持好,但慢,且块长可能极不均衡
工程上最常用的是第二种的现成实现:RecursiveCharacterTextSplitter。它拿一个分隔符列表(默认 [\"\\n\\n\", \"\\n\", \" \", \"\"])按顺序试,直到块足够小,从而尽可能把段落、句子、词保持在一起。
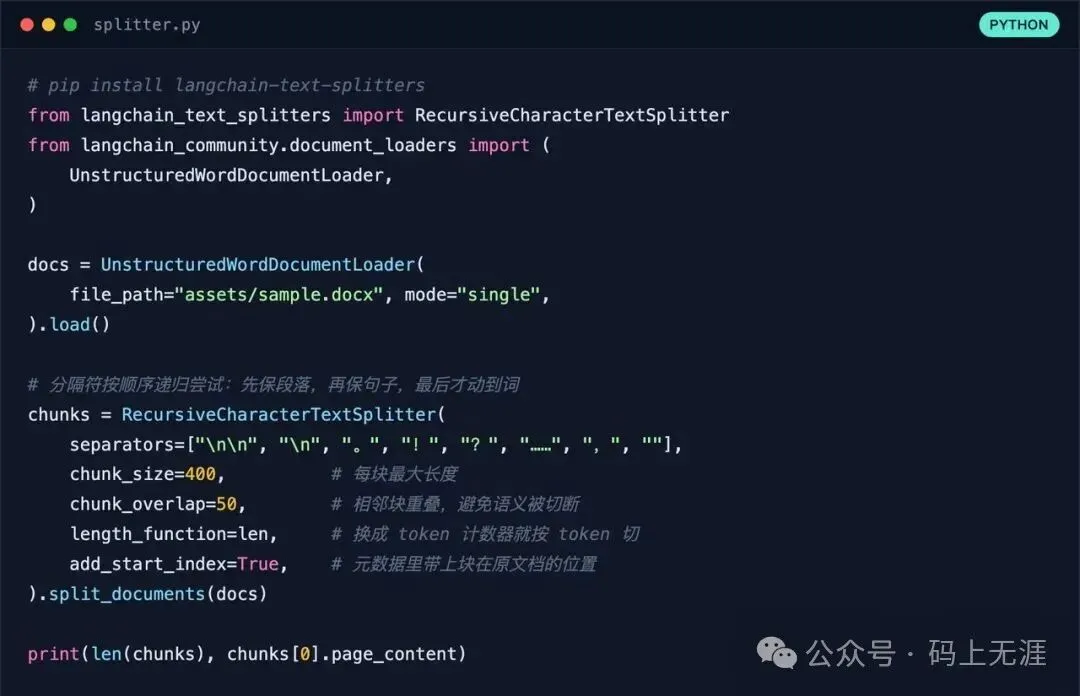
两个参数值得调:chunk_overlap 让相邻块有重叠,跨块的语义不会断;add_start_index 把块在原文档的起始位置写进元数据,后面要标引用时很有用。
六、嵌入:把语义变成坐标
块切好了,接下来要把它变成向量,才能在检索时和查询做相似度计算。2018 年谷歌的 BERT 已经能把文本嵌入成向量,但它并不是为句子嵌入优化的;Sentence-BERT 调整了架构和预训练任务,产出的句子向量可以直接用余弦相似度比较,算相似句子的开销大大降低。
LangChain 用一个 Embeddings 抽象类统一了接口,核心就两个方法:embed_documents 批量转文档,embed_query 转单条查询。具体实现有 HuggingFaceEmbeddings、OpenAIEmbeddings 等。
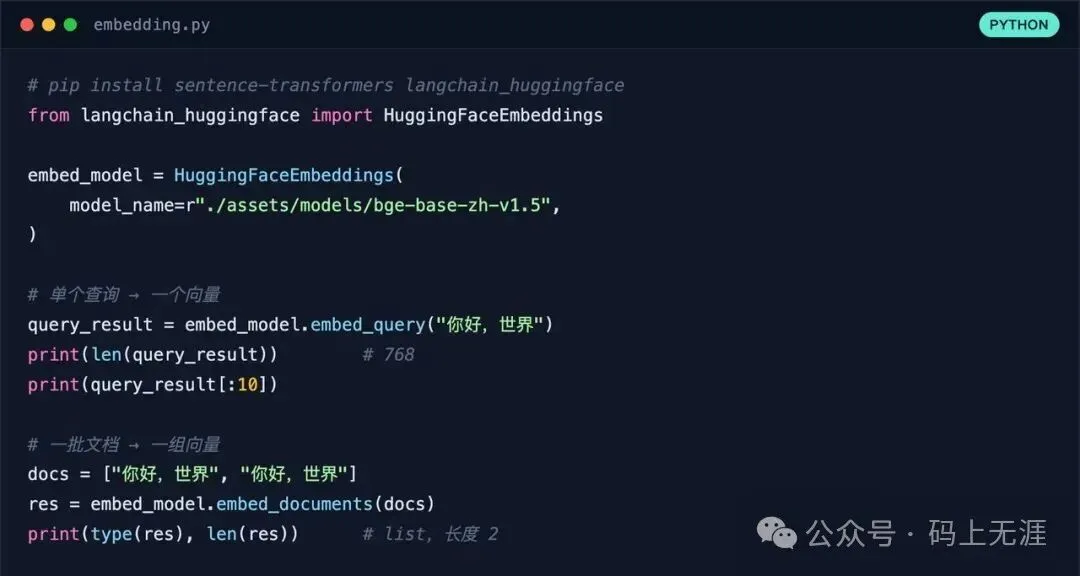
这里有个隐形陷阱:建库时用 embed_documents,查询时用 embed_query,两次必须是同一个模型。换了模型,向量空间就对不上,检索出来的东西全部是错的,而且不会报错。
七、进库:为什么 MySQL 不够用
还是摄影师那个例子。用 MySQL 存拍摄时间、地点、相机型号特别顺手,但你要搜「海边那张」「暖色调那张」,就没有字段可查了——「像不像」用一个等号表达不了。
向量库换了个思路:把每张照片的特征表示成多维空间里的一个点,点与原点相连就是一条向量,检索就从精确匹配变成了算距离。注意它返回的不是唯一匹配,而是最相似的一批,本身带模糊性。
这篇用 Milvus。它的数据组织是「数据库—Collection—实体」三层,Collection 相当于二维表,用 Schema 定义字段、类型和索引:一个主键、最多四个向量字段、若干标量字段。
向量字段分两类。稠密向量通常由 Transformer Encoder 架构的模型(如 Sentence-BERT)生成;稀疏向量表示关键词及其权重,从早期 TF-IDF 词袋演进到用深度学习模型加权。下面用 BGE-M3 跑一遍,它一次编码同时给出两种表示:
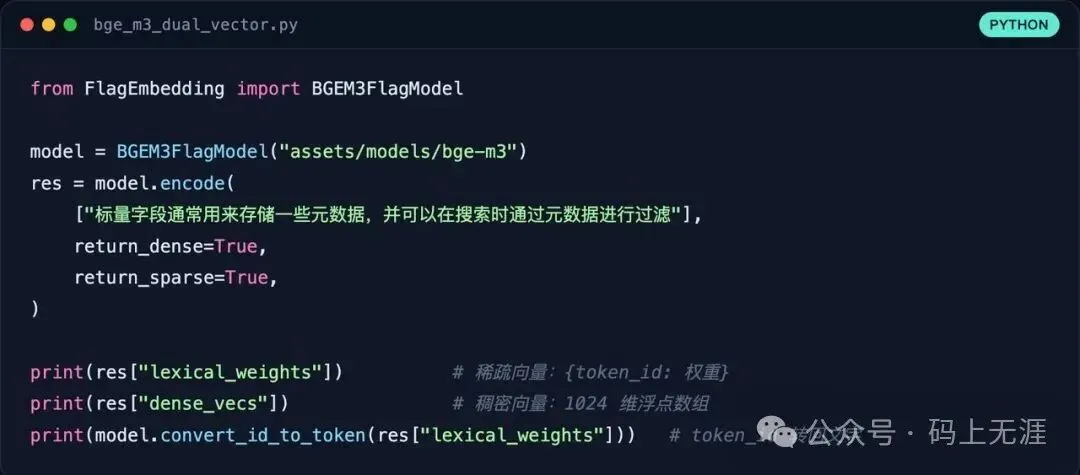
索引方面:稠密向量用 HNSW,多层图结构,上层粗筛下层细化,精度高延迟低,代价是内存;也可以选 FLAT,暴力搜索,100% 召回但慢。稀疏向量用 SPARSE_INVERTED_INDEX,也就是倒排索引,先找出包含 query token 的文档再算分,打分可以用 IP(内积)或 BM25。建库的代码长这样:
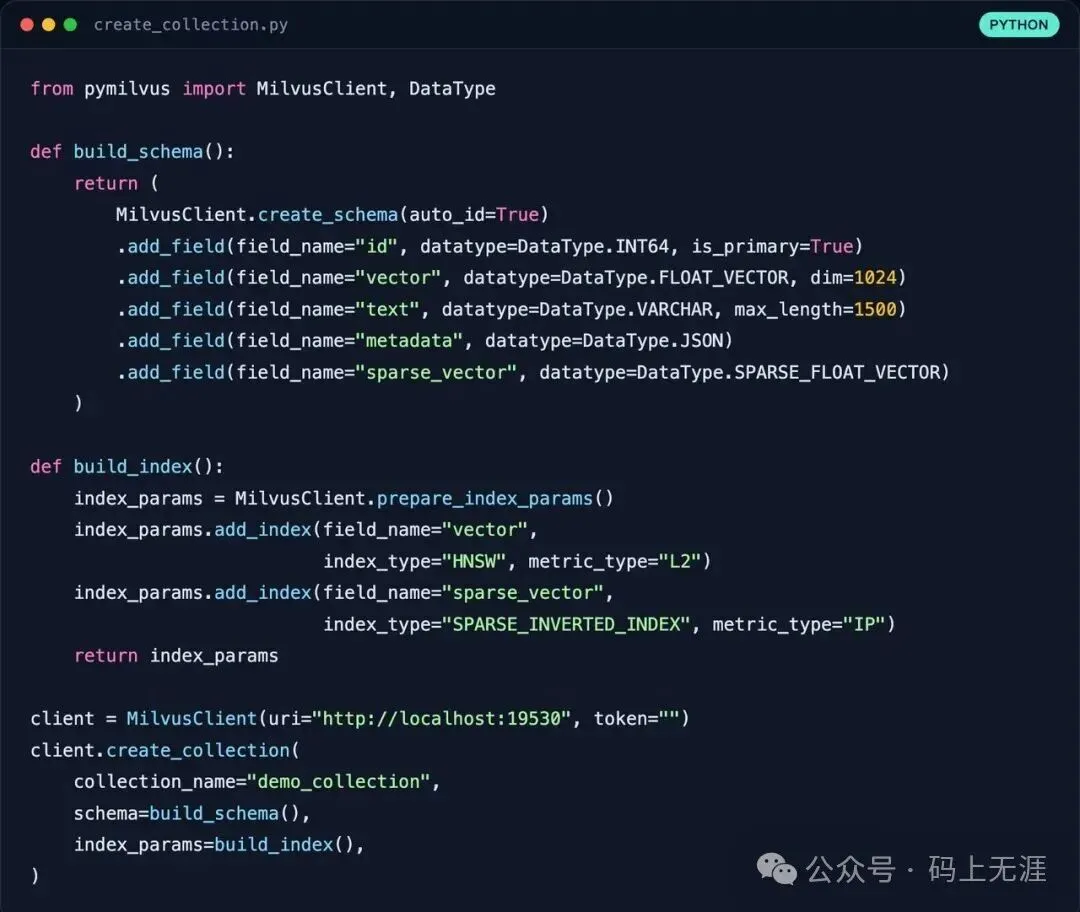
部署有三种:Lite 用 pip 装完就能跑,但只支持 FLAT 索引,且只能在 macOS / Linux 上用;Standalone 是 Docker 单点部署;Distributed 跑在 Kubernetes 上。演示用 Standalone,两步就起来:
▪︎ docker load -i milvus_image.tar # 先加载镜像
▪︎ bash standalone_embed.sh start # Linux 启动
▪︎ standalone.bat start # Windows(Docker Desktop)
起来之后用官方图形客户端 Attu 连 http://localhost:19530,选 token 直接连。调试阶段有个可视化的库,比对着代码猜字段写没写对省事太多。
八、写入与删除
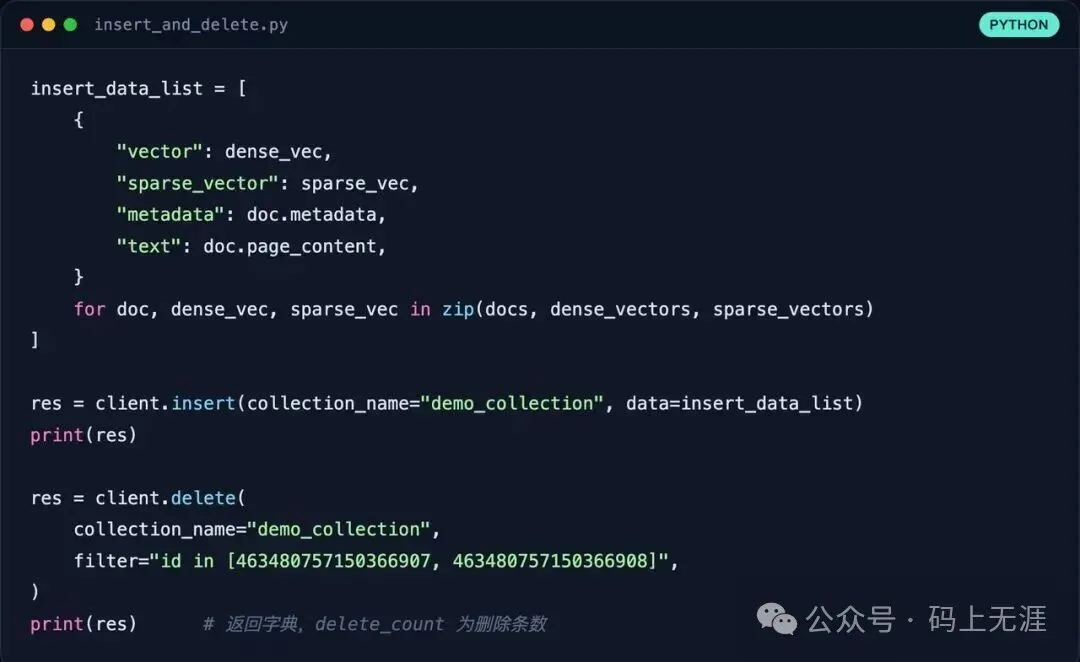
插入格式是 List[Dict]:外层 List 是批量,内层 Dict 是一条符合 Schema 的记录。典型入库流程是:加载文档 → 切 chunk → 编码成稠密加稀疏 → 组装 → insert。删的时候按主键 filter 就行。
九、检索:三种打法
向量字段支持精确检索(KNN)和近似近邻检索(ANN),标量字段提供条件过滤,专门配合向量检索做筛选。纯向量检索要盯四个参数:查询向量(维度必须对齐)、anns_field、limit(TopK)、metric_type(要和索引一致)。
但生产里最好用的往往是混合检索:稠密和稀疏各召回一批,再用重排序融合。
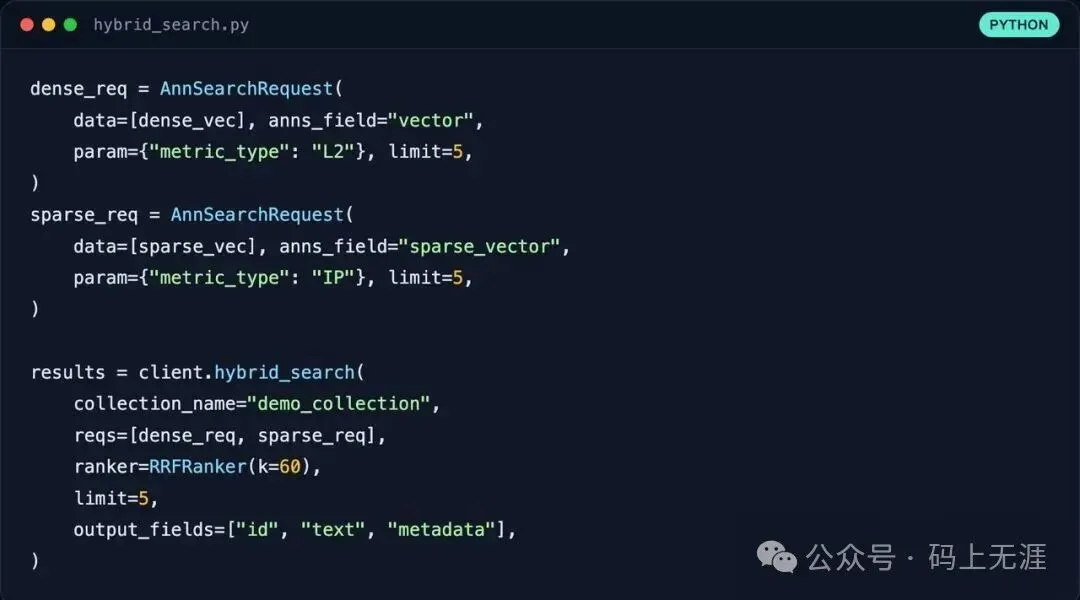
RRF 的取巧之处在于:L2 距离和 IP 分数本来没法直接相加,但「名次」可以。所以它只收集排名,按公式折算(k 一般取 60)再聚合,你不用关心两路分数的量纲。
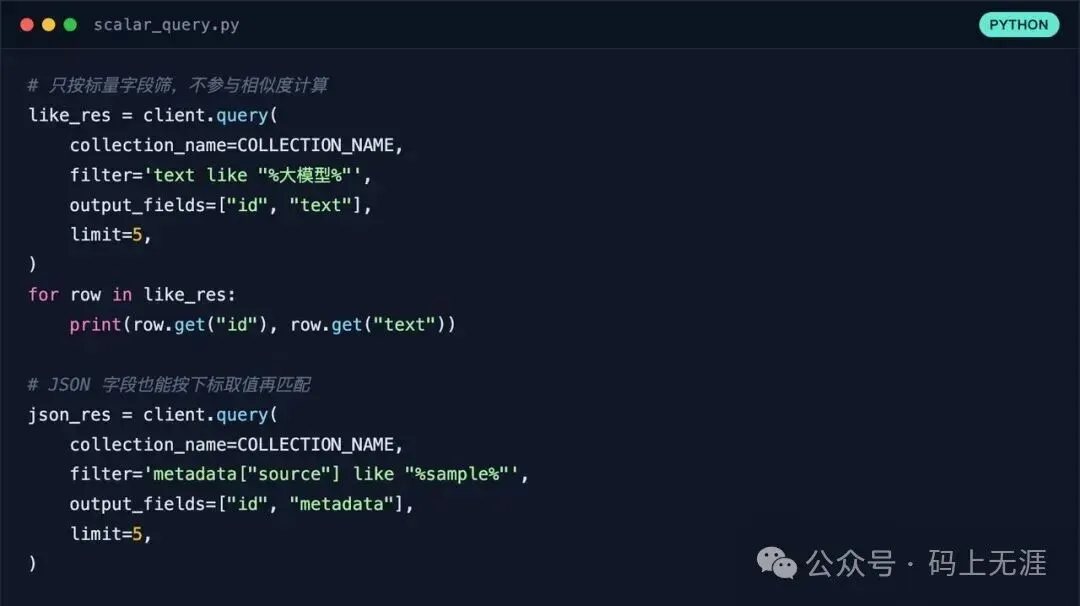
第三种是标量检索,不涉及相似度,纯按字段条件筛——对 VARCHAR 用 like 模糊匹配,对 JSON 按下标取值再匹配。真实系统里这两类能力通常是叠着用的:
十、生成:最后一步,也最容易偷工
检索到相关数据之后,把内容拼进上下文,让 LLM 基于完整上下文生成。代码很短,但两个细节决定效果:
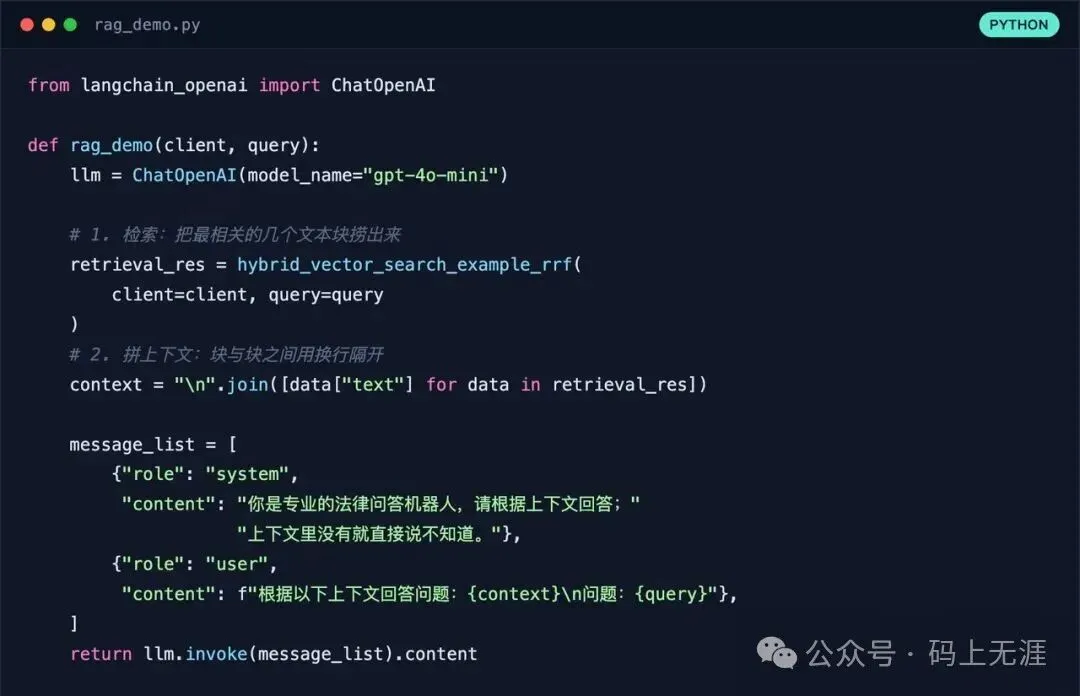
一是 system 里要明确「上下文里没有就说不知道」。这一句能显著减少幻觉——否则模型会拿训练记忆去补检索的空缺,你想防的东西又回来了。
二是块与块之间用换行拼接,不要压成一大段。结构丢了,模型对「哪句出自哪块」的判断也会跟着模糊。
十一、小结
▪︎ RAG 治的是知识滞后、知识缺失和幻觉,代价是时延与 Token 消耗
▪︎ 切分和嵌入是地基:块切得好不好、embed_query 与 embed_documents 用没用同一个模型,直接决定检索能不能准
▪︎ Milvus 这边建库三个高频翻车点:维度对不上、开了 auto_id 还传主键、索引与 metric 不配套
▪︎ 混合检索(稠密 + 稀疏 + RRF)是性价比最高的召回提升;生成阶段一句「不知道就说不知道」能拉回不少幻觉
本文整理自 LangChain 学习笔记的 Retrieval 章节,代码按当前 langchain / pymilvus 接口对齐过,可以直接抄。