ARTICLE · 1287721
AI Agent帮我们将软件快速“搬”到RISC-V平台
 更多精彩,请点击上方蓝字关注RVEI

一次 YiMig 迁移实测——从“能跑”到“快90%”
恒一纪元是一家专注于面向 Agent 工作负载、基于 RISC-V 架构研发高性能服务器 CPU 的芯片设计企业。芯片设计推进到一定阶段,团队里最让人焦虑的问题,往往不是“性能还能不能再提一点”,而是另一个更现实的问题:芯片出来了,上面跑的软件从哪里来?
x86 架构跑了快五十年,积累了海量的应用;而RISC-V 则很年轻,软件生态是公认的短板。把一套应用从 x86 平台迁到 RISC-V 平台,过去靠工程师逐行排查编译错误、手动修改、反复调试—— 一个中等规模的软件项目,动辄需要数周甚至数月才能搞完。行业里管这叫“迁移”,实际上更像“人肉翻译”,耗时费力。
那么,能不能让 AI 来干这件事?带着这个问题,我们公司软件团队做了一次真实的软件迁移实验。
01
一场“软件搬家”实验
两组对照实验:
第一组,选一个已经有人工适配过 RISC-V 的项目,把代码回退到适配前的状态,让 AI 重新做一遍,再和人工版本对比;市面上已有不少项目经过了移植,相关数据可查,因此不是本次实验重点关注的方向。
第二组,选一个完全没做过 RISC-V 适配的开源项目,直接把整个任务丢给 AI——我们这次实验的主角是 libwebp 库,就属于第二类。
为什么选 libwebp?
因为它是互联网上应用最广的图片编解码库之一,网页里大量图片(如 WebP 格式)就是由它处理的。这个库自带一套 x86 的 SSE2 向量优化代码——就是专门榨干 CPU 性能的那部分代码。把它搬到新架构上,既有代表性,又有挑战。
怎么判断“搬得好不好”?
我们搭了三种环境,分步测试:①原生 x86 平台、②QEMU 仿真的 RISC-V、③真实 RISC-V 硬件。
STEP 01
我们先在原生 x86 上测试并作为基线:同一个 libwebp 库,先跑一份关掉向量指令的纯标量版本;再跑一份 x86 原生向量化版本,各测一遍,得到 x86 平台上自己的基准——这台机器上向量化到底能快多少。这些数据是后面所有对比的参照线。
STEP 02
再用 QEMU 仿真环境做兼容性检查:这一步不看速度,只看代码能不能跑通。我们把向量寄存器宽度(VLEN,可以理解成一次能带多少数据的宽度)调成四种不同配置逐一测试,确认迁移后的代码在各种向量配置下结果都正确。它只排雷,不测性能。
STEP 03
最后上真实 RISC-V 硬件,分两步走:先做标量移植测试,确认代码在新架构上能跑、结果和原版逐字节一致;再做向量移植测试,把 RVV 向量指令加进去,看性能到底能提多少。
所有性能数据,统一用 CPU 周期数(cycles)来比,而不是墙上的毫秒。两块芯片主频差得很多,直接比“跑了多少毫秒”并不公平;周期数回答的是“完成同一件事,CPU 转了多少步”,用比值把频率差异剔除掉。前提列清楚了,实验结果才站得住脚。
02
第一轮:先测试软件的功能都“搬对”了
第一轮,我们让 AI 完成 libwebp 解码路径里 7 个 SSE2 源文件到 RISC-V 向量指令(RVV)的迁移。这一步的目标只有一个:功能上完全等价。
覆盖范围如下:色度上采样、无损格式转换、Alpha 处理三个模块全量覆盖;反滤波、输出缩放、帧内预测等模块按实测收益分发,负收益的函数主动保留标量——这里没有为了“全向量化”而硬上向量处理。
对图片解码来说,“搬对”有严格标准:解码出来的图片,每一个字节都必须和原版一模一样。实测结果:100% 逐字节一致——超过 18 万个测试用例、多种随机种子全部对齐,7 类测试图片的 SHA-256 完全一致;4 种不同向量位宽配置也全部通过。
这里多提一句 QEMU 的用途:它只是用来验证软件代码在不同向量位宽(VLEN)下都能正常跑,验证的是“兼容性”,不含性能评估;因为真实的性能,还是得上真机测试。
功能部分全对了,我们当时还挺高兴 —— 然而随后一测性能,我们又高兴不起来了:慢,而且慢很多!
03
第二轮:AI Agent 参与的“性能体检”
第一轮跑通了,但性能却远低于预期。
我们把问题原样抛回给 AI:帮我看看,时间都花在哪里了?AI Agent 接下来做了一件工程师们最熟悉的事 —— 逐函数剖析,把整条解码链路拆开,看每一段到底消耗多少周期。然后给出诊断:哪些函数适合向量化、哪些向量化反而更慢;该向量化的向量化,该保留标量的保留标量。
经过一轮一轮迭代,性能开始往上走。
期间我们发现了一个反常识的小细节:编译器也会帮倒忙。连编译器自己的自动向量化,AI 也单独查了一遍——在 rv64gcv 参数下,GCC 15 的自动向量化默认是开着的,它会把迁移范围外的标量代码也“顺手”向量化:有些函数经过它这一“优化”,反而比纯标量还要慢(实测只有 0.92×、0.83×);显式关掉后,才回到 1.09×、1.13×。
追查下去,原因也很反直觉:被自动向量化的主要是熵解码这类分支密集的标量路径——指令数确实少了 10.5%,周期数反而涨了 20.8%。因为在这类核上,向量指令并非“免费”:每条都有固定的启动拍数、短依赖链还要叠加延迟,而编译器的成本模型没有按这个真实开销校准,把自动向量化当成了“免费提速”,结果适得其反。三种构建输出 MD5 一致,说明这是纯性能问题,不是正确性问题。
处理方式其实简单:手写 RVV 在全部 7 张图上都是正收益,拖后腿的只是编译器的自动向量化——交付构建显式关掉它(-fno-tree-vectorize)即可。这件事也让我们看得更清楚:AI 不是无脑“开向量”,它会逐函数判断哪一步有正收益、哪一步帮倒忙;同时,RISC-V 的生态差距不只是硬件——工具链(比如编译器成本模型)同样需要时间,针对这类新核去校准。
几轮下来,结果开始明显提升了:同一颗芯片上,RVV 版本相对纯标量版本,整体性能加速 30%—90%;典型的有损图片场景下提升到 50%—60%。最直观地说:一张 4K 实拍照片的解码时间,直接少了五六成。这已经逼近人工适配的水平。
但测试的故事还没完:我们拿它和 x86 平台的向量化效果对比,发现还是有一段距离。而 AI Agent 给了一个出乎意料的结论——这不是代码本身的问题。原因见 04 节。
把 7 张测试图的结果放在一起,每一行回答同一个问题:同一台机器上,向量化比纯标量快了多少?
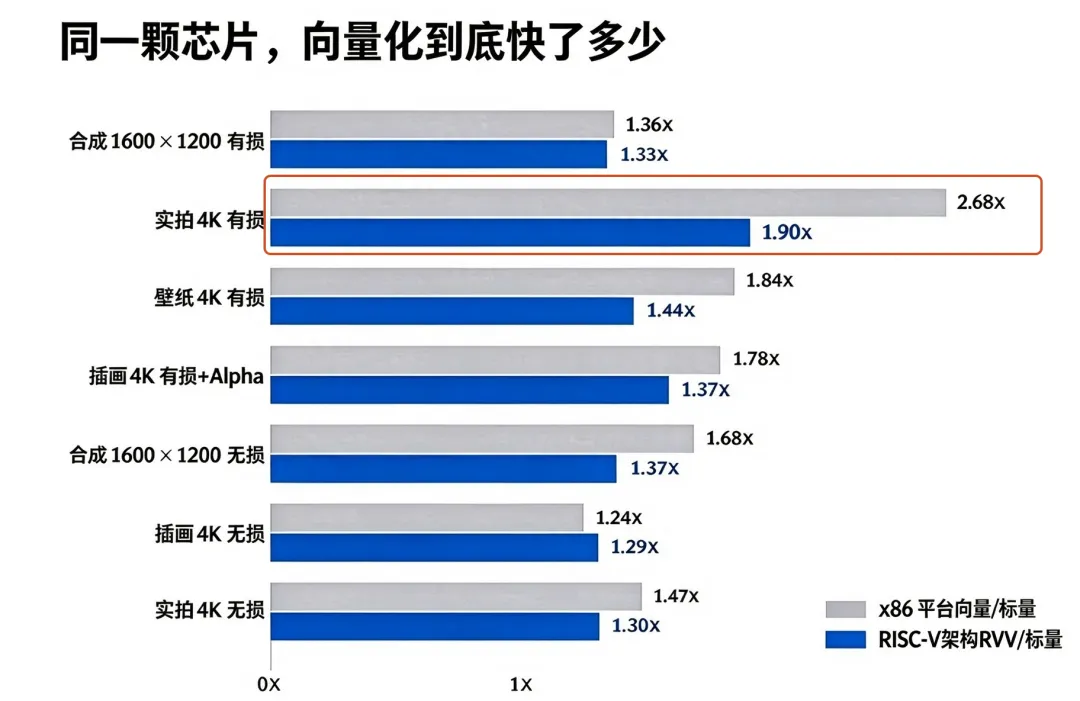
注意“实拍 4K 有损”这一行:1.90×,这正是副标题里“快 90%”的出处。加速比口径:同一台机器、同一份源码、同一张图,纯标量构建的每帧周期数 ÷ 向量构建的每帧周期数。数据来源:《libwebp 在某 RISC-V 平台上的向量化迁移性能实测报告(第2版),公司内部测试数据》。
这里我们更要关注数据的异常表现:以实拍4K有损为例,虽然RISC-V上开启RVV指令获得了1.90x的加速收益,但是同样的算子在x86平台上经过向量化之后,却获得了更是高达2.68x的收益。这里数据的巨大差异,才是我们研究的重点—— 为什么会这样? 这就需要我们进行更深入的微架构研究和算子展开研究。具体细粒度的分析和研究结果见以下章节。
04
最后一问:差距来自哪里?
在同等周期数下,RISC-V 平台向量化后的表现,和 x86 平台之间仍有 1.4~2.6 倍的周期差距。为什么?
AI Agent一路追查下去,把根因定位到了微架构层面——也就是说,问题出在芯片硬件本身的固有架构设计上,而不是代码写得不好。
AI 先把差距拆开看了一遍——同样的周期数,差距到底花在哪?拆完是两块:一块是天生串行的环节。比如熵解码(VP8 的算术解码、VP8L 的 Huffman 解码),每一步都要等前一步的结果,任何向量指令都插不上手,是“任何向量扩展都动不了”的部分——向量化之后,它仍然占整帧周期的 21%(实拍有损)到 73%(实拍无损),成了最大的 Amdahl 分母;而且 x86 平台上它同样没有 SIMD 实现(占 40%/80%),这不是 RISC-V 独有的短板。
另一块是小尺寸计算:反变换(IDCT)和帧内预测都是 4×4、16×16 的小块,向量指令有固定开销,硬上向量化反而更慢——这类函数 AI 主动保留标量实现,性能反而提升了。有损图里真正缩得多的是环路滤波(也只有垂直方向被向量化,水平方向实测负收益、保留标量)和上采样,向量化把该拿的收益都拿到了。
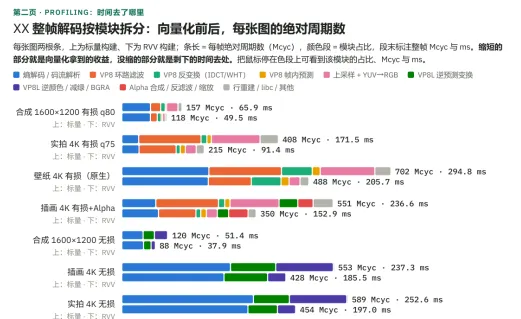
上图是实测报告第 2 页的原图:同一颗 RISC-V 芯片上,7 张测试图向量化前后的整帧时间构成——每组两根条,上为纯标量构建、下为手写 RVV 构建,条长=每帧周期数(Mcyc),颜色段=各解码模块占比。读图只需要看一件事:哪一段缩了,哪一段没缩。有损图里,环路滤波(橙)和上采样(粉)明显变短,向量化拿到的主要收益都在这里;而蓝色“熵解码/码流解析”段几乎纹丝不动——实拍 4K 有损那张,整帧从 408 Mcyc 降到 215 Mcyc,缩掉的部分主要来自橙色和粉色段。无损图更直观:深绿“逆预测”段缩到底之后,整帧剩下的几乎全是蓝色熵解码。
换句话说,向量化把能拿的收益都拿了;剩下拿不动的,正是熵解码这类天生串行的环节。但“动不了”到底是软件问题还是硬件问题?—— 不能靠猜。
AI Agent 做了一件更“较真”的事:自己写了一个微架构探针(valu_probe.c),把每一条候选向量指令放进 200 万次迭代的循环里,实测它在真实芯片上“一条指令要花几个周期”,数据按“实测规律 / 有证据推断 / 未验证”分级,板上一分钟就能复现。经过几轮实测结果,把疑问一个个确定了:
▲短向量没有折扣:整数向量 ALU 每条指令 1 拍,代价跟着 LMUL 走、和实际处理多少元素无关——vl=4 和 vl=32 一样贵,小向量等于白跑一趟。
▲跨步访存代价跟着 VLMAX 走:水平方向滤波这类“列方向”访问必须用跨步加载,代价按整个向量寄存器的槽位数算、与实际取多少元素无关,实测比连续访存慢约 28 倍——这正是水平滤波负收益的机理。
▲依赖链延迟 3 拍:要打满 1 拍/指令的吞吐,至少需要 3 条独立指令链并行;vl=4 的短依赖链每条指令都付 3 拍,而标量侧同一时刻能发 3 条——“短向量链输给标量”就是这个机理。
▲向量发射宽度每拍最多 1 条:而标量却能持续约 3 IPC—— 这和 Zen5(4 个 256 位向量口 + 2~3 个加载口)的绝对差距,主要就落在发射宽度上。
▲访存并非越大越快:unit-stride 加载 LMUL=1 只要 1 拍、LMUL=4 却要约 6 拍,比拆成 4 次小加载慢 50%;存储通路只有 128 位宽,一次存满 32 字节要 2 拍。
这些都是硬件固有的设计取舍——多数和这颗核的能效定位相符,是取舍而非缺陷——不是改几行代码就能补救回来的。
指令是一样,但效果不一样
不过,看懂之后不是认命——有些差距,软件是可以“绕”过去的。比如水平方向滤波的跨步访存,代价按 VLMAX 槽位数走,我们就用分数 LMUL(让一条向量指令只占寄存器的几分之一)把 VLMAX 压到刚好等于要取的元素数,每字节代价直接减半——微基准上 5 个水平滤波函数已有 4 个转正(0.94×~1.28×),端到端收益正在真机上做最终确认。读懂了微架构,软件侧是能定向缩小差距的。
所以迁移不能照搬 x86 的优化套路:x86 上有效的向量写法,换一颗 RISC-V 芯片未必成立。正确的做法,是针对每款芯片的微架构特性定制优化策略,并把这些经验沉淀成为芯片的专属知识库;同时,软件的功能跑通只是第一步,迁移全部完成,还必须加上“性能达标”这一关。
有意思的是,这个结论反过来帮了我们:它让我们更清楚地“看懂”了 RISC-V 的芯片内部微架构——哪些瓶颈是软件能解决的,哪些该由芯片微架构设计去改进。一次迁移实验,意外地变成了我们CPU硬件设计的前期输入。
同样地,这些实验得到的真实数据,也为云帆迁移产品 YiMig 提供了可信的原始数据验证,可以引导我们如何去优化 YiMig 的性能。
05
从一次实验到一条流水线
这次实验里,AI Agent 覆盖了功能迁移、性能分析、瓶颈定位的全流程。和传统方式相比,最大的变化是:工程师从“逐行改代码”,变成了“定义问题、验收结果”,繁琐的体力活全部交给 AI Agent 去跑。
我们把这套能力沉淀成了云帆迁移系统(YiMig)——一个 AI Agent 辅助的 RISC-V 软件迁移系统:以源码仓库为输入,自动完成工程分析、交叉构建、问题诊断、推理修复和运行验证,迁移周期从“天级/周级”压缩到“小时级/天级”—— 一个过去要按周排期的项目,现在按小时就能出结果。
分工上,常规迁移以 AI 为主,绝大部分工作由 AI 独立完成;真正费劲的深度调优,也要由人和 AI 协同完成。还要强调一点:功能跑通不等于迁移完成——代码能在新架构上运行只是起点,后续仍要结合具体硬件的微架构做针对性调优,才算真正交付。
目前,云帆已经在持续迁移了一批常用软件,并把每次踩坑的经验沉淀进自进化知识库,越用越聪明。而且我们已经开始与国内几家云服务巨头进行紧密合作,帮助他们将那些非常常用的基线软件迁移到 RISC-V 平台服务器上。
06
结语:迁移的终点,是生态的起点
RISC-V 生态的成熟,不只需要芯片算力突破,更需要应用软件的规模化迁移。当软件“搬家”从人肉翻译变成 AI 流水线,迁移门槛就被显著降下来了,RISC-V 软件生态的飞轮才能够真正转得起来。
说到底,芯片性能没达到,生态是建立不起来的;而软件迁移,正是让每一分硬件性能真正落到应用上的那座桥。这,就是我们做这次实验的意义。
NEWS
云帆(YiMig)迁移系统・开放试用申请
如果您对 RISC‑V 软件迁移系统感兴趣,欢迎提交试用申请。
点击文末【阅读原文】或扫描文末二维码填写信息,我们将对申请进行评估,后续与您对接沟通。期待与运营商、政企、软件研发伙伴共同推进 RISC‑V 软件生态落地。
来源:恒一纪元