ARTICLE · 1288989
小米开源 0.8B 文档模型,五项平均 83.2,一张消费卡就能跑
一张 1.75GB 的权重文件,在 OmniDocBench v1.6 上拿到 96.83 分。榜首那个模型 1.2B 参数,只比它高 0.04 分。
模型叫 Xiaomi-OCR-0,参数 0.8B。10 月 30 日小米对外宣布开源,可权重早在 9 月 30 日就挂上了 Hugging Face,技术报告也是那天发的。
中间隔了一个月。中文技术圈的实测文章先出来,官方声量反而落在后面。
一个模型干三件事
做文档智能化,过去要拼三套东西。版面分析一套,文字识别一套,字段抽取再一套。Xiaomi-OCR-0 把这三件塞进同一个权重文件。
第一件是文档解析。整页丢进去,正文,表格,数学公式按阅读顺序还原成 Markdown。表格按 OTSL 结构输出,公式转 LaTeX。OTSL 是给机器读的表格标记,官方附了转 HTML 的脚本,转完就能编辑。
第二件是关键信息抽取。发票,收据,身份证,银行卡,业务表单,你指定字段,它按字段定位,输出 JSON。接自动化流程,不用再写一堆规则。
第三件是视觉问答。围绕文档和图表做跨区域检索,数值计算,语义推理。不只是把字认出来。
分数摆出来
官方模型卡上,这几项成绩挨着写。OmniDocBench v1.6 拿 96.83,总榜第二,1B 以下第一。Real5-OmniDocBench 拿 95.24,在这几款里排第一。Wild-OmniDocBench 是 87.94。
专项里,公式识别 UniMER-Test 97.84,表格结构 PubTabNet 92.27。古籍和书法那一组,Chronicles-OCR 拿 73 分。小米把它跟闭源模型 Seed 2.0 Pro 的 72 分放在一起说,意思是打平。
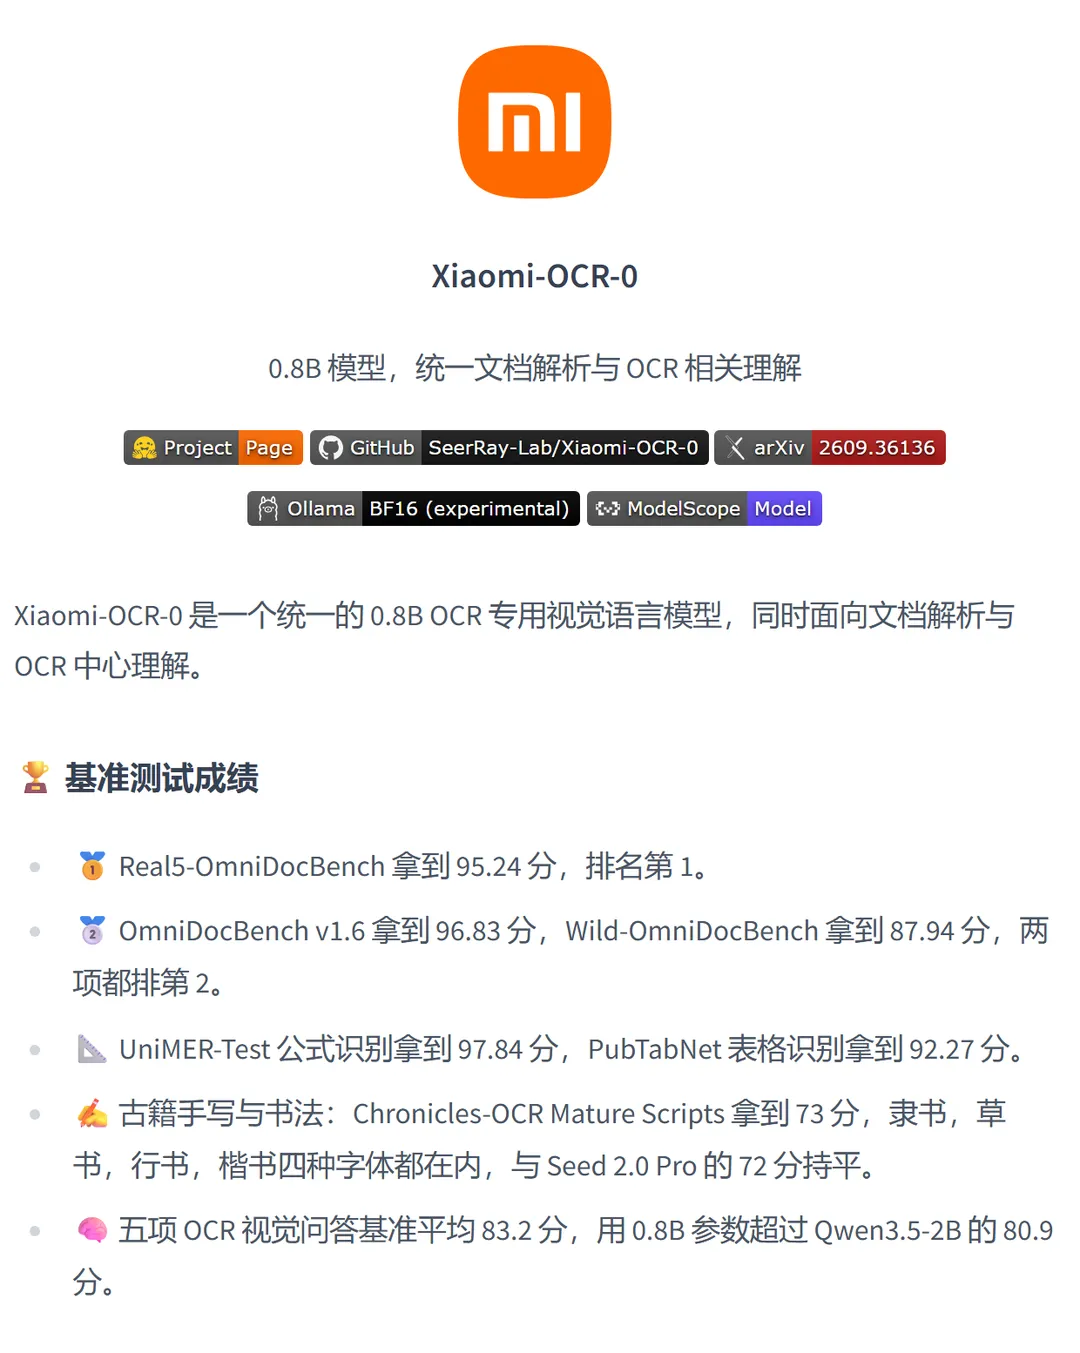
图1、官方模型卡上的成绩与排名
标题里的 83.2,是五项视觉问答基准的算术平均。DocVQA 93.1,InfoVQA 75.1,ChartQA 84.6,OCRBench 也 84.6,TextVQA 78.6,五项加起来除以五,正好 83.2。
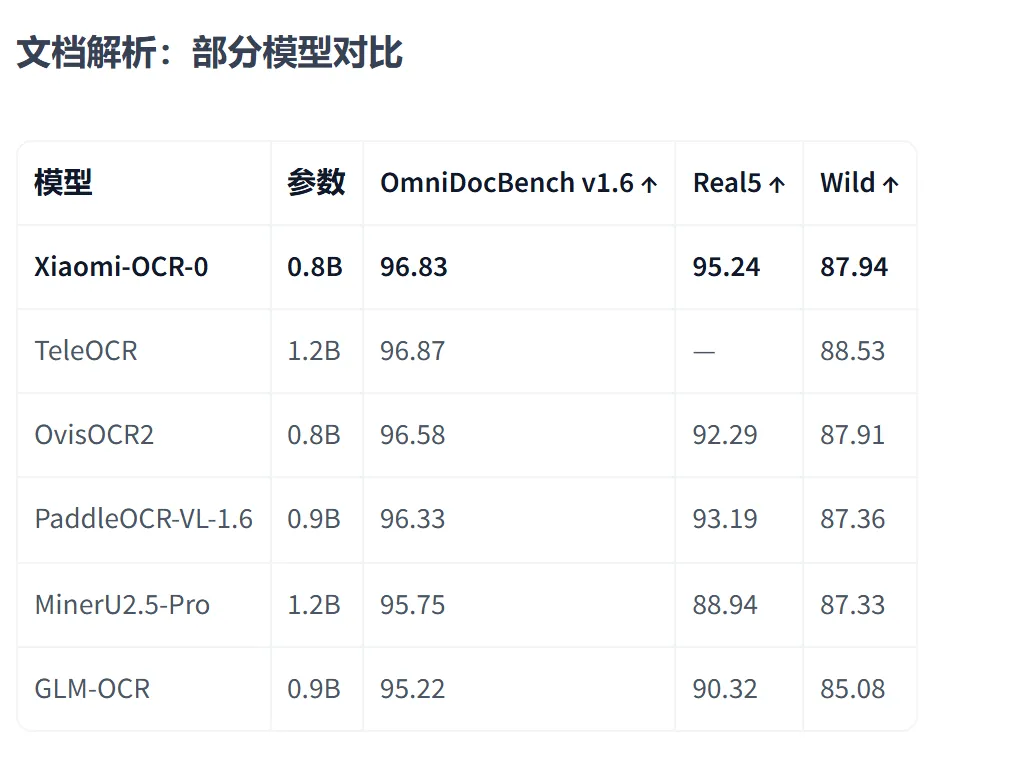
图2、文档解析的六款模型对比
83.2 这个分数,得跟参数量一起看。2B 的 Qwen3.5-2B 拿 80.9,8B 的 MiniCPM-V-4.5 拿 82.6,7B 的 TextHawk2 拿 78.5。只有 4B 的 Qwen3.5-4B 跑到 84.9,比它高 1.7 分。
0.8B 站在什么位置
官方放了一张参数效率图,横轴是参数量,纵轴是分数。0.8B 这一档只有两个点,Xiaomi-OCR-0 在上面那个。再往右,1.2B 的 TeleOCR 也只多 0.04 分。
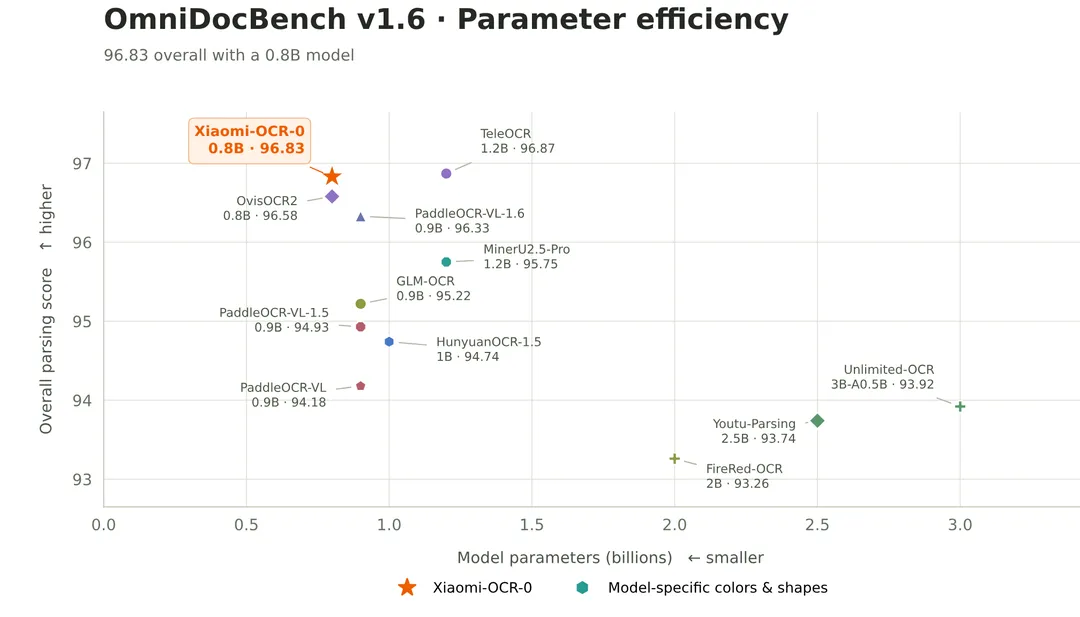
图3、OmniDocBench 的参数效率分布
解析这一侧,它贴着 1.2B 的 TeleOCR。后者 96.87,它 96.83,参数只有三分之二。
问答这一侧更明显。8B 的 MiniCPM-V-4.5 在 82.6,它在 83.2,参数差十倍。
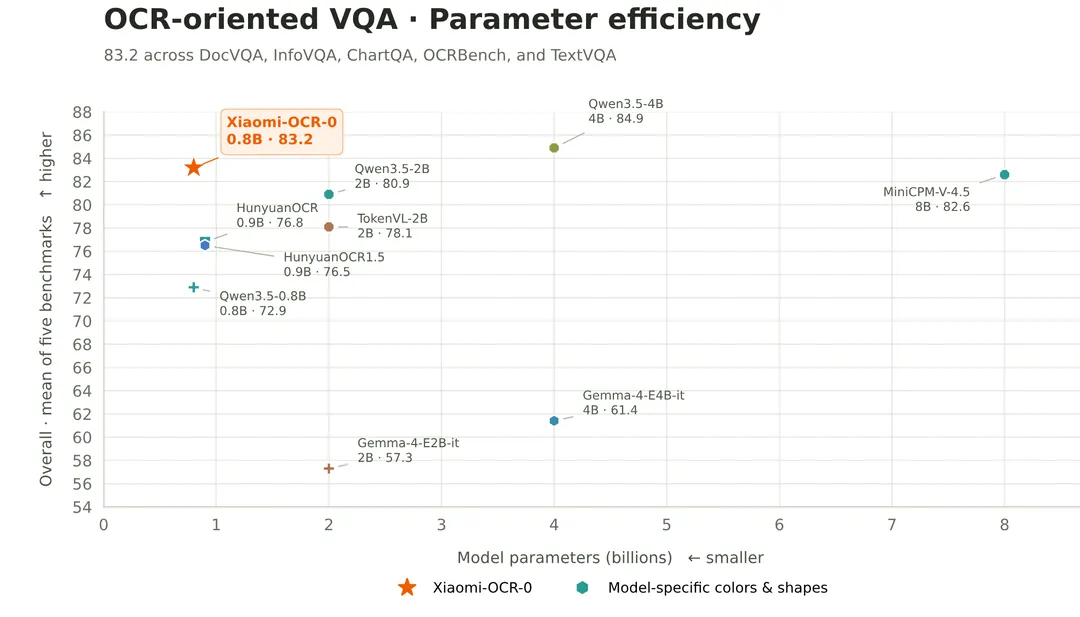
图4、五项视觉问答的参数效率
1.7 亿样本,三道工序
底座是 Qwen3.5-0.8B-Base,训练用了约 1.7 亿条 OCR 与文档理解样本。一个 0.8B 的模型吃下这个量级,是它敢跟大模型排进一张表里的底气。
数据不是直接喂进去。第一道是异构专家共识,让一批 OCR 专家模型同时对正文,表格,公式出标注,再按 1-NED,TEDS,CDM 这些专项指标投票,取三家一致的结果。
技术报告里的专家池有八款。PaddleOCR-VL-1.6,MinerU2.5-Pro,GLM-OCR,dots.mocr,HunyuanOCR-1.5,TeleOCR,OvisOCR2,Qianfan-OCR。既有老牌工具,也有同期竞品。
第二道是渲染引导校验。表格和公式的候选结果重新渲染成图,跟原图做像素级和结构级比对。行列错位,符号缺失,这一步能抓出来。
第三道是定向合成。按版面复杂度,字体形态,物理退化三个维度挖短板,补多语种,古籍手写,屏幕摩尔纹,扭曲光照。
训练分三段。先是 Q-Mask 文本锚定,把文字 Token 和它在页面上的位置对齐。再是 OCR 持续预训练,百亿级 Token 的多任务混合。最后是混合任务强化学习,奖励信号用结构编辑距离,表格匹配度,问答准确率。
团队还总结出一条规律。解析基础没打牢的时候,过早掺进高层理解任务,早期阶段反而掉 0.33 分。等解析稳了再加,中期涨 0.64 分,晚期又涨 0.07 分。
一张消费卡装得下
权重文件 1.75GB,许可证 Apache 2.0。整个仓库连示例图和评估脚本加起来,1.77GB。
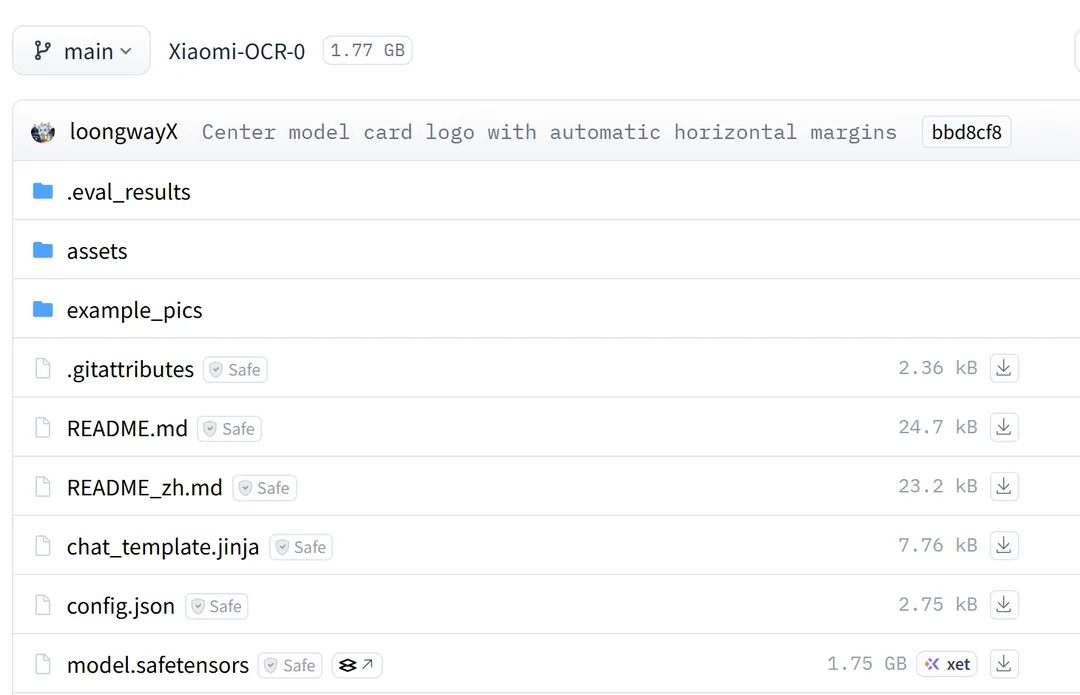
图5、仓库里权重文件 1.75GB
这个体积,一张普通显卡装得下,退一步纯 CPU 也能跑。官方示例按 cuda,mps,cpu 三种设备给了分支。社区把它转成 BF16 的 Ollama 包,约 1.8GB,一条命令拉下来就能起服务。
更说明问题的是手机端。小米说这套能力已经进了超级小爱。短按 AI 键,三指上滑,或者喊一句记一下,就能把屏幕上的信息抽出来。
取餐码,快递取件码,排队号,会被提到显眼的位置。账单详情里,交易金额,商户,时间,类别一次性抽出来记账。群里的会议通知,海报上的时间地点,直接生成日程卡片。
OCR 从按页调 API,变成装在自己机器里的一个能力。
这是参数小带来的直接变化。
它的边界
榜首的 TeleOCR 还是第一。96.87 对 96.83,差 0.04 分,参数是 1.2B。
Wild-OmniDocBench 那张表里还藏着一个数字。TeleOCR 的 88.53 比它的 87.94 高 0.59 分,这一项官方没在模型卡上展开说。
官方自己做过一组对照。同样从 0.8B 扩到 4B,解析分数只涨 0.15 分,理解分数涨了 4.9 分。解析这一侧它已经贴到天花板,理解那一侧还留着空间。
所有分数都是小米自己跑的。对比表里部分对手的 Real5 一栏是空的,说明原始来源没报这一项。评估配置公开在仓库里,能不能复现,得自己验。
一个 0.8B 的模型,把文档解析做到 1B 以下的头名,把体积压到 1.75GB。对做文档处理的人来说,原来按页付费的活儿,现在可以搬回本地。
TeleOCR 领先的那 0.04 分还能守多久。识屏这套能力能不能走出手机,落进多少条企业流水线。