ARTICLE · 1290041
每天一个AI知识点——Harness,同一个模型,为什么你和别人差 20 分
做第 7 篇的时候,有一张图我怎么看都不顺眼。
一张四层的塔形图,四层都堆在最上面,下面空出九十五个像素,像一句话没说完就咽回去了。
按直觉,这时候该做的是换一个更会画图的模型。
我没有。我打开组件源码,找到那个外层容器,把 height: 400 改成 justifyContent: center。
重新渲染,图好了。
整个过程两分钟,模型一个参数都没动。
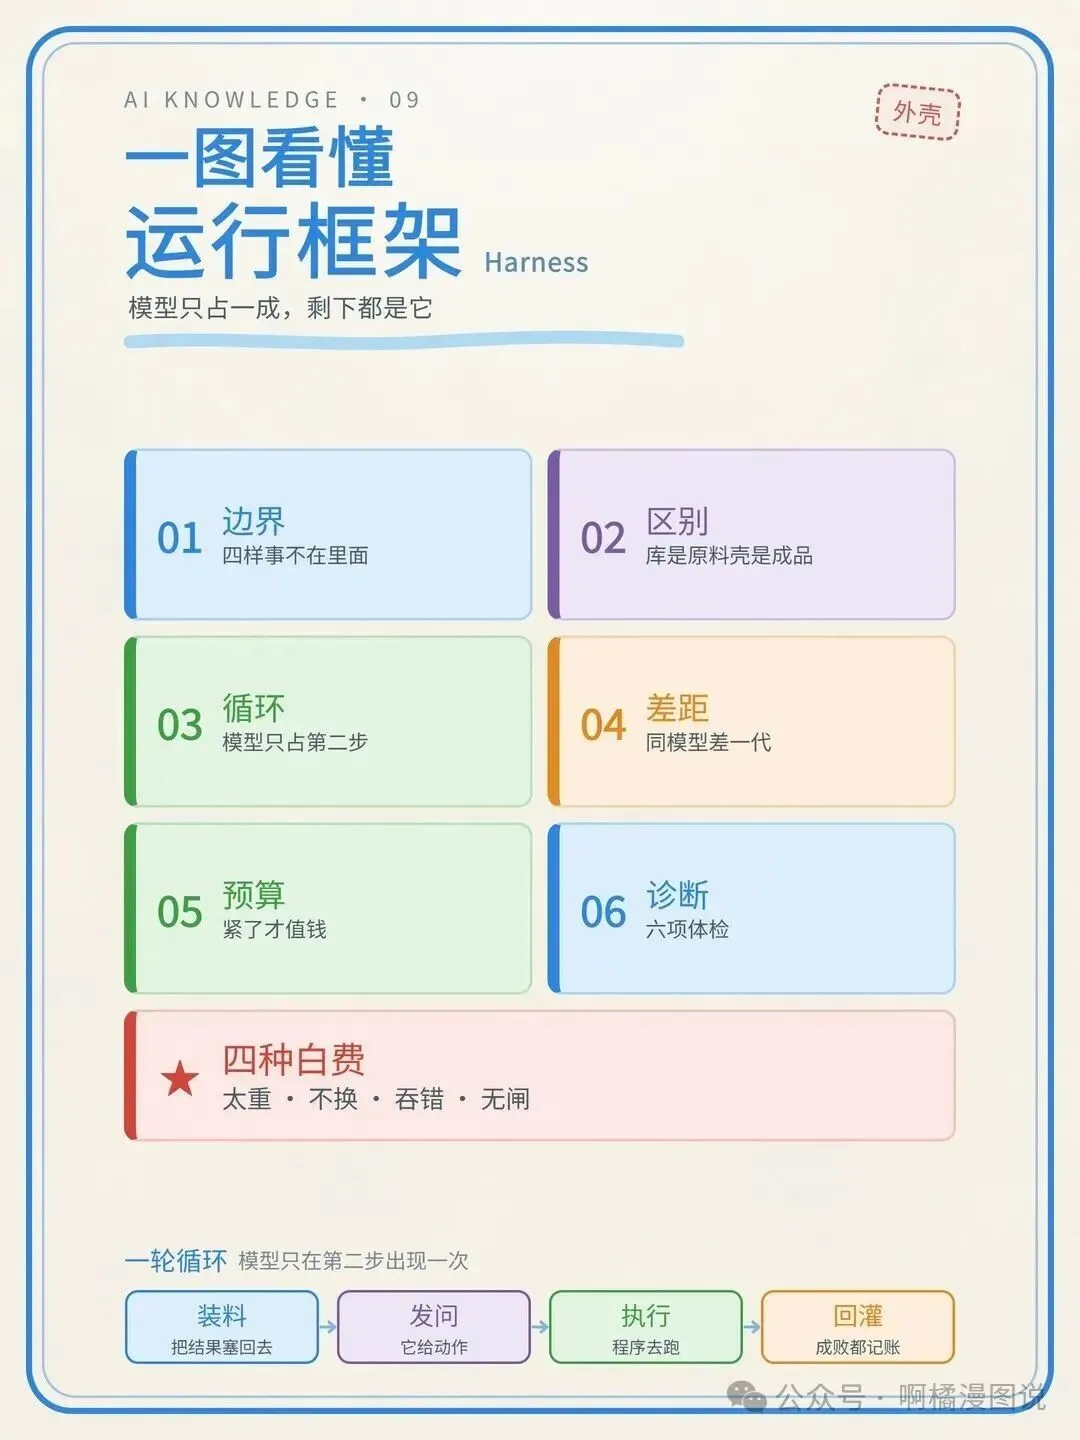
问题从来不在那个会思考的东西身上,而在包着它的那层壳。
这层壳有个名字:Harness。
一、模型只是循环里的一个函数
先看一张最不浪漫的图。
你以为 AI 干活是这样的:你说一句话,它想明白了,事情办完了。
实际上是这样:
装料 → 发问 → 执行 → 收账 → 判停 → 再绕回来。
五个步骤里,模型只出现在第二步。
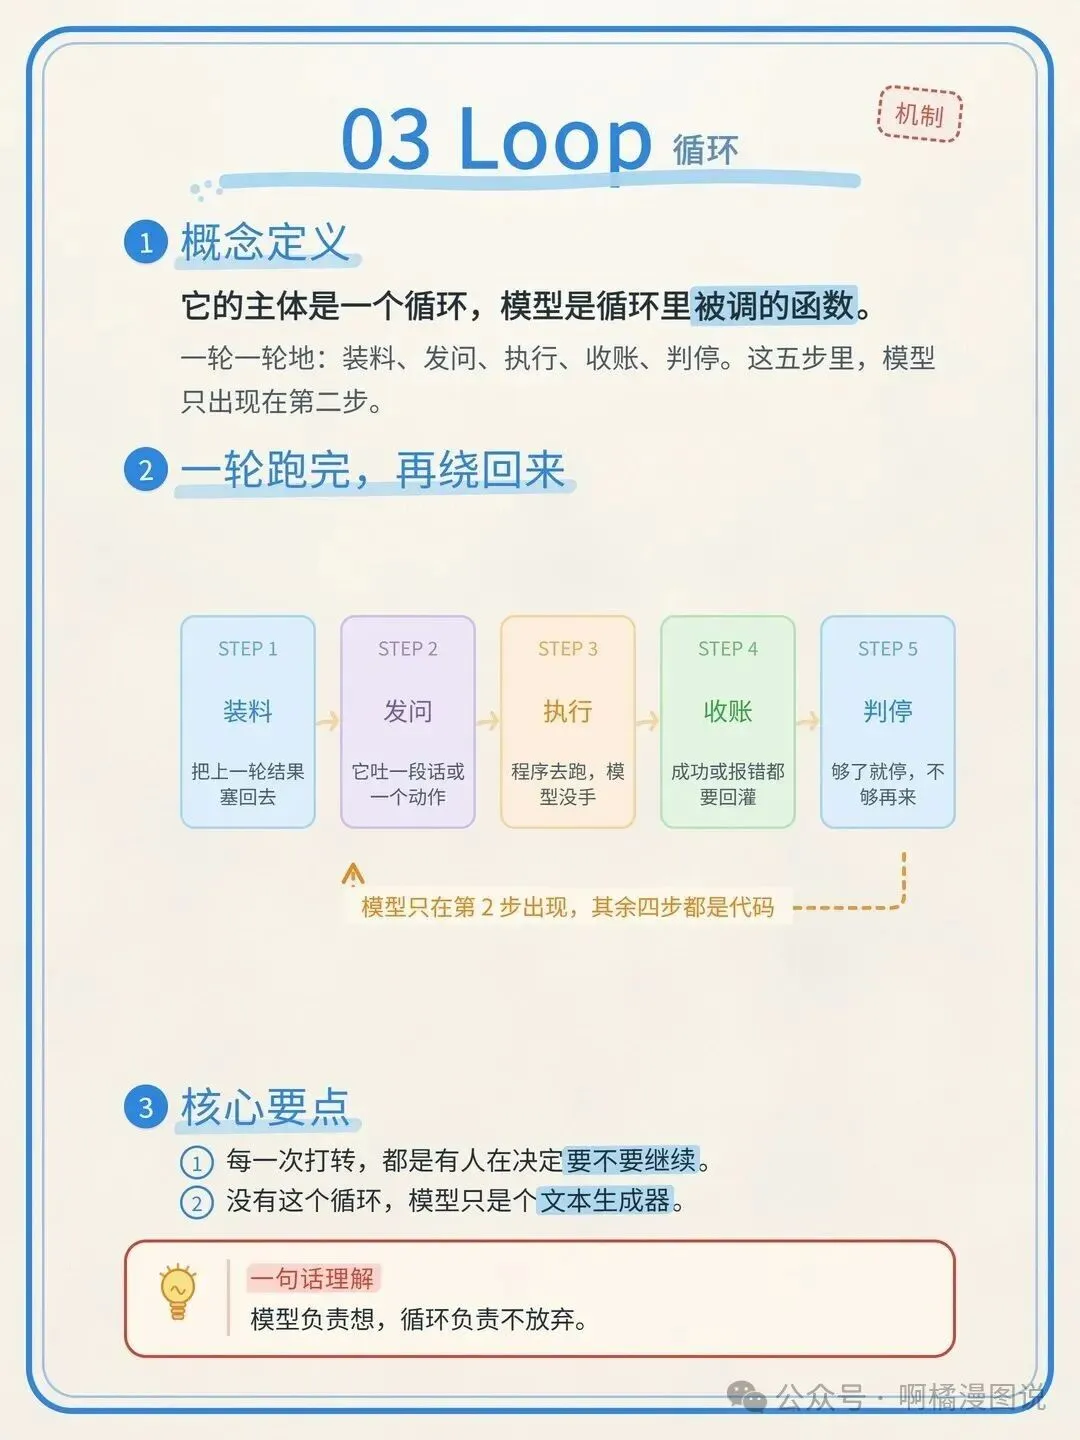
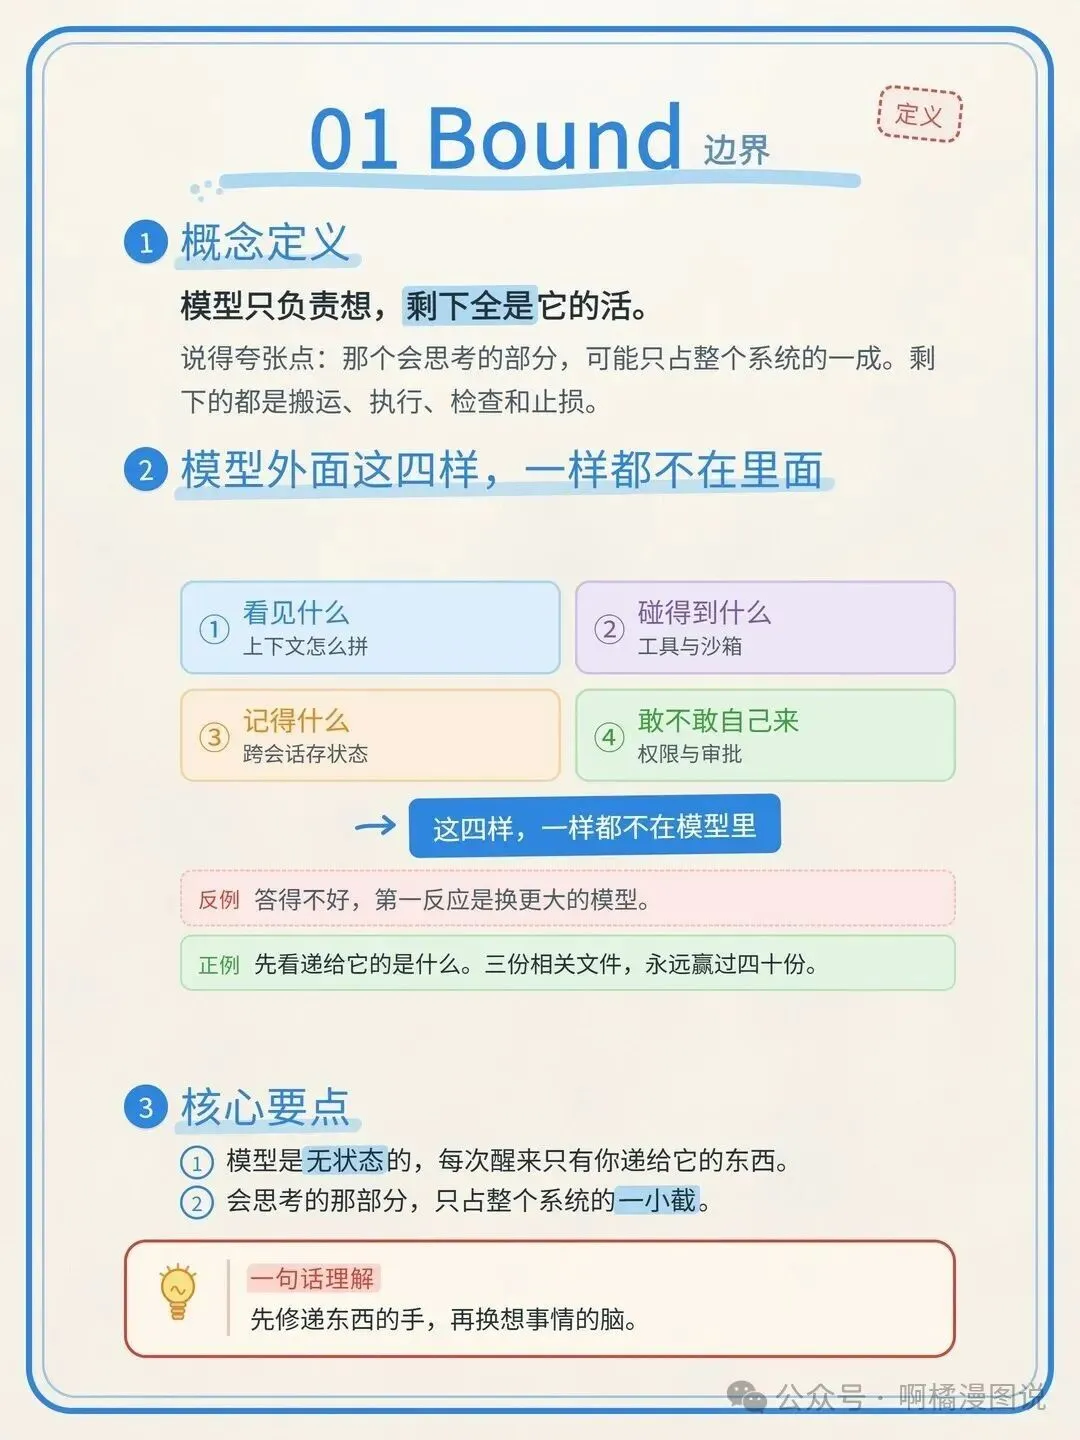
模型只会做一件事:根据你递给它的东西,猜下一个词。
它没有手。它不能读文件,不能跑代码,不能点按钮。它唯一能做的,是把「我想调用这个工具」写成一段文字。
真正去执行的,是壳。
真正决定这一轮该塞什么进去、上一轮的报错要不要原样回灌、跑到第几轮该放弃的,也是壳。
所以有个公式,2026 年被引用得最多:
agent = model + harness
LangChain 的说法更直接,几乎是甩出来的:harness 就是所有不是模型的东西。
系统提示、工具定义、执行循环、上下文裁剪、权限审批、状态存盘,还有那些写在仓库根目录的约定文件(CLAUDE.md、AGENTS.md),全都算。
有个细节能说明这件事有多彻底。
模型是无状态的。每一次调用,它都像刚睡醒,除了你递过去的那一叠纸,什么都不记得。
你觉得它「记得我们刚才聊过」,是因为壳每一轮都把之前的对话重新塞了一遍。
你觉得它「知道自己上次试过这个方案失败了」,是因为壳把失败的记录写进了下一轮的输入。
它的记忆不是记忆,是有人一直在替它复述。
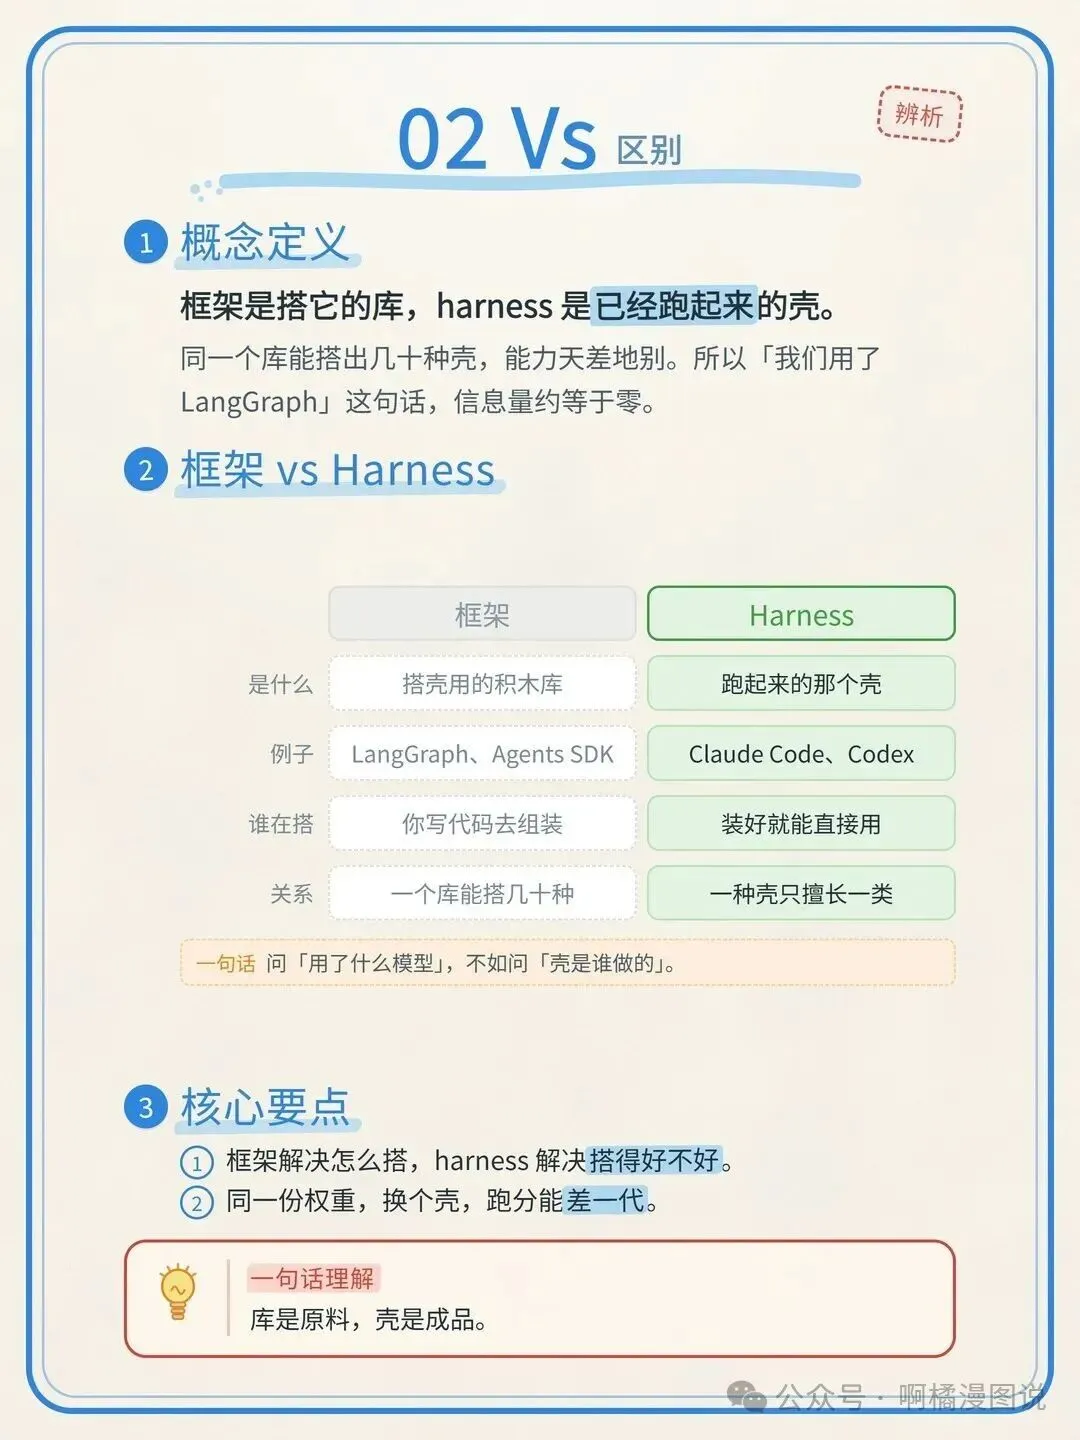
二、它跟「框架」不是一回事
这是最容易混的地方,我拆开说。
这里说的「壳」,就是 harness。
- 模型
:权重,只会猜下一个词。比如 Claude、GPT、Qwen - 壳
:已经跑起来的那个。比如 Claude Code、Codex - 框架
:用来造壳的积木库。比如 LangGraph、Agents SDK - 沙箱
:壳跑在里面的环境。比如 Docker、E2B
一句话分清:框架是你搭壳用的砖,harness 是搭好之后真正在跑的房子。
同一个 LangGraph,能搭出几十种壳,能力天差地别。所以「我们用了 LangGraph」这句话,信息量约等于零——就像说「我们家是用砖盖的」。
Anthropic 自己写得很清楚:Claude Code 就是 Claude 外面的那个 harness,而 Agent SDK 是把同一套 harness 打包成库,让你塞进自己的产品里。同一套东西,一种是给你用,一种是给你改。
这也是为什么同一个模型,在 Copilot 里、在 Cursor 里、在 Claude 自己的 App 里,手感完全不同。
模型是同一个,壳不是。
三、这个差别,是能测出来的
如果只是「手感不同」,那还是玄学。
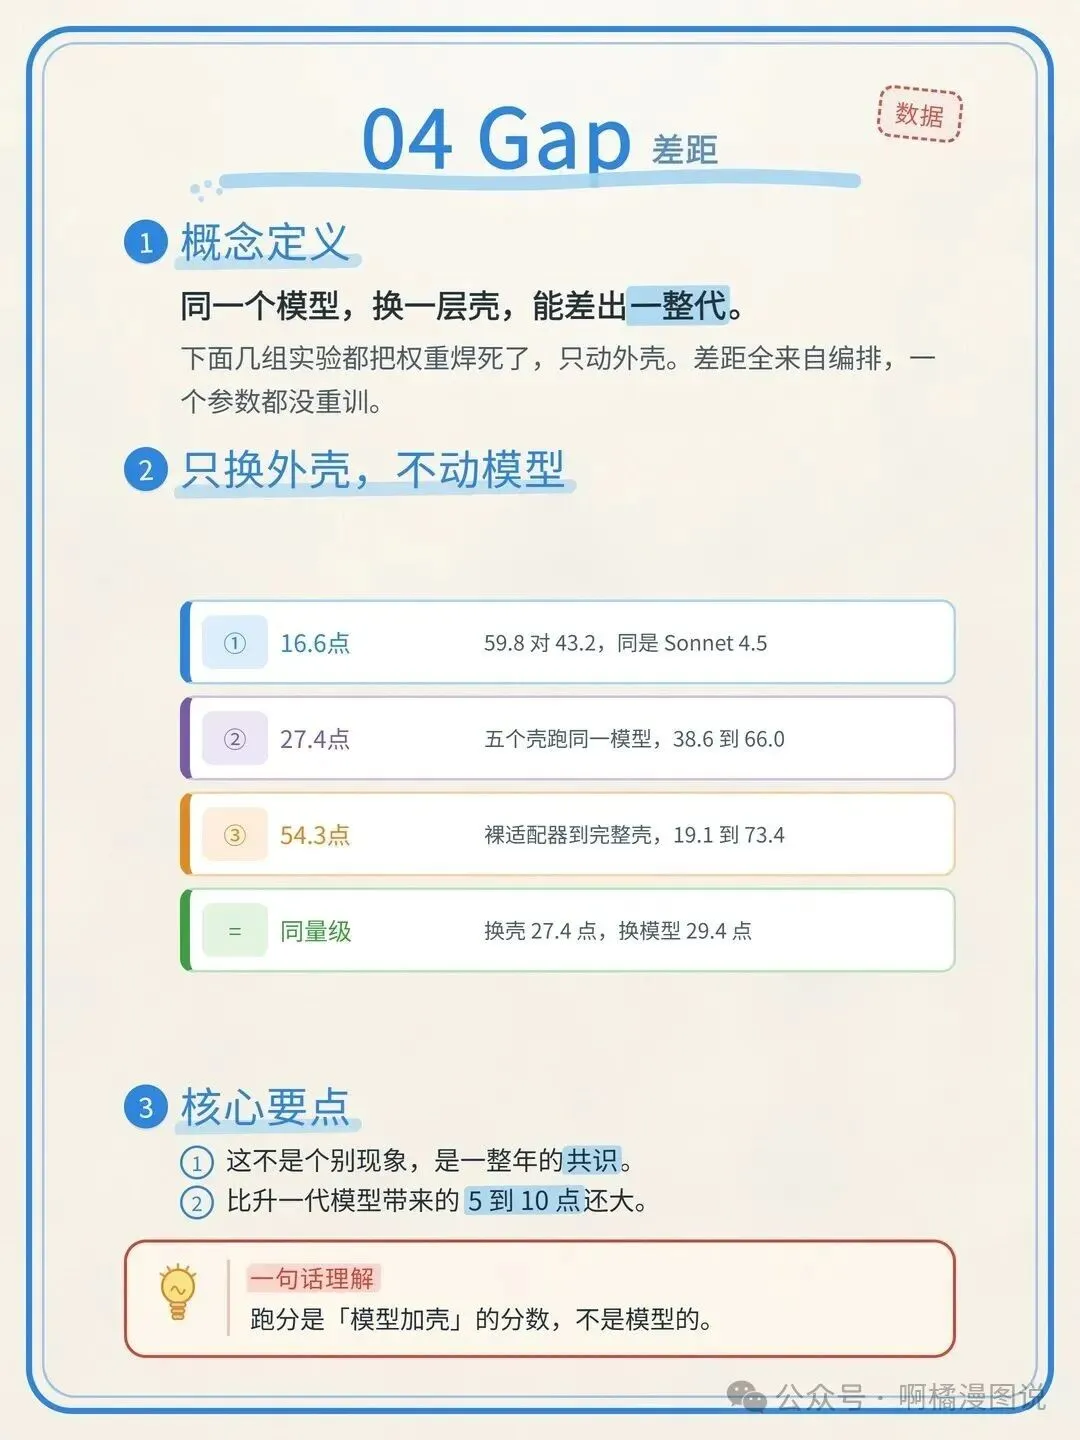
但从 2026 年年初到年尾,好几组独立实验都在做同一件事:把模型焊死,只换壳。
结果比想象中暴力。
三组实验分别焊死的是 Sonnet 4.5、Qwen3.6-flash、GLM 5.1。一个参数都没重训。
最后一行最扎眼。同一个模型,配上简单适配器只解出 19.1%,配上完整的一套壳解出 73.4%。
顺带说一句,那个实验里还有个数字:补丁应用失败率从 69.1% 掉到 1.5%。
也就是说,之前大部分失败根本不是「它不会做」,是它做对了,但改动的格式没人接得住。
这不是模型的智力问题,是接口的工程问题。
还有一组更细的实验,只改一件事:改代码的格式。整块替换还是 diff 补丁?
同一批任务,16 个模型里有 14 个明显偏好其中一种。分数从 6.7% 到 68.3%。
连「改动怎么写」这种细节,都在壳的职责范围里。
四、最反直觉的一条:预算一宽,它就不值钱了
上面那些数字容易让人上头,觉得「壳决定一切」。
但同一份研究里,有一个对照组特别值得看。
固定壳,换九个模型,差距 29.4 点。
固定模型,换五个壳,差距 27.4 点。
同量级。
换壳很值钱,但没有比换模型更值钱。它们是一样大的两个变量。
真正有意思的是下面这个。
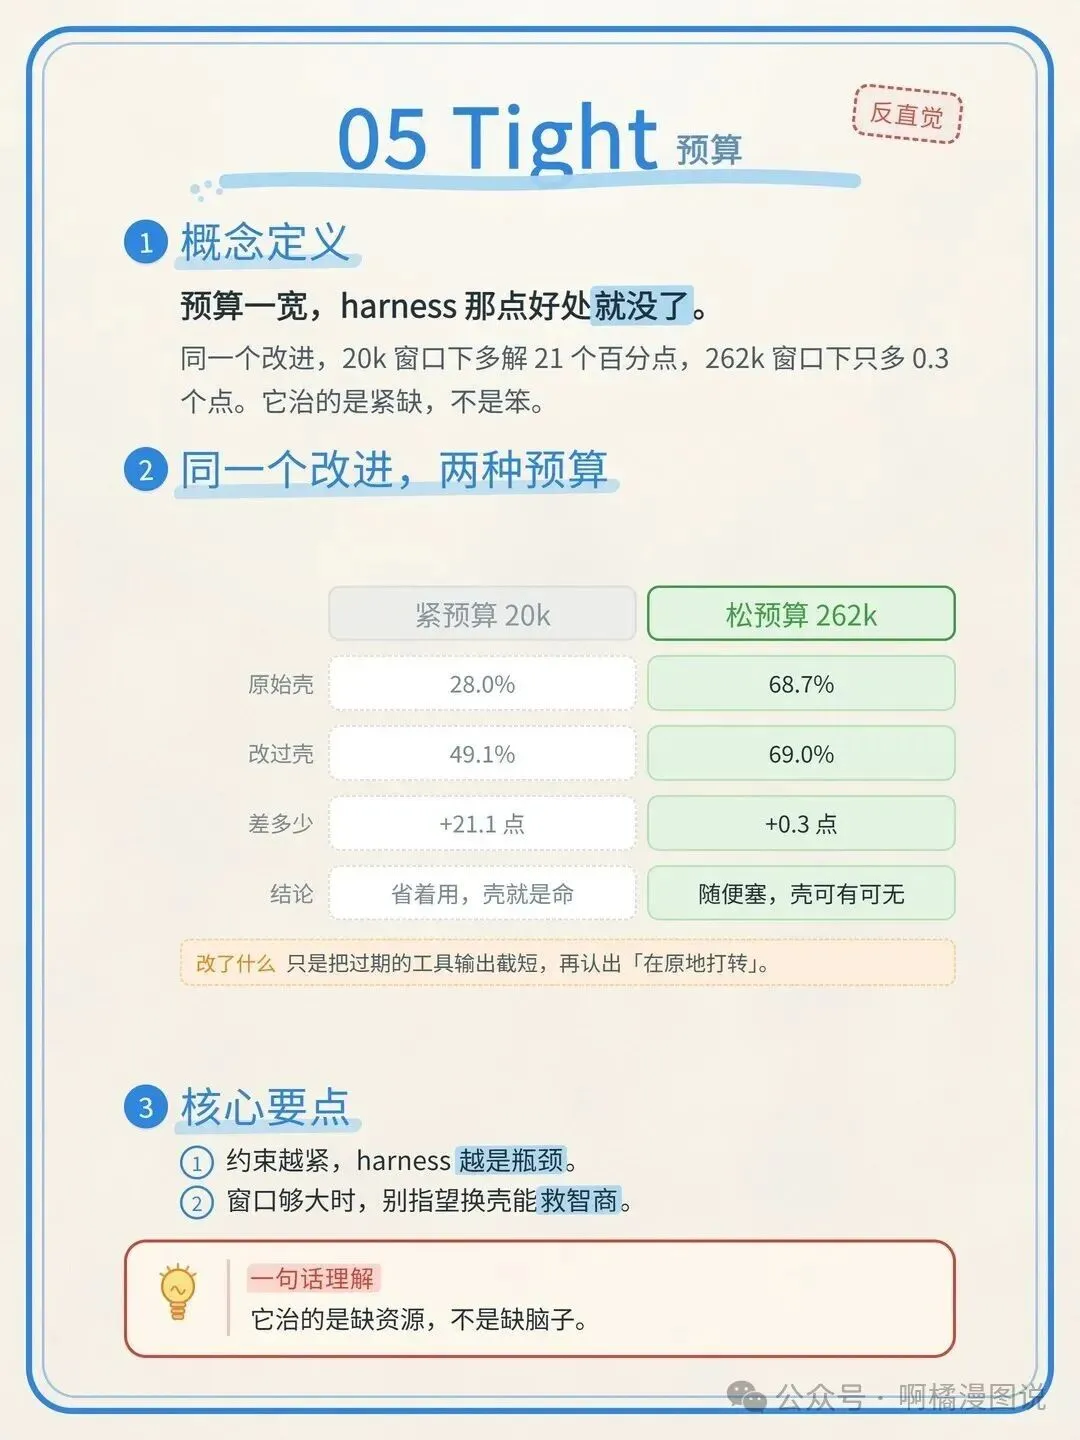
有一份研究把壳的改进拆开,只做两件很小的事:把过期的工具输出机械地截短,再识别出「在原地打转」然后插一句干预。
在 20k 窗口下,解决了 43 题变成 72 题(169 题里),分数从 28.0% 到 49.1%。
多解了 21 个百分点。
同一个改进,放到 262k 窗口下:
68.7% → 69.0%。
多解了 0.3 个百分点。
这个对比几乎是这件事的题眼。
harness 治的是「资源不够」,不是「脑子不灵」。
窗口小的时候,每一轮塞什么、丢什么,是生死问题。窗口大到随便塞,那点裁剪技巧就变成了挠痒痒。
所以别信「壳决定一切」这种标题。准确的说法是:约束越紧,壳越是瓶颈。
什么时候约束最紧?
长任务。 跑几十轮、跨好几个会话、中间还可能断掉重来的那种。
这也是为什么 Anthropic 专门写了一篇《Effective harnesses for long-running agents》——短任务用个轻壳就够了,跑一整天的任务不行,它会忘、会超窗、会自认为做完了。
五、出问题先查六样,别急着换模型
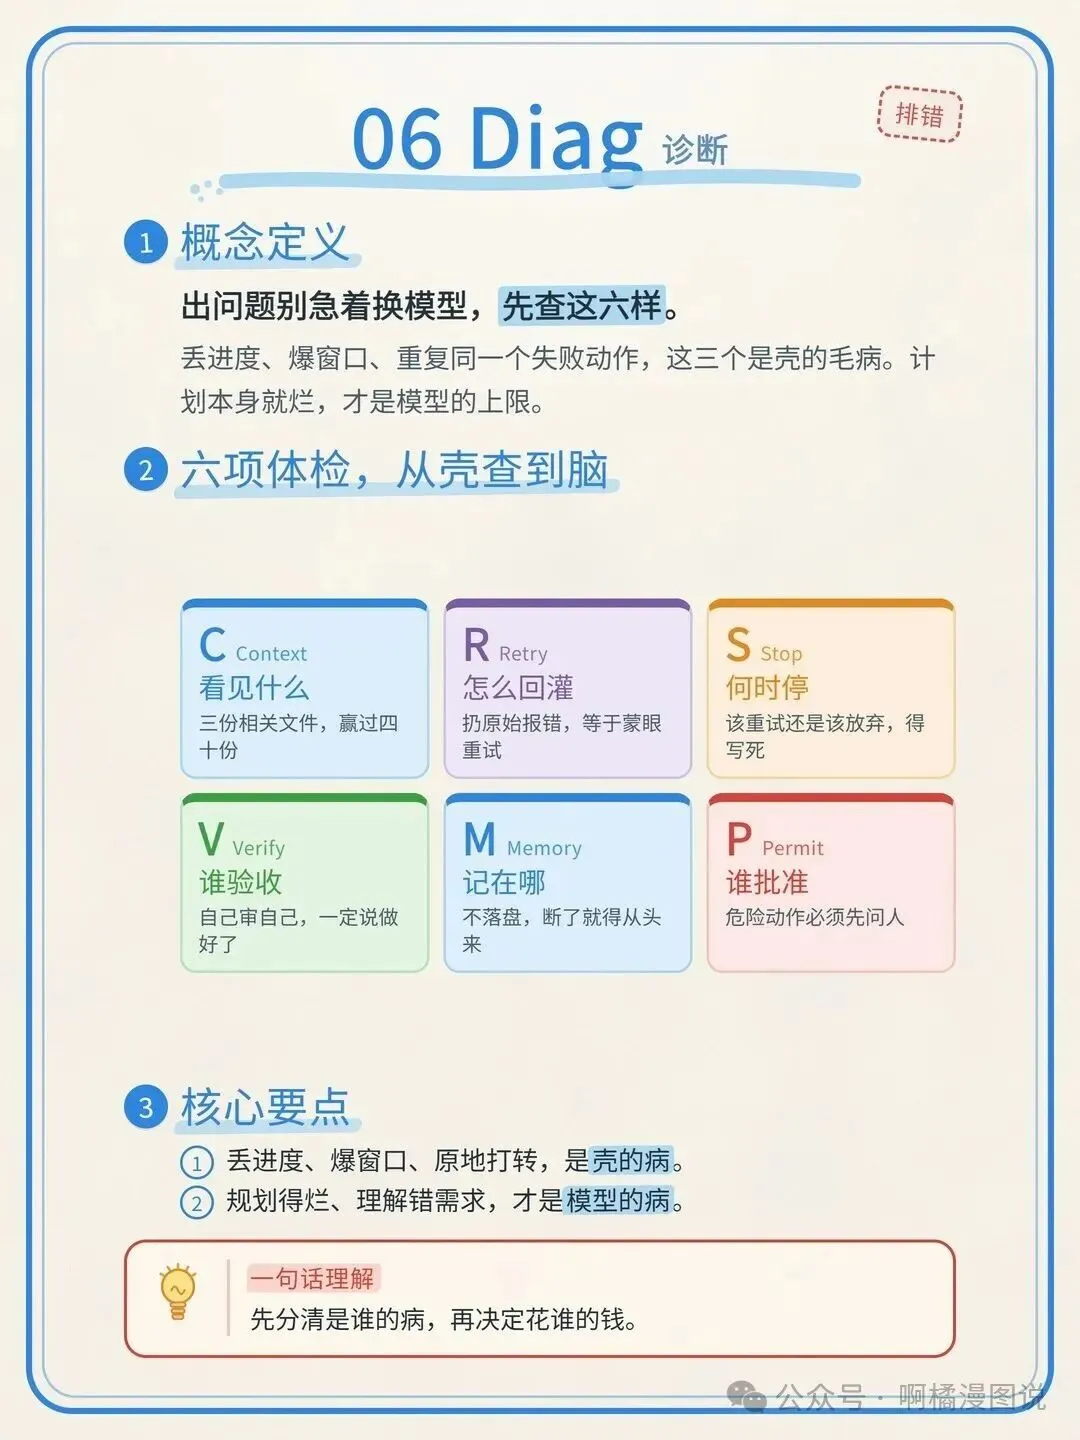
我现在的习惯是:AI 干得不好,先别动模型,按这六项过一遍。
前五条基本都是壳的活。第六条是底线。
判断标准其实只有一句:
丢进度、爆窗口、原地重复同一个失败动作——这是壳的病。
计划本身就烂、需求理解错了、方案在方向上就不对——这才是模型的病。
两种病的治法完全不同,价钱也差着一个量级。
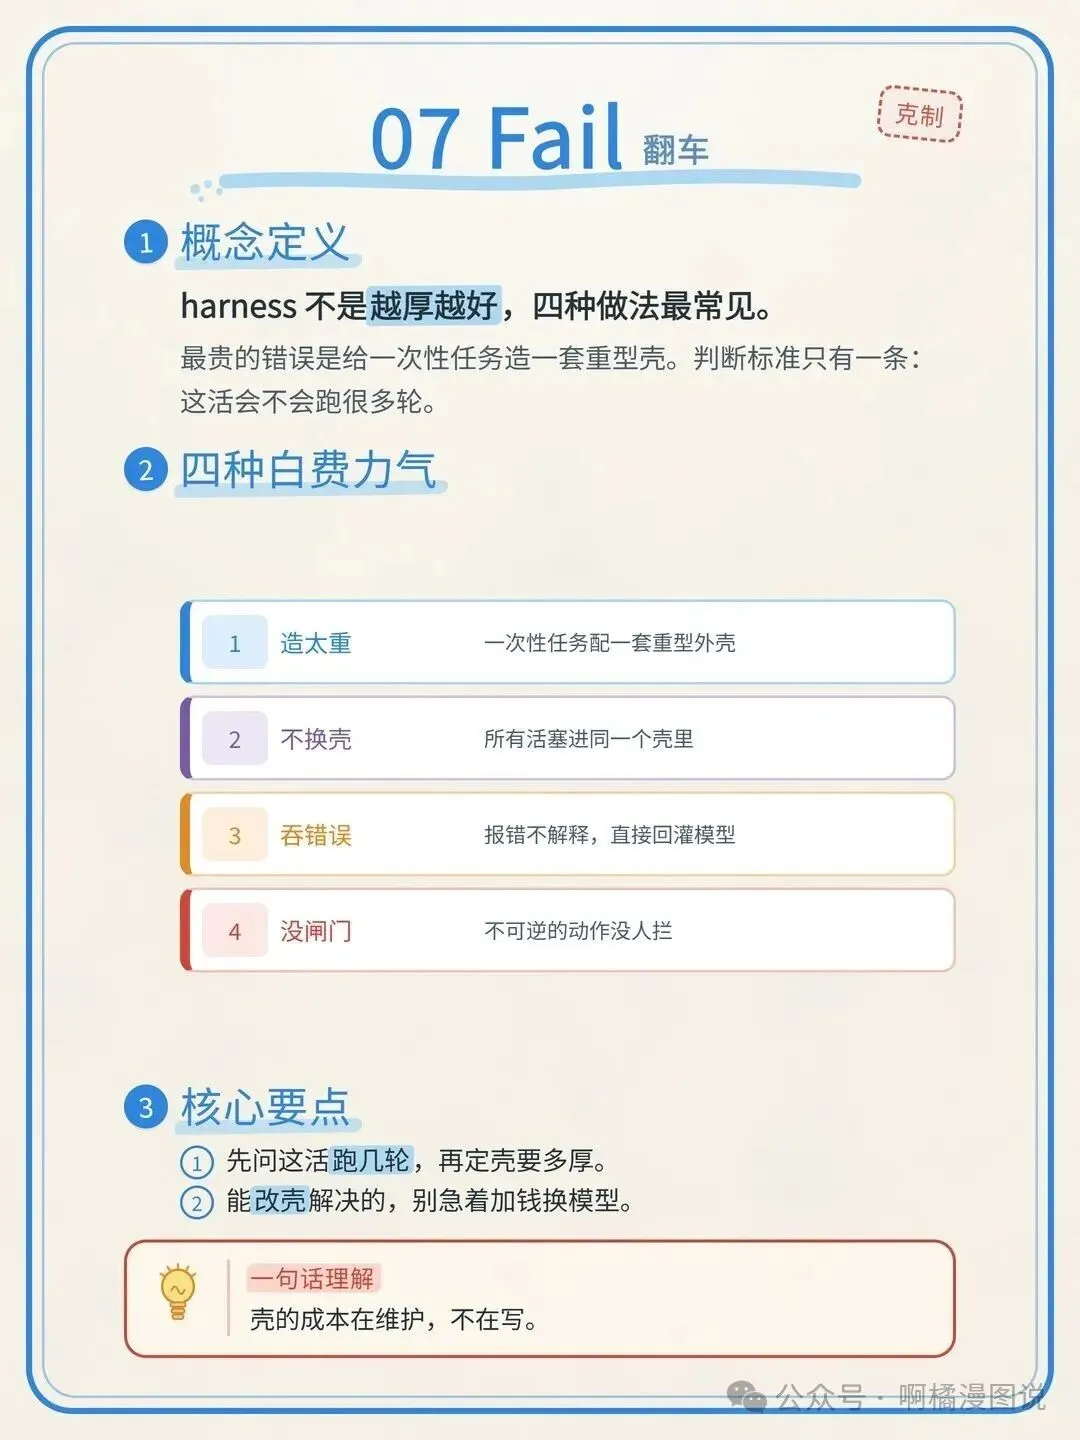
六、但也别把壳造得太重
说完壳多重要,得泼一盆冷水。
最近有个倾向:不管干什么,先搭一套带子代理、带记忆、带审批的重型框架。
给一次性任务配一套重型壳,是最贵的错误。
判断标准只有一条:这活会不会跑很多轮?
跑一轮就完事的,壳越薄越好。写个脚本,调一次接口,完事。
要跑几十轮、跨会话、中途有人接手的,才值得投资壳。
还有三种白费力气:
壳的成本在维护,不在写。
写一个壳可能是一下午的事,维护它是往后每一天的事。多一行逻辑,就多一处会坏的地方。
七、九篇串起来,是一整条链路
写到这里,这个系列其实已经闭环了。
前八篇讲的都是零件。第九篇讲的是把它们装在一起的那个东西。
零件可以买,壳只能自己调。
因为壳里装的全是「你们家的情况」:你的工具、你的权限、你的验收标准、你踩过的坑。
模型是租来的,壳是自己盖的。
这大概也是这一年最实在的一个结论:与其等下一代模型,不如先把壳修一修。
最后留个问题。
你最近一次觉得「AI 怎么这么笨」,是在它答错的时候,还是在它明明能做、却没做完的时候?
如果是后者——那多半不是它笨。
是有人没告诉它什么时候该停。