ARTICLE · 1304309
用 AI 跟进研究与技术前沿:分享一个自己开发的开源工具 Paper-Radar
目录
从一个具体研究方向开始 根据需要调整检索范围 利用 Zotero 中已有的资料确定检索主题 管理检索结果和后续阅读记录 将本次检索整理成研究进展报告 按需配置中文速览 设置定期更新,持续积累资料
无论从事科研还是工程研发,都需要定期了解相关方向的进展:近期出现了哪些新方法,已有方法解决了什么问题,哪些成果值得进一步阅读和验证。实际操作中,往往要反复访问几个检索网站,使用相近的关键词查找资料,再逐条查看标题、摘要和来源。隔一段时间重新检索,还要核对哪些内容已经看过、哪些是新收录的。
此前有读者希望我介绍如何借助 AI 跟进一个领域的研究前沿。我结合自己的日常工作,用 AI 辅助编程把检索、整理、记录和报告导出等步骤整合成了一个本地工具,取名 Paper-Radar。经过几轮修改,目前已经能够完成关键词检索,也可以按设定的时间定期自动化更新。这里介绍当前版本的主要功能和使用过程。
Paper-Radar 在个人电脑上运行,通过浏览器操作。检索记录、下载的 PDF 和生成的报告都保存在本地。当前支持从 arXiv、OpenAlex 和 Crossref 获取学术文献题录,读取本机 Zotero 收藏夹,并将结果整理为 Word、Markdown 和 CSV 文件。Springer Nature、Scopus 和 ScienceDirect 也预留了检索入口,但需要获得相应的官方 API 授权后才能使用。
现阶段,工具主要通过公开学术文献了解一个方向的研究和技术方法进展。对于企业研发人员,它可以用于前期技术调研和方案资料积累;对于科研人员,则可以用于持续跟进研究主题、整理阅读记录。专利、技术标准、产品资料等信息仍需通过其他渠道补充。
项目地址:https://github.com/QiQiWan/Paper-Radar。
从一个具体研究方向开始
第一次使用可以先完成一轮检索,暂时跳过 Zotero 和大模型配置。基础检索和报告导出不需要模型 API,但需要联网访问学术检索服务。
先在电脑上安装 Python 3.10 或更高版本,将源码包解压到固定文件夹。Windows 用户双击 start_windows.bat;macOS 或 Linux 用户执行 sh start_macos_linux.sh。首次启动时程序会安装依赖,完成后即可在浏览器中打开本地工作台。
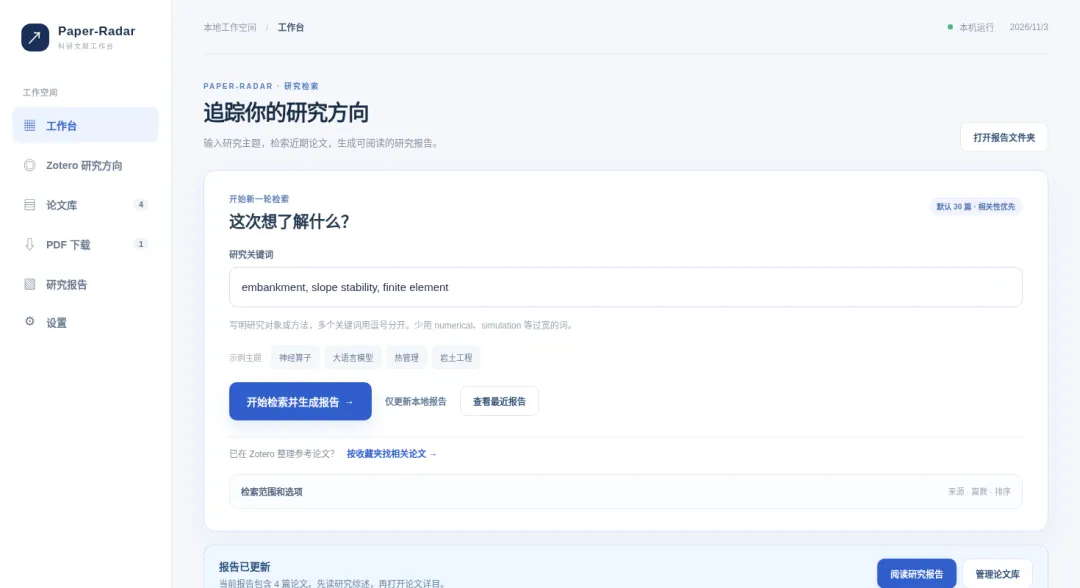
进入左侧的“工作台”,找到 研究关键词。这里以物理信息神经网络(Physics-Informed Neural Networks,PINN)为例,跟进它在反问题求解和参数识别方面的研究进展。可以输入:
physics-informed neural networks, PINN, inverse problems, parameter identification
这组关键词包含研究方法和具体任务。检索范围较宽时,可以继续补充应用领域或方程名称,例如 heat transfer、Navier–Stokes equations。关键词需要结合检索结果调整。对于企业研发中的具体问题,建议同时写入设备涉及的物理过程或需要识别的参数,便于后续判断文献是否有实际参考价值。
点击 开始检索并生成报告,页面上方会显示任务进度。展开运行日志,可以查看 arXiv、OpenAlex、Crossref 各自的检索情况。任务结束后,工作台会显示收录条目数、PDF 下载数和运行状态,点击 查看研究报告 即可查看本次结果。
根据需要调整检索范围
系统默认最多收录 30 篇文献,按照相关性排序。日常跟进可以先用这一设置;需要做专题调研时,再展开“检索范围和选项”,把数量上限调整为 50 或 80,也可以切换成按日期排序。数量上限控制的是本次收录规模,不能据此判断相关方向的全部研究成果。
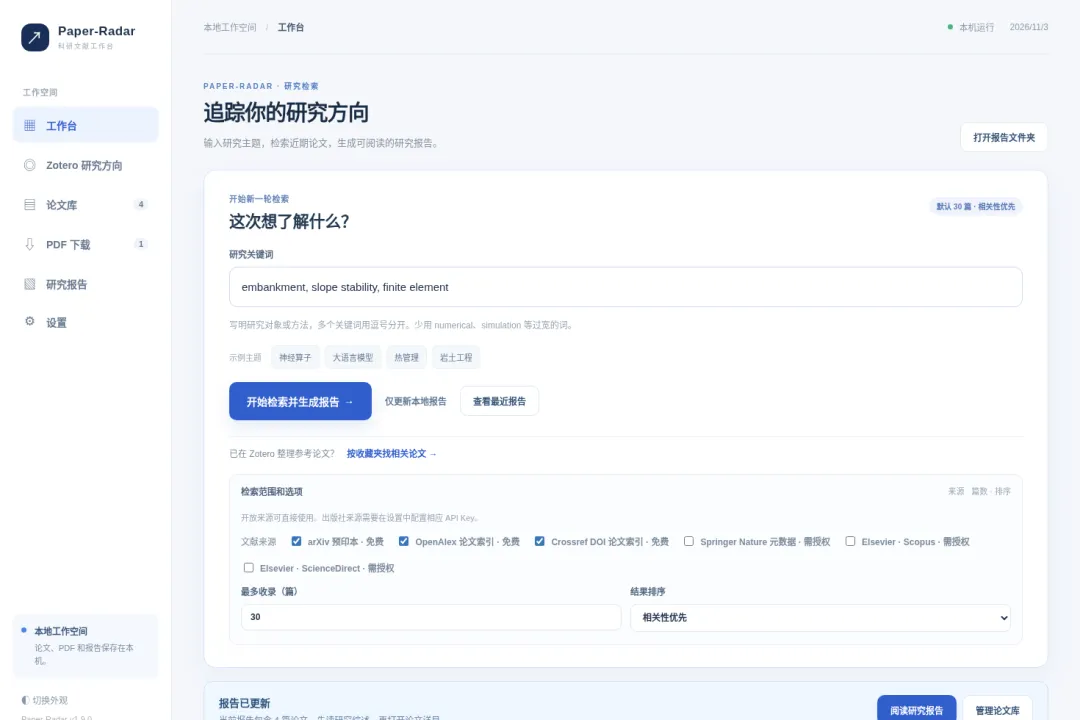
检索接口返回的发布日期有时不完整,也可能与所选时间窗口不一致。程序会对题录日期做基本检查,避免将未来日期或日期不完整的条目直接计入“最近 7 天”结果;相关性筛选也会降低 numerical、simulation 等宽泛词汇的影响。自动筛选仍可能遗漏研究内容相近、但使用不同术语的文章,因此重要调研建议结合人工检索复核。
利用 Zotero 中已有的资料确定检索主题
如果已经用 Zotero 积累了一批相关文献,可以直接从收藏夹提取关键词,减少重复设置。没有使用 Zotero 的读者可以跳过这一部分,按上一节的方法手动检索。
例如,已有一个“PINN 与偏微分方程反问题”收藏夹,收录了参数反演、方程约束和训练方法等方面的论文。Paper-Radar 可以参考这些文献的题名、摘要和标签,整理出用于后续检索的关键词。
先打开 Zotero,在 设置 → 高级 → 杂项 中勾选 允许此计算机上的其他应用程序与 Zotero 通讯。Windows 通常从“编辑 → 设置”进入,macOS 通常从“Zotero → 设置”进入。
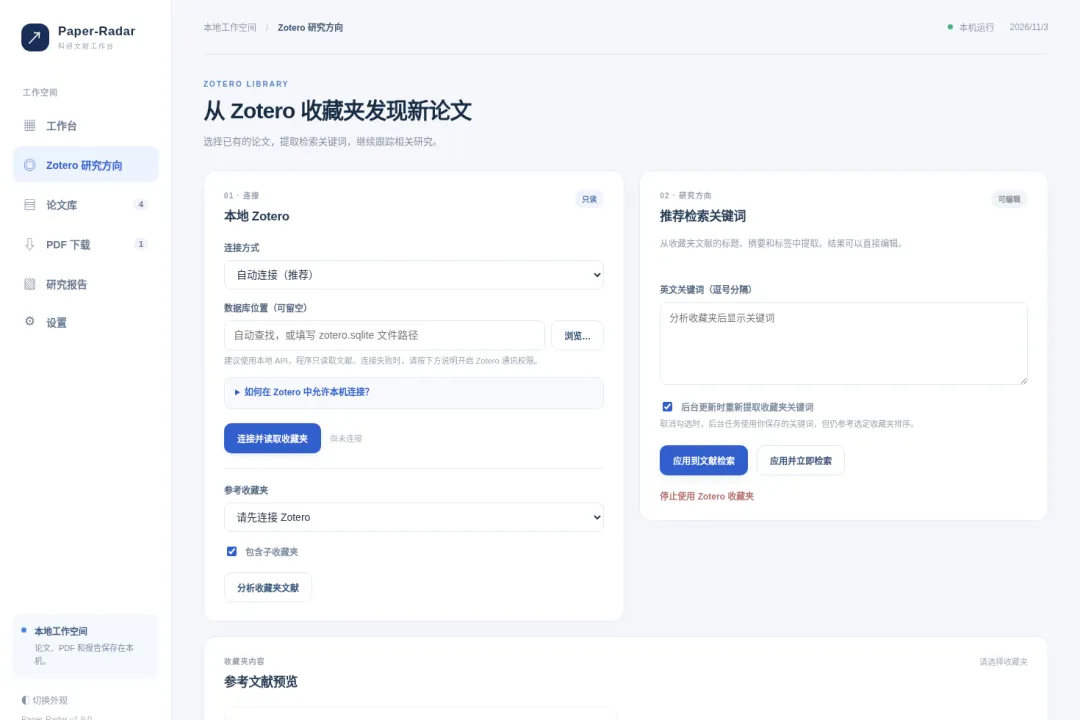
保持 Zotero 运行,进入 Paper-Radar 左侧的 Zotero 页面。连接方式选择“自动连接”,点击 连接并读取收藏夹,再选择需要跟进的收藏夹。如果资料分布在下级文件夹中,可以勾选“包含子收藏夹”。
接着点击 分析收藏夹文献。程序会生成一组英文关键词,并列出相关的参考文献,供使用者核对。以 PINN 为例,physics-informed neural networks 和 inverse problems 通常是需要保留的核心术语;model、learning 等宽泛词汇可根据实际结果删减。如果关注未知参数的反演,还可以补充 parameter identification 或具体物理过程的名称。
确认关键词后,点击 应用并立即检索。程序会按照修改后的关键词检索近期文献,并尝试根据 DOI 或标题识别 Zotero 中已经收藏的重复记录。关键词生成结果需要人工检查,尤其要注意同一术语在不同研究方向中的含义可能不同。
如果自动连接失败,可以先检查 Zotero 的本地通讯设置;也可以选择只读方式读取 zotero.sqlite。按照当前设计,这两种方式都不会修改原有的 Zotero 文献库。
管理检索结果和后续阅读记录
持续跟进一个方向时,检索结果会逐渐增多。仅保存题录或 PDF,后续仍要花时间重新筛选。因此,Paper-Radar 的论文库提供了分页展示、检索、分组和阅读状态管理功能。
可以按标题、作者、DOI 搜索条目,也可以筛选加星标或标记为“阅读中”的文献。需要按方向浏览时,可以根据关键词、学科、来源和年份分组,并折叠暂时不关注的类别。
每条记录默认显示简短摘要,需要时可以展开完整摘要。对于可能用于研究设计或工程方案比较的资料,我通常会先加星标,再根据阅读进度更新状态。这样即使当时没有下载全文,也可以保留后续需要核对的条目。
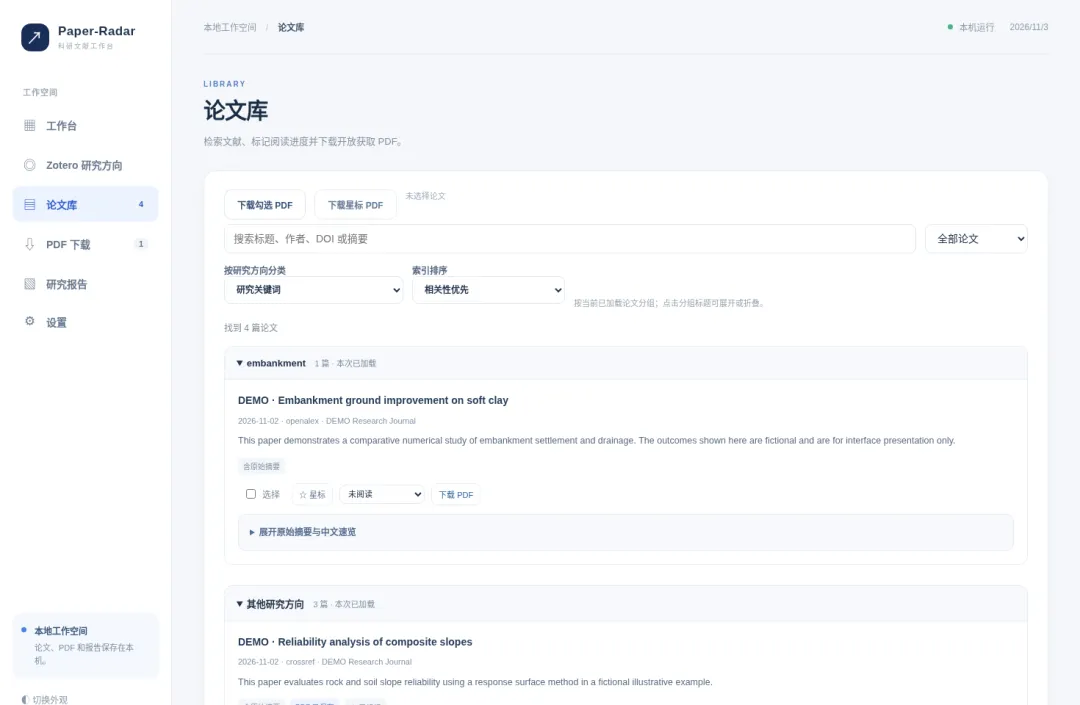
如果页面出现 下载 PDF 按钮,表示题录中存在可尝试访问的开放获取地址。支持单篇或批量下载,失败原因及重试入口会保留在“PDF 文件”页面。需要订阅权限的文献,仍应通过具有相应访问权限的出版社网站或图书馆获取。
将本次检索整理成研究进展报告
我在使用中更关注检索后的整理结果。逐条浏览题录可以了解大致范围,但要把这些材料用于选题、技术评估或团队讨论,还需要一份便于阅读和复核的报告。
每次检索完成后,程序会生成 reports/近期文献汇总.docx 和对应的 Markdown 文件,同时导出 CSV 题录索引。Word 适合批注和团队内部交流;Markdown 可以直接预览,也便于保存到个人知识库;CSV 可用于后续筛选和统计。
进入 研究报告 → 预览 Markdown,可以在页面中查看系统智能生成的本期综述、建议优先阅读的文献和逐篇条目,再决定是否下载 Word 文件。
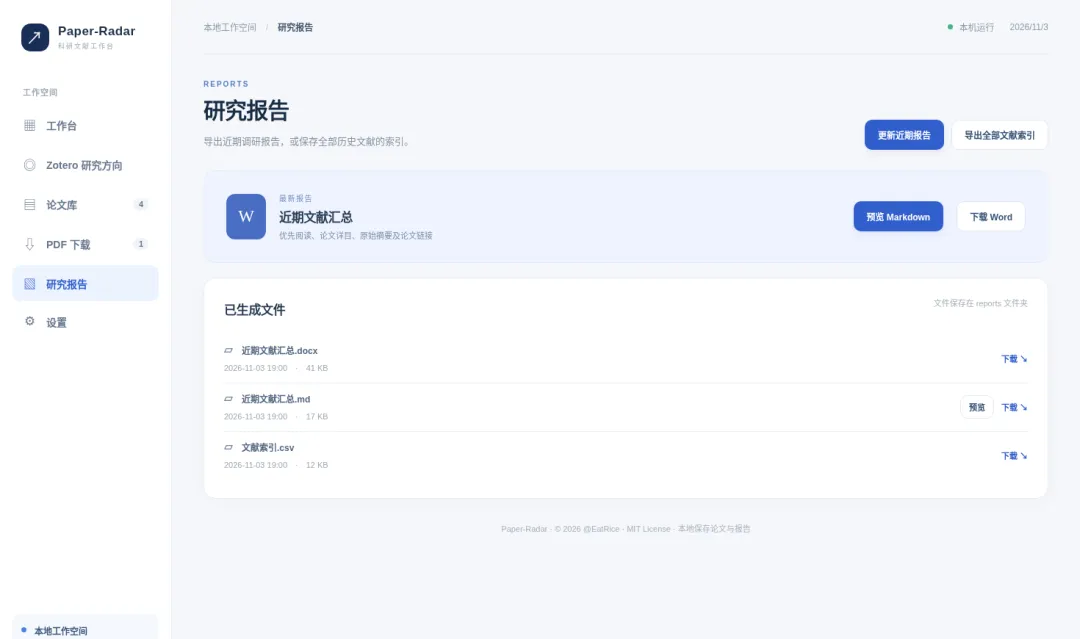 图6 研究报告页面:下载 Word、预览 Markdown。
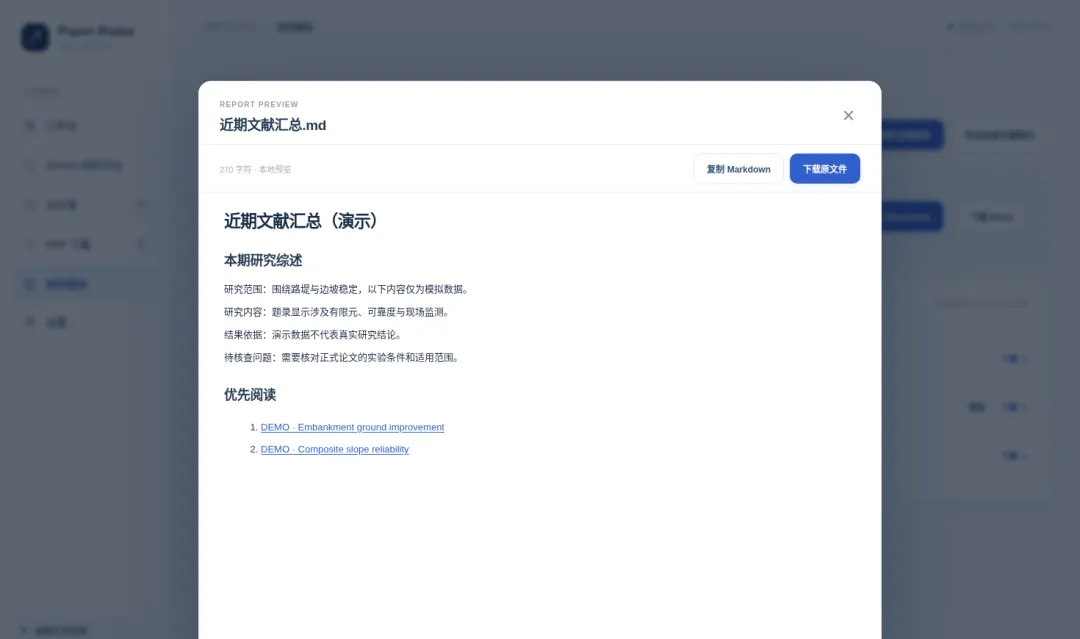
报告内容的准确性是我修改较多的部分。早期版本容易根据有限的摘要信息做进一步推断。例如,原摘要只写了“使用神经网络求解偏微分方程”,报告却可能将其归纳为“使用 PINN 进行参数反演”。这类扩展会影响后续判断。
现在生成报告时,会尽量依据题录和摘要中能够确认的信息,说明研究对象、采用的方法和作者报告的结果。摘要没有交代的实验条件、性能指标或技术细节,应当保留待核实的状态;缺少摘要的条目会标注为“仅题录”。
仍以 PINN 的参数识别为例。如果我想了解它能否用于设备传热过程中的未知参数反演,阅读报告时会重点核对:作者识别的是导热系数、换热系数还是其他参数;训练使用了哪些温度观测数据;偏微分方程、初始条件和边界条件如何参与建模;是否讨论了观测噪声、参数辨识精度,以及与常规反演方法的比较。
这些问题既涉及研究方法,也关系到工程应用条件。对于只讨论 PINN 训练稳定性、损失权重或一般 PDE 求解的文章,还要进一步判断它与参数识别任务的关联程度。如果摘要没有给出足够信息,就需要查看原文,不能直接据此认定某种方法已经适用于特定工程场景。
以上 PINN 案例用于说明报告的阅读和核对方法,不涉及一次实际检索的数量统计,也不代表对具体论文结论的验证。工具提供的是前期筛选和材料整理,技术路线选择、性能判断和工程适用性评估仍需要结合原文、实验与实际工况完成。
按需配置中文速览
基础检索、英文题录整理和 Word 报告导出不要求配置大模型。如果需要将英文摘要整理成中文速览,可以进入 设置 → 中文速览,开启云端模型并选择 DeepSeek。在 https://platform.deepseek.com/ 申请 API Key,填入后点击 保存并测试连接。模型服务可能按调用量收费,具体以服务商规则为准。
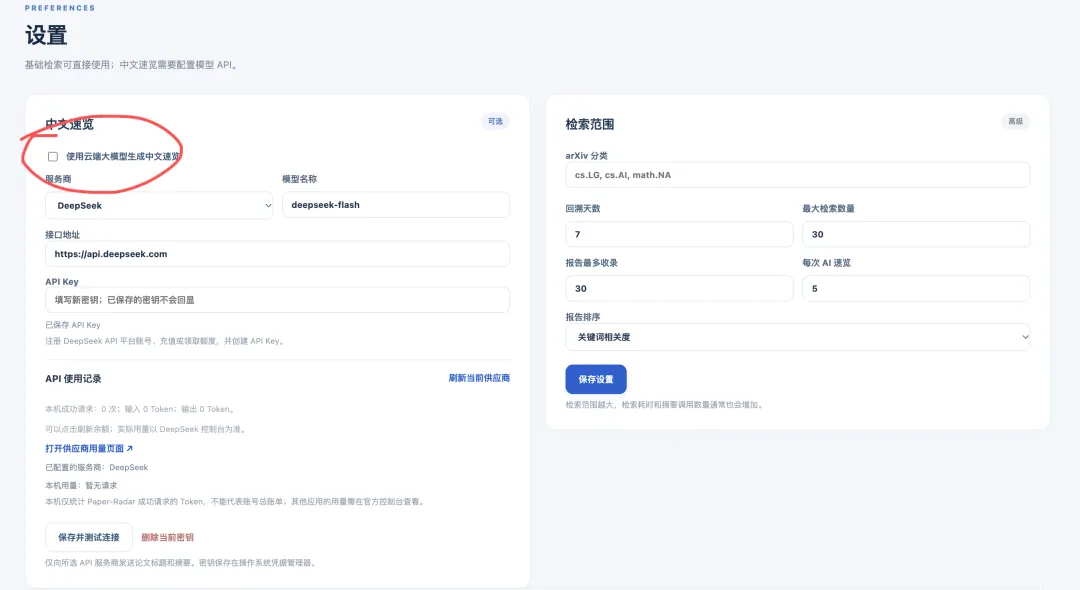
界面还提供豆包、OpenAI API、Claude、通义千问、智谱 GLM 和 Gemini 等服务商的配置入口。由于不同平台的模型 ID、接口地址和调用权限存在差异,建议先完成一个平台的连接测试,再根据需要调整。启用云端模型后,提交处理的文本会涉及第三方服务商,使用企业内部资料时应先确认相应的数据管理要求。
设置定期更新,持续积累资料
如果希望每天自动检查相关方向的新增文献,Windows 用户可以在工作台底部展开 每日自动更新,设定运行时间后点击 开启后台更新。程序会通过 Windows 计划任务启动独立检索进程,完成任务后退出。
设置完成后可以关闭浏览器,但电脑必须在计划执行时保持开机、联网,并具备相应的运行权限。生成的 Word、Markdown 和 CSV 文件仍保存在本地。如果某次更新未正常完成,可以到 设置 → 运行记录 查看手动任务或后台任务的日志。
Paper-Radar 目前已经能够把一次主题检索、结果整理和定期更新衔接起来。现有的大模型相关功能主要集中在文献筛选与内容整理上,检索本身不要求配置模型 API。后续我会继续完善主题管理、跨周期进展比较和相关性排序,重点提高长期使用时的检索准确性和资料可追溯性。学术检索接口的授权范围、不同 Zotero 文献库的兼容情况,以及定时任务在不同电脑上的运行表现,仍需要结合实际环境检查。
这个项目会继续更新,欢迎大家持续关注。在使用中遇到的问题,或者对本程序有具体建议,都可以在项目仓库反馈,或在公众号中留言。
项目地址:https://github.com/QiQiWan/Paper-Radar
2026年11月03日 第146期
图文:EatRicer
审核:EatRicer