ARTICLE · 1313000
我调了切片窗口和 top-k,文档还是查不全
窗口调大点就查全了
参数调了一圈
文档还是查不全
根因:那份文档一个空行都没有
项目实战AI笔记
一个字段都答不出来
专栏二 · 从零搭本地 RAG 第 7 篇(共 14 篇)
上一篇把检索侧的索引讲完了。这篇回到链路的更前面——块是怎么切出来的。
我上传了一份数据库设计文档,是 SQLark 从库里导出来的,纯文本。然后问:
biz_order_audit 表有哪些字段
回答是:
资料中没有相关信息
换了几个问法都不行。我把 askDebug 的命中片段打出来看,情况更奇怪:
表名能召回到,但片段里字段只剩三四个,剩下的不见了,片段里还混着另外两张表的内容。
也就是说,模型不是没看到这张表,是看到的这张表是残的。
这时候第一反应很自然:参数没调对。
第一轮:我把能调的都调了
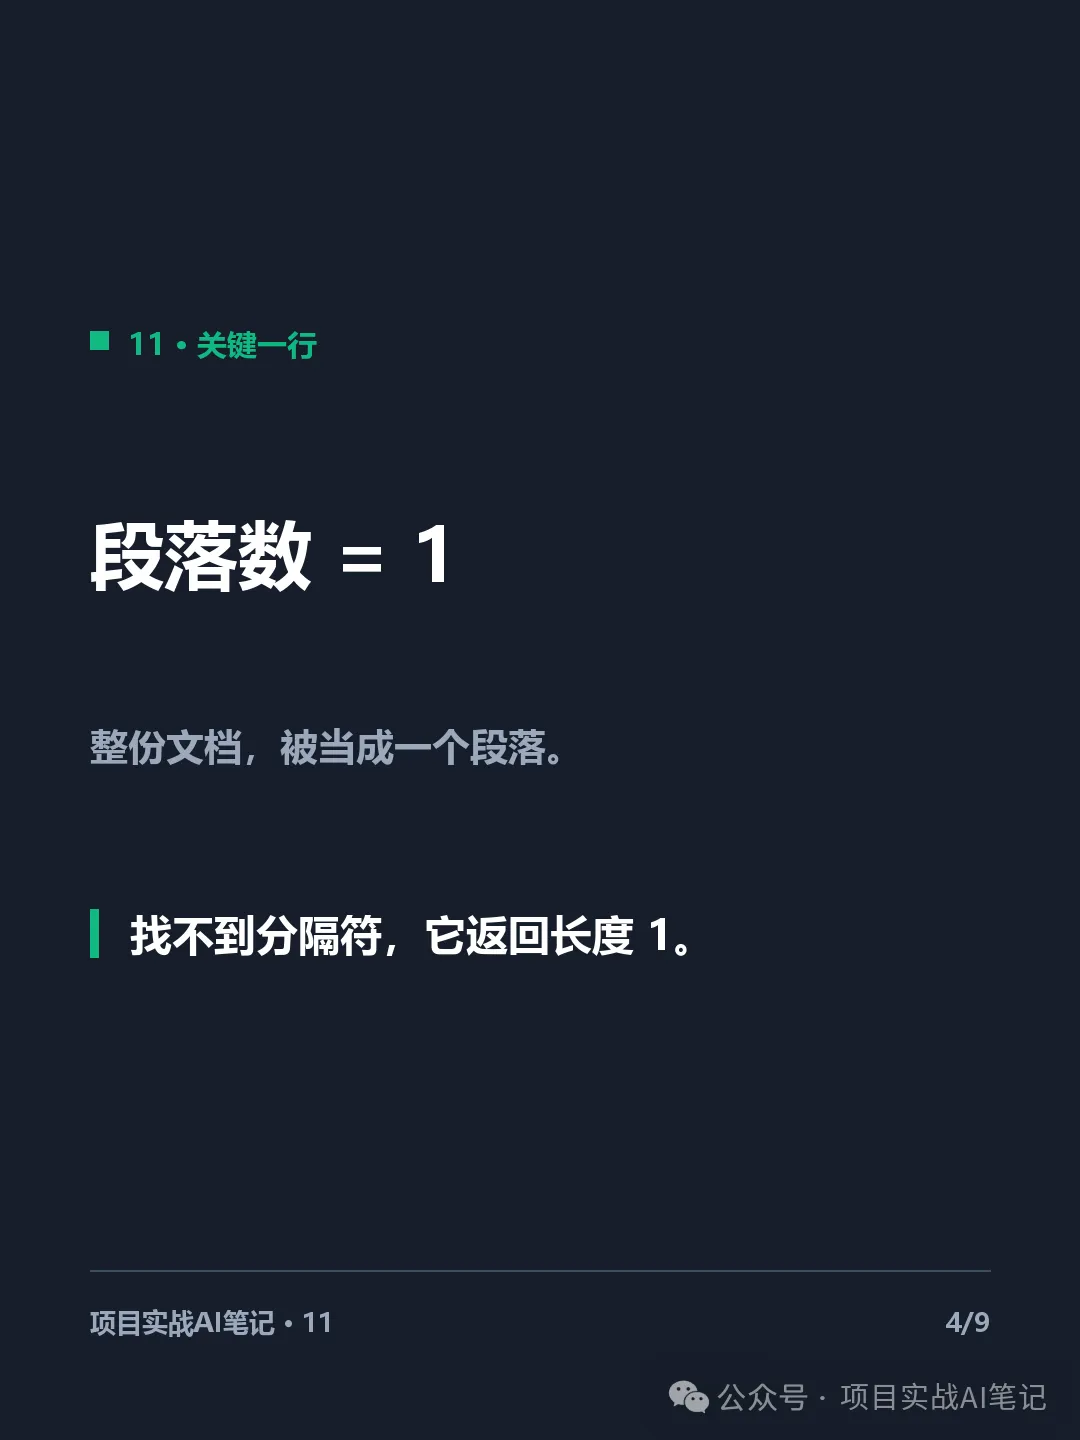
当时链路上的可调项就三个,我全动了:
2.1 切片从「硬切」改成「段落优先」
第一条是重点。原来的 split() 就是最土的那种:按字符数一段段剁。改成段落优先后变成四步:
private List<String> split(String text, int window, int overlap) {
List<String> result = new ArrayList<>();
if (text == null || text.isEmpty()) return result;
// 1) 按空行切段落:\n\n,或中间夹空白的空行
String[] paragraphs = text.split("\\n\\s*\\n");
// 2) 贪心合并:装满窗口就开新块,新块以上一块的尾部开头
List<String> merged = new ArrayList<>();
StringBuilder current = new StringBuilder();
for (String p : paragraphs) {
String para = p.strip();
if (para.isEmpty()) continue;
if (current.length() > 0 && current.length() + 1 + para.length() > window) {
merged.add(current.toString());
String tail = current.length() > overlap
? current.substring(current.length() - overlap)
: current.toString();
current = new StringBuilder(tail); // 重叠靠这里
}
if (current.length() > 0) current.append('\n');
current.append(para);
}
if (current.length() > 0) merged.add(current.toString());
// 3) 兜底:单段本身超窗口(比如一张超大的表),才退回字符硬切
for (String chunk : merged) {
if (chunk.length() <= window) result.add(chunk);
else result.addAll(hardSplit(chunk, window, overlap));
}
return result;
}
配套把两个写死的数字提到了配置文件:
rag.chunk-window=1200
rag.chunk-overlap=200
原来的 500 / 80 是写死在 ingest() 调用里的。
想法很朴素:文档里一张表天然是一段,按段切,表名和字段就该落在同一个块里。 窗口比原来大一倍多,一张表的字段怎么也该装下了。
2.2 top-k 从 3 调到 8
理由也简单:3 个块太少。一张表要是被切到两块里,3 个名额里只要有一块是别的表,答案就凑不齐。
2.3 Prompt 也松了
原来是「只能依据参考资料作答,没有就明确说没有」——措辞太保守,模型看到残缺的片段,宁可拒答也不肯把看到的拼一下。
改成领域专用的版本:允许从上下文提取整理,问字段时按 字段名 | 类型 | 注释 输出表格,只有确实完全不包含才说没有。
这个提示词后来在做多知识库改造时又改回了领域无关的默认版本。现在的默认提示词第 1、4 条还是当时那个严格口径,因为要给任意知识库用,不能写死「数据库设计」。
2.4 结果
还是查不全。
具体说:偶尔能凑出七八个字段,但从来凑不齐;问另外几张表,答得倒是挺全。
这就不是「参数不够大」的样子了。参数是均匀作用于所有块的,一张表答得全、另一张答不全,说明问题出在这两张表被切出来的样子不一样。
把文档本身打印出来看
到这一步我才去做一件早该做的事:看看切之前,这份文档到底长什么样。
加了一行临时代码,打印第一次切段的长度:
String[] paragraphs = text.split("\\n\\s*\\n");
System.out.println("段落数 = " + paragraphs.length);
输出是:
段落数 = 1
一。整份文档,一个段落。
这里有个 Java 的坑值得单独说一句:String.split() 在找不到分隔符时,返回的是长度为 1 的数组,不是空数组。
"abc".split(",") // → ["abc"],length = 1
"a\nb\nc".split("\\n\\n") // → ["a\nb\nc"],length = 1
所以「段落切分」这一步看起来一切正常——它没抛异常、没返回空、老老实实返回了一个段落。只是这个段落是整篇文档。
if (paragraphs.length == 0) return fallback() 这种防御写法也拦不住,因为长度是 1。
那份文档长什么样
SQLark 导出的是这样的:
2.1.2.3 表:biz_order_audit
字段名 | 类型 | 注释
order_id | VARCHAR(64) | 订单ID
status | VARCHAR(20) | 状态
...
2.1.2.4 表:biz_order_item
(下一张表紧挨着,中间没有空行)
整篇只有单个换行 \n,一个空行 \n\n 都没有。
在编辑器里看,它是一行一行的,看起来很有结构。但抽成纯文本之后,结构只剩换行符,而我的段落切分器找的是空行。
文档看着有层次,机器眼里是一片平地
换个说法:它的结构对人是可见的,对正则不是
为什么「段落优先」完全没生效
把三处改动按执行顺序走一遍,就明白为什么调什么都没用了:
也就是说:我写的「段落优先」,在这份文档上一次都没跑起来。每一块都是第 3 步的 hardSplit 产出的——和改之前那个固定窗口硬切,是同一套逻辑,只是窗口从 500 变成了 1200。
这点特别讽刺:我把主路径改得很讲究,还加了重叠、加了配置项,结果兜底路径悄悄接管了全部工作,而且不报错、不告警。
跟 Java 里那种 try { 精细逻辑 } catch (Exception e) { return 粗暴降级(); } 一模一样——降级分支把主逻辑全吃了,日志里一行都没有。
一张表是怎么被切散的
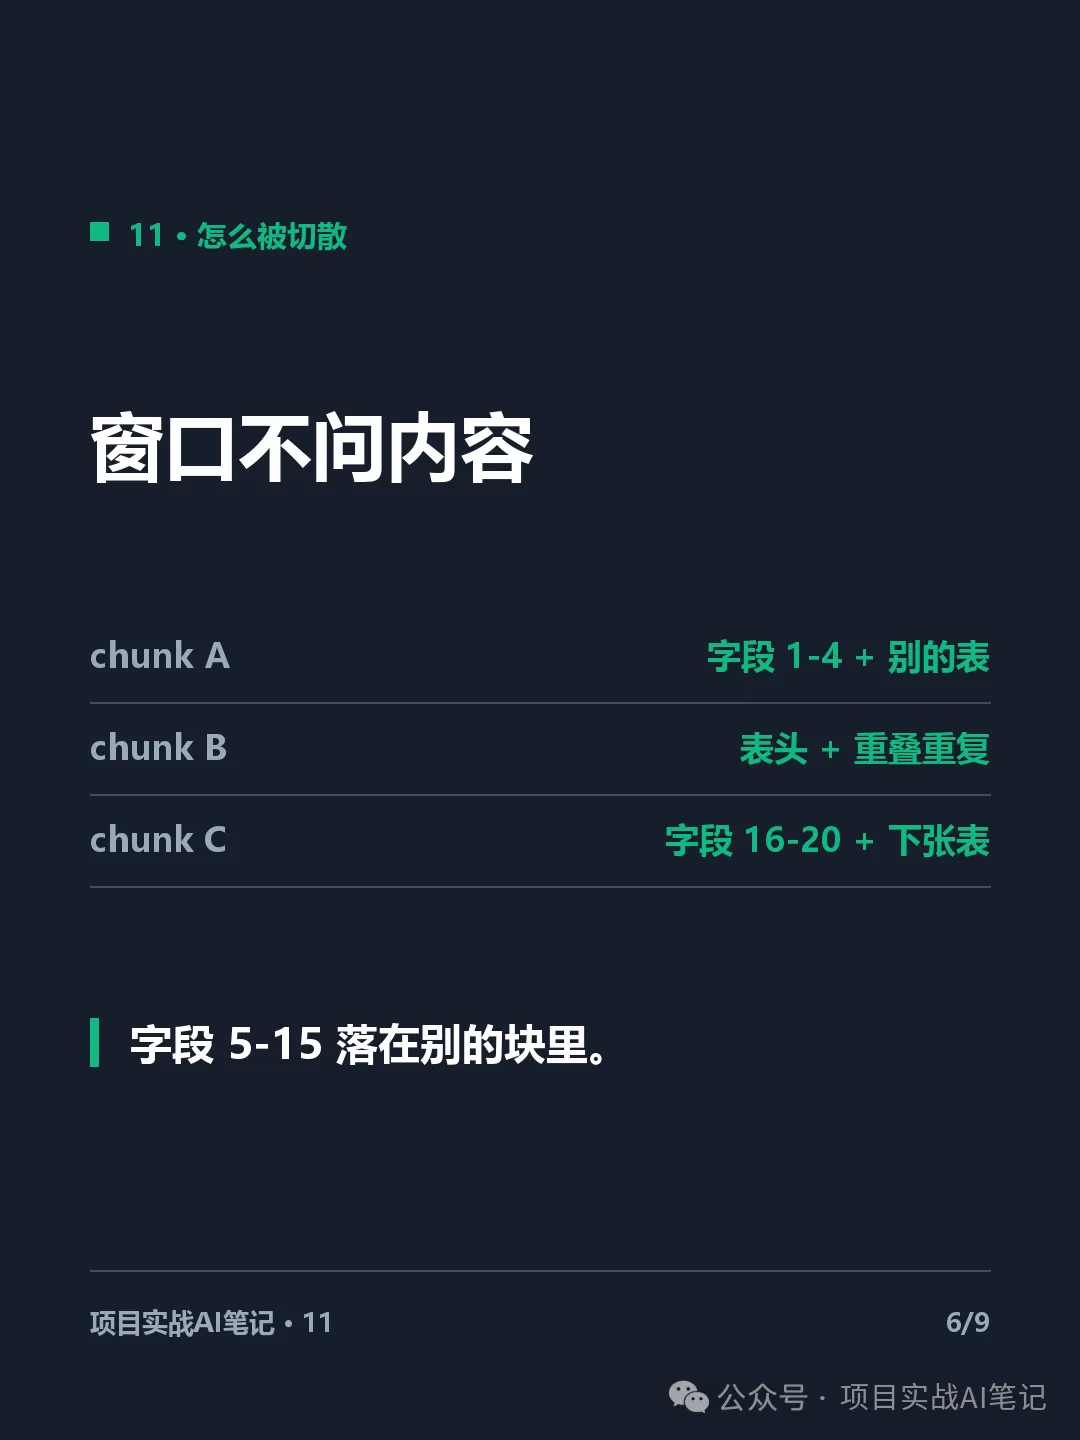
窗口 1200 按字符滑,不问内容。结果:
biz_order_audit 一共 20 个字段,5–15 这一段落在别的块里。
召回时每路取 20、融合后进 prompt 8 条。问「这张表有哪些字段」,向量路最像的是 A、B、C 这几块——它们的共同点是都含这张表的名字,也共同点是都不完整。
模型拿到的是三段残缺、还各自混着别的表的内容。它按 Prompt 的严格口径回一句「资料中没有相关信息」,其实是诚实。
问题不在取几条,在每条里有什么
top-k 调大,只是让模型多看几块碎片
召回得再多,也不会凭空把 5–15 拼回来。用 SQL 类比就是:WHERE 选错了行,把 LIMIT 从 3 调到 8 救不了。
根治方向:按「表标题」切
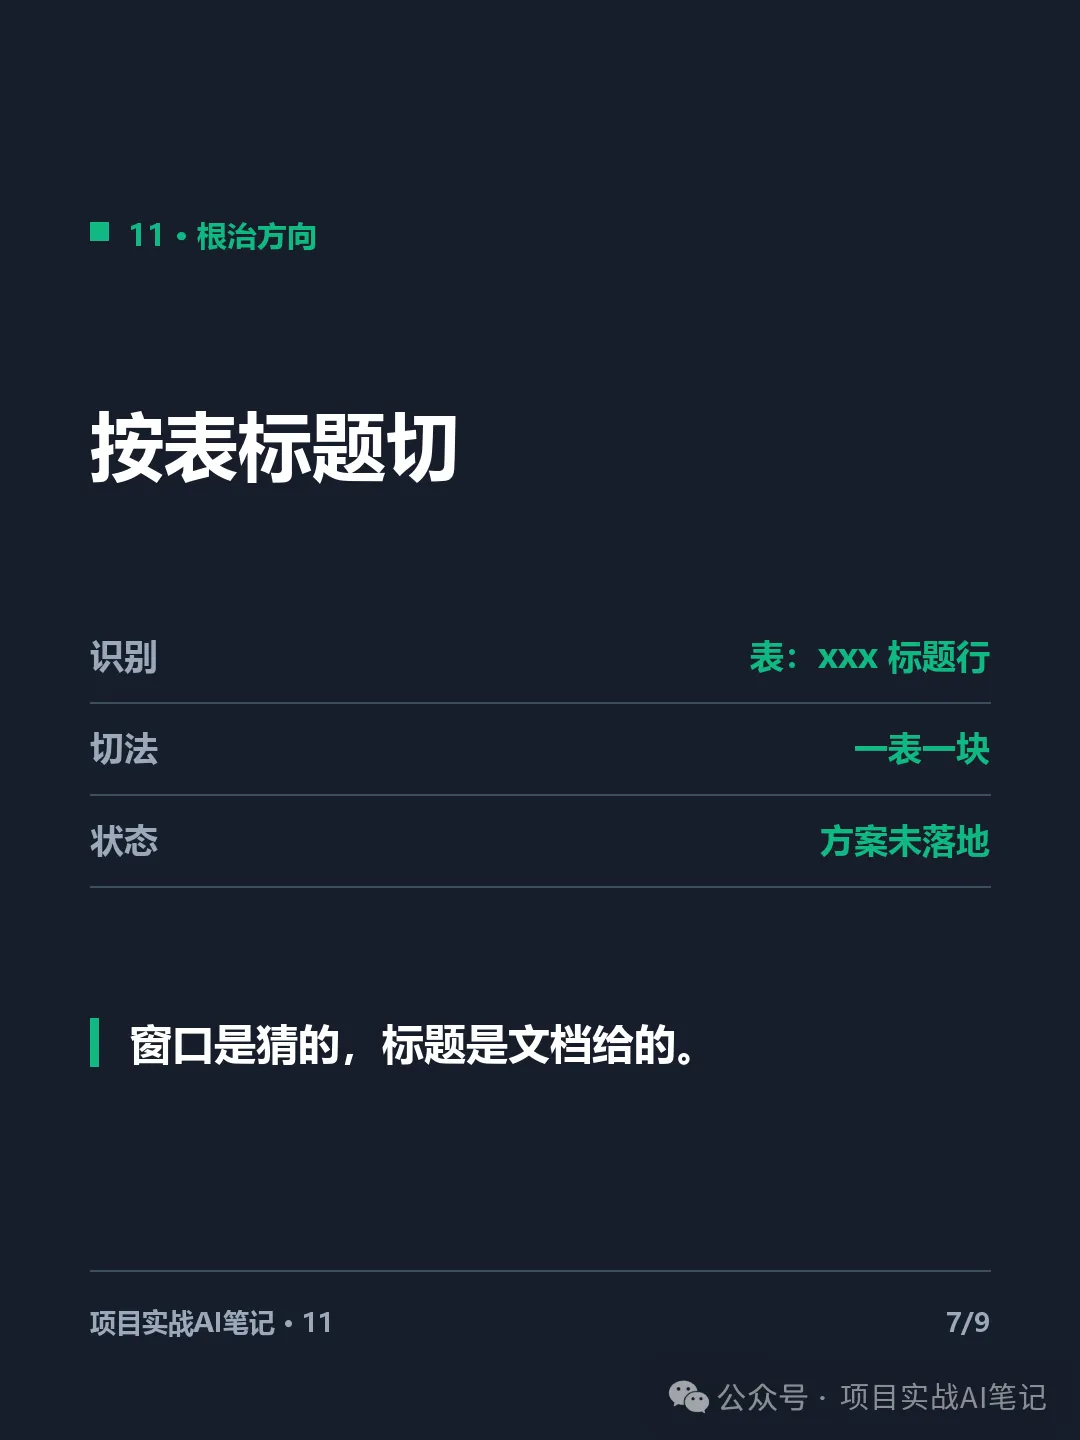
根因清楚了,方案也就直白:这份文档有自己的一套结构标记,只是它不是空行,是标题行。
2.1.2.3 表:biz_order_audit
那就按这个切。用正则找标题行,一张表一个 chunk:
// 形如:2.1.2.3 表:biz_order_audit
private static final Pattern TABLE_HEAD =
Pattern.compile("^\\s*\\d+(\\.\\d+)*\\s*表[::]\\s*(\\S+)\\s*$",
Pattern.MULTILINE);
大意是:行首数字编号 → 可选的多级 .数字 → 表字加冒号 → 表名 → 行尾。
配套要做三件事,缺一个都不算切对:
这一段是方案,不是已完成。当前代码里还是 1200 字滑动窗口,split() 里没有这个正则。写在这里是因为它比再调大窗口更有价值:窗口是猜的,标题是文档自己给的。
看看别人怎么切
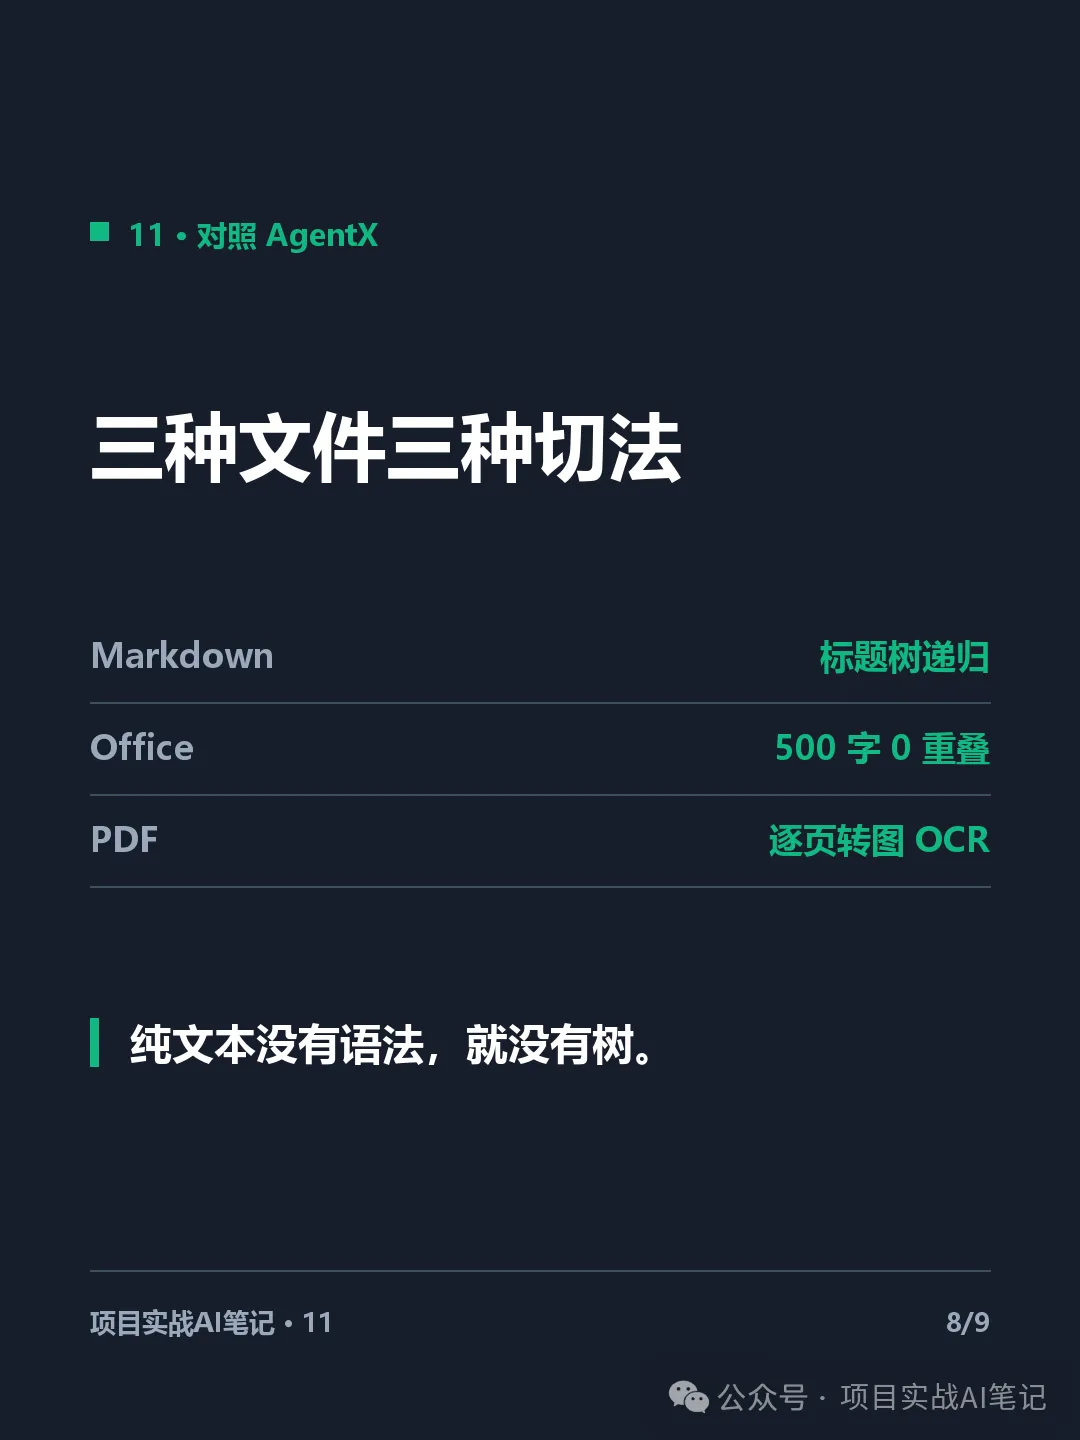
写这篇的时候我去翻了 AgentX 的切片实现,它按文件类型分流:
两个观察。
第一,它的强项正好是我这份文档的短板。 我这份是 SQLark 导出的纯文本,走它那条 500 字 0 重叠的路径,比我现在还差——连 200 字重叠都没有。
第二,它的强项有前提。 标题树切分能work,是因为 Markdown 有 # 这种显式语法。纯文本没有语法,就没有树可建。
所以最省力的路径其实是绕开这个问题:让 SQLark 导出 Markdown。
表标题就成了标准的 ###,直接能吃标题树切分,一行切片代码都不用写。
如果导不出来,就在 split() 里加那个正则——轻量版的结构感知切分,几十行代码的事。
结论:先看文档长什么样
这件事我复盘了很久,因为被坑的地方不在技术难度,在顺序。
我拿到「查不全」,第一反应是调参数。参数是整条链路上最显眼、最容易动的东西,改一个数字重启一下,看起来像在推进。
但真正该先做的是看一眼输入:
先看清你的文档长什么样,再谈切片策略
具体三个动作,一分钟能做完:
# 1. 有没有空行(段落切分能不能用)
grep -c '^$' 文档.txt
# 2. 有没有标题行(能不能按结构切)
grep -cE '^\s*[0-9]+(\.[0-9]+)*\s*表[::]' 文档.txt
# 3. 总行数 / 总字符,估一下会被切成几块
wc -l -m 文档.txt
第 1 条是 0、第 2 条是几百——那这份文档就该按标题切,不该按空行切。这不是调参能解决的问题,是切法选错了。
再补一条判据,是这次之后我给自己加的:
看召回结果时,别只问「它召回了什么」,要问「它该有的东西,有没有整块进来」。
我一开始看到「表名召回到了」就以为检索是对的。其实表名对、内容残,比完全没召回更难查——因为它看起来像在工作。
附 · 一份整理好的完整资料
切片这一章,资料包里写得比这篇细
这篇只讲了「为什么段落优先没生效」。而入库那六步、混合检索那条 SQL、Rerank 为什么一直没接、MCP 工具的权限怎么收——都写在里头。
这份 《Java 后端做本地 RAG · 项目完整技术资料》(Word 版,12 章,7 张自绘图),不是概览,是能当手册查的:
7 张图都是自己画的:分层架构、代码模块全景、数据模型 ER、入库六步、检索链路对比(单路 vs 混合双路 + RRF)、多 Agent 编排、安全七道关。
踩过的坑一条没删。到现在还没做的那几件事,文中也都如实标了出来——哪项是「方案已定、还没落地」,哪项是「完全没动」,都标了。
关注公众号「项目实战AI笔记」,私聊发送「资料包」,直接发你。
下期预告
一行 min-score=0.3,让我的 RAG 全线拒答
这个配置项注入了 Spring 字段,但整条问答链路从头到尾没读过它——纯死代码。一旦有人好心把它接上,每个问题都会答「资料中没有相关信息」。
我是AI民工,一个写了多年 Java 的后端。
后面继续写 Java 老兵做 Agent ——真实踩坑,不讲概念只讲根因。
如果觉得这篇有用,欢迎转发给正在调 RAG 切片参数的同学——他大概率也在调窗口大小。