ARTICLE · 1317377
我用 AI 做了3个 MCP 工具,终于搞明白它到底能干什么
最近,做了3个和MCP相关的产品,都是自己工作上用的。
有一点心得,想和你分享一下,这篇内容比较长,大概4000多字,但是都是我这几个月经验的浓缩。
其中有一个工程MCP知识库,已经开源给社群的兄弟们了。
看到对大家有用,倍感欣慰。
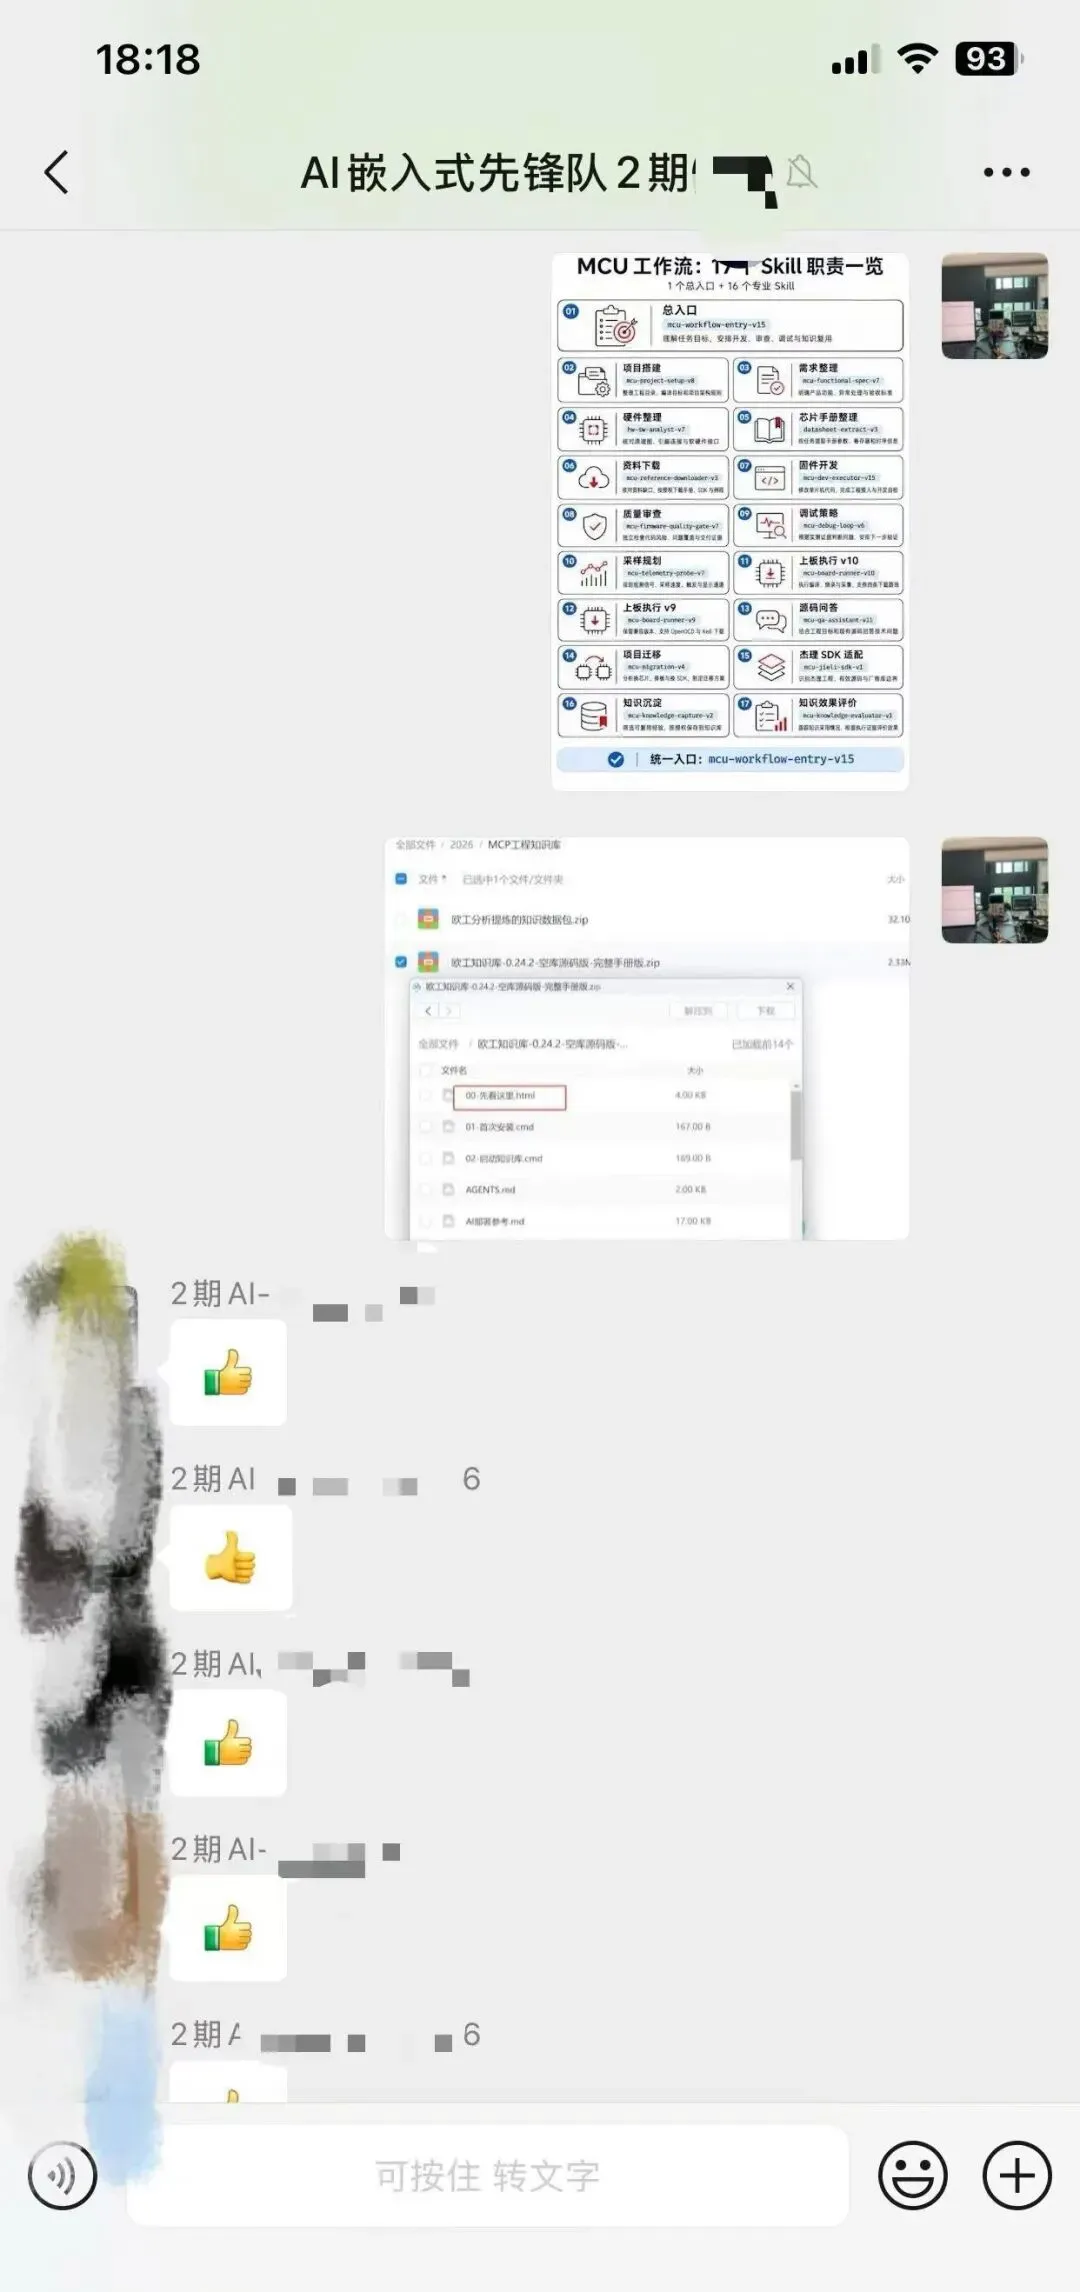
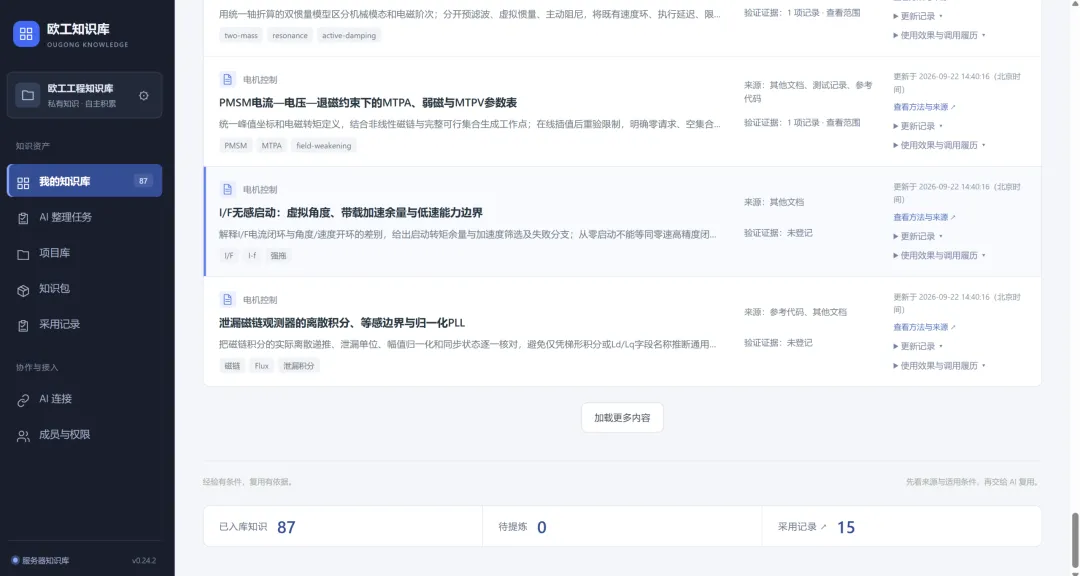
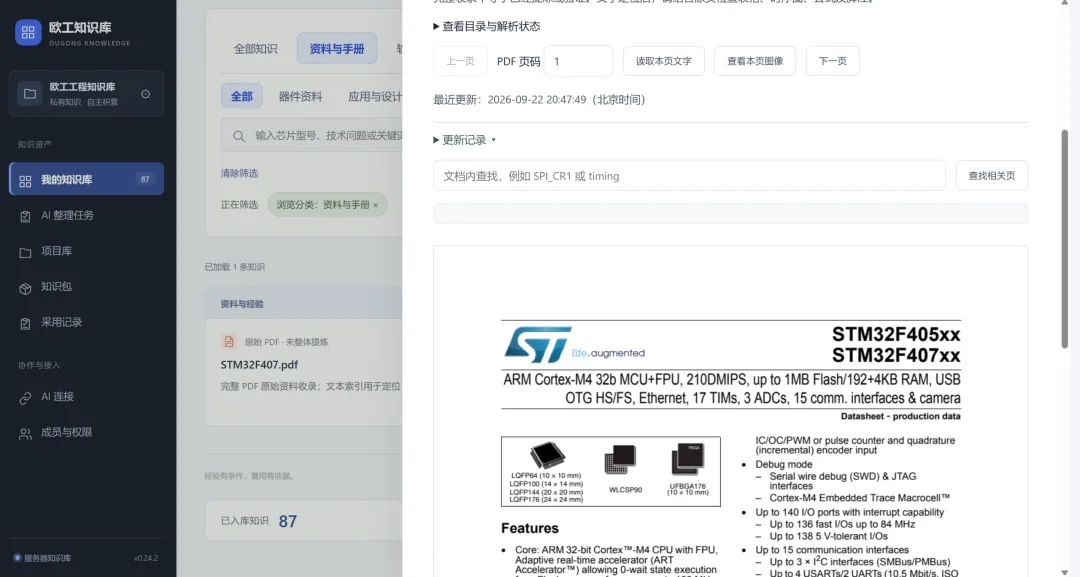
这个知识库可以保存芯片资料、参考代码、历史工程经验、以及做过的完整项目整个都可以丢进去。
下面展示一下界面:
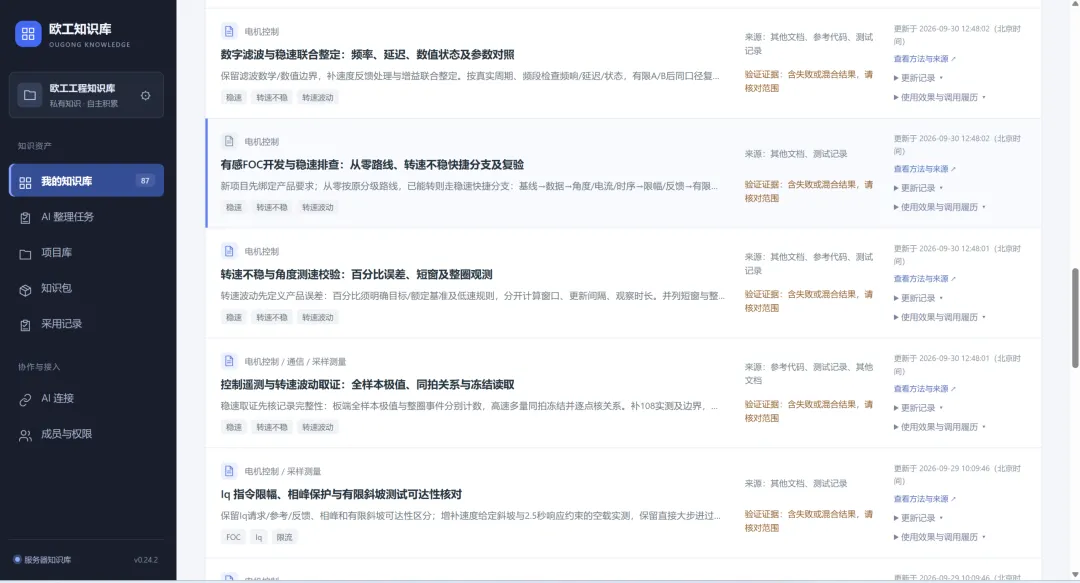
然后就可以通过任意AI Agent接入知识库,这个对我来说已经没有悬念了,因为我一直在这么用。
我更想试试如何在手机,通过AI工具,去连接我的MCP知识库。
然后豆包,deepseek之类的搞了一圈,发现他们的手机APP都不支持接入MCP。
最后我发现Chatgpt可以,然后就开始愉快的玩耍。
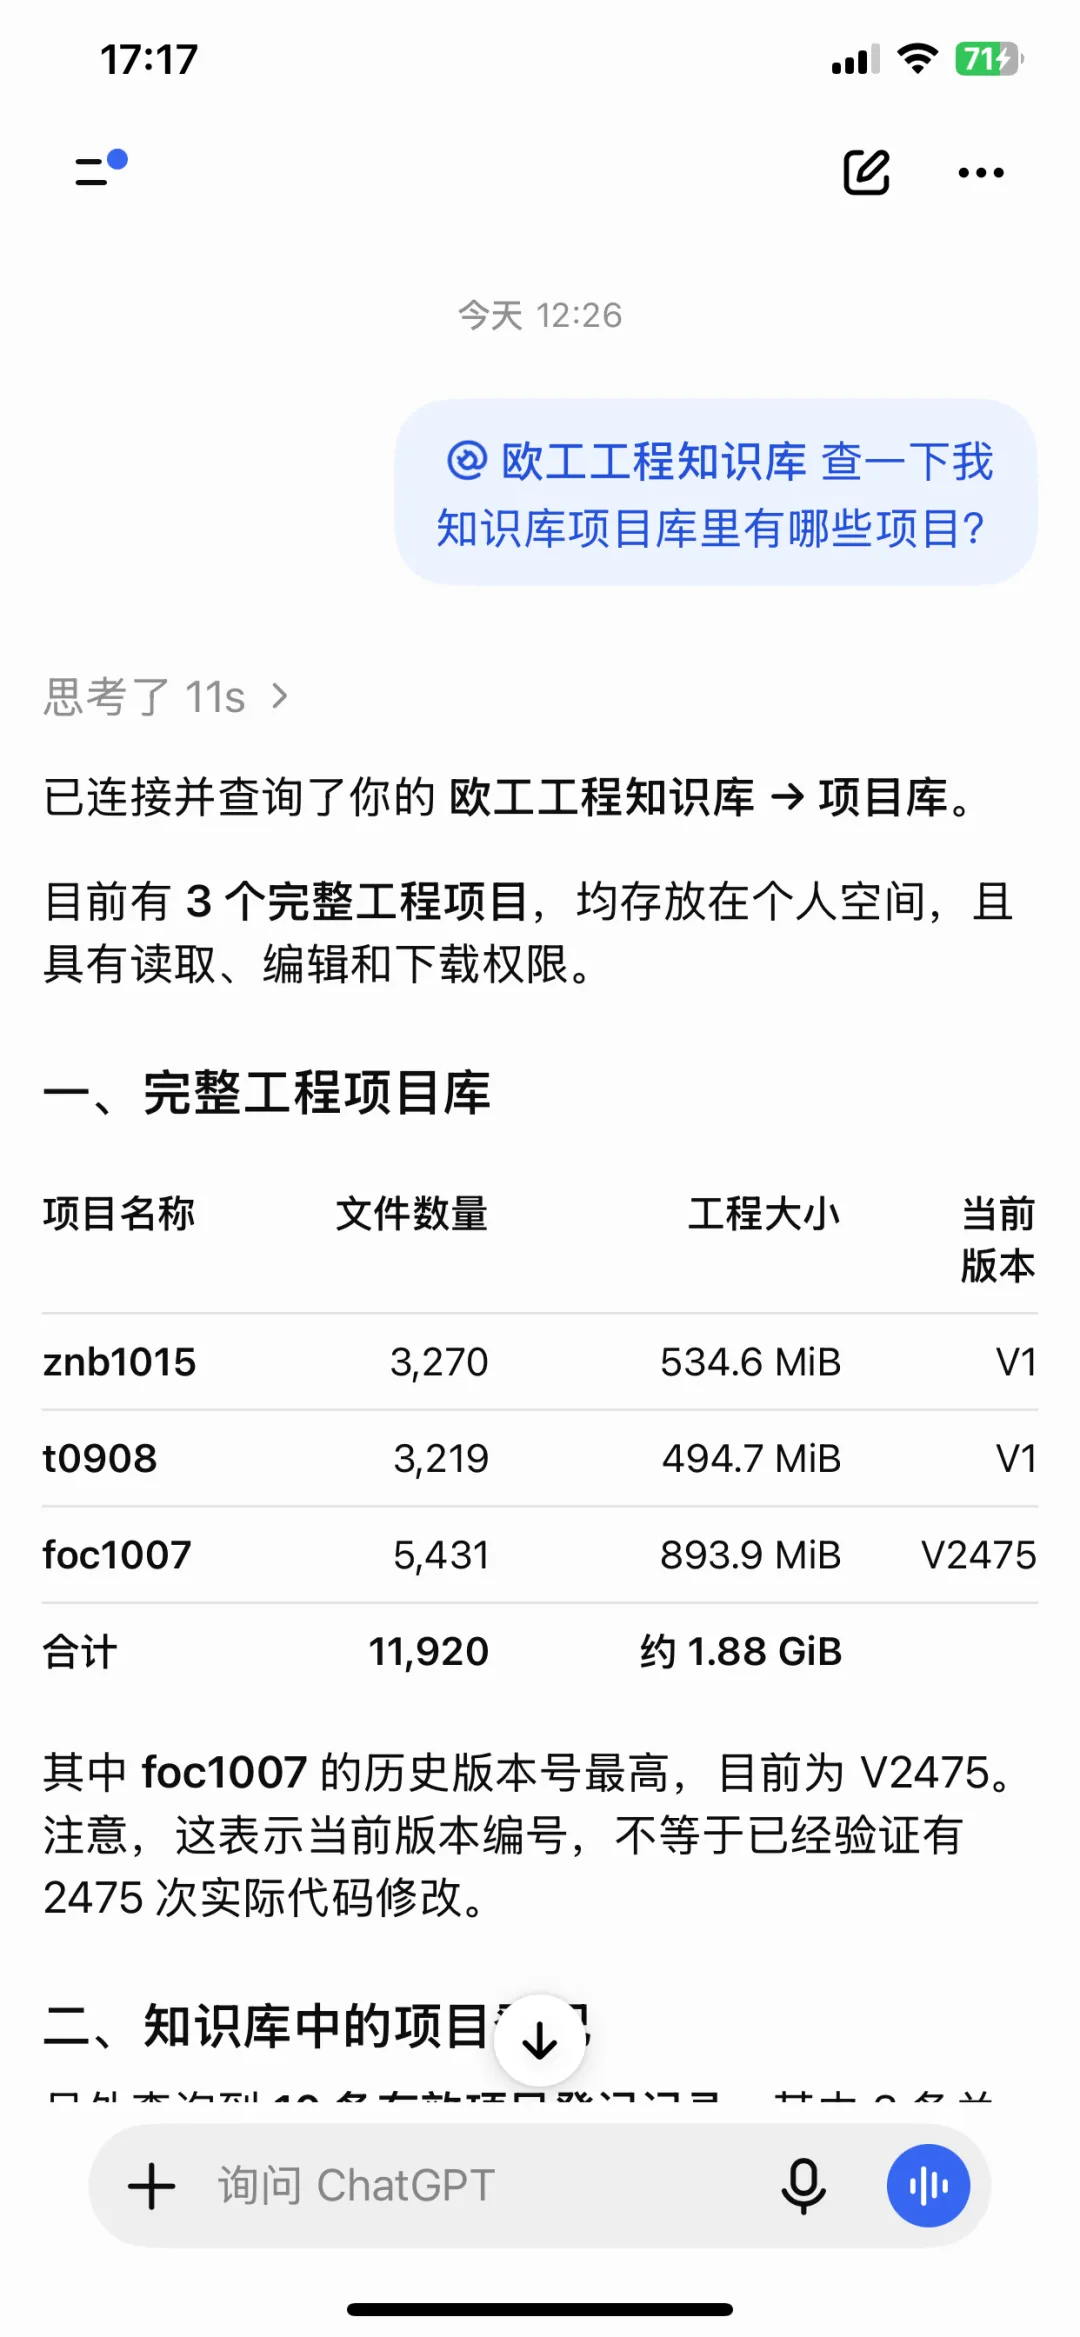
比如我在手机上查知识库里面有哪些项目?
对应知识库的后台管理端。
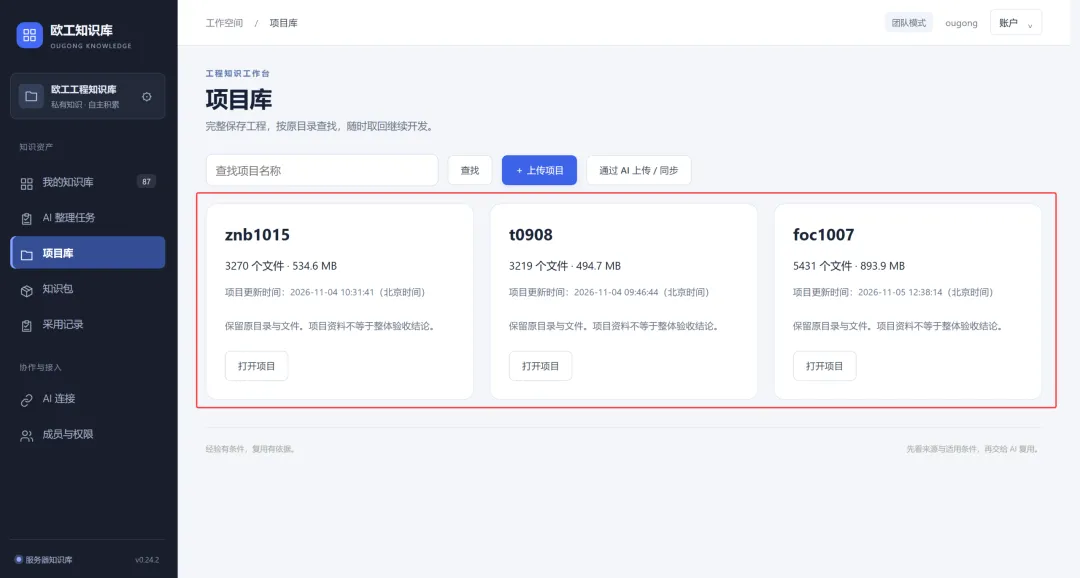
这样就能在手机上快速查询某个项目功能、硬件接口、代码等信息。
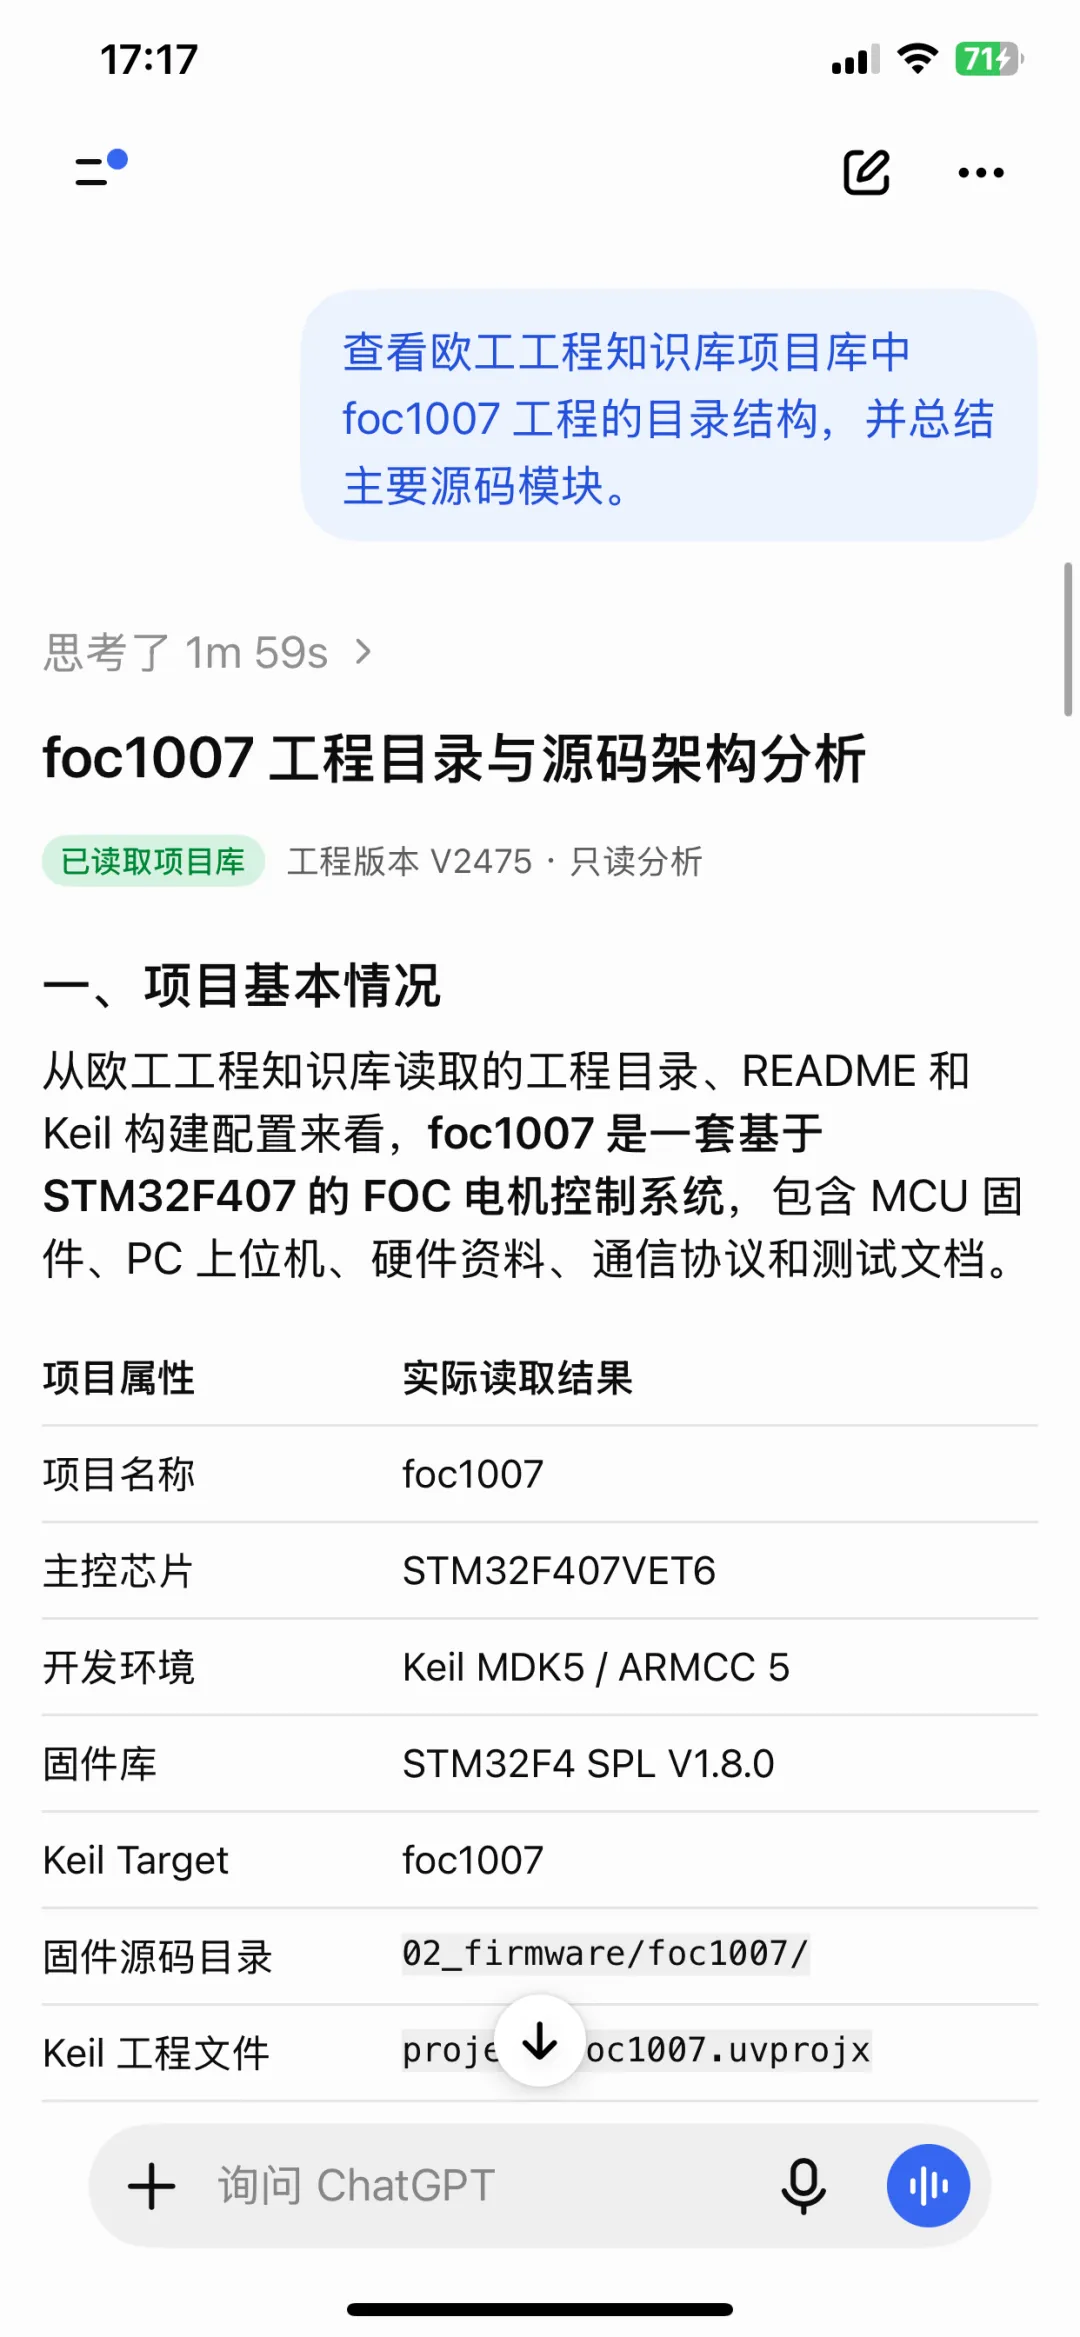
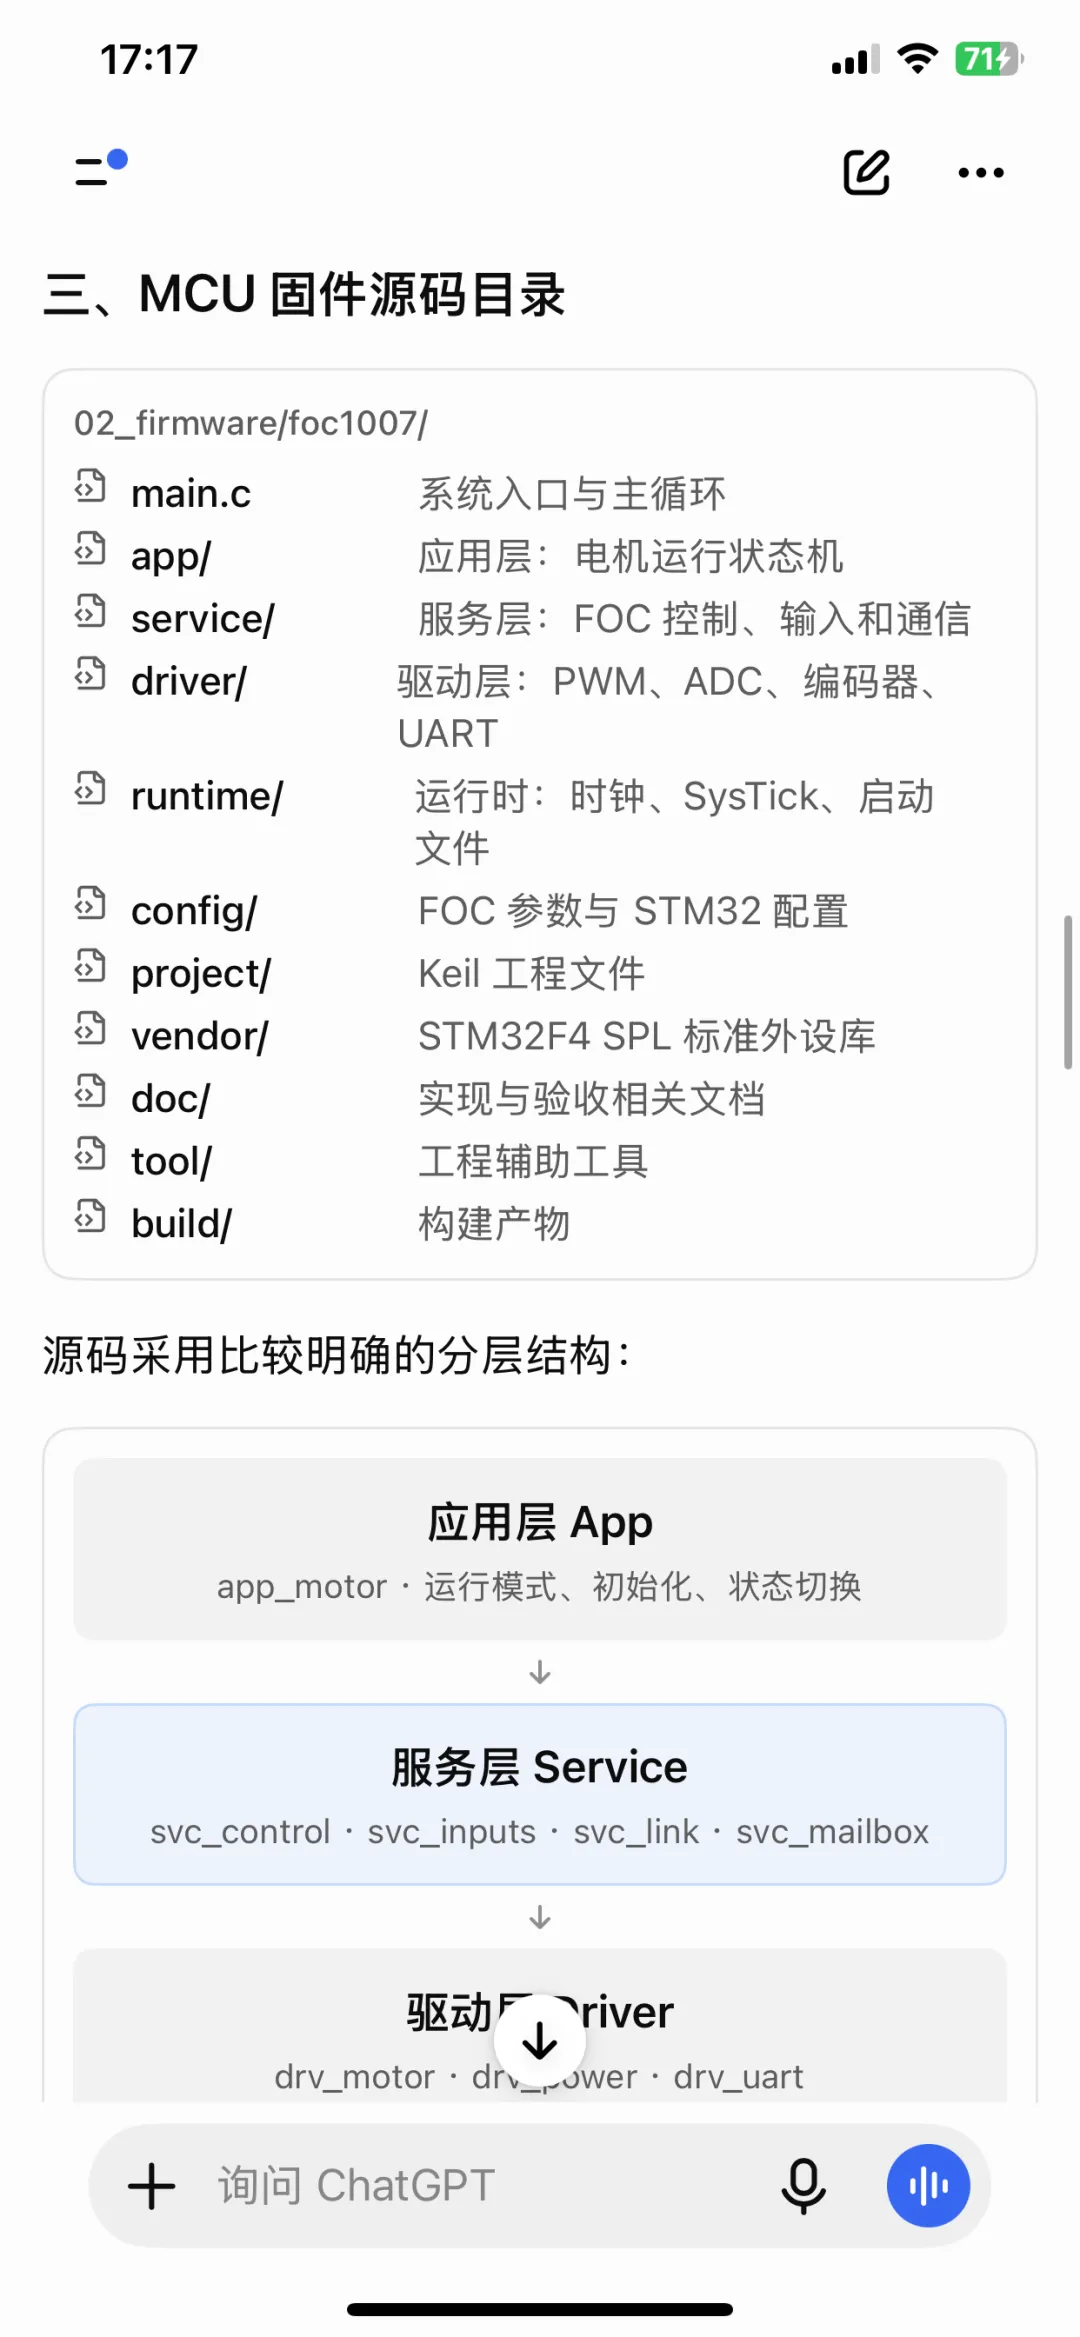
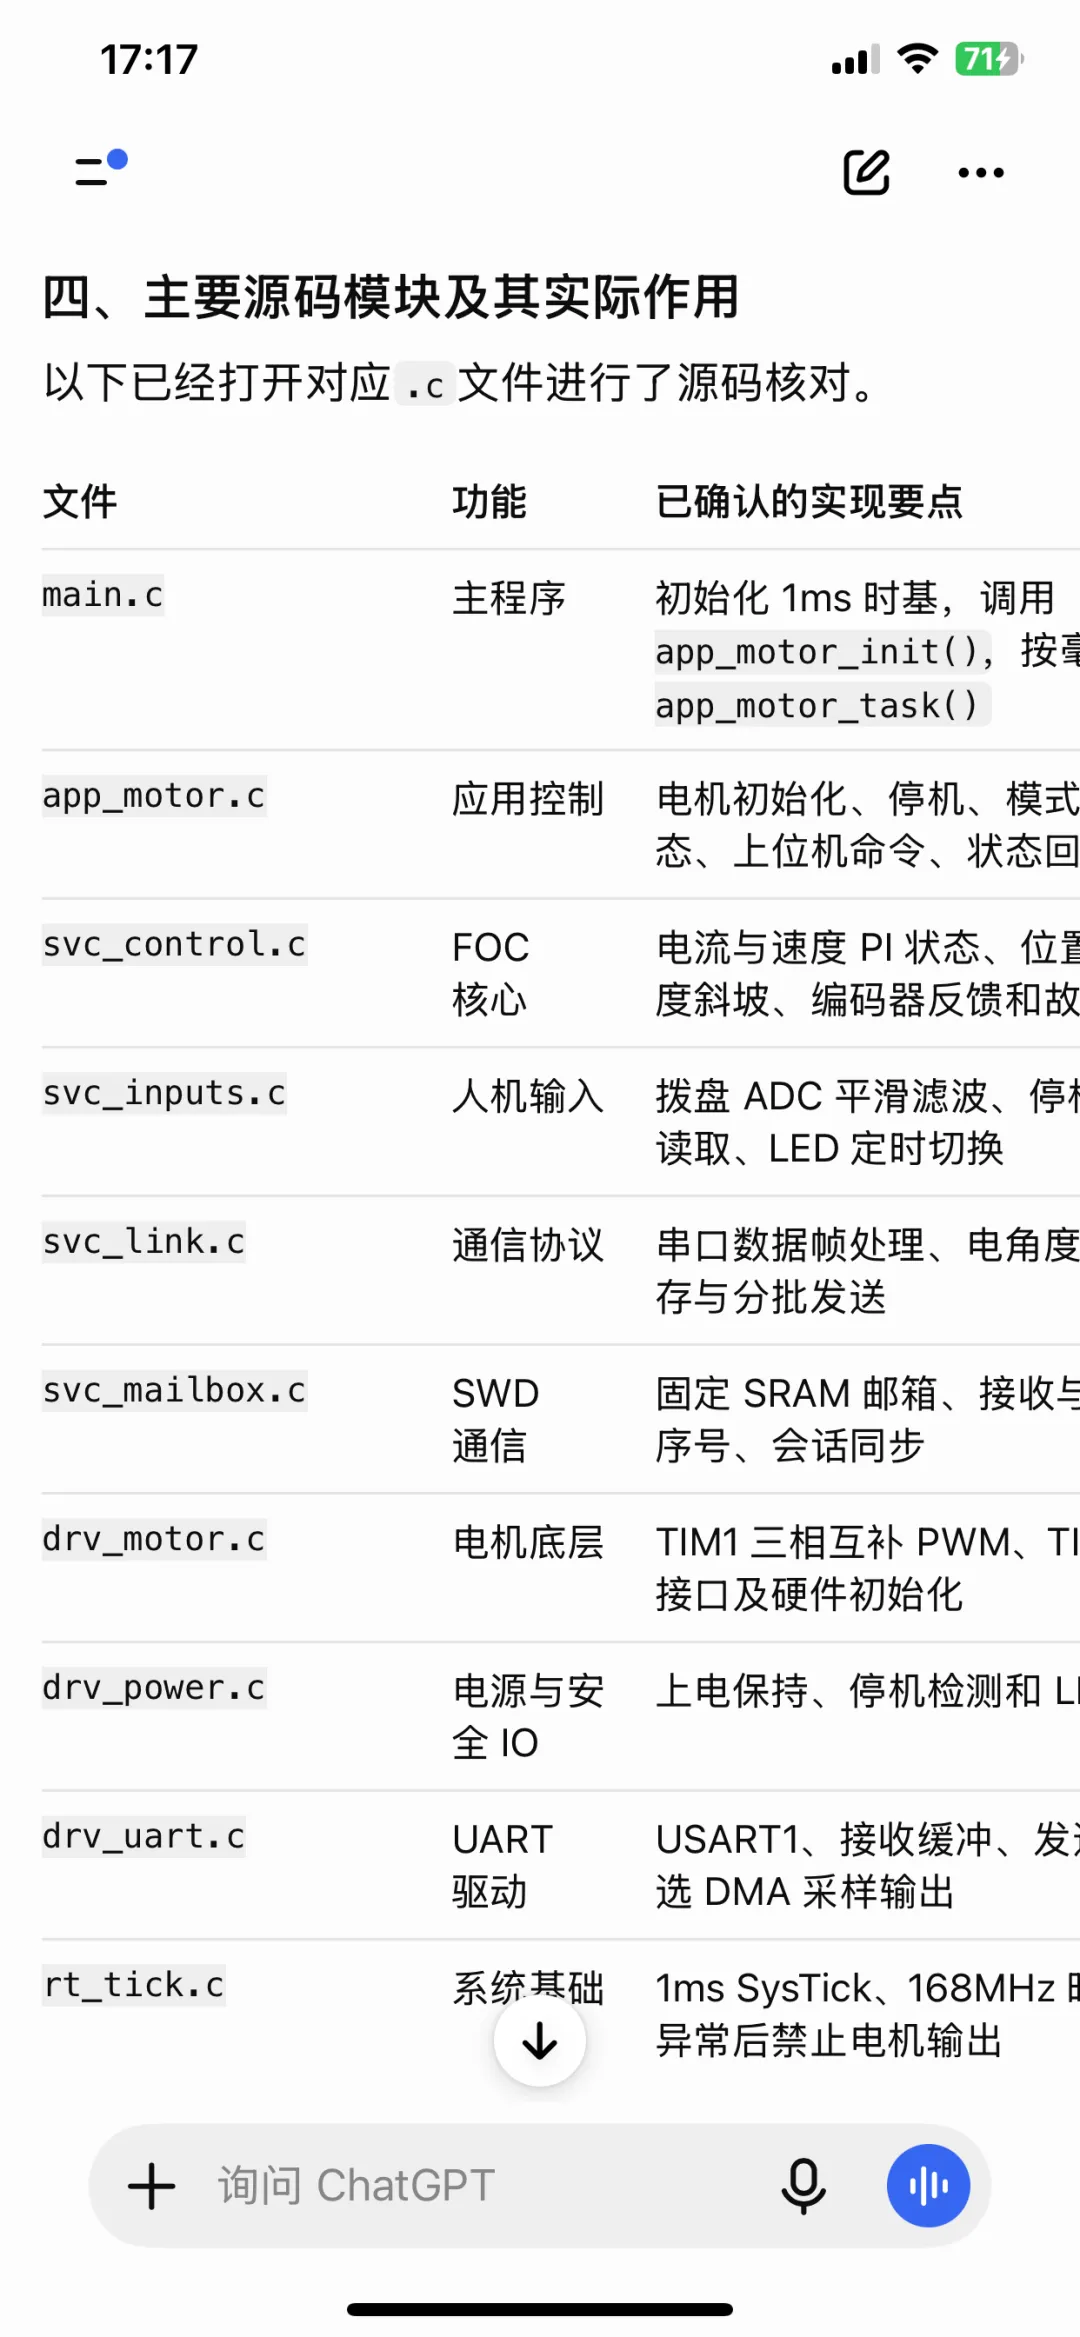
比如我要分析知识库foc1007这个项目的源码都包含哪些功能模块:
当然除了读,还可以直接通过手机App改知识库里面的内容。
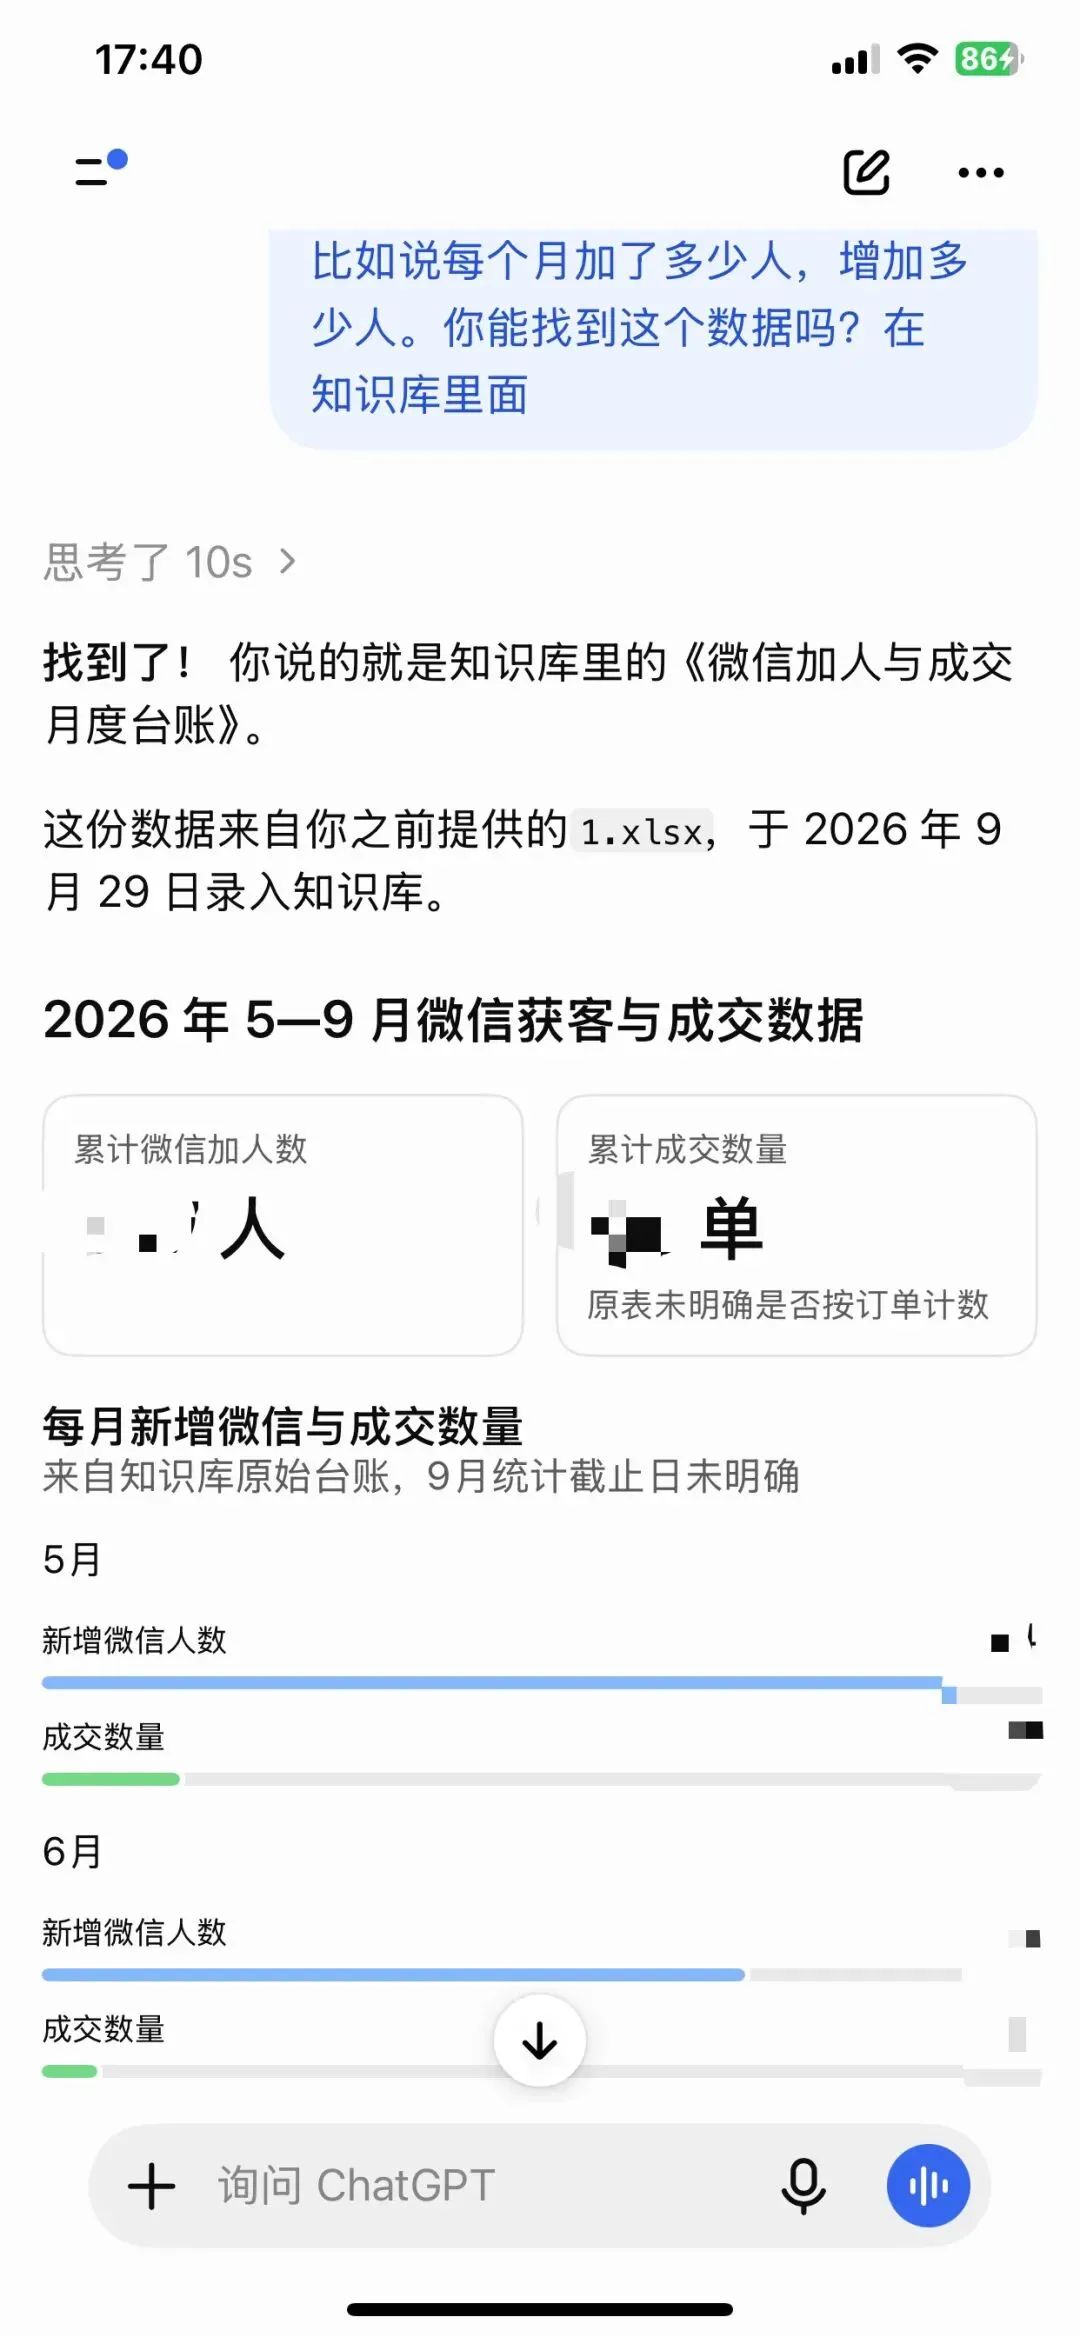
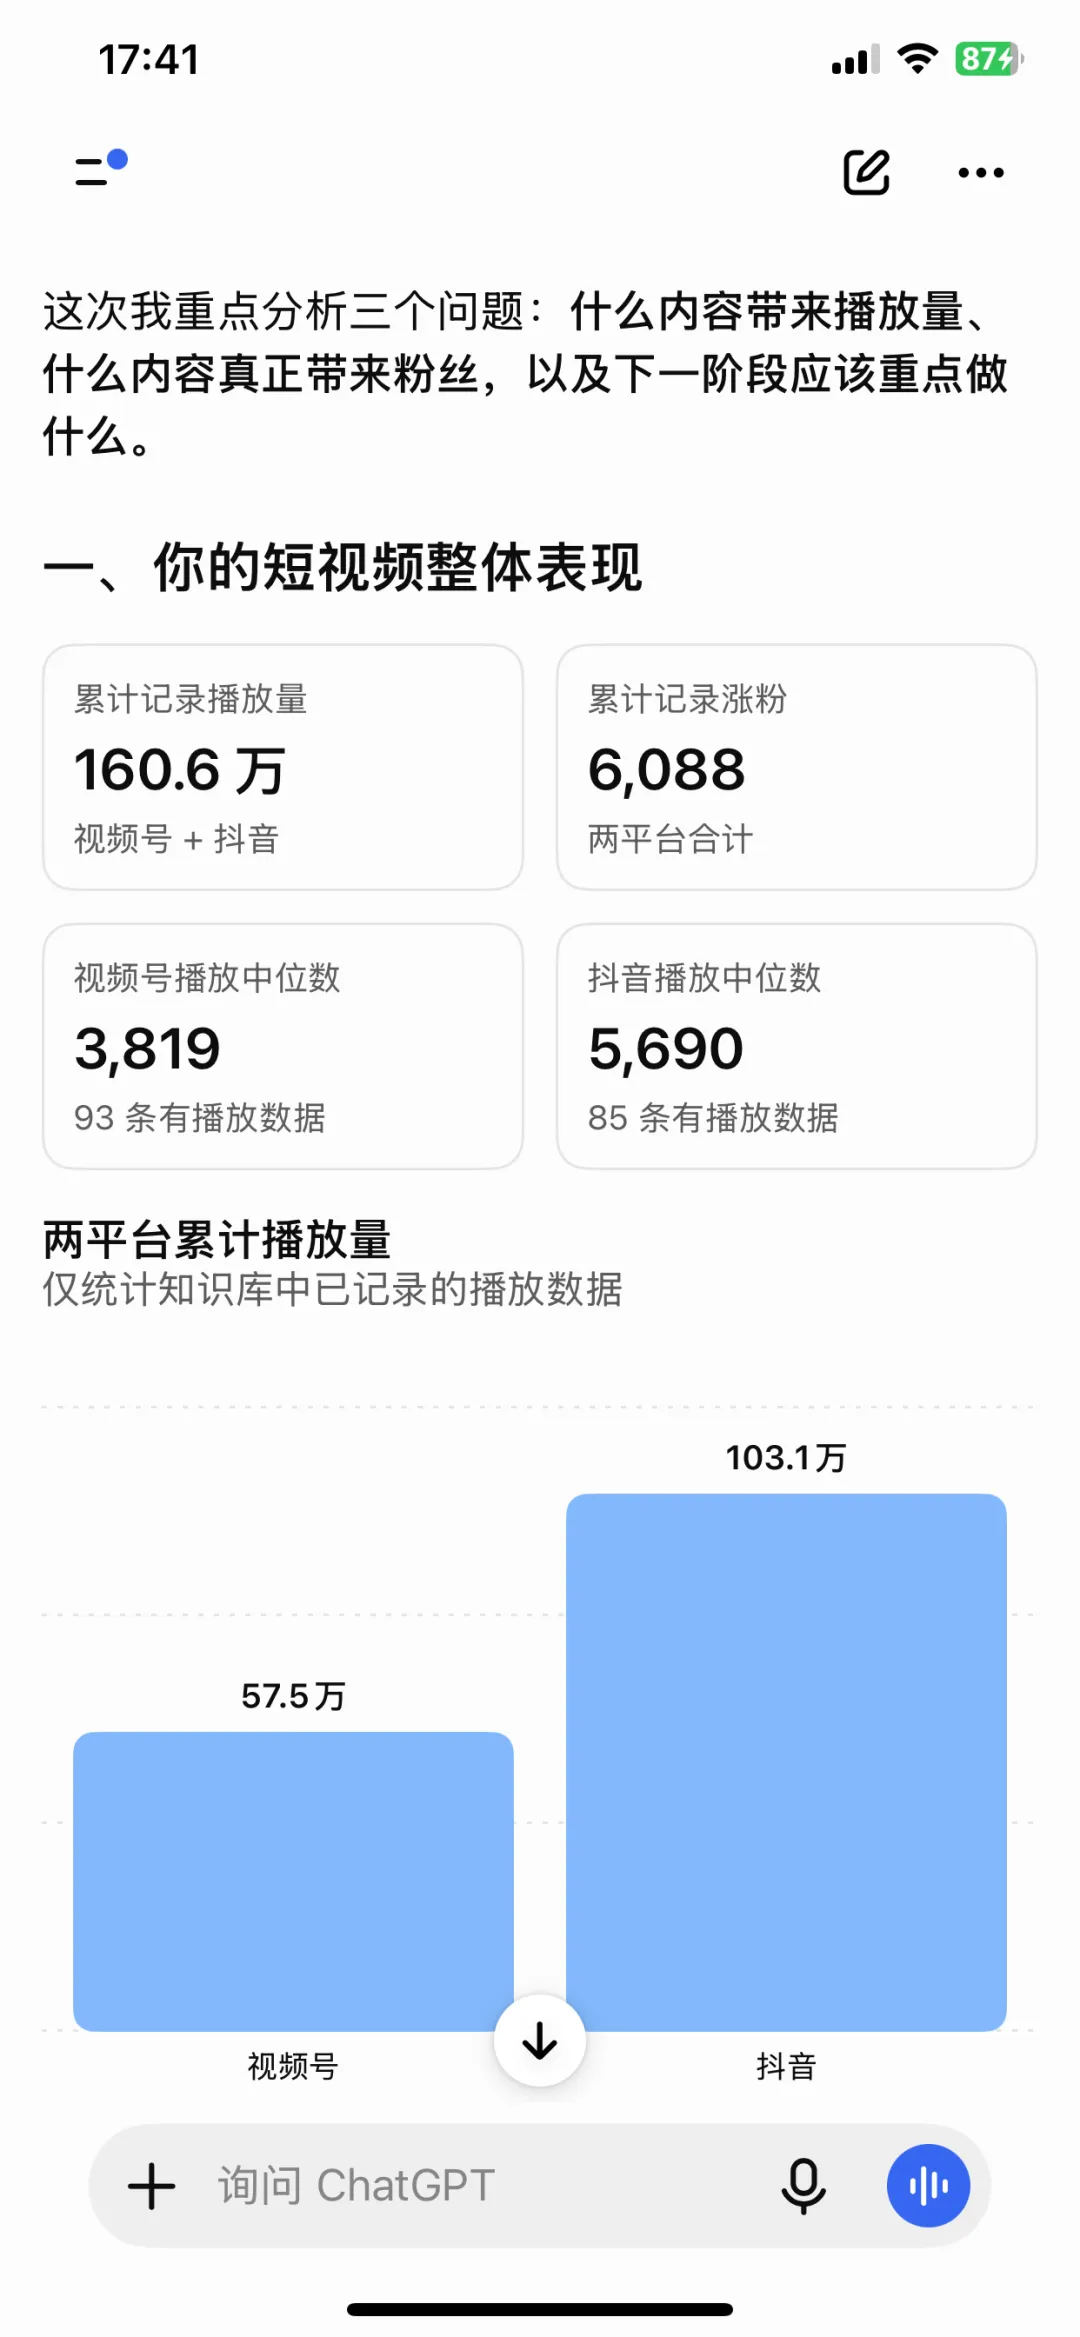
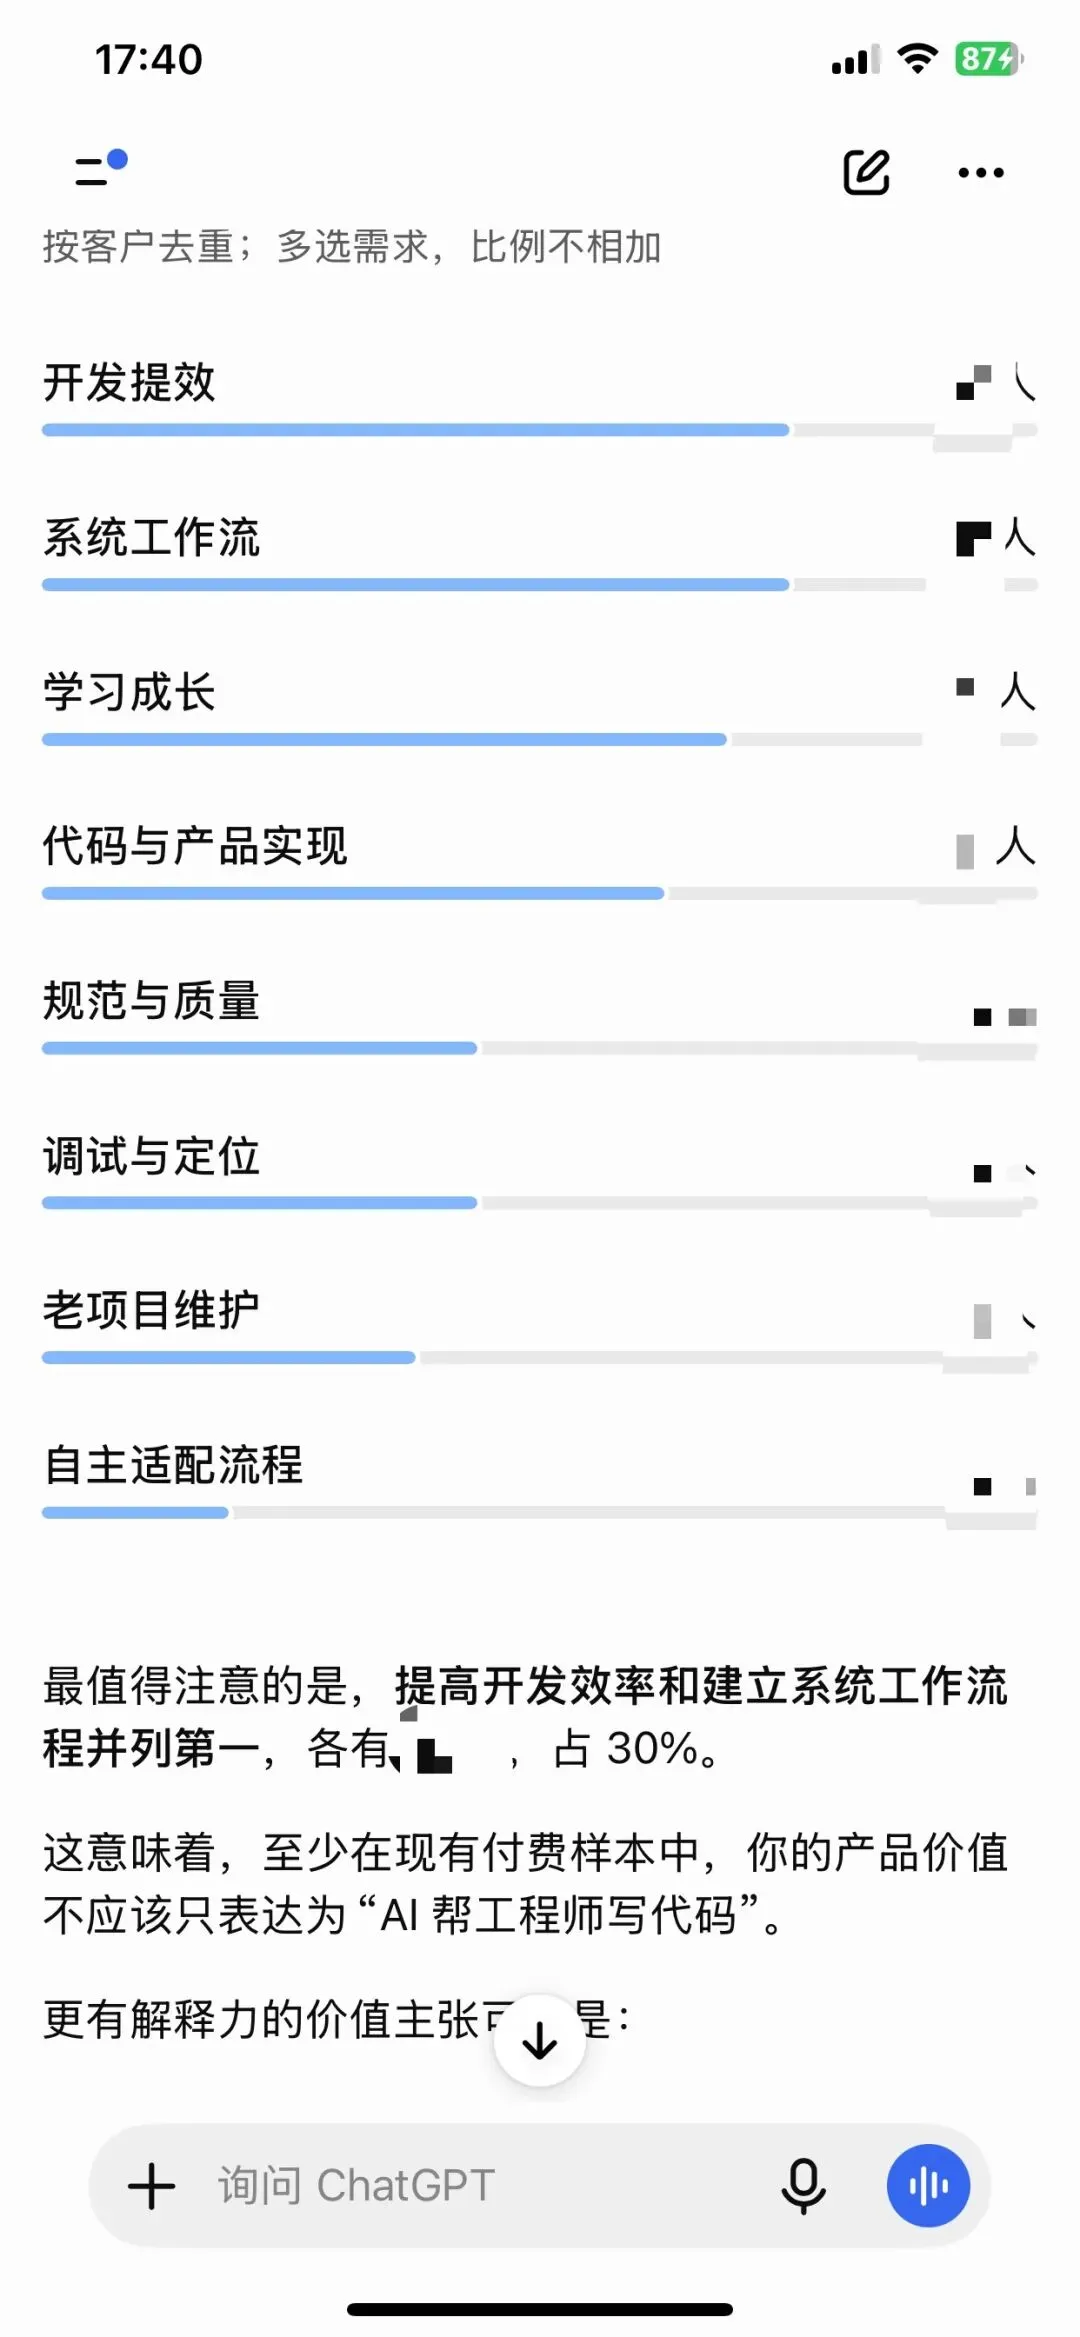
这个可想象的空间就巨大了,比如我还有另外一个运营的MCP工作台。
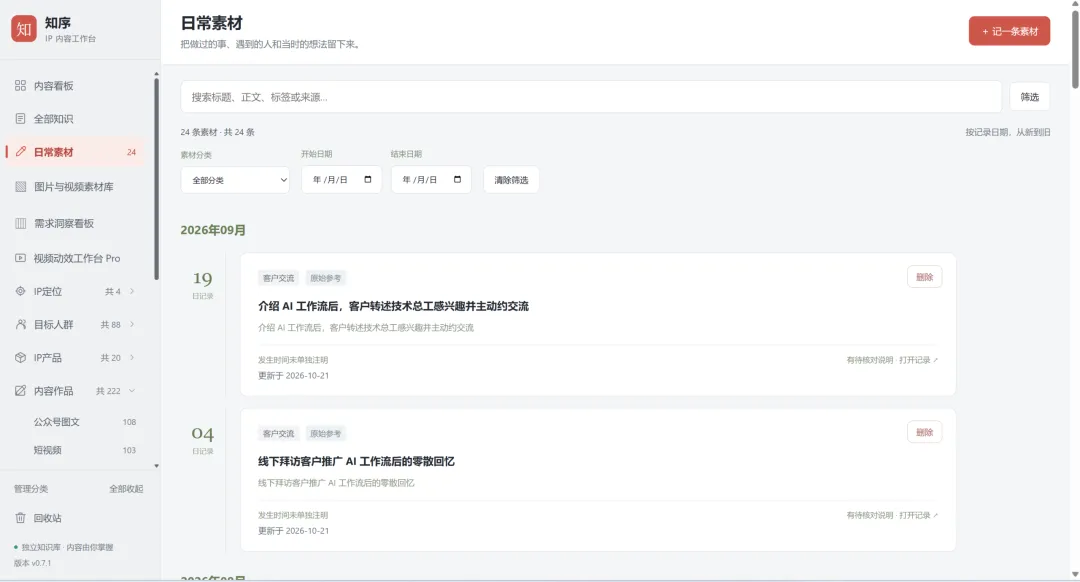
我每天通过手机app就能往我工作台记录,比如今天发生了什么,去了哪个客户,和客户聊了什么等等,还包含我所有发过的内容,客户反馈等,可以帮你所有的东西集中到一个数据库里。
打通数据记录和数据分析:
说个暴论,以后凡是不支持AI Agent接入的软件和工具,不说被淘汰吧,起码我是不想用。
而MCP就是帮你接通AI Agent的标准协议。
MCP 到底是一种什么协议?它和我们熟悉的 API 有什么区别?为什么接上以后,AI 就能知道服务器有哪些功能?如果我自己开发了一套软件,能不能把它的功能也通过 MCP 提供给 AI?
还有一个更关键的问题:我在 MCP 里规定了一套操作方法,AI 就一定会照着做吗?
这是我在研究过程中碰到的问题,很多知识到现在我还是模糊的,但是这不影响我做出来,因为全程都是口喷让AI做的,根本不需要自己写任何代码。
这篇文章,我想从一个嵌入式工程师比较容易理解的角度,把 MCP 的原理、功能和学习路径讲清楚。
一、先把 MCP 理解成一种标准接口
MCP 的全称是 Model Context Protocol,模型上下文协议。
做单片机开发的人,可以先拿串口通信作类比。
UART 解决的是数据怎么传,但收到里面具体的数据格式和定义,还需要双方约定应用协议。比如上位机发一条命令读取温度,单片机收到后采集温度,再按约定格式把结果返回。
换一套命令定义,同一条通信链路也可以控制电机、读取设备参数或者升级固件。
MCP 的思路有相似之处。它给 AI 客户端和外部系统约定了一套标准交互方式,让客户端能够发现服务器提供了什么能力、怎样传参数、怎样取得返回结果。
不过,MCP 不是另一种 UART。UART 主要涉及串行传输,MCP 是应用层协议,通常通过标准输入输出或 HTTP 等方式承载,包含工具发现、工具调用、资源读取和提示模板等机制。
拿欧工工程知识库来说,整个关系可以理解成:
用户提出需求 → ChatGPT / Codex / Claude Code → MCP Server → 工程知识库的检索程序 → 返回资料和来源。
这里真正负责保存、搜索技术资料的,还是原来的工程知识库。MCP 没有替我重新做一个数据库,也没有让模型突然掌握所有 MCU 的知识。
它只是把软件已有的能力,用另一套标准接口开放给 AI。
二、MCP 的功能全景
如果只是把 MCP 理解成让 AI 访问数据库,那其实只看到了其中一部分。
下面这张表,把常见的核心能力、配套机制以及扩展方式放在一起。
这不是说每个 MCP 客户端都能使用表里的所有功能。
部分能力是可选的,Tasks 等功能采用扩展形式。
Roots、Sampling 等能力在不同协议版本中的支持方式也有变化。
实际开发要核对所用协议版本和客户端。
对于新手,我觉得最先需要理解的还是 Tools、Resources、Prompts 三个概念。
三、Tools、Resources、Prompts,到底有什么区别?
还是用工程知识库举例。
如果我想让 AI 查询某个芯片的资料,可以给 MCP Server 提供一个搜索工具。客户端传入芯片型号和检索词,服务器去知识库搜索,再返回对应内容。
这就是 Tools。它更像一次函数调用,有参数、有执行过程,也有返回结果。
我实际连接的工程知识库就提供了类似的检索工具,可以搜索技术条目,也能检索已收录的 PDF 资料。
如果我想把某份工程设计规范、固定版本的接口说明提供给 AI,可以通过 Resources 暴露相关资料,让支持该能力的客户端读取。
这就是 Resources。它重点解决的是向模型提供上下文。不过实际项目里,也完全可以通过一个 Tool 读取文档,不一定非要用 Resources。
如果我希望 AI 按固定流程分析驱动代码,例如先核对芯片型号,再检查硬件接口,最后列出需要实板验证的条件,也可以把这套流程做成 Prompt 模板。
这就是 Prompts。但有模板,不代表客户端会自动调用它,更不代表模型一定逐条遵守。
所以简单理解,Tools 偏向做事,Resources 偏向提供资料,Prompts 偏向提供任务模板。它们可以组合使用,却不会因为放在同一个 MCP Server 里,就自动形成一套完整工作流。
四、我可以自己定义 MCP 工具吗?
可以。这也是 MCP 对开发者最有意思的地方。
MCP 没有规定你只能提供搜索文件、查询数据库这些功能。工具名称、输入参数、返回结构,以及背后执行什么业务逻辑,都可以由开发者设计。
假设我希望 AI 在开发一个 MCU 项目时,先从工程知识库里寻找可以参考的驱动。
我可以增加一个 find_mcu_driver 工具,输入芯片型号、外设类型和开发环境。
服务器收到请求后,检索现有的技术资料和参考代码,检查资料版本及适用条件,再把候选结果和来源返回。
例如,我工程知识库已经有一条 STM32F407 使用标准库读取 MT6701 A/B 计数的参考记录,里面包含 TIM3 计数、资源占用、相关依赖和历史验证信息。
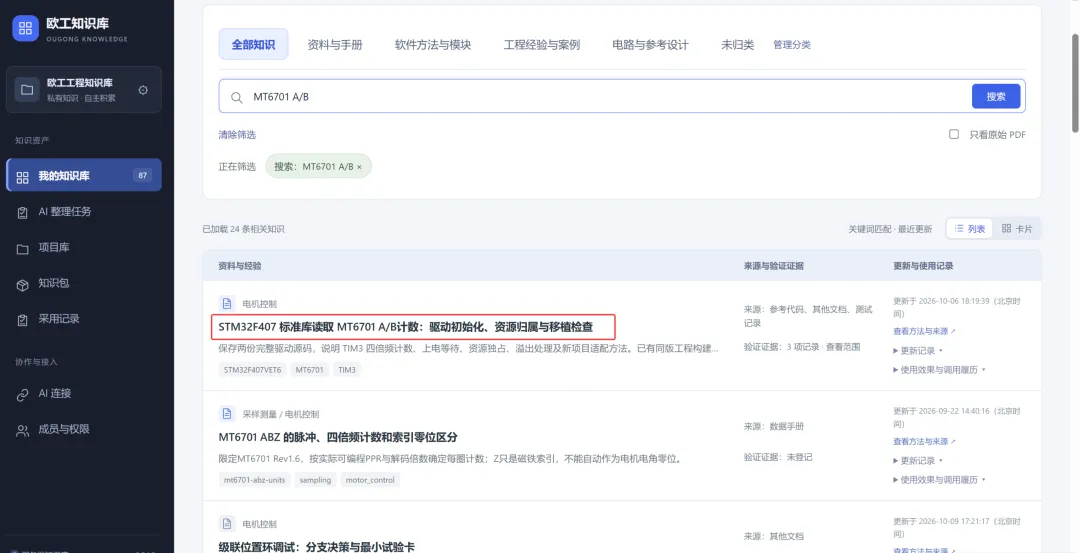
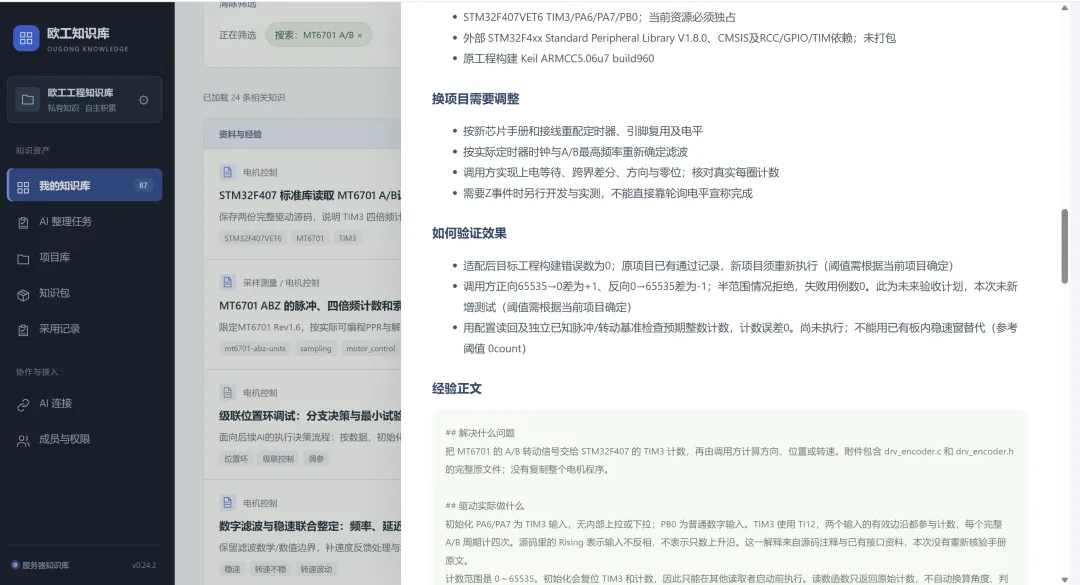
这类资料就可以成为工具的检索对象。
但要注意,返回一份历史工程里的驱动,不代表它能够不经修改直接用在当前项目上。原工程通过构建或者有限上板测试,也不等于你现在的硬件、SDK 和资源分配已经验证通过。
同样,如果我给 MCP 增加一个编译工具,背后就必须有真正可调用的编译环境。否则只是定义了一个叫编译的接口,并不会凭空获得编译能力。
所以 MCP 本身并不负责实现你的业务。它负责把已经存在的程序功能,以标准方式提供给 AI。
五、AI 是怎么知道这些工具的?
这也是我之前比较困惑的一点。
我的工程知识库提供了搜索技术知识、查询 PDF、读取源码等接口。接入 ChatGPT 以后,AI 怎么知道应该调用哪一个?
MCP 有工具发现机制。
客户端连接服务器后,可以请求工具列表。服务器返回工具名称、功能描述,以及每个工具需要的参数。
客户端再把这些工具能力提供给模型。
比如你问 AI,STM32F407 有没有可参考的 MT6701 编码器驱动?
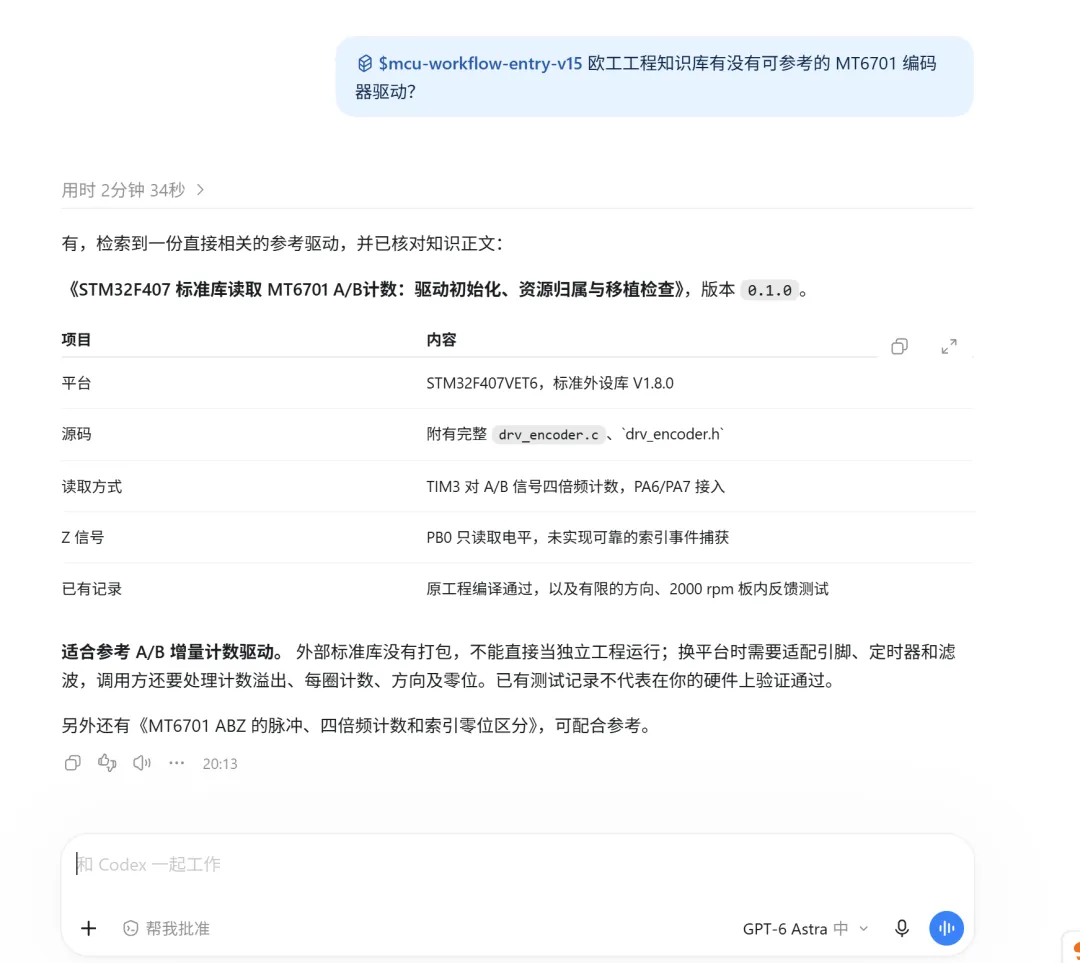
模型看到知识库搜索工具的描述,就可能决定调用它,拿到服务器返回的技术资料,然后结合当前问题回答你。
但这里有一个特别重要的区别。
MCP 工具已经接入,不代表 AI 每次都一定调用。
你让 AI 分析某个芯片,它可能去查工程知识库,也可能直接根据自身已有知识回答。
MCP 规定了工具如何发现、如何调用,却没有规定遇到某一句自然语言就必须调用哪个工具。这个决定还取决于客户端、模型和上层指令。
如果你希望某个任务每次都必须查库,只在工具描述里写一句必须查库,并不能提供程序级保证。
六、那我能不能把方法也放进 MCP,让 AI 严格遵守?
可以把方法提供给 AI,但要分清两种完全不同的要求。
一种是可以通过程序确定执行的要求,例如必须核对芯片型号、检查访问权限、读取指定版本、记录资料来源。这些最好直接写进服务器程序里。
另一种是需要模型判断的要求,例如怎样组织驱动架构、哪些代码值得复用、如何解释测试风险。这些可以通过工程规范、Skill、提示模板或知识库资料提供给 AI。
例如我做一个驱动查找工具,如果型号不匹配就不允许把结果标为可直接复用,这个检查可以写在服务端。
但如果只是把必须核对芯片型号写在 Prompt 里,模型就可能漏掉。
这和 MCU 固件里的固定判断逻辑不一样。
所以我认为,凡是必须执行、又能够编程验证的步骤,就不要只依赖模型记住。
MCP Server 可以保证工具被调用以后执行内部的程序逻辑,却不能单独保证 AI 一定选择调用这个工具。
如果想进一步保证整套流程不跳步,就需要在自己能够控制的 Agent 或应用入口中编排这些工具,并对结果进行校验。
七、MCP 和 Skill 是一回事吗?
不是。
MCP 主要解决 AI 怎样连接外部能力。Skill 则通常用于组织某类任务的方法和步骤,具体实现取决于客户端。
比如做单片机开发,我可以用 Skill 规定怎样整理需求、分析硬件接口、写代码、检查和验证。
MCP 则可以让 AI 搜索芯片资料、读取工程源码,或者调用真正的编译与测试程序。
两者可以协作,但不需要强行绑定。
把一套很长的 Skill 规则塞进 MCP 工具返回值,也不能保证模型完整理解和严格执行。
特别是嵌入式项目,代码生成了、编译通过了、上板正常运行了,是不同的验收层次。不能只凭模型说完成,就认定工程通过验证。
八、新手怎么从零学会 MCP?
我建议分五个阶段,不要一上来就开发一个功能很多的平台。
第一阶段:先做使用者。
找一个支持 MCP 的客户端,连接可信的现成服务器,实际体验搜索、读取和调用工具。先弄清楚什么是客户端、MCP Server,以及返回结果怎样交给 AI。
第二阶段:自己做一个最小 MCP Server。
用官方 SDK 注册一个简单工具,例如 add(a, b),输入两个数字,返回相加结果。
功能虽然简单,却可以把工具注册、tools/list、tools/call、参数传递和结果返回整个链路看明白。
第三阶段:连接真实数据。
把加法工具换成资料检索接口,比如查询工程知识库中的芯片手册。先只开放读取,验证搜索结果、资料来源和权限边界。
第四阶段:加入业务流程。
例如开发查找参考驱动的工具,让服务器先核对型号,再检索历史工程和数据手册,最后返回代码来源、依赖和未验证条件。
测试型号不存在、没有结果、服务失败、访问被拒时,工具会怎样回应。
第五阶段:补齐安全和可靠性。
做好身份认证、最小权限、日志、超时、版本校验、幂等处理及自动化测试。对于修改项目、删除文件、执行高权限命令,要有明确的授权和确认机制。
学到这里,你才真正开始理解怎样把 MCP 做成一套能长期维护的业务接口,而不是只做一个能演示的连接功能。
九、学习 MCP,最容易走进的几个误区
第一个误区,是觉得接入 MCP 以后,AI 就自动具备了某套软件的全部能力。实际上业务程序仍然要自己实现。
第二个误区,是把工具描述当成强制执行规则。描述可以帮助模型选择工具,但不能替代服务器里的检查逻辑。
第三个误区,是工具越多越好。如果工具职责重复、描述不清楚,模型反而可能更难选择。对同一类任务,少量清晰的接口通常更容易维护。
第四个误区,是把所有方法都写死在程序里。芯片手册、工程规范和项目资料会持续变化,适合按版本管理;必须执行的权限、参数和结果检查才应该尽量固化到代码中。
第五个误区,是以为所有问题都需要 MCP。有时候直接用本地函数、SDK、CLI 或已有 API 就足够了。只有当你需要让不同 AI 客户端以统一方式复用这些能力时,MCP 的优势才会更明显。
十、回到最初的工程知识库
如果我只是打开网页查询芯片资料,其实不一定需要 MCP。原来的知识库已经能完成搜索。
但我现在希望在手机 ChatGPT,或者支持 MCP 的 Codex、Claude Code 中直接使用同一套工程知识库,不必反复打开网页、复制资料、解释资料从哪里来。
这时 MCP 就有了价值。
最小的接入方式,是在已经部署的知识库旁增加 MCP Server,让它调用原有的搜索 API;如果原系统没有独立 HTTP API,也可以直接调用已有检索模块。再将服务接入支持远程 MCP 的客户端,测试工具发现、调用、返回数据和权限控制。
不需要因为增加 MCP,就把原来的知识库、数据库和网页全部重做一遍。
而且,接通只是第一步。AI 能否正确选择工具,是否查到了正确版本,旧工程里的代码是否适合当前项目,还需要分别核对。
所以 MCP 最重要的价值,是让 AI 能够调用真实软件系统中已经存在的能力。
如果你刚开始学,我建议先做一个能够查询芯片资料的最小工具,把一次发现、调用、返回的链路跑通。
等这条链路真正理解了,再去扩展源码查询、工程编译、调试工具甚至 EDA 软件,就会清楚很多。