ARTICLE · 1320760
AI 帮查病,医生来看病
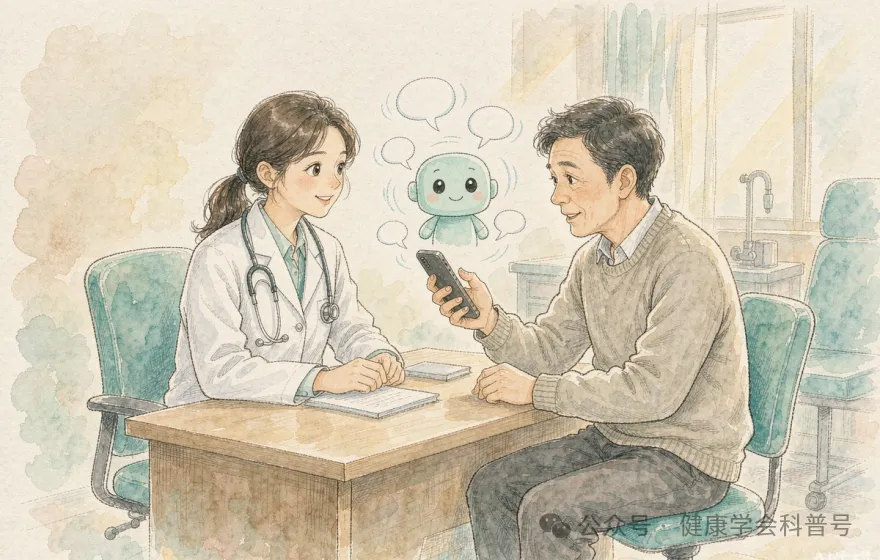
11 月 1 日,人民日报"人民锐评"发了篇文章,标题是一句诊室里的话——"大夫,您说的咋和AI不一样啊?"
文章说得很明白:"知道得多,不等于看得准;说得全,也不等于治得了。"医疗不是一次问答,而是一条决策链。
这不是个别现象。中国青年报社社会调查中心今年 8 月的调查里,92.0% 的受访者用 AI 查过病情、问过就医建议,69.7% 会带着 AI 的建议去和医生沟通。
AI 到底会不会看病?先看考卷,再看诊室,最后说清楚它现在还不能做什么。
01
先看考卷:医学能力测评里的大模型
试卷上的成绩确实亮眼。德国马尔堡大学团队今年公布一项研究:13 个大众可用的大模型,和 123 名医学专业人员同考一份急性肾损伤知识问卷,大模型平均答对约九成、多个拿到满分;人类正确率约 48.7%。
但"会考试"和"会看病"是两回事。美国麻省总医院团队在《美国医学会杂志·网络开放》发表研究:让 21 个大模型分步接诊 29 个标准化病例——信息补齐之后,九成以上案例能给出正确的最终诊断;可在病例早期、信息还不全时,超过八成的情况给不出合格的"鉴别诊断",也就是先把几种可能摆出来、逐项排除的本事。而这恰恰是医生接诊的头一步。
国内也有一场大规模"判卷"。北京友谊医院团队联合多家医疗机构,在《自然》子刊《数字医学》上发表研究:400 余名不同年资、不同地区的执业医生,盲评 5 款通用大模型对真实病例给出的意见。结果高年资医生更认可 DeepSeek-R1 和 GPT-4o,年轻医生更认可 Qwen-Max,AI 评委自己评出的"第一名"又和医生不同。
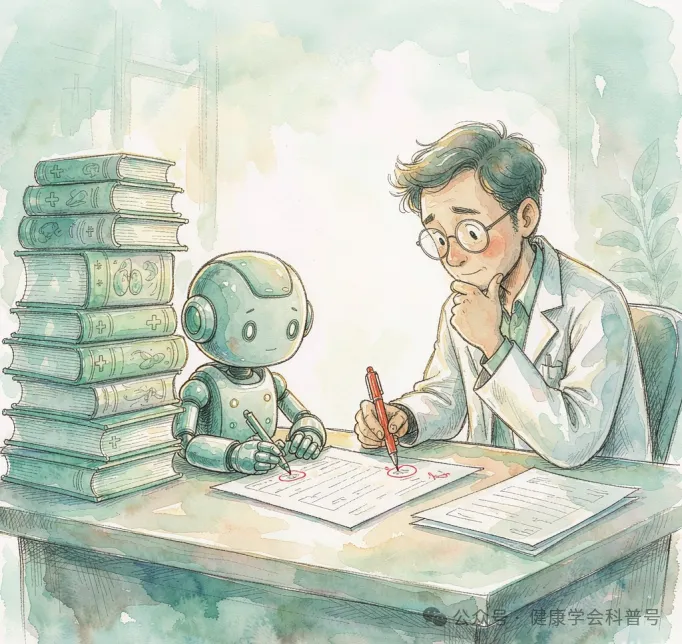
牵头研究者之一、北京友谊医院栗荐医生说得很到位:AI"只认标准答案",而真实病例往往是"多选题"甚至"开放题"——同样是胸痛,心内科先想冠心病,呼吸科想肺栓塞,急诊先做心电图排除心梗,三种判断在各自专科逻辑里都对,AI 还接不住这种差异。栗荐也提醒:门诊里拿着 AI 诊断意见来求证的患者越来越多,可以参考,但不宜全信。
02
再看诊室:几款主流"AI 医生"上手体验
考卷之外,普通人真正用上的是装在手机里的健康 AI。按热门程度,我们试了四款。
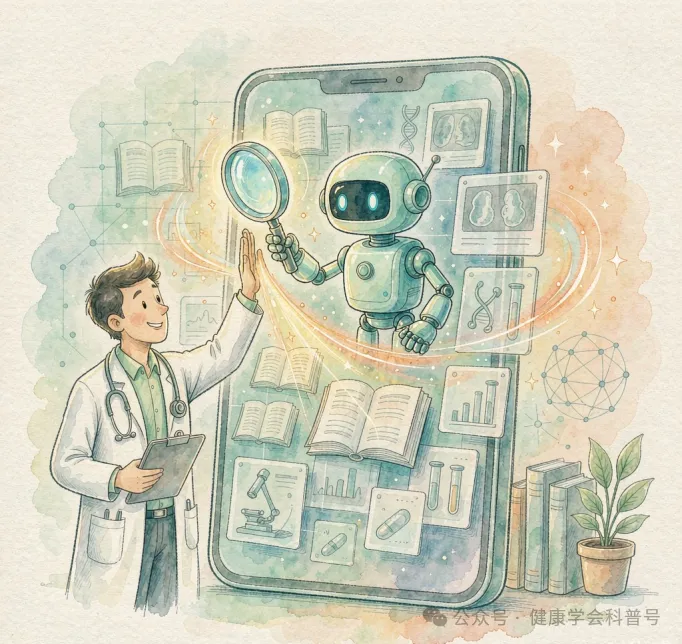
蚂蚁阿福(月活超 3000 万):更像流程管家——匹配号源挂号、院内导诊、云陪诊签到、报告大白话解读、医保一站式结算。最值得留意的设计是"AI 先答、三甲医生复核",皮肤科这项服务里医生复核与 AI 分析的一致率超 90%,已扩展到 16 个科室。饭桌那头也管得着:饭前拍张照片,它会结合体重目标、运动和体检记录给建议——茂名人那碗粥、那碟咸菜,也能拍过去问两句。蚂蚁集团 CEO 韩歆毅说得克制:"无论 AI 如何发展,诊疗主导者永远是医生。"
百小医(今年 5 月上线,免费):问诊会一轮轮追问,问完给两份文档——给医生的,把病史、病程、在吃的药理成时间线;给自己的,写明挂哪个科、怎么描述病情、问哪几个问题。创始人王小川的定位是"不替代,而是接手":诊前诊后约占一次就医 95% 的时间,诊中 5% 的关键决策必须留给真人医生。
京东知医、氢离子(医生端):普通人下载了也用不顺手,但正好能看清 AI 在诊室里干的是哪一段——查证据、给出处。京东知医整合数千万篇文献、数万份指南,对医生免费,已覆盖 300 万基层医生;氢离子每个答案后面挂着指南或论文原文,今年还上线"动态证据定位",能指出原文里哪一句支撑结论。为什么都在拼"能溯源"?阿里健康 CTO 祥志引过一个数字:中国医师协会调研显示,仅 31% 的基层医生会完全信任 AI 的辅助诊断结果。
03
为什么"有知识"不等于"能看病"
把测评和体验放在一起,AI 问诊的局限其实已经写在里面了。
一是给不出鉴别诊断。信息不全时,它难以像医生那样先摆可能性、再逐项排除——麻省总医院那项研究里,这是差距最大的一环。
二是不认识"你"。同一个症状落在不同年龄、病史、用药的人身上,排查方向完全不同;只认标准答案,就接不住个体差异。
三是它只听得见你说的。栗荐提醒过:普通人缺乏医学训练,描述病情的用词、角度不准,AI 据此给出的答案也会偏——漏说一种在吃的药,它就排除不了药物相互作用。
四是它会一本正经地说错话。人民日报也点了这条:AI 有幻觉。它说的每句都能拿去问医生,不能拿去替医生。
急症没有例外:胸痛、呼吸困难、意识不清、大出血——别问 AI,直接打 120。
顺带说一句离我们最近的:茂名市人民医院已备案开展人工智能辅助治疗技术,AI 进茂名诊室不是将来的事,是眼前的事。
知识可以拷贝,判断不能。AI 帮你查病,医生给你看病;工具越顺手,越要把判断留在人这一边。