ARTICLE · 1324347
graphify:将代码、文档和图片转化为可交互知识图谱
一个数字先摆出来。
130,804 star。 Apache-2.0,Python 写的,作者是 Graphify Labs。
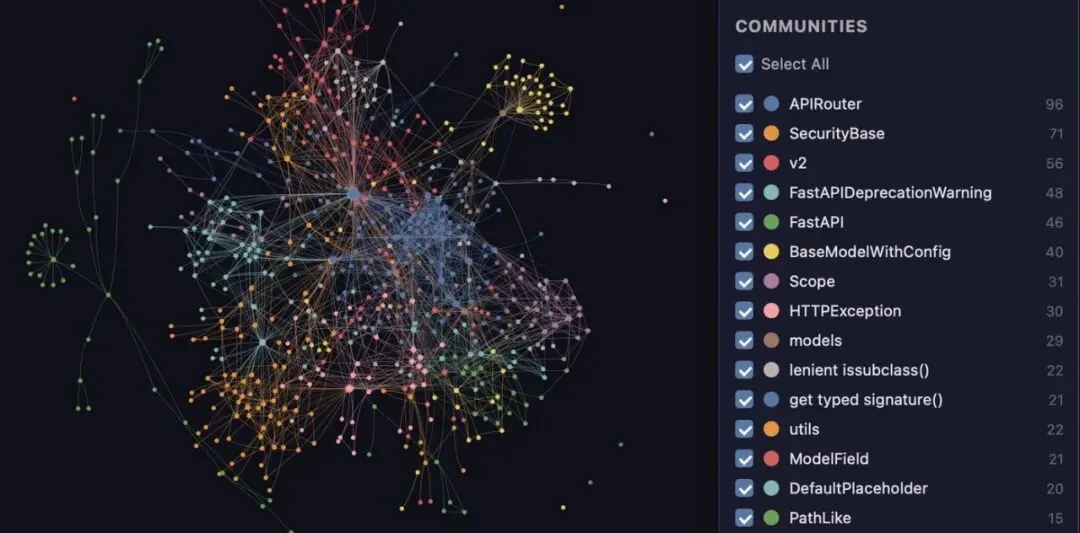
它做的事一句话能说完,把一个代码库变成一张可以查询的图。
但真正让我想写这篇的,是另一个数字。
建图消耗的 LLM 额度是 0。
01 建图不烧 token
这是它和其他 RAG 方案最根本的区别。
表 1 · 两条路线
| 本地 tree-sitter AST 解析 | ||
| 0 | ||
| 不用 | ||
| 代码不出本机 |
第一行是关键。
代码走的是语法树解析,不用模型读。tree-sitter 对约 40 种语言做 AST 解析,纯本地跑。
这就是「0 LLM credits」的来源。 模型不参与建图的第一步。
这里要问一句,不用向量库那用什么?
用图。节点是代码里的实体,边是它们的关系。
查的时候是图遍历,不是向量相似度搜索。
02 每条边都标了来源
这条设计我觉得最有价值。
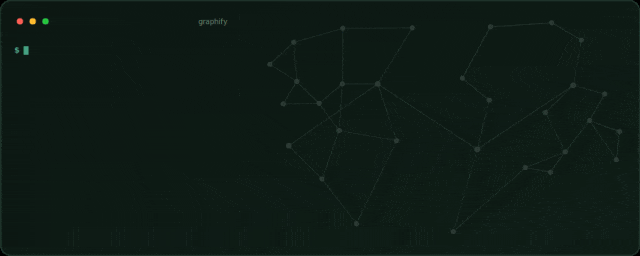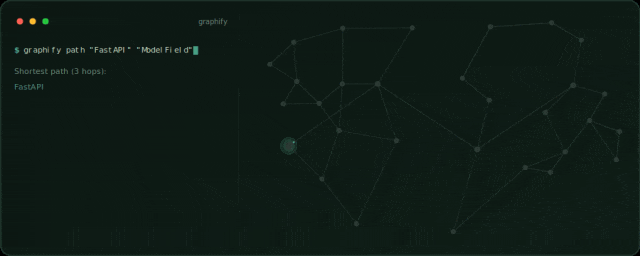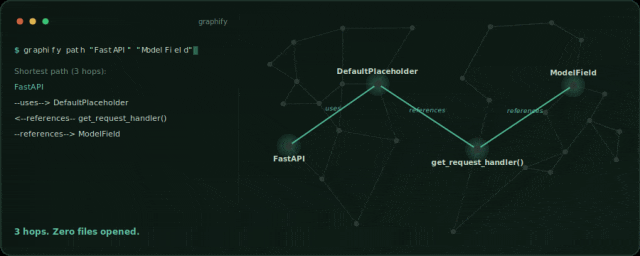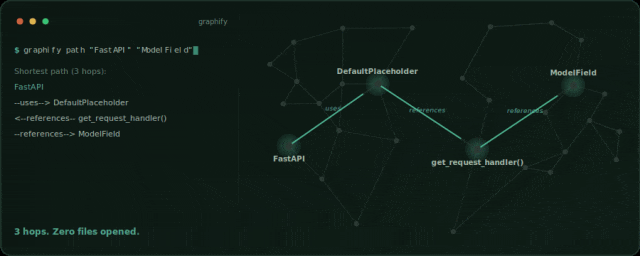
看上面这个动图。终端里问「FastAPI 到 ModelField 怎么连」,答案沿着图一跳一跳亮起来。
实际输出长这样。
$ graphify path "FastAPI" "ModelField" Shortest path (3 hops): FastAPI --uses--> DefaultPlaceholder <--references-- get_request_handler() --references--> ModelField每条边的末尾都有个标签。
表 2 · 两种置信标签
| 源码里明确写着的 | |
区分很重要。
`A imports B` 是源码里写着的,`EXTRACTED`。而 `A uses B` 往往是从调用链推出来的,`INFERRED`。
你看一眼标签,就知道这条边能不能信。
这里要问一句,为什么要标这个?
因为知识图谱最大的问题是「看起来有道理,实际是猜的」。
一个 47 条边的节点,如果没有置信标签,你没法判断哪几条是硬事实。
03 三个查询命令
表 3 · 怎么问
第一个是「划范围」。
你问「认证怎么连到数据库」,它返回的是相关的那一小块图,不是一段文字。
第二个是「找路径」。 上面那个三跳的例子就是这个。
第三个是「看邻居」。 `explain "APIRouter"` 会告诉你它在哪个文件第几行、属于哪个社区,还有多少条边。
04 社区划分不用模型
表 4 · 图上的三种分析
| Leiden 算法 | |
第二行得说一句。
社区检测用的是 Leiden 算法,一个纯图论方法。标签也不用模型生成。
这跟「0 LLM credits」是一条思路,能在本地算的就不调模型。
这里要问一句,不用模型打标签,质量够吗?
标签来自社区内的共同特征,比如都跟某个模块相关。不如模型起的名字漂亮,但结果是确定的、可复现的。
05 基准数据自己报
表 5 · 四个基准
| 0.497 | |||
| 76% | |||
| 82.0% |
第一行差距最大。
recall@10 是检索前 10 条能召回多少相关内容的指标。0.497 对 0.048,差了一个数量级。
但第二行它也输了。
QA 准确率 45.3%,比 supermemory 的 49.7% 低。
README 把这行也列出来了,没有藏。 这点值得说一句。
第四行是和自己比。 grep/read 基线 70.8%,它 82.0%。
这里要问一句,这些数字可信吗?
README 写了评测方法,同一套 harness、同一个模型,也是同样的预算,而且判分器做过盲评校验,和第二判分器一致率 90.6%,Cohen's kappa 0.81。
kappa 0.81 属于「高度一致」。 这个数字说明评测本身是严谨的。
06 代码不出本机,但文档要
隐私这块分得很清楚。
表 6 · 三类内容分别怎么处理
| 不出 | ||
| 不出 | ||
| 要出 |
第一行和第二行是纯本地的。
README 明确写了,纯代码的语料不需要 API key,`graphify extract` 可以完全离线跑。
第三行是唯一的例外。
文档和图片的语义理解要靠模型。但注意,它走的是你自己 IDE 会话里的模型(通过 `/graphify` skill),不是它自己的服务器。
这里要问一句,混着放怎么办?
有个 `--code-only` 参数,只索引代码,跳过需要 LLM 的文档和图片。
这个开关对私有项目很实用。
07 装和用都很短
表 7 · 上手路径
第一步那个包名要注意,是 `graphifyy`,双 y。
README 专门提醒了,PyPI 上其他 `graphify*` 包跟它没关系。但命令行还是 `graphify`,没有双 y。
第二步会自动检测你用的是哪个助手,把 skill 注册进去。支持 20 多个平台,Claude Code、Codex、Cursor、Gemini CLI、OpenCode 都在列表里。
第三步就是建图。 建完会生成 `GRAPH_REPORT.md` 和 `graph.json`。
几个常用参数。
/graphify ./docs --update # 只重抽改动的文件 /graphify . --cluster-only # 只重跑聚类 /graphify . --wiki # 从图生成 markdown wiki graphify add <arxiv-url> # 抓一篇论文加进图里它解决的是「读不动」
说回开头。
一个几万行的仓库,人读不动,模型也读不动。
grep 只能找字面,读文件要一个个开,塞进上下文很快就满。
graphify 换了个思路,先建一张图,然后查图而不是读文件。
而且它做了两个我认为对的选择。
第一,能在本地算的就不调模型。 代码解析、社区划分和音视频转写全部本地。
第二,每条边都标了是读出来的还是猜的。 这让人能判断结果的可靠性。
一个知识图谱工具,最该看的是它敢说自己哪部分不确定,连得多全排在后面。
你有没有哪个仓库,一直想搞懂但读不进去?
项目地址
https://github.com/Graphify-Labs/graphify
文档
https://docs.graphify.com
安装
uv tool install graphifyy许可
Apache-2.0。注意 PyPI 包名是 `graphifyy`(双 y),命令行是 `graphify`。