ARTICLE · 1356401
国产系统改造手记3:PDF飞刀迁 UOS,一份能双击的交付
案例实录 · PDF飞刀
PDF飞刀 迁 UOS:一份能双击的交付
用五阶段方法论,把 PyMuPDF 应用送进统信桌面
一、这个产品,踩的是哪几道坎
先说 PDF飞刀 是什么。它是一套 PyQt6 写的桌面工具,底层用 PyMuPDF 做 PDF 的渲染和编辑,界面是 Ribbon 架构,分四个模块:Pages(页面)、Annotate(标注)、Security(安全)、Output(输出)。它最早叫 PDF快刀,后来改名为 PDF飞刀,目前版本 v1.10.9,所有窗口顶栏都带着「视频号:Excel办公精英」的品牌前缀。
我前面讲过,从 Windows 迁 UOS 横着四道坎:应用兼容性、驱动与外设、操作习惯、运维成本。落到 PDF飞刀 身上,这四道坎长这样。
应用兼容性这一道,PDF飞刀 反而比一般工具有优势——它的核心栈 PyQt6 和 PyMuPDF 本身就是跨平台的,没有 win32com、没有 winreg 这种 Windows 独苗。但优势只到「源码能跑」为止,往下还有两道更隐蔽的坎。
第一道隐蔽坎是字体。PyMuPDF 排版输出走的是 @font-face 那条路径,中文水印、页眉、带格式文本框,一旦字体回退漏了 Linux 分支,中文就在产物里静默变成小方框。界面上的中文好好的,输出的 PDF 却坏了,这种错最气人,因为它不报错。
第二道隐蔽坎是打包。PyMuPDF 不是一个纯 Python 包,它带重量级的 C 扩展。冻结成 ELF 可执行目录时,依赖图比普通包复杂,漏一个底层 .so,双击就安静地没反应。
驱动与外设这道坎,PDF飞刀 基本不碰——它是纯软件,不连打印机也不连扫描仪。但「不连设备」不等于「没有打印需求」:PDF 工具总有导出和打印功能,打印走的是 Qt 的 QPrinter,不走 win32print,这一段在阶段1 里单独处理。
操作习惯这道坎,因为界面本来就是我自绘的 Ribbon,不存在「Windows 肌肉记忆」问题,反而是四道坎里最轻的。
运维成本这一道,PDF飞刀 逃不掉。它 Windows 版和 UOS 版要长期并行,每改一个功能两边都要回归,版本号也得两边对齐。
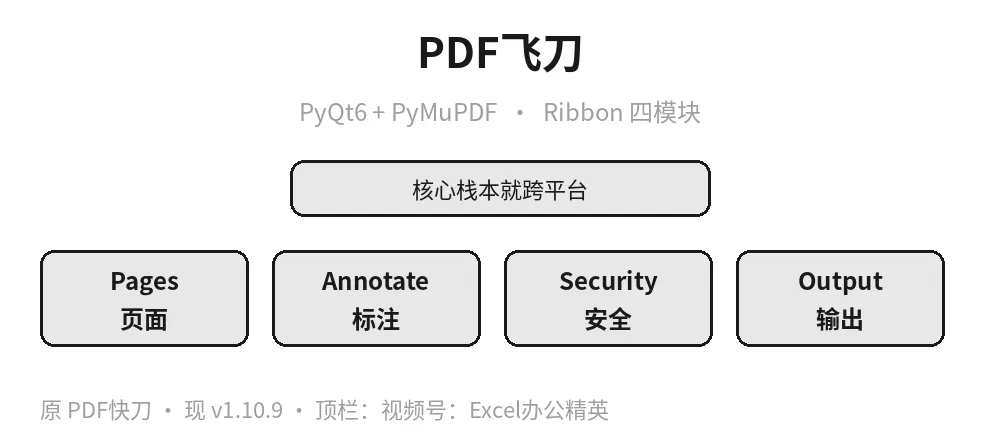
图 1:PDF飞刀 的产品定位与 Ribbon 四模块,核心栈 PyQt6 + PyMuPDF 本就跨平台。
二、阶段0 审计:先看清自己有什么
方法论的第一步不是写代码,是审计。我用 grep 扫了一遍源码,专门找 Windows 专属面:os.startfile、winreg、win32com、win32clipboard、win32print 这些。结果很干净——PDF飞刀 几乎一个都没有,因为它的跨平台栈从第一天就不是为 Windows 量身定做的。
真正要记的是第三方依赖基线:PyQt6、PyMuPDF,以及它们各自的版本号和来源路径。这一步看起来像形式主义,实则是后面「版本一致性」那道坎的伏笔——很多工具迁移后出问题,不是代码改错了,是打包时把错误版本的依赖冻了进去。
审计还要列一份「功能清单」:页面操作、标注、加密、导出,每个功能对应哪些模块、哪些第三方调用。这份清单不是给领导看的,是阶段3 回归时的对照表——漏一个功能没回归,就是真机上少一块。
审计的结论是:PDF飞刀 源码层改动量很小,真正的工程量在「字体回退」和「冻结打包」两段。这个结论直接决定了后面把力气花在哪。
三、阶段1 源码适配:要改的不多,但要改对
因为核心栈跨平台,阶段1 的源码改动确实少。我主要做了四件事。
第一件,把少数平台相关的地方用平台守卫包起来。比如高清屏 DPI、系统字体目录的取法,Windows 和 Linux 的取值方式不同,但这些是「函数内惰性处理」,即使没适配也只是某功能表现不对,不会让整个程序启动即崩。
第二件,也是最关键的一件——补字体回退的 Linux 分支。前面说过,PyMuPDF 输出走 @font-face,这条路径在 Windows 上能自动拿到系统字体,到 Linux 上如果没显式带字体文件并注册,中文就丢。我的底牌是随包带一个 simhei.ttf,系统回退只当保险。这条后来直接焊进了构建模板,谁用模板谁自动带上。
第三件,处理剪贴板与打印。PDF 工具要支持复制文本、粘贴图片、打印页面。Windows 上惯用 win32clipboard、win32print,到 Linux 上要换回 Qt 自带的 QClipboard、QPrinter。这两处如果不换,功能不是报错,是点了没反应——比报错更难查。
第四件,统一路径与编码写法。encoding="gbk" 改成 utf-8,反斜杠改成 os.path.join。PDF飞刀 这类工具很少直接碰这些,但凡有一处漏了,真机上就是某一个导出功能悄无声息地失效;subprocess 里调 .bat 的地方,要么找到 Linux 等价命令,要么禁用并明确提示,不能留着让它静默失败。
阶段1 的出口判据很明确:改完每个模块 import 全绿,并且逐功能在本地端到端跑一遍。不是「能启动」就算过,是「每个按钮都真调过」才算过。
四、阶段2 冻结打包:PyMuPDF 是重 C 扩展
阶段2 是用 cx_Freeze 8.x 把东西冻成 ELF 的 install-dir。PDF飞刀 在这里吃了打包的亏,教训很典型。
第一个坑是动态 import 的包必须显式写进 packages。PyMuPDF 有些子模块是运行时才 import 的,cx_Freeze 静态分析抓不到,不显式声明,冻结后一调用就 ModuleNotFoundError。
第二个坑,也是最阴的那个——libxcb-util.so.0 和 .so.1 的版本差。UOS 自带的 Qt 只带了 .so.0,而 PyQt6 的 xcb 插件要的是 .so.1,版本号差一位,整个图形栈起不来,而且不报错、不弹窗、连进程都没有。解法是用 ldd libqxcb.so | grep "not found" 确诊,再把 .so.1 放进插件自己的 RUNPATH 目录。
第三个坑是时区。PDF飞刀 会记录文档处理时间、写日志,而玲珑容器里 /etc/localtime 可能是空文件,又没有 TZ 环境变量,界面时间会整整差八小时。用户看到的是「刚才」变成「八小时后」,没人会往时区上想。这一段在启动器里补 TZ,不能靠运气。
启动器还有一条我付过代价的约定:失败分支统一走一个函数,写日志、给中文原因、三级弹窗兜底——zenity 到 xmessage 到只落日志。精简版 UOS 可能没有 zenity,弹窗会静默失效,所以必须三级兜底。
构建骨架还有个顺序陷阱:缺口记录必须写在 setup() 返回之后,因为构建一开始会清空产物目录,写在前面会被一并清掉。这条我付过代价。
阶段2 出口前还要做一件不起眼但必须有的事:排除启动日志和构建信息文件,它们可能残留构建机的绝对路径,暴露目录结构。
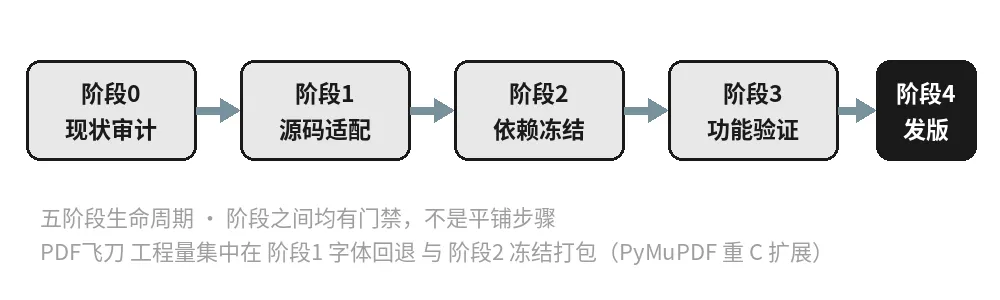
图 2:PDF飞刀 走完五阶段,工程量集中在阶段1 字体回退与阶段2 冻结打包。
五、阶段3 验证:守卫怎么盯住 PDF 产物
阶段3 是方法论里我最较真的一段,三态加 L1–L4。
源码模式验「写对没」,冻结模式验「从产物跑对没」,注入式 --selftest 往沙箱塞缺陷,确认守卫真的会报警。只会报绿的守卫,和没有守卫是一回事。
L1 验所有模块能 import;L2 反汇编 .pyc 确认关键改动入了库,而且只扫 library.zip 会漏「包形态」模块,必须两处并扫;L4 冻结模式断言业务模块的 __file__ 全来自 install-dir,排除「venv 假 PASS」——也就是守卫验的是本机源码而不是冻结产物那种假绿。
L3 功能层是 PDF飞刀 最该盯的。我每个功能真调一次,断言产物本身:页数对不对、文件大小变没变、加密态生没生效,还有一条最容易漏也最要命的——中文非空。前面那个字体坑,如果守卫没断言「输出 PDF 里中文还在」,它就会在真机上静默复发。
测试本身还有副作用。桌面注册、配置读写这类验证必须在隔离的 HOME 与 XDG_DATA_HOME 下跑——只伪造 HOME,菜单项会被写进真实的用户目录,测试一次就把本机搞脏一次。这条教训我是真踩过。
最后一道门是阶段门控:阶段1/3 的真机双击验收通过之前,不许进阶段2 发版。「继续」两个字不触发发布,必须明确批准。因为我试过,offscreen 启动只证依赖齐、插件能加载,根本没走真机的 xcb 路径,不代表像素级 GUI 正常。
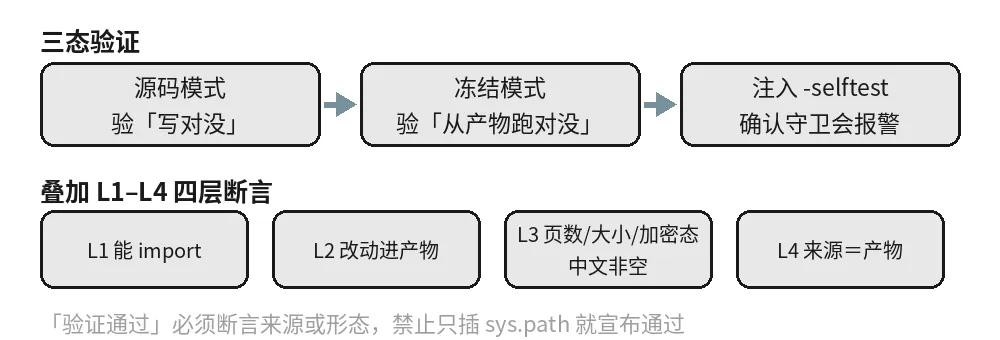
图 3:L3 功能层针对 PDF 产物断言页数、大小、加密态与中文非空,L4 锁死来源防假绿。
六、阶段4 发版:双包归档 + SHA256
阶段4 的流水线很机械,但一步都不能省:先清掉旧的 dist,再打两个包——一个给普通用户的安装包,一个给便携场景的 install-dir 压缩包,算 SHA256,最后拆包做一次无头复验。
清旧产物这一步要用 mv 旁置,不用 rm -rf,因为安全删除守卫会拦大目录的直接删除。校验值不是形式,它是交付当天唯一能证明「用户手上这个包就是我验过的那个」的东西。校验值对不上,说明中间哪一步被人动过,或者你验的是 A 包、发的是 B 包。
发版不是点一下按钮。清单上每一项都要打勾:产物存在、依赖齐全、启动器可执行、日志可写、双包校验值一致。任何一项不过,包就不许出。这套机械动作看着笨,却是防止「我以为发了、其实发错」的唯一办法。
七、这套流程为什么能复用
有人会问:PDF飞刀 的坑,换个产品还适用吗?答案是适用,因为我没把经验堆进一本文档,而是拆成了一个编排层加六个专项技能。
编排层只做编排和指向,深层机理交给六个专项技能——环境适配、冻结打包、发版、桌面注册、启动器、Web 改造。这六个专项技能各管一摊,边界清楚:环境适配管源码层的平台差异,冻结打包管依赖声明与 cx_Freeze 的坑,发版管阶段2 的九步流水线,桌面注册管 .desktop 与菜单项,启动器管自定位与三级弹窗,Web 改造管浏览器壳。谁的事谁管,编排层不越界,改一处不会牵动全身。同一份机理只在它该在的地方维护,编排层只放要点和指向,不重复建档。否则两份文档写着同一件事,迟早一个更新、一个不更新,坑就原样回来了。
架构边界也是写死在开头的:x86_64 的产物只能在 x86_64 目标机跑,ARM 的飞腾、鲲鹏,龙芯的 LoongArch,都得另建对应架构的产物,这套流程不覆盖跨架构。把边界写在开头,比藏在附录里有用,读者第一天就知道这件事不能许愿。
八、结果:一份能双击的国产桌面交付
现在 PDF飞刀 在统信 UOS 上双击即跑,品牌顶栏照常展示「视频号:Excel办公精英」,四个模块功能完整。它不是一个「大概能跑」的演示,是过了真机双击验收、带了 SHA256 凭证的交付物。
这套五阶段方法论,对我而言最大的价值不是「少踩坑」——坑该踩还是踩了。它的价值是让坑不再靠人记:字体回退焊进模板,libxcb 差异写进启动器自检,中文非空写进 L3 断言。下次再搬一个 PyQt6 应用,照着走一遍,第一天就不会重蹈覆辙。
国产化适配不该靠玄学。把 PDF飞刀 送进 UOS 的这一步,验证的不是某个工具多厉害,而是「流程能自己跑起来、能报警」这件事,真的能落地。