ARTICLE · 1360230
博士生嫌AI太慢,花“两周”写个插件!结果搞成4年3000人巨无霸,狂揽1.5亿美金!
作者 | 微醺客
编辑 | 深夜灯
永远不要相信一个程序员嘴里的“这活儿很简单,两周就能搞定”。
因为硅谷顶级风投 a16z 最近晒出的一段复盘视频,刚刚为这句行业名言提供了一份价值 8 亿美元 的人类历史级罪证。
事情的起因听起来像个冷笑话。
2022 年,加州大学伯克利分校的博士生 Woosuk Kwon 嫌实验室里的大模型跑得太慢,一拍脑袋,决定搞个课余副业把它加速一下。
他给自己定的工期是:两周。
结果呢?
整整四年过去了,三千名程序员前赴后继地掉进这个坑里。
当年那个“两周小插件”,直接长成了今天全球大模型领域的开源基建巨无霸,vLLM。
任何时刻,全世界都有大约 50 万张昂贵的 GPU 显卡在昼夜不停地跑着他们的代码。
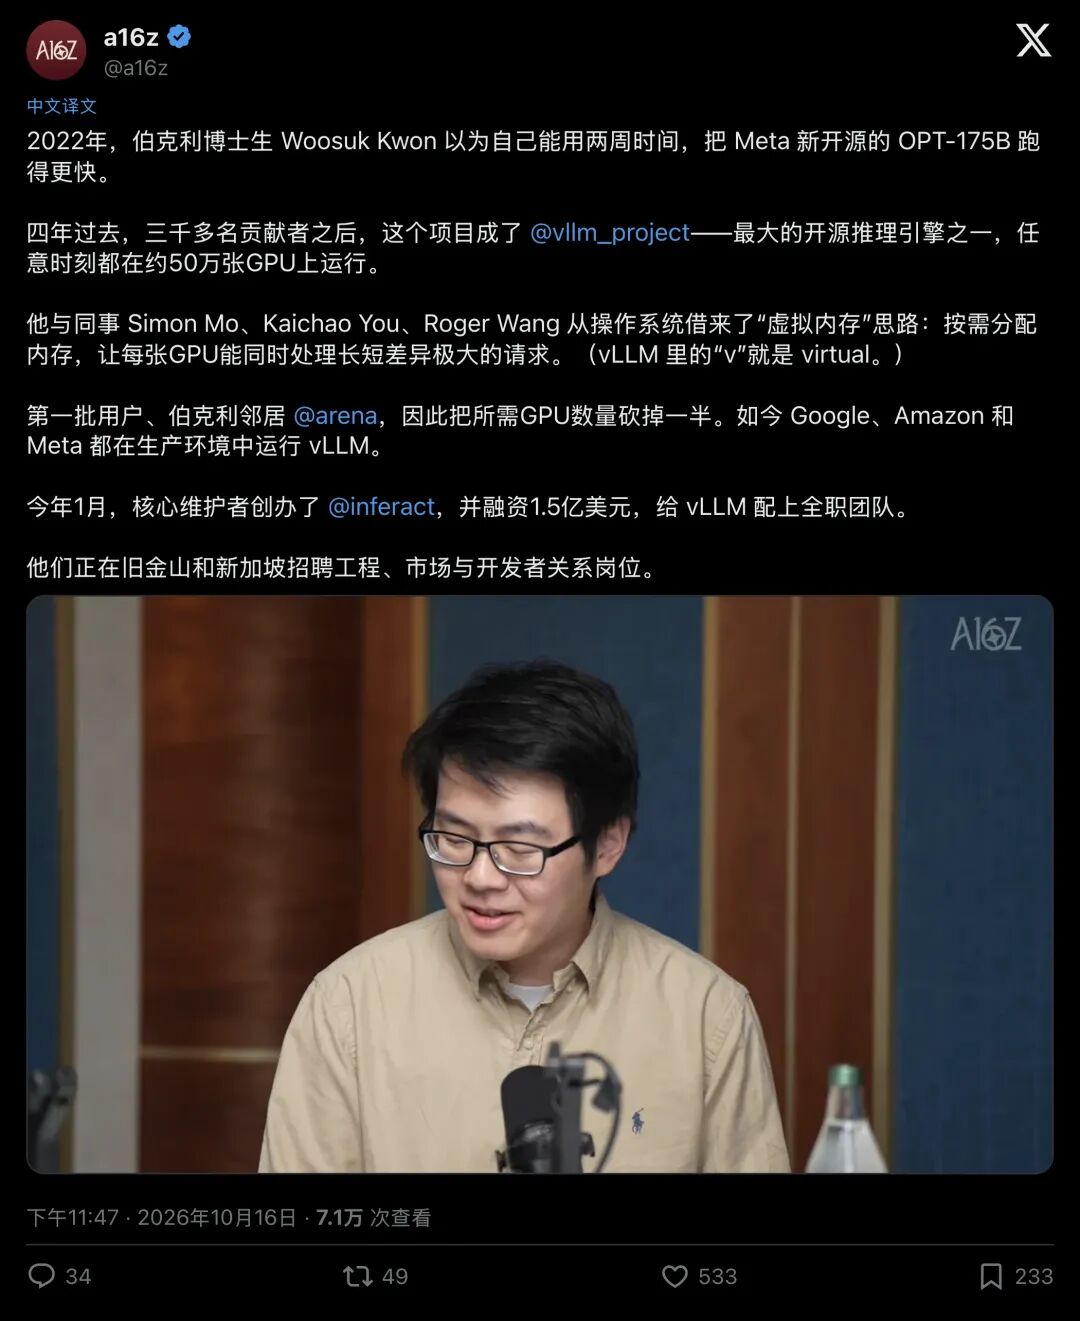
▲ a16z 官方账号复盘 vLLM 从“两周副业”变成支撑约 50 万张 GPU 开源巨兽的传奇经历
评论区的网友看热闹不嫌事大,当场总结出了计算机科学的第一定律:“开发排期里的两周,精确换算过来,等于四年外加三千号人。”
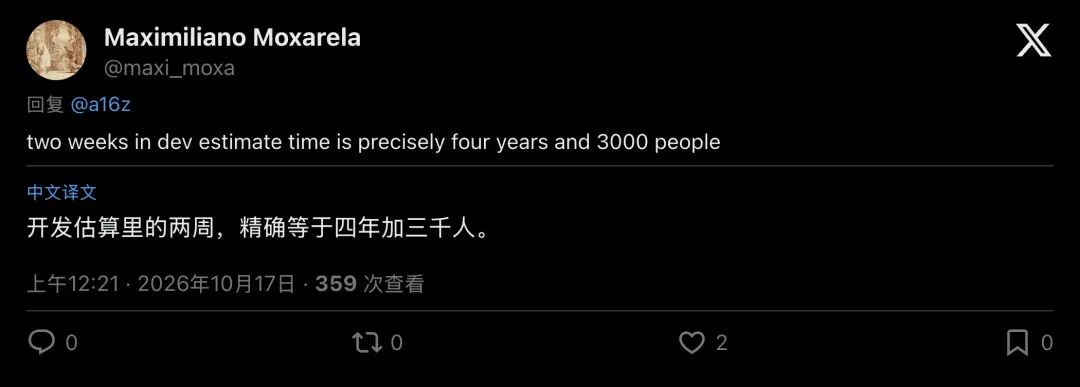
▲ 网友神吐槽:开发估算里的两周 = 四年 + 3000人
可就是这个史上最离谱的“延期工程”,在 2026 年初孵化出了创业公司 Inferact,一出手就拿下了 1.5 亿美元(约合人民币 10.8 亿元) 的天价种子轮融资。
一个穷博士的周末副业,到底是怎么捅破硅谷算力天花板的?
 节点一:2022年·最蠢的“煤老板饭店”与60年前的老黄历
把时钟拨回 2022 年。
那时候 ChatGPT 还没统治地球,Meta 刚刚开源了一个拥有 1750 亿参数的巨型模型 OPT-175B。
伯克利实验室兴冲冲地搭了个网页演示,让大家上去体验。
体验极其酸爽。
你敲进去一句“你好”,屏幕上的光标就开始原地装死,慢到让人怀疑人生。
这里得先说个大白话:训练大模型,是把海量书本喂给 AI,让它寒窗苦读背题库;
而推理(Inference),则是 AI 毕业后坐堂接客,你问一句、它答一句的现场计算。
推理看起来只是“算个答案”,但在后台却是一场灾难。
大模型有个毛病:它每往外蹦一个新字,都得把你们前面聊过的所有历史记录重新翻看一遍。
这些临时记忆叫做 KV Cache(键值缓存),全得塞进极其昂贵的 GPU 显存里。
当时的推理系统有多蠢呢?
简直像个不懂经营的煤老板开饭店。
不管进门的客人是只点一碗牛肉面(只问一句“在吗”),还是打算摆满汉全席(直接贴上来一份十万字合同),旧系统为了省事,统统按“满汉全席”的最大规格,给每位客人强制预留一张能坐 50 人的豪华大圆桌(一整块连续显存)。
结果显而易见:大厅里放眼望去全是空椅子,显存被切得七零八落,想吃饭的客人却在门外排长队。
这就是让无数工程师头秃的“显存碎片与浪费”。
Woosuk Kwon 和实验室伙伴 Simon Mo、Kaichao You、Roger Wang 盯着这堆烂摊子,懒得折腾什么玄学新数学,干脆翻开了 1962 年操作系统老祖宗的旧黄历,虚拟内存与分页(Paging)。
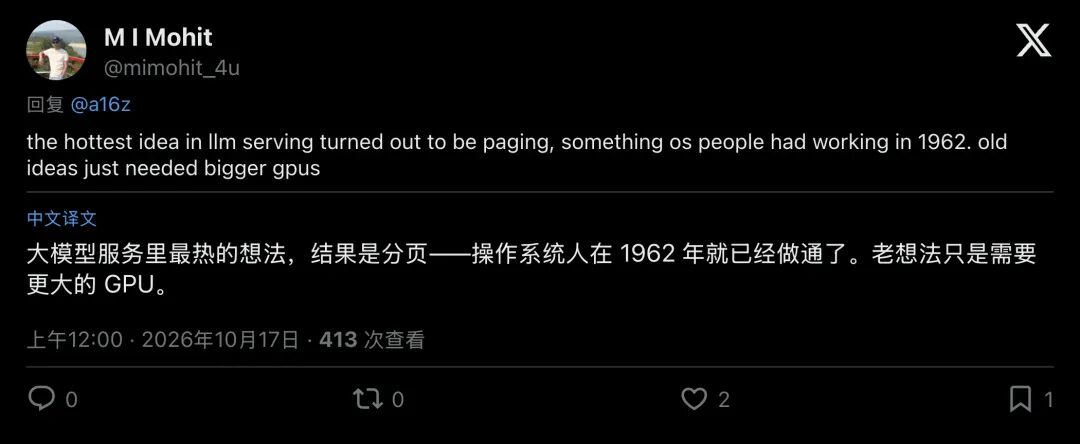
▲ 网友一针见血:大模型服务里最火的想法,其实是操作系统在 1962 年就搞定的“分页”
他们在 2023 年拿出了杀手锏 PagedAttention(分页注意力)。
做法简单粗暴:把饭店里的大圆桌全劈了,改成标准尺寸的“拼桌小方格”。
客人来一个坐一格,聊长了再动态加一格;
哪怕两个格子在物理显存里隔着十万八千里,只要前台领班手里捏着一张“座位对照表”,就能无缝拼出完整对话。
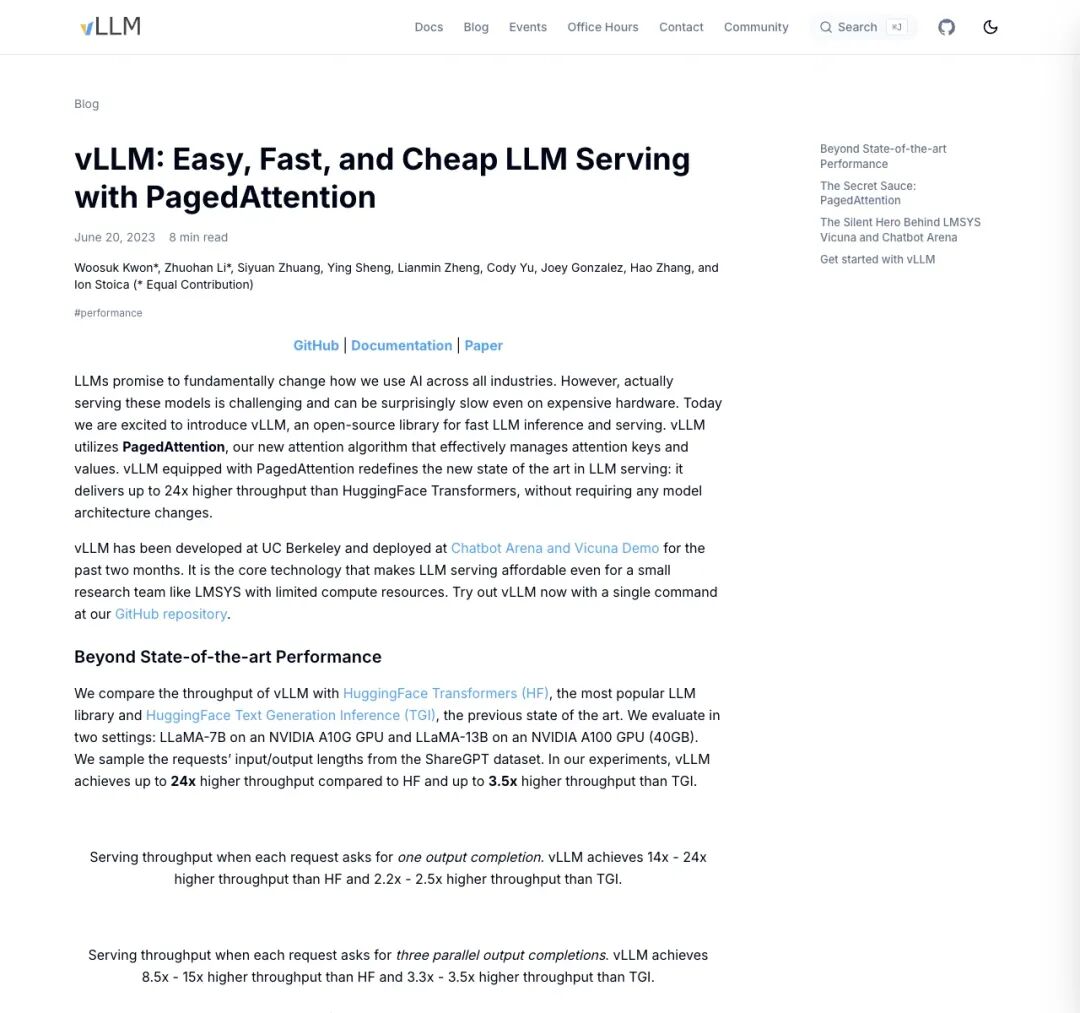
▲ 2023 年 6 月 vLLM 官方博客首次公开系统,宣布将主流大模型吞吐量提升 2 到 4 倍
vLLM 里的那个字母“v”,意思就是 Virtual(虚拟)。
不改模型一分一毫的智商,不加一块新显卡,单靠把显存塞满,系统吞吐量直接暴涨 2 到 4 倍。
 节点二:2023年·十分钟抢光的披萨,与毫不知情的“榜一大哥”
第一个吃螃蟹的,是住在他们隔壁实验室的“穷亲戚”,Chatbot Arena(大模型盲测竞技场)。
这个网站每天流量爆炸,全靠到处化缘捐来的 GPU 苦苦支撑。
换上 vLLM 的第一天,奇迹发生了:竞技场所需的 GPU 显卡数量,当场砍掉了一半。
硅谷的羊毛党和极客们瞬间闻着味儿就来了。
2023 年 10 月,vLLM 在 a16z 办公室办了第一场线下交流会。
按原计划,这场聚会顶多是几十个书呆子的茶话会,结果报名人数直接把大楼安保系统干报了警,保安紧急通知主办方,塞进来的人数已经突破消防安全红线。
现场准备的披萨,开场前十分钟就被抢得连渣都不剩。
到了 2024 年,戏剧性的一幕上演了。
电商巨头亚马逊高调上线了前台购物助手 Rufus,服务成千上万的剁手党。
那时候,Woosuk Kwon 和同伴们还是没毕业的苦逼博士生。
直到某天他们后知后觉地扒开信息才发现,亚马逊这个庞然大物底下跑的正是 vLLM。
那种荒诞的震撼感难以言表:几个穷学生坐在宿舍里网购卫生纸,点击发送的那一刻,请求正在穿越他们自己亲手写下的代码。
 节点三:2024–2025年·荒诞大反转:显卡越快,系统怎么越卡?
如果故事停在这里,那只是一群学生走狗屎运的爽文。
彻底把 vLLM 送上神坛的,是随后爆发的一场反直觉危机。
到了 2024 年下半年,硬件从 A100 升级到了怪兽级的 H100,模型结构也越来越精巧。
按理说,推理应该快到飞起才对。
但 Woosuk Kwon 却发现,推理非但没变轻松,反倒成了一块愈发难啃的硬骨头。
团队拿着显微镜对单张 H100 运行 Llama 3 8B 模型做了一次全身检查(v0.6.0 性能剖析),结果出来那一刻,所有人差点气笑:
因为 H100 算得实在太快了,跑一步模型计算只需要大约 5 毫秒。
这导致了一个极其荒谬的局面,在总运行时间里,昂贵的 GPU 显卡流汗算题的时间只占 38%!剩下整整 62% 的时间,价值几十万的顶级显卡都在原地摸鱼,眼巴巴地等 CPU 里的 Python 代码给它“派活”!
其中,33% 的时间耗在网页接口打包数据上,29% 的时间耗在调度排队上。
这就好比你高薪聘请了飞人博尔特去送外卖,博尔特跑一单只要 5 秒钟,结果每跑完一单,都得站在柜台前等老板拨算盘记账、慢吞吞扎塑料袋等上 10 秒钟。
为了把这个“慢郎中掌柜”踹开,vLLM 团队在 v0.6.0 到 2025 年初的 V1 架构重构中,干了一套极其狠辣的外科手术:
- 前店后厨彻底分家
:用高速通信(ZeroMQ)把负责接单打包的 API 服务和负责算题的引擎拆成独立进程,再也不用抢同一把锁;配合攒够几步一起派活的“多步调度”,直接让 Llama 8B 吞吐量暴涨 2.7 倍,单字延迟砍掉 80%。 - 推倒重来的 V1 大一统调度
:以前的 V0 架构由于补丁摞补丁,把“读题(预填充 Prefill)”和“答题(解码 Decode)”分得死死的。V1 架构干脆打破界限,统统按“每步字数预算”一把抓,不仅架构清爽,吞吐量还在不换算子的情况下又白嫖了 1.7 倍提升。 - 零损耗的“老汤底”复用(默认前缀缓存)
:很多用户聊天都带着几万字相同的背景文档。以前想缓存这些重复前缀,一旦没押中,CPU 查找的开销反而会让系统变慢。V1 重写了底层数据结构,做到了哪怕缓存命中率是 0%,性能损耗也低于 1%;一旦命中,速度直接原地起飞。 - 用编译器把零件焊死(
torch.compile融合):为了不用给几百种新模型挨个手写底层代码,他们引入了编译器自动改写计算图,把“分段 CUDA 图”和零散的激活、量化、跨卡通信指令硬生生焊成一个动作。光是在 8 张 AMD MI300X 上把几个小工序焊在一起,就凭空抠出了 8% 到 15% 的额外吞吐。 - “实习生猜题法”与诚实的自省(投机解码)
:为了让单个用户体验极速飙车,vLLM 搞了三条路线的投机解码,比如派个小模型当“实习生”先一口气狂猜几个词,再让 70B 的“大教授”模型一眼扫过去批改,或者直接在原文里匹配词组,处理新闻摘要时速度能飙升 2.8 倍。但极客最迷人的地方在于诚实:他们在报告里公开警告,当系统处于高并发满载时,千万别用这招! 因为教授忙着批改实习生的废话,反而会让整体吞吐倒退 1.4 到 1.8 倍。为此他们又开始死磕能看脸色行事的“动态投机”。
你看,哪有什么点石成金的魔法?
所谓的算力奇迹,全是一群聪明绝顶的年轻人在毫秒和字节的缝隙里,拿命抠出来的。
 节点四:2026年·50万张显卡的底座,与1.5亿美金的体面
当模型冲向万亿参数、芯片分化出英伟达、AMD、谷歌 TPU、亚马逊 Trainium 等八国联军,全球科技巨头突然意识到:没有 vLLM 这个中间层“万能插座”,谁家的日子都别想好过。
到 2026 年 1 月,vLLM 已经支持 500 多种模型架构、横跨 200 多种硬件加速器,当时统计有超过 40 万张 GPU 并发运行、2000 多名贡献者参与;
而到了 2026 年 10 月 a16z 最新复盘时,这个数字已经滚雪球般刷新到了任意时刻约 50 万张 GPU、3000 名开源贡献者,谷歌、亚马逊、Meta 统统在生产环境里深度依赖它。
这群终于熬出头的维护者们,决定不再只靠用爱发电。
2026 年 1 月,Simon Mo(出任 CEO)、Woosuk Kwon、Kaichao You、Roger Wang 联手伯克利传奇教授、Databricks 联合创始人 Ion Stoica,正式创立商业公司 Inferact。
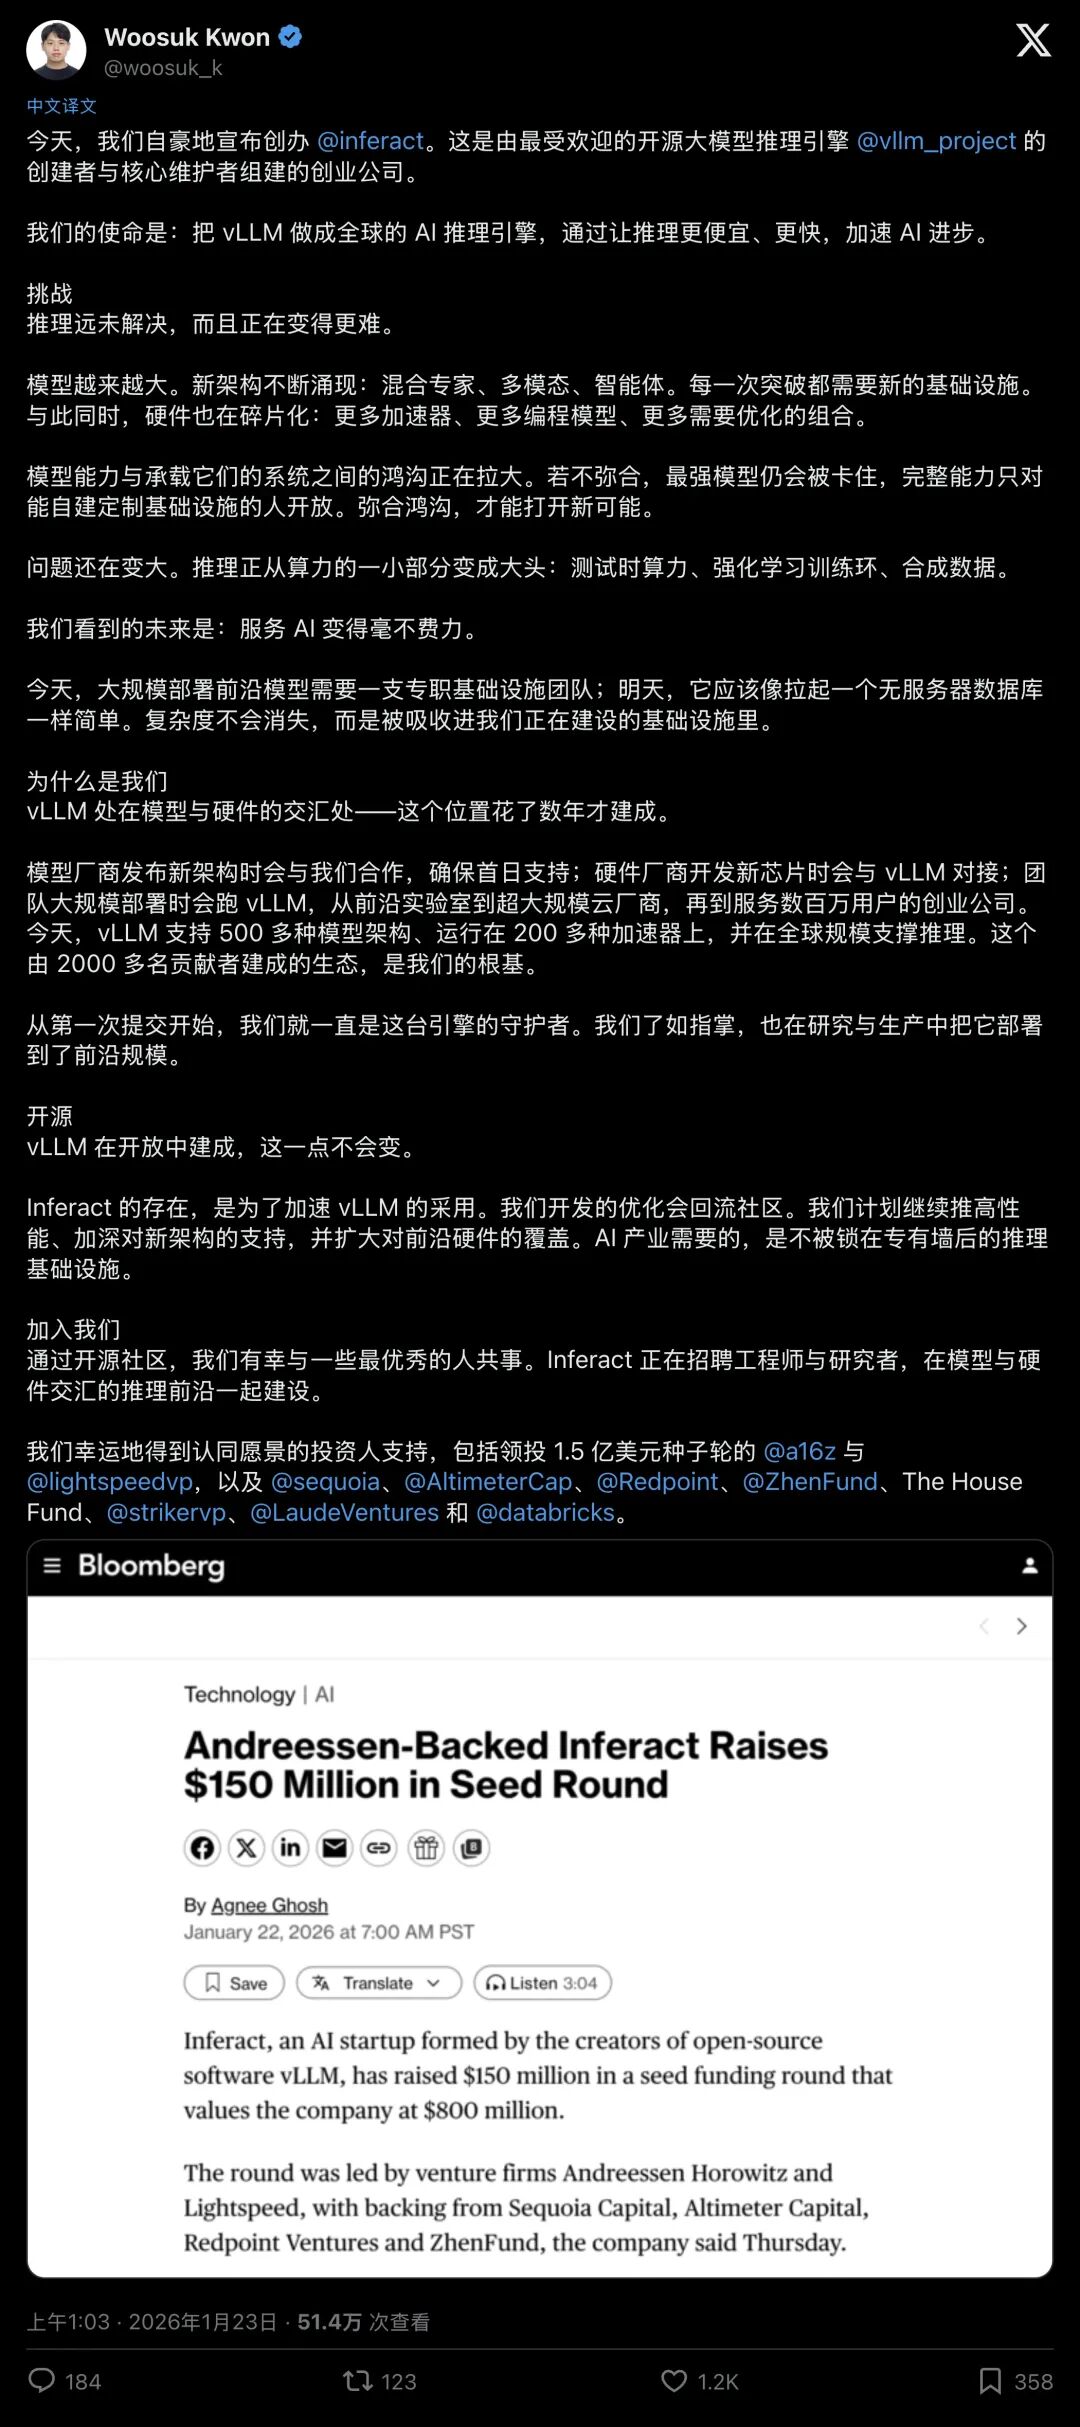
▲ Woosuk Kwon 发长文宣布创办 Inferact,坦言推理远未解决,反而愈发棘手
资本市场的反应近乎疯狂:a16z 与 Lightspeed 领投,红杉、真格基金、Databricks 相关基金等一众顶级机构跟投,直接砸下 1.5 亿美元(约 10.8 亿人民币)的史上最大规模级别种子轮,公司初创估值直奔 8 亿美元!
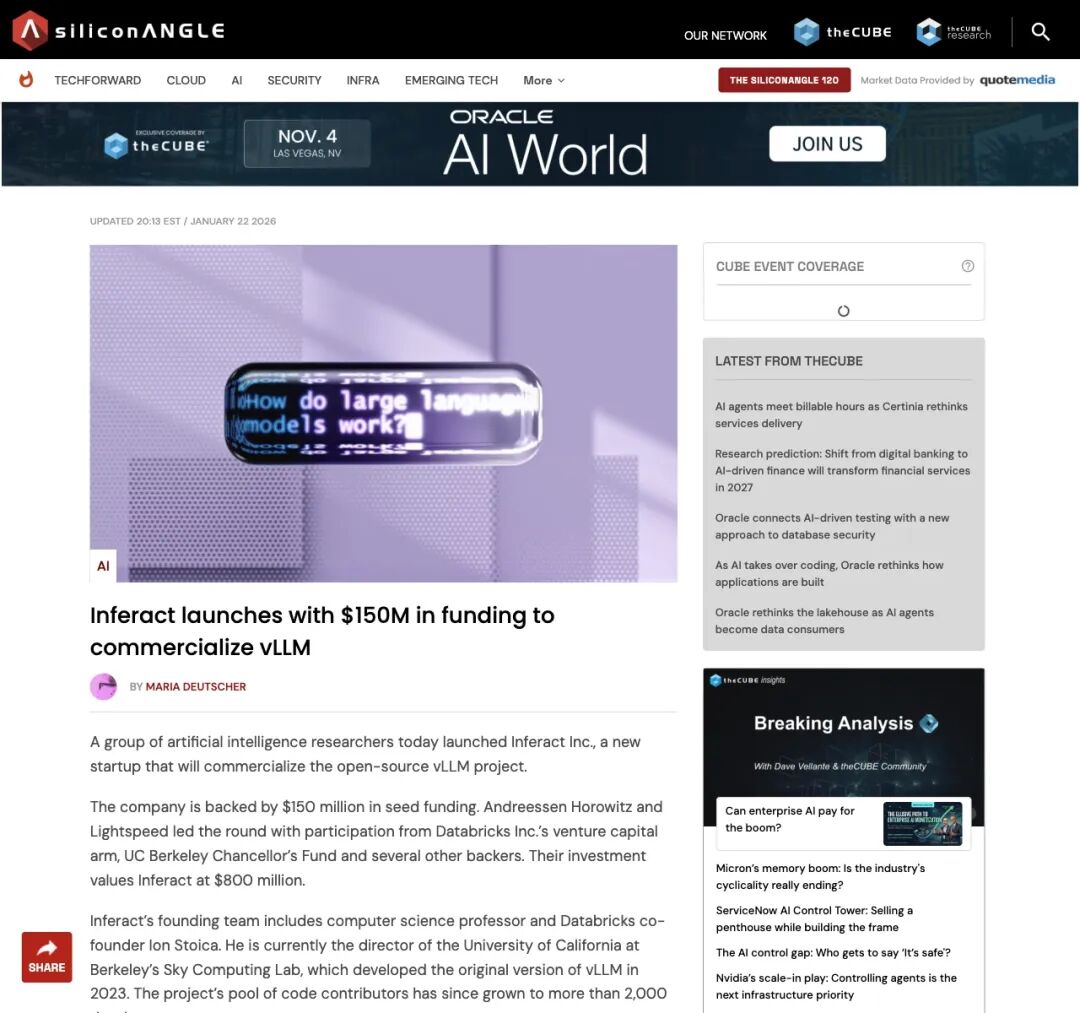
▲ 科技媒体 SiliconANGLE 报道 Inferact 携 1.5 亿美元巨额种子轮融资亮相,估值达 8 亿美元
有人担心:拿了巨资,是不是要把开源摇钱树锁进保险柜了?
恰恰相反。
Inferact 在官网和声明里把规矩立得明明白白:vLLM 永远是属于所有人的开源底座;
商业公司赚的,是帮大型企业搞定私有算力管控、异构芯片极限调优、新模型发布“首日(Day-0)无缝上线”的辛苦钱。
哪怕拿了上亿美金,到了 2026 年 10 月,这支约 40 人的团队里,身为 CEO 的 Simon Mo 依然每天在给开源社区提代码(PR)。
回看这四年,最让人感慨的,其实还是 2022 年那个下午的“两周幻觉”。
如果当时年轻的 Woosuk Kwon 能够预知未来,知道那个看似两周就能收工的小脚本,背后竟藏着一个需要重写底层调度、兼容两百种芯片、伺候五十万张显卡的无底洞,他大概率会吓得合上电脑,转身去买杯咖啡。
人类工程史上最伟大的突破,往往都诞生于一次毫无敬畏心的“盲目乐观”。
在这个人人都在吹嘘 AI 即将取代人类的狂热年代,PPT 上的概念与凭空捏造的魔法终究虚浮;
稳稳托住整个智能世界不至于崩塌的,始终是 1962 年教科书里的一页旧纸,外加一群以为“两周就能干完”的傻小子,闷头干了整整四年的水电工苦力。