ARTICLE · 1360964
千万级文档 RAG 系统设计实战:如何做到“零幻觉”?(上篇)
导读:当知识库规模膨胀到 1,000 万份文档(1.2 亿切片)、并发峰值达到 5,000 QPS,且业务方明确要求“绝对零幻觉(Zero Hallucinations)”时,一套真正能抗住企业级生产考验的 RAG 架构该如何设计?
本篇将从需求拆解、容量与流量估算、核心 API 契约出发,完整拆解异步入库流水线、混合检索重排、后置零幻觉防护层(Guardrail)以及跨存储一致性的更新与删除机制。
01 需求澄清(Clarifying Requirements)
在进入架构设计之前,我们先明确系统的功能边界与非功能性硬指标。
1.1 功能性需求(Functional Requirements)
多格式海量接入:支持用户上传 PDF、DOCX、HTML、Markdown 和纯文本等多种格式,知识库总量支持高达 1,000 万份文档。 严格基于上下文回答:用户通过自然语言提问,系统生成的回答必须严格锚定于已上传的文档——严禁使用任何外部知识。 行内精准溯源:每一条回答都必须包含行内引用(Inline Citations),精确指向对应的文本切片(Chunk)、文档标题以及页码。 多轮对话支持:支持上下文追问,后续问题能够结合历史对话语境理解(例如:“关于那项政策,文档里是怎么说的?”)。 元数据过滤:支持在查询时附加元数据过滤条件——如时间范围、部门、文档类型、作者——方便用户限定检索范围。 文档更新机制:当文档重新上传覆盖时,系统绝不能再返回基于旧版本生成的历史回答。 5 分钟级彻底删除:已删除的文档必须在 5 分钟内 从所有索引中彻底清除。 可观测性看板:管理员可以通过可视化监控后台查看文档入库任务状态与查询日志。
1.2 非功能性需求(Non-Functional Requirements)
零幻觉(Zero Hallucinations):大模型绝不能生成任何未得到检索切片直接支撑的断言。这是一项硬性的产品级保障,而非“尽力而为”的软目标。 端到端查询延迟:包含大模型生成在内,需满足 p50 小于 1.5s,p99 小于 3s。入库吞吐量:持续支撑每日新增 10 万份文档(平均约 1.2 篇/秒,并具备 10 倍突发流量的容忍度)。 检索召回率(Recall@5 > 90%):包含正确答案的文本切片必须出现在前 5 个检索结果中。 检索准确率(Precision@5 > 80%):检索出的切片必须真正切题相关,而不仅仅是主题泛相关。 系统可用性:99.9% SLA(全年停机时间不超过约 8.7 小时)。 数据时效性(Freshness SLA):更新或删除的文档必须在 5 分钟内 停止出现在回答中。 多语言支持:系统必须能够处理多种语言的文档(至少覆盖英语、印地语、西班牙语)。
02 容量与性能估算(Back-of-the-Envelope Estimation)
通过粗略计算,我们可以提前锁定存储瓶颈与算力需求:
文档与切片存储估算
总切片数:1,000 万份文档 × 平均 12 个切片/篇(每个切片 512 tokens,约 400 字节) = 1.2 亿个切片(120M total chunks)。 单条向量大小:1536 维 float32浮点数 × 4 字节 = 6 KB / 切片。向量存储总量(Qdrant):1.2 亿 × 6 KB ≈ 720 GB —— 必须跨多个节点进行分片(Sharding)存储。 BM25 倒排索引(Elasticsearch):约为原始文本大小的 1.5 倍 ≈ 150 GB。 原始文本存储(PostgreSQL):1.2 亿 × 400 字节 ≈ 48 GB。
查询流量估算
峰值 QPS:5,000 次查询/秒。 语义缓存命中率:约 40% → 意味着约 2,000 QPS 可以完全绕过检索引擎和大模型直接返回。 穿透至检索层的剩余 QPS:约 3,000 QPS。 单次检索开销:并行执行 1 次近似最近邻搜索(Qdrant ANN) + 1 次关键词搜索(Elasticsearch BM25)。 单次大模型调用消耗:约 800 个输入 tokens(5 个切片 × 160 tokens) + 约 200 个输出 tokens = 1,000 tokens / 次。 推理总吞吐:在 3,000 次调用/秒 × 1,000 tokens 下,推理吞吐高达 300 万 tokens/秒(3M tokens/sec) —— 必须依赖高吞吐推理集群(如自建 vLLM 集群或企业级高配 API)。
入库吞吐估算
日常平均速率:10 万篇/天 ≈ 1.2 篇/秒。 向量化批处理:每篇文档约 12 次 Embedding 计算,按 2,048 个切片/批 打包调用。在 1.2 篇/秒 × 12 切片 = ~15 切片/秒的速率下,远低于单个 Embedding 节点的处理上限。 10 倍突发流量扛压:15 篇/秒 = 180 切片/秒 → 仅需扩容至约 3 个 Embedding Worker Pod 即可平稳应对。
03 核心 API 接口设计(Core APIs)
1. 文档入库接口(Ingestion API)
POST /v1/ingestBody: {”source_url”: ”string”, // S3 预签名下载链接或直传 URL”doc_id”: ”string”, // 客户端提供的幂等键(Idempotency Key)”metadata”: {”title”: ”string”,”author”: ”string”,”department”: ”string”,”date”: ”2024-06-01”,”language”: ”en”}}Response: { ”job_id”: ”uuid”, ”status”: ”queued”, ”estimated_chunks”: 12 }GET /v1/ingest/{job_id}Response: {”status”: ”done” | ”processing” | ”failed”,”chunks_created”: 1240,”error”: null}
2. 智能问答接口(Query API)
POST /v1/queryBody: {”question”: ”string”,”conversation_id”: ”string”, // 用于关联多轮对话上下文”top_k”: 5,”filters”: {”department”: ”legal”,”date_after”: ”2023-01-01”,”language”: ”en”}}Response: {”answer”: ”string”,”citations”: [{”chunk_id”: ”uuid”,”doc_id”: ”uuid”,”title”: ”Annual Report 2024”,”page_num”: 12,”excerpt”: ”...相关原文片段...”,”score”: 0.94}],”confidence”: 0.91,”cache_hit”: false,”latency_ms”: 1240}
3. 文档管理接口(Document Management APIs)
DELETE /v1/docs/{doc_id}Response: { ”deleted_chunks”: 12, ”vectors_purged”: true, ”cache_invalidated”: true }PUT /v1/docs/{doc_id}Body: { ”source_url”: ”string”, ”metadata”: {...} }Response: { ”job_id”: ”uuid”, ”replaces_version”: ”old_checksum” }GET /v1/docs/{doc_id}/statusResponse: { ”status”: ”active”, ”chunks”: 12, ”last_indexed”: ”2024-06-01T12:00:00Z” }
04 总体架构设计(High-Level Design)
4.1 场景一:文档异步入库流水线(Document Ingestion)
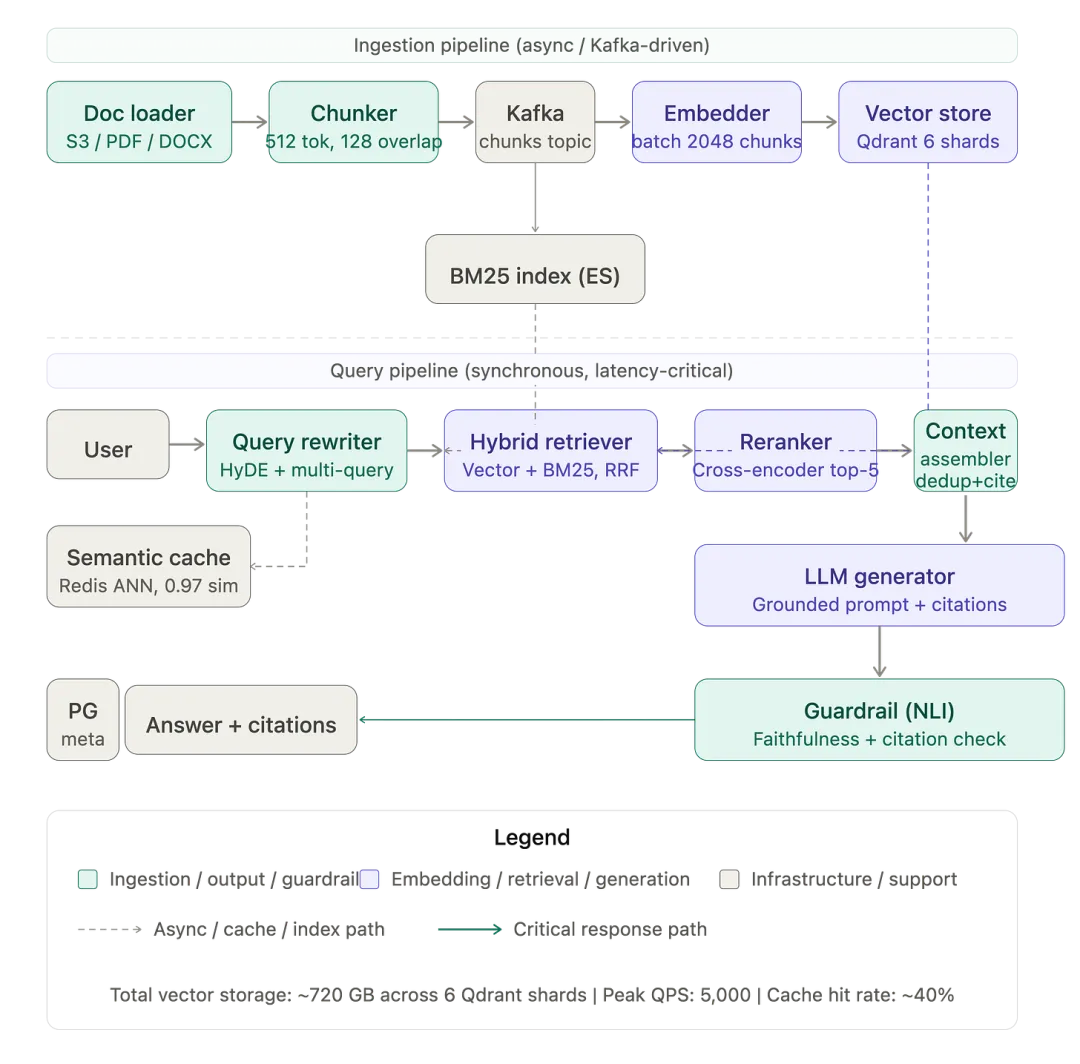
整条入库流水线采用全异步、Kafka 驱动架构,确保每个处理阶段都能独立水平扩缩容,且单点故障时可直接重试,无需重启整条流水线。
Document Loader(文档加载器) 接收来自 API 的入库任务,使用预签名 URL 从 S3 拉取原始文件。 执行格式检测(PDF、DOCX、HTML)并分发给对应的解析器:针对 PDF,使用能够提取文本并保留页码元数据的解析器;针对 DOCX,提取段落与标题结构。 输出:为每篇文档生成 (raw_text, metadata)数据对,推送至 Kafka 的raw-docs主题。Chunker(智能切片器) 消费 raw-docs主题。采用递归句子边界感知切分器(Recursive Sentence-Boundary-Aware Splitter):优先尝试在段落换行处切分,其次在句号/句子边界处切分,最后在词边界处切分——绝不在句子中间生硬切断。每个切片上限 512 tokens,并与相邻切片保留 128 tokens 的重叠区(Overlap),确保跨越切片边界的完整答案不会被遗漏。 每个切片携带 doc_id、chunk_index、prev_chunk_id、next_chunk_id、page_num以及父文档的完整元数据,推送至chunks主题。Embedding Worker(向量化工作节点) 消费 chunks主题。为提升吞吐效率,每次批量打包最多 2,048 个切片调用text-embedding-3-small接口,生成 1536 维float32向量数组。支持无状态水平扩展:在 10 倍入库洪峰时动态拉起更多 Pod 节点。处理完成后将 (chunk_id, vector, metadata_payload)推送至vectors主题。Vector Store Writer(向量库写入器) 消费 vectors主题,将数据写入(Upsert)Qdrant,并将切片的doc_id存为 Payload 字段,以便后续删除操作按文档 ID 过滤。采用批量写入(1,000 条向量/批)以保障高吞吐。BM25 Indexer(BM25 倒排索引器) 直接并行消费 chunks主题(无需等待向量化完成),将原始切片文本连同元数据字段写入 Elasticsearch。由于 BM25 建索引的速度通常比向量化快 10 倍,它会远早于向量库写入完成。这意味着对于刚入库的新文档,关键词检索会比语义检索更早上线生效——这是一个非常实用的工程特性。 PostgreSQL Writer(元数据与状态落库) 写入 doc与chunks数据行;当 Qdrant 和 Elasticsearch 均确认写入成功后,将入库任务状态标记为done。
4.2 场景二:在线智能问答流水线(Answering a Query)
查询流水线是全同步且对延迟高度敏感的。关键路径上的每一个组件都必须在严格的时间预算内完成执行。
在触发任何检索操作前,系统先计算用户问题的 Embedding(耗时约30ms),并在Redis中通过 ANN 与历史缓存问题的向量进行比对(设定余弦相似度 > 0.97的高阈值)。
命中缓存:在 < 5ms 内直接返回存储的答案。
未命中:继续执行后续流水线。虽然未命中时会增加 30ms 开销,但命中时能省下超过 2 秒的延迟——在 40% 命中率下,这笔账永远划算。
HyDE(Hypothetical Document Embeddings,假设性文档嵌入):调用一个轻量、高速的小模型,针对用户问题生成一段 2~3 句话的“假设性答案”,然后对这段假设答案进行向量化。相比简短生硬的原始提问,假设答案的用词在语义空间中更贴近真实文档切片。例如,提问 “退款政策是什么?” 会被转化为 “客户可在购买后 30 天内联系客服申请退款……”——这与真实政策文档的表达高度契合。
Multi-query Decomposition(多查询拆解):针对复杂问题(例如 “对比 Q1 和 Q2 的营收并解释差异原因”),将其拆分为多个独立子问题:“Q1 营收是多少?”、“Q2 营收是多少?”、“导致差异的原因是什么?”。每个子问题独立检索后再合并结果,避免单一子主题主导整个召回列表。
Vector ANN(Qdrant 稠密检索):使用 HyDE 扩展后的向量,将元数据过滤条件作为 Qdrant Payload 过滤器(如
department = "legal",date > "2023-01-01"),基于 HNSW 算法检索最相似的 Top 50。当 HNSW 参数设为ef=128时,单分片延迟 < 50ms 即可达到约 95% 的召回率。BM25(Elasticsearch 稀疏检索):将原始问题文本(连同拆解后的子问题)作为 BM25 查询语句,附加相同的元数据过滤条件,按 BM25 得分返回 Top 50 结果。
RRF(Reciprocal Rank Fusion,倒数排序融合):无需对两套完全不同的打分量纲做归一化,直接按排名位置融合双路结果:
常数 60 是经过大量实验调优的经验值,用于平衡准确率与召回率。按 RRF 得分排序后的Top 50切片进入精排阶段。
ANN 和 BM25 检索使用的是“双塔编码器(Bi-encoder)”——即问题与文档分别独立向量化,虽然速度快但精度有限。精排阶段引入交叉编码器(bge-reranker-v2-m3),将用户问题与每个候选切片拼接在一起进行联合编码,从而捕捉否定词、精确措辞以及指代消解等细粒度语义交互。模型对全部 50 个候选打分后输出Top 5。该步骤耗时约150ms,却是提升最终回答质量贡献最大的单一环节。
拿到 Top 5 核心切片后,执行以下组装动作:
Small-to-Big 上下文扩展:根据每个切片的 prev_chunk_id和next_chunk_id,从 PostgreSQL 中捞取其前后相邻切片并拼接(即“由小及大”检索模式——用小切片保证检索精度,用相邻切片保证上下文完整性)。内容去重:合并并去除重叠的文本片段。 格式化引用编号:组装成带编号的上下文字符串: [1] <切片文本> (来源: Annual Report 2024, 第 12 页)。Token 预算控制:严格限制在 6,000 tokens 的上下文窗口预算内,优先级最高的切片优先保留。
接收经过精心设计的系统提示词(Prompt):
System: 你是一个文档问答助手。请【仅】使用下方带编号的参考段落进行回答。你陈述的每一个事实,都必须在句末用方括号标注对应的引用编号,例如 [1]。如果没有任何段落能支撑某项结论,请直接输出 [NOT FOUND],严禁猜测。严禁使用任何外部知识。Passages:[1] <chunktext> (Annual Report 2024, p.12)[2] <chunktext> (Policy Manual v3, p.4)...User: <question>
这种结构化 Prompt 让引用标注变得非常自然(模型直接面对带编号的段落),同时明令禁止使用外部知识,大幅压低了幻觉率。
在大模型生成结果后、返回用户前,执行四步自动化核验:
事实断言提取:从生成的回答中逐条抽取出所有的事实性断言(Factual Claims)。 NLI 蕴含校验:针对每条断言,调用 NLI(自然语言推理)模型比对它与所引用原始段落之间的逻辑得分——如果判定为矛盾(Contradiction)或中立无依据(Neutral),立即将该条断言标记为异常。 引用覆盖率检查:强制校验回答中的每一句话都必须包含至少一个 [N]引用编号,且该编号必须真实映射到本次检索的切片。阈值熔断与局部脱敏:
如果整篇回答的忠实度得分(Faithfulness Score)< 0.9,直接整段拒绝,并替换为兜底话术:“在现有文档中未能找到可靠的答案。” 如果忠实度得分 ≥ 0.9 但个别句子被标记为异常,则精准剔除(Redact)这些有问题的句子。
4.3 场景三:文档更新与删除(Document Updates and Deletions)
数据陈旧(Staleness)是一种极其隐蔽的幻觉——系统会一本正经地返回一个“在建索引时正确、但现在已经过时”的错误答案。要杜绝这种现象,必须在四套存储引擎之间实现严格一致的清理机制。
PostgreSQL 原子软删:在 PostgreSQL 中将该文档状态标记为 status = "deleted"——原子操作,立即生效。清理 Qdrant 向量:删除所有 payload.doc_id = doc_id的向量点——Qdrant 原生支持按条件过滤删除,12 个切片通常在 1 分钟内 清理完毕。清理 Elasticsearch 索引:删除所有包含该 doc_id的倒排索引文档。精准清除 Redis 语义缓存:扫描并删除所有 citations数组中包含该doc_id的缓存条目——通过写入时维护的二级反向索引(doc_id -> [cache_keys])+ Redis Lua 脚本高效完成清理。
幂等校验:计算新文档的校验和(Checksum)。如果与库中存储的旧 Checksum 一致,直接跳过(保证幂等性)。 先删后建保证无脏读窗口:如果校验和不同,原子递增 doc_version,完整执行上述四步删除流程,然后再触发新版本文档的入库流水线。旧向量在写入新向量前已被彻底清除,从而确保绝不会出现“新旧版本切片同时被检索出来”的时间窗口。
4.4 架构全景总结(Putting It All Together)
整套系统的入库流水线与查询流水线完全解耦——二者仅以 Qdrant 和 Elasticsearch 索引作为交汇边界。这意味着:
入库流量的突发洪峰不会拖慢在线查询延迟,反之查询高峰也不会阻塞文档入库; Kafka 在入库各阶段之间充当了可靠的持久化缓冲带; 语义缓存大幅削减了高频重复或语义相似问题对检索层与大模型推理层的压力——在 40% 缓存命中率下,直接省去了 40% 的全链路计算成本。