ARTICLE · 1361129
WPS正则函数REGEXP完全教程【建议收藏】
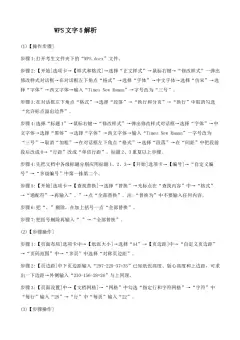
同事整理 5000 条地址要几天,我用regexp函数 30 秒搞定
【常用符号、应用规则、17 个案例,常用公式随便抄】
上周五下班前,行政丢过来一个表:5000 条收货信息,姓名、电话、地址全挤在一个单元格里,让周一前拆成三列。
同事当场脸色就变了。这活用 RIGHT、LEFT、MID、FIND 套着写,收货信息乱七八糟,做两三天都未必做出来。。
而我花了几分钟观察一下数据规律,一个函数,一条公式,几分钟完成。
这个函数就是今天我们要讲的:REGEXP,WPS2024版以上才有的新函数,专门用于文本提取、判断、替换,适用正则表达式。
今天我就从0至1详细讲一次,教程很细很长,你能耐心认真看完,保证你能学会并精通这个强大的函数,以后再不想用RIGHT、LEFT、MID、FIND。(文末附了全套公式模板,复制改个单元格就能用)。
有些同学说,太难太多了,记不住。
其实,你不需要全记住。理解规则和用法就行,先收藏下来,遇到问题时,翻出来看一下,用到哪条抄哪条。

左边是地狱,右边一句话。
一、REGEXP 到底是个什么函数
REGEXP 是 WPS 表格的正则表达式函数。
正则表达式你没听过也没关系,把它理解成一种“描述文字长相”的语言。比如“以 1 开头、后面再跟 10 位数字”,用正则写就是 ^1\d{10}$。
平时我们查找替换里用的那个 * 和 ? 的通配符,也算是这个意思。
REGEXP函数的参数是这样的:
=REGEXP(原字符串, 正则表达式, [匹配模式], [替换内容])
四个参数,前两个必填,后两个选填,我们一个个说:
参数一,原字符串。
要处理的文本,可以是单元格引用,也可以直接写字面文本,新版还支持给一整列。
参数二,正则表达式。
描述你要找的“长相”,必须用英文双引号包起来。
参数三,匹配模式。
0 提取、1 判断、2 替换、3 完整提取,不写默认 0,四种模式一张图看明白:

一个函数四种模式,记不住就收藏这张图。

四个参数各管一段,结构就长这样。
参数四,替换内容。
只有模式是 2 时才用得上,不写就替换成空。
顺带说一句,微软 Excel 到 2024 年才补上正则函数,还拆成了三个,而且现在只有 365 版本能用,所以,如果你的EXCEL不是365版本,也用不了这个函数。
你电脑上的 WPS 还是老版本,先把软件更新了,不然下面所有公式一个都跑不起来。
二、REGEXP 支持哪些正则符号?
正则里那些 “\d、[一-龟]” 之类的东西,叫元字符。下面按分类简单过一遍:
1)匹配字符本身。
字母、数字、汉字,写什么就匹配什么。想匹配小数点、括号这类特殊符号,前面加个反斜杠转义。
2)快捷字符类。
\d 数字 \D 非数字 \w 字母数字下划线 \W 反之 \s 空白 \S 非空白
比如:\d 等价于 [0-9],\w 等价于 [A-Za-z0-9_],\s 覆盖空格、制表符、换行。
例:=REGEXP(A2,"\d{11}") 提出 11 位数字
3)自定义字符类 [ ]。
方括号里写允许出现的字,[0-9] 就是任意数字;开头加 ^ 表示“不要这些”,[^0-9] 是任意非数字。
想匹配汉字,用 [一-龟]:从“一”到“龟”,覆盖了常用汉字的编码区间,这是中文里的高频写法,此外,还有“[一-龥]”或者“[一-﨩]”。
这三个写法有什么区别?主要是对偏辟字的识别上的区别,“[一-﨩]”能识别的字数最多;
4)锚点:只站位置,不吃字符。
^ 开头 $ 结尾 \b 单词边界 \B 非边界
例:^张 只认“张”开头的;张$ 只认“张”结尾的
5)量词:说次数。
* 零次或多次 + 一次或多次 ? 零次或一次 {n} 正好 n 次 {n,} 至少 n 次 {n,m} n 到 m 次
例:\d{4} 正好 4 位数字,年份常用
量词默认贪婪,能多吃就多吃;加个 ? 就变非贪婪,能少吃就少吃。
贪婪是什么意思?到底怎么个贪法,后面第四节专门讲,先接着往下看。
6)分组和引用。
小括号把一段包起来叫捕获组,从 1 开始编号;替换内容里用 $1、$2 引用它们。
例:(ab)+ 把“ab”当一个整体,重复一次以上
7)环视断言。
(?=内容) 后面跟着它才匹配;(?<=内容) 前面是它才匹配;换成 ! 就是否定版。环视只“看”不“吃”。
例:(?<=订单号)\d+ 提出订单号后面的数字
8)剩下几个零散的。
| 或者 \K 前面匹配的不算结果 \t 制表符 \n 换行
例:苹果|香蕉 两者之一;上海\K浦东 只交“浦东”
符号有点多,正常。文末附录有完整速查表,用到哪个回来翻哪个。

七类符号一张图,先混个脸熟。
光看符号容易晕?我们拿条真公式拆一遍就通了:

手机号公式拆开,就是五个零件拼在一起。
三、在 WPS 里写正则,先记住这八条规则
规则一:提取模式返回全部匹配。
默认模式 0 是全局匹配。一句话里有两个数字,它给你吐两个,排成一列。
比如“北京 上海”里写 \S+,结果会是“北京”“上海”两个。
规则二:默认区分大小写,而且没有开关。
WPS 的 REGEXP 没有“忽略大小写”参数。要找 Excel 这个词,只能写 [Ee][Xx][Cc][Ee][Ll] 这类笨办法。
规则三:结果永远是文本。
提取出来的 129.9 是文本不是数字,直接 SUM 会是 0。前面加两个减号 --,或者乘个 1,才转成真数字。
规则四:正则要用英文双引号包。
从网页复制公式时,全角引号会悄悄混进来,WPS 不认,报错报得莫名其妙。
规则五:特殊字符要转义。
想匹配字面的句号、方括号、小括号,前面加反斜杠。删掉“备注[已核对]”,正则要写 \[[一-龟]+\]。
规则六:三种模式没匹配到时,表现不一样。
提取模式返回 #N/A;判断模式返回 FALSE,不报错;替换模式原样返回原字符串。
规则七:[一-龟] 够用,但不是全部汉字。
它覆盖的是常用汉字区间,生僻字可能漏。日常办公数据基本碰不到。
规则八:只讲 WPS 实测能跑通的语法。
网上很多正则教程讲的是别的引擎的语法,跟 WPS 不完全一样。下面这些案例我都跑过,放心抄。
四、贪婪与断言:最容易绕晕的两个概念,一次说透
前面讲符号时已经碰到它们了。这节单独拎出来讲透,不然公式换个场景你就不会改了。
先说贪婪:默认能多吃就多吃。
量词 *、+、?、{n,m} 默认都是贪婪的,只要能多匹配,它绝不手软。
拿“北京[海淀]上海[浦东]”举例,用 \[.*\] 匹配时,它从第一个 [ 一路吃到最后一个 ],整段全取完。
因为 . 匹配任意字符,* 又能多吃就多吃,中间的内容它照单全收全部读取。

差一个问号,匹配结果完全两样。
非贪婪:量词后面再加个问号。
在量词后面再加一个 ?,就变成非贪婪,能少吃就少吃。\[.*?\] 只吃到第一个 ] 就收手。
逐个提括号 =REGEXP(A2,"\[.*?\]")
一把全抓 =REGEXP(A2,"\[.*\]")
想逐个提出每个括号里的内容,用非贪婪;想抓从第一个括号到最后一个括号的整段,才用贪婪。
再补一条规则:{n,m} 也是贪婪的。
a{2,4} 去匹配“aaaa”,会吃满 4 个,不是 2 个。想让它吃最少,写 a{2,4}?。
顺便说下底层逻辑:贪婪是“先多吃,不够再吐”,非贪婪是“先少吃,不够再拿”,正则引擎会自动往回找,你不用管。
一句话:想提“第一个到第一个”,量词后加 ?;想一把抓到底,别加。
再说断言:只看位置,不吃字符。
断言分四种:(?=...) 后面是它,(?!...) 后面不是它,(?<=...) 前面是它,(?
它有个外号叫“零宽断言”:只是站在那里看一眼,自己一个字都不占。
所以匹配结果里永远不会有断言的内容,但你要求的前后文,一个都不能少。

“实付”和“元”只是看一眼,结果只交 129.9。
四种断言,配四个例子。
后面是 \d+(?=元) 匹配“88元”里的 88
后面不是 \d+(?!元) 匹配“88块”里的 88,不碰“88元”
前面是 (?<=实付)\d+ 匹配“实付88”里的 88
前面不是 (?
看后两个例子的差别:后行断言管的是匹配内容“前面”是谁,先行断言管“后面”是谁。
断言和 \K 可以互相替代,各有各的顺手处。
订单号\K\d+ 和 (?<=订单号)\d+ 结果一样:都只交数字。\K 好写,断言更灵活,替换模式下只能用断言。
写断言的三个注意点。
一是断言的括号里写什么正则都行,但后行断言尽量写固定长度的内容,比如一个字、一个括号,别写 .* 这种没边界的,以实测为准。
二是别在问号和等号之间手滑敲了空格,(?= 元) 是不对的。
三是断言在替换时特别有用:只替换数字、保留前后文,脱敏公式就是这么干的。
贪婪管“吃多少”,断言管“在哪吃”。这两个概念过了,正则就通了八成。
五、实战案例:从入门到组合
先判断,再提取,后替换——大多数文本清理的活,都能拆成这三步。下面按这个顺序上案例。
案例1:判断手机号对不对
=REGEXP(A2,"^1[3-9]\d{9}$",1)
拆开看:^ 从头开始,1 字面匹配,[3-9] 第二位只能是 3 到 9,\d{9} 再跟 9 位数字,$ 到结尾。11 位手机号一次校验完。

错一位、多一位,都逃不过。
案例2:判断身份证号
=REGEXP(A2,"^\d{17}[\dXx]$",1)
前 17 位数字,最后一位数字或者 X,大小写都算。18 位身份证的格式校验就够用了。
案例3:判断邮箱像不像邮箱
=REGEXP(A2,"^[\w.]+@[\w-]+(\.[\w-]+)+$",1)
简化版,日常够用:要求“一串字母数字@一串字母数字.域名”的结构。
案例4:判断有没有中文
=REGEXP(A2,"[一-龟]",1)
只要字符串里出现任意一个汉字就返回 TRUE。查乱码、查中英混排很好用。
案例5:提取数字
=REGEXP(A2,"\d+")
“订单 20231113 已发货”直接提出 20231113。提出来是文本,要计算就写 =--REGEXP(A2,"\d+")。
案例6:提取姓名
=REGEXP(A2,"[一-龟]+")
从“张三 13800138000”里把张三提出来。连续汉字,就是姓名的常见长相。
案例7:提取“元”字前面的金额
=REGEXP(A2,"\d+(\.\d+)?(?=元)")
\d+ 是整数部分,(\.\d+)? 是可有可无的小数,(?=元) 要求后面必须跟着“元”,但“元”本身不吐出来。

姓名、金额,都是这么提的。
案例8:提取括号里的内容
=REGEXP(A2,"(?<=().*(?=))")
(?<=() 要求前面是中文括号,(?=)) 要求后面也是,中间全要。颜色备注、规格说明都这么提。
案例9:提取关键词后面的数字
=REGEXP(A2,"订单号\K\d+")
\K 把“订单号”匹配了但不交结果,只把后面的数字给你,比环视好写好懂。
案例10:删掉批注
=REGEXP(A2,"\[[一-龟]+\]",2,"")
模式写 2,第四参数空,中括号里的汉字全删。注意 [ ] 在正则里是特殊符号,得写成 \[ 和 \]。
案例11:手机号脱敏
=REGEXP(A2,"(\d{3})\d{4}(\d{4})",2,"$1****$2")
前三位存进组 1,后四位存进组 2,中间四位换成星号。名单导出、公示场景都用得上。

组 1 和组 2 各抓一段,中间换成星号。
案例12:统一日期格式
=REGEXP(A2,"(\d{4})[/-](\d{1,2})[/-](\d{1,2})",2,"$1-$2-$3")
2024/1/5、2024-01-05 混在一列,这条公式把斜杠、横杠统一成横杠。
案例13:清理多余空白
=REGEXP(A2,"\s+",2," ")
连续的空格、制表符、换行,压成一个空格。
案例14:一个单元格里多个金额,直接求和
=SUM(--REGEXP(A2,"\d+(\.\d+)?(?=元)"))
REGEXP 把单元格里所有金额提成一列,-- 转成数字,SUM 一把加完。报销明细单这招最常用。
案例15:算体积
=PRODUCT(--REGEXP(A2,"\d+"))
“箱子 40×30×20cm”提出三个数,PRODUCT 一乘,24000 立方厘米。
案例16:整列判断、整列提取
=REGEXP(A2:A500,"^1[3-9]\d{9}$",1)
第一参数直接给区域,公式一次写完,结果自动铺满整列。这是 17813 以上版本才有的能力。
老版本不支持数组也不要紧,公式下拉一行行算,结果一样。
案例17:模式 3,每行多个结果全拿出来
=MAP(REGEXP(A2:A8,"[一-龟]+",3),ARRAYTOTEXT)
模式 3 把每行的全部匹配包成数组,配 MAP 和 ARRAYTOTEXT 展开、拼回对应的行。一行三个名字,三个全给你。

普通提取只给第一个,模式 3 全都要。
六、应用案例:五个工作场景,一步到位
前面是单个公式,下面五个是整套做法,每个都能直接套到你的表里。
场景一:500 条收货信息,拆成三列
A 列是“张三 13800138000 北京市朝阳区望京街道10号楼501”这种混排,三列公式分别是:
B 列姓名 =REGEXP(A2,"^[一-龟]+")
C 列手机 =REGEXP(A2,"1[3-9]\d{9}")
D 列地址 =REGEXP(A2,"^[一-龟]+|1[3-9]\d{9}",2,"")
前两列是提取;地址列反过来,把姓名和手机号替换成空,剩下的就是地址。不用去猜地址长什么样。
小结:提不干净的东西,就用替换删掉它,剩下的全是你要的。

B、C 列负责提取,D 列负责“剩下的全是我的”。
场景二:报销单金额一键汇总
=SUM(--REGEXP(A2:A50,"\d+(\.\d+)?(?=元)"))
五十行报销明细里的所有金额,一条公式求和。前提是版本支持数组参数。
小结:求和前先 --,这是新人最容易漏的一步。
场景三:一摞简历,批量提出手机号和邮箱
=MAP(REGEXP(A2:A100,"1[3-9]\d{9}",3),ARRAYTOTEXT)
=MAP(REGEXP(A2:A100,"[\w.]+@[\w-]+(\.[\w-]+)+",3),ARRAYTOTEXT)
简历文本直接粘进 A 列,两条公式把每份简历的联系方式一次提干净。
小结:数组公式一次写、整列算,简历再多也不怕。
场景四:系统导出的脏数据,一次洗白
去掉标签 =REGEXP(A2,"<[^>]+>",2,"")
压缩空白 =REGEXP(A2,"\s+",2," ")
统一日期 =REGEXP(A2,"(\d{4})[/.](\d{1,2})[/.](\d{1,2})",2,"$1-$2-$3")
网页导出的数据,八成脏在标签、空白、日期这三样,三条公式套一遍基本就干净了。
小结:三条公式连起来用,脏数据洗一遍基本就能用。

洗之前进不了透视表,洗之后随便用。
场景五:身份证号录错了,当场标红
选中 A2:A100,条件格式,新建规则,使用公式确定格式,填:
=REGEXP(A2,"^\d{17}[\dXx]$",1)=FALSE
格式设成红底。以后谁把身份证号敲错了,单元格当场变红,不用等人力月底对账才发现。
小结:校验类的活,交给条件格式比事后查表靠谱。

录错标红,比事后查省一整天。
记住一个顺序:先判断,再提取,后替换。大多数文本清理的活,都能拆成这三步。
七、避坑指南:这几个错误,八成人都踩过
坑一:#N/A 不是公式写错了,是没匹配上。
提取模式下找不到匹配就返回 #N/A。别急着改公式,先确认数据里到底有没有你要的“长相”。不想报错就套一层 IFNA。
坑二:#SPILL! 是结果没地方放。
提取结果是一列,下面的单元格被占了就报溢出。清出空白区域就行。
坑三:忘了转义。
想删掉文本里的英文句号,写 . 是不行的,句号在正则里是“任意字符”,要写 \.。
坑四:文本数字没转就求和。
regexp提取出来默认是文本,直接 SUM 结果是 0。可以在公式前加“—”或在后面 *1 转换成数值。
坑五:老版本 WPS。
2024版本以前的 WPS 里没有这个函数,公式只会报 #NAME?。先升级。
什么时候别用 REGEXP?
固定位置的简单截取,比如从身份证里提生日,LEFT 和 MID 更快更直观;百万行级别的数据,正则会拖慢计算,优先用分列或 Power Query。
所以,位置固定的活交给文本函数,乱七八糟、复杂的活交给 REGEXP。
如果你在用 Excel。
Excel 365 也有正则能力,但拆成三个函数:REGEXTEST 管判断、REGEXEXTRACT 管提取、REGEXREPLACE 管替换。WPS 的 REGEXP 一个函数全包,不需要会员,免费版就有。
想再往上走一步。
正则是一门通用手艺,WPS 里练会了,Python、SQL、网页开发全用得上。网上搜“正则表达式在线测试”,写完先测再进表格。

补三个高频问题。
问:REGEXP 能在表格以外的组件用吗?
答:WPS 文字的查找替换也支持正则,但勾选项和细节不同,本文只讲表格。
问:提取的数字怎么变成真数字?
答:公式外面套 --,比如 =--REGEXP(A2,"\d+")。
问:手机号想支持 +86 前缀怎么办?
答:正则改成 (\+86)?1[3-9]\d{9},前缀可有可无。
附录:符号速查表 + 公式模板库
这一屏建议收藏。忘了符号查表,懒得写公式直接抄模板。
符号 | 含义 | 例子 |
. | 任意一个字符(除换行) | a.c 可匹配 abc |
\d\D | 数字 / 非数字 | \d+ 匹配 2024 |
\w\W | 字母数字下划线 / 反之 | \w+ 匹配 Excel2024 |
\s\S | 空白 / 非空白 | \s+ 匹配连续空格 |
[abc] | abc 中任意一个 | [张李] 匹配 张 |
[^abc] | 不是 abc 的任意一个 | [^0-9] 匹配非数字 |
[一-龟] | 常用汉字 | [一-龟]+ 匹配 张三 |
^$ | 开头 / 结尾 | ^1 以 1 开头 |
\b\B | 单词边界 / 非边界 | \bcat\b 匹配独立的 cat |
*+? | 0+ / 1+ / 0或1 次 | \d+ 匹配一串数字 |
{n}{n,}{n,m} | 正好 n / 至少 n / n 到 m 次 | \d{11} 匹配 11 位数字 |
*?+??? | 非贪婪版 | \[.*?\] 只吃到第一个 ] |
( ) | 捕获组,从 1 编号 | (\d{3}) 存前三位 |
(?: ) | 分组但不捕获 | (?:ab)+ 匹配 abab |
\1$1 | 反向引用 / 替换引用 | $1****$2 脱敏 |
(?= )(?! ) | 后面是 / 不是(只看不吃) | \d+(?=元) 匹配元前数字 |
(?<= )(? | 前面是 / 不是(只看不吃) | (?<=() 括号后开始 |
| | 或者 | 苹果|香蕉 匹配其一 |
\K | 前面匹配的不算结果 | 订单号\K\d+ 只交数字 |
\ | 转义,让特殊字符变字面 | \. 匹配字面的句号 |
匹配模式 | 作用 | 没匹配到会怎样 | 示例 |
0(默认) | 提取全部匹配 | #N/A | =REGEXP(A2,"\d+") |
1 | 判断有没有,返回 TRUE/FALSE | FALSE | =REGEXP(A2,"[一-龟]",1) |
2 | 替换成第四参数 | 原样返回原字符串 | =REGEXP(A2,"\s+",2," ") |
3 | 完整提取,包成数组 | #N/A | 配 MAP、REDUCE 等展开 |
常用模板再来一份,改个单元格就能用:
手机号 =REGEXP(A2,"^1[3-9]\d{9}$",1)
身份证 =REGEXP(A2,"^\d{17}[\dXx]$",1)
邮箱 =REGEXP(A2,"^[\w.]+@[\w-]+(\.[\w-]+)+$",1)
含中文 =REGEXP(A2,"[一-龟]",1)
提数字 =REGEXP(A2,"\d+")
提姓名 =REGEXP(A2,"[一-龟]+")
提金额 =REGEXP(A2,"\d+(\.\d+)?(?=元)")
提括号 =REGEXP(A2,"(?<=().*(?=))")
脱敏 =REGEXP(A2,"(\d{3})\d{4}(\d{4})",2,"$1****$2")
删批注 =REGEXP(A2,"\[[一-龟]+\]",2,"")
清空白 =REGEXP(A2,"\s+",2," ")
最后
正则这东西,学的时候觉得玄,用起来才发现:它只是把你脑子里“我要找一串数字”“我要删掉括号里的字”这些想法,翻译成 WPS 能听得懂的话。
建议你如果时间多,可以把上面场景一在自己电脑上做一遍,跑通了,这事就算真的会了。
表格里最耗时间的从来不是算数,是清理规范文本。REGEXP 就是那个帮你把清理活干完的工具。