ARTICLE · 1372633
Nexent RAG 实战复盘 从文档入库到可追溯售后问答的全链路优化 从一条真实售后问题出发,拆解知识入库、检索召回、工具调用与答案核验.
工程实践报告 · 真实问题拆解 · 可复核数据 · 证据闭环
测试记录版本:Nexent v2.8.2 | 文档整理日期:2026-11-15
文章导读 / Nexent RAG 实战复盘 从文档入库到可追溯售后问答的全链路优化
从一条真实售后问题出发,拆解知识入库、检索召回、工具调用与答案核验。
文章标签(10 个)
Nexent · RAG · 知识库 · 文档解析 · 文本切片 · Embedding · 混合检索 · MCP · AI Agent · 智能客服
摘要
本文以 Nexent v2.8.2 演示环境中的一组售后问答记录为线索,完整拆解 RAG 从文档接入、格式解析、文本切片、Embedding 向量化,到 accurate、semantic、hybrid检索,再到双知识库协同与 MCP 订单查询的工程链路。文章围绕五份规则文档、24 条规则、24 道检索题和 6 个端到端案例,展示 17 片到 11 片的切片变化、模型与检索策略对证据覆盖的影响,并复盘型号丢失、参数未生效、引用错配、工具执行顺序偏差等问题。重点不是追求单一命中率,而是建立可验证的证据闭环:订单事实可查、规则条款可定位、答案结论可核验、未知信息敢于说明。
先看四个关键数字17 → 11:切片数量变化;11/11:封存集 Top5 至少命中一条有效条款;8/11:封存集完整预期条款覆盖;4/6 与 1/6:端到端业务正确数与完整通过数。 |
这篇文章解决什么问题
·文档上传成功后,如何确认型号、条款编号和正文没有在解析阶段被破坏?
·Embedding 与切片参数如何用固定题集比较,而不是凭感觉选择?
·通用规则、商品例外和订单状态如何协同,避免 AI 用一条规则回答所有问题?
·如何让最终答案的每个关键结论都能回到来源文件和原文条款?
01业务问题 / 一条售后问题,暴露 RAG 的真正难点
用户问的是“能不能退”,系统必须先弄清楚“是什么商品、发生了什么、哪条规则适用”。
“耳机签收第 4 天,没试听过,可以申请退货吗?”看起来只需要查一个期限。但如果这是一款入耳式耳机,卫生封条已经拆开;而另一款外观相近的头戴式 Pro 允许正常短时试戴,那么只检索“七天期限”就会给出不完整甚至错误的判断。
这类问题至少包含三类不同的数据。第一类是订单事实,例如完整型号、签收时间、包装状态和使用状态;第二类是稳定规则,例如通用期限、申请材料和物流异常处理;第三类是商品例外,例如某个型号的封条要求、试戴条件或定制限制。三者的来源、更新频率和可信边界并不相同。
信息类型 | 示例 | 应该由谁提供 | 常见错误 |
订单事实 | AE-100、签收第 4 日、封条已拆 | 只读订单工具 | 让模型根据用户描述自行补全 |
通用规则 | 签收后期限、申请流程、材料要求 | 通用售后知识库 | 只召回期限,不召回必要条件 |
商品例外 | AE-100 与 AE-100 Pro 的不同条件 | 商品规则知识库 | 型号相似导致条款串用 |
核心判断RAG 的目标不是“找一段看起来相关的文字”,而是把回答所需的全部事实和规则找齐,并让结论与证据保持一致。 |
本文使用虚构的“澄星数码演示店”资料,不包含真实订单或真实客户信息。所有订单号均为 DEMO 格式;结论只适用于本文列明的样本、版本和配置,不应直接外推为通用性能承诺。
02系统架构 / 让知识、事实与推理各司其职
Nexent将知识库、智能体运行时和 MCP 工具放入统一工作流,重点是明确各层职责。
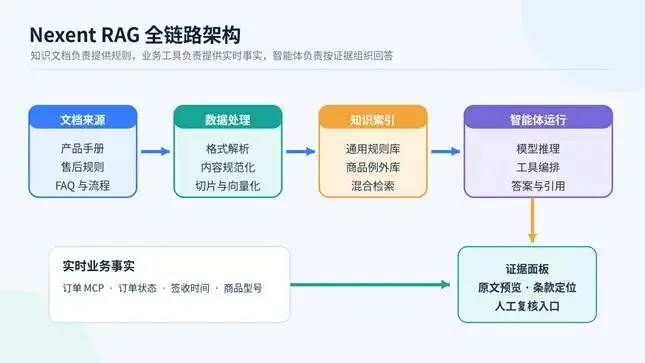
图 1 从文档处理到来源核验的端到端架构示意。
从平台结构看,前端负责配置和交互;配置服务管理模型、知识库、权限与智能体;数据处理服务完成文档解析、切片、向量化和索引;运行时负责智能体执行、模型调用和流式响应;MCP 服务提供工具接入。底层由关系数据、检索索引、缓存与对象存储等组件承载。
对售后问答而言,知识库不应该保存“某一笔订单当前是什么状态”这种瞬时事实;订单工具也不应该代替规则文档。把规则和事实分开,既能降低数据重复,也能让回答更容易审计。
架构边界平台能力以实际部署版本为准。公开指南对部分功能的版本标注与本次 v2.8.2 测试记录并不相同,具体界面、参数传递和源码行为应以目标版本为准。 |
03实验设计 / 先固定样本、环境和评价口径
没有固定数据集与可解释指标,模型对比很容易变成一次性演示。
项目 | 本次记录 | 说明 |
平台版本 | Nexent v2.8.2 | 具体行为以该版本现场记录为准 |
知识语料 | 5 份 Markdown/TXT,约 11.9 KiB | 共 24 条编号规则 |
基线切片 | 17 个 | 五份文档分别为 4、4、3、3、3 片 |
Embedding | V4 与 Qwen3.7 | 两组向量维度统一为 1024 |
检索配置 | Top-k=5,关闭 rerank | 对比 accurate / semantic / hybrid |
检索题集 | 24 题 | 12 道开发题 + 12 道封存题;每组 11 道可回答、1 道无答案 |
端到端案例 | 6 个 | 使用只读订单 MCP,统计首次尝试 |
题集覆盖完整型号、连字符缺失、普通版与 Pro 区分、包装状态、质量问题、物流停滞和无答案问题。另有“两个接口是否各有 65 W”这类错误前提,用来检查系统是否会顺着用户的错误假设生成答案。
评测不把“返回了几段文本”当作成功。每道题都提前列出预期条款:只要 Top-k 中至少有一条有效条款,记为命中;如果回答需要的全部条款都出现,才记为完整覆盖。
资源条件也属于实验条件解析容器最初限制为 1200 MiB,五份文件处理时触发内存上限;调整到 1800 MiB 并同步持久配置后,该批文件完成处理。解析与查询同时运行时,主机可用内存一度降至 479 MiB,集中检索前暂停了已完成入库的文档处理服务。 |
04文档入库 / 上传成功不等于知识已经可用
文件状态、处理任务、正文质量和检索结果是四个不同层次。
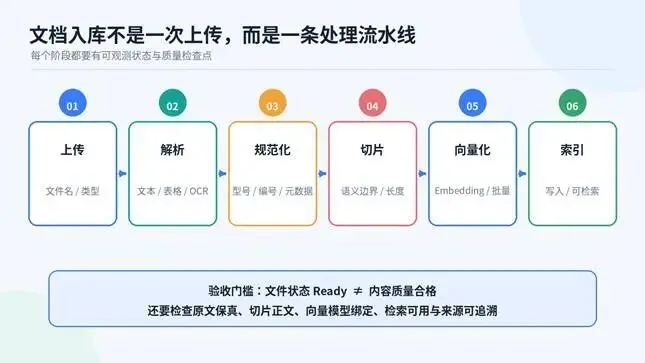
图 2 文档入库流水线与各阶段验收点。
本次环境在上传后遇到两类典型问题。第一类是纯文本任务报图像模型路径不存在:服务继承了旧环境中的模型路径,关闭启动预载并不会自动清空任务执行时读取的配置;清理无效路径后,文本处理才继续。
第二类是 WorkerLostError。解析容器最初设置为 1200 MiB,进程连续退出;内核记录确认该解析容器触及内存限制。将限制调整到1800 MiB 并写入持久配置后,五份文件全部就绪。需要注意,解析并发设为 1 不代表整台主机只运行一个进程,API、其他 worker 和基础服务仍会占用资源。
另一次主机可用内存下降并伴随界面、SSH 卡顿,但没有取得对应的内核 OOM 证据,因此不能把它与前述容器 OOM 混为同一个已确认根因。排障记录应区分“已证实”与“尚未证实”。
入库验收顺序先确认任务完成与文件 Ready,再抽查原始正文、型号和条款编号,最后用固定问题做检索验证。不要只凭上传进度条判断知识库质量。 |
05解析保真 / SKU-01 为什么会被拆成三段
检索之前先保证文本没有变形;Embedding 无法修复已经丢失的字符。
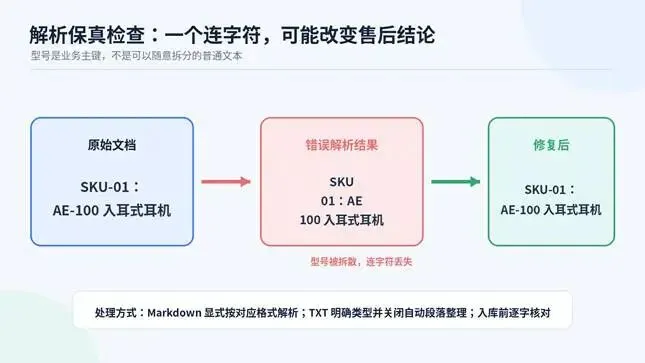
图 3 型号被错误拆分与格式识别修复后的对照。
原始规则写的是 `SKU-01:AE-100 入耳式耳机`。最初解析结果却出现 `SKU`、`01:AE`、`100 入耳式耳机` 三段,连字符消失。AE-100 与 AE-100 Pro 的售后条件不同,型号一旦在入库前被破坏,后续向量检索和模型推理都可能把两款商品混为一谈。
定位时对照了原文件、DataProcessCore 输出和解析器调用方式。现场线索显示,Markdown 内容保留了标题标记,而 TXT 路径可能把连字符识别成列表分隔符。修复方向不是重写整条 RAG 链,而是明确文件类型:Markdown 走对应解析路径,TXT 明确类型并关闭自动段落整理。
修复前后使用同一批冻结文件。将各文件切片按序拼接,忽略空白并移除原文行首 Markdown 标题标记后逐字符比较;五份文件均通过保真检查,条款编号、完整型号及出现次数保持一致。片数仍为 4、4、3、3、3,说明这一轮修复解决的是解析质量,而不是切片参数。
可复用的质量门对 SKU、序列号、错误码、条款编号、日期、金额和版本号建立保真检查;这些字段不应只靠人工浏览几段切片来确认。 |
06切片策略 / 17 片降到 11 片,究竟改善了什么
切片不是越短越精准,也不是越长越完整;关键是问题所需的证据能否一起被取回。
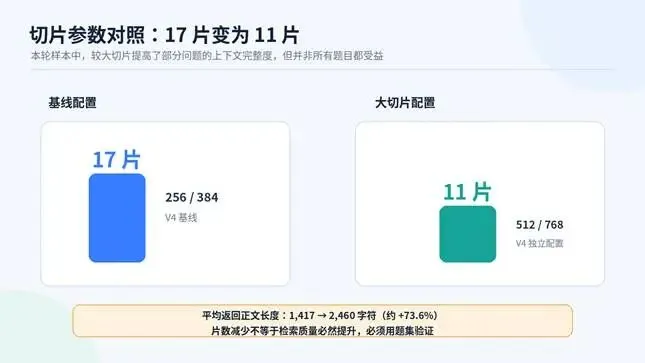
图 4 同一批文档的两组 V4 切片配置对照。
文档 | V4 基线 256/384 | V4 独立配置 512/768 |
退换货通用规则 Markdown | 4 | 3 |
申请流程与信息不足 TXT | 4 | 2 |
耳机规则与例外 Markdown | 3 | 2 |
充电器规则与兼容 Markdown | 3 | 2 |
键盘规则与保修 TXT | 3 | 2 |
合计 | 17 | 11 |
本次还发现一个容易忽略的配置问题:知识库创建弹窗中的高级切片设置在 v2.8.2 现场链路中没有进入实际解析请求,最终仍使用模型记录里的 256/384。通过新建独立模型配置、保持同一 Embedding 接口与 1024 维度、将模型自身参数改为 512/768 并重新建库,才得到 11 片结果。
较大切片使 V4 hybrid 在 11 道可回答开发题上的平均返回正文从 1,417 增至 2,460 字符,约增加 73.6%。收益是部分相邻条件可以一起返回;代价是上下文更长,也可能把无关内容带入候选。
参数选择原则先确认参数真的生效,再比较召回结果;每次只改变一个变量,保留旧索引作对照。切片数量只能描述结构变化,不能单独代表答案质量。 |
07检索对比 / Embedding 与检索方式,不要只看 Hit@1
本轮采用三种路径、三组配置;开发集用于选型,封存集用于检查泛化表现。
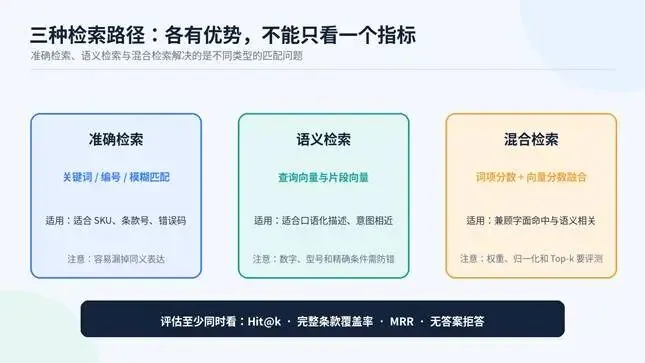
图 5 三种检索路径的能力侧重与评估指标。
配置 | 模式 | Hit@1 | 完整覆盖@3 | 完整覆盖@5 | MRR@5 |
V4 256/384 | accurate | 10/11 | 5/11 | 5/11 | 0.9091 |
V4 256/384 | semantic | 10/11 | 6/11 | 6/11 | 0.9091 |
V4 256/384 | hybrid | 10/11 | 6/11 | 7/11 | 0.9091 |
Qwen3.7 256/384 | accurate | 10/11 | 5/11 | 5/11 | 0.9091 |
Qwen3.7 256/384 | semantic | 8/11 | 9/11 | 10/11 | 0.8182 |
Qwen3.7 256/384 | hybrid | 10/11 | 9/11 | 9/11 | 0.9091 |
V4 512/768 | accurate | 10/11 | 6/11 | 8/11 | 0.9545 |
V4 512/768 | semantic | 8/11 | 6/11 | 10/11 | 0.8409 |
V4 512/768 | hybrid | 10/11 | 7/11 | 11/11 | 0.9545 |
从开发集看,Qwen3.7 的semantic 对部分通用规则补全更有优势;Qwen hybrid 在两道条款组合题上将关键条款排到首位。V4 大切片 hybrid 则在Top5 完整覆盖上达到 11/11。不同模型的优势落在具体问题和排名位置上,不能简单得出某个 Embedding 在所有场景都更好。
准确检索更适合编号、型号和固定词项;语义检索更擅长口语化表达;混合检索试图兼顾二者。若问题含数字、型号或条款编号,必须单独检查精确字段是否被保留。
08封存集验证 / Top5 命中 11/11,完整覆盖仍只有 8/11
这组数据说明:找到一条相关内容,与找齐全部适用条件,是两件不同的事。
封存集指标 | Top1 | Top3 | Top5 |
至少命中一条有效条款 | 10/11 | 11/11 | 11/11 |
条款 Recall 宏平均 | 72.73% | 81.82% | 86.36% |
完整预期条款覆盖 | 6/11 | 7/11 | 8/11 |
MRR | 0.9091 | 0.9545 | 0.9545 |
封存集仍包含 11 道可回答题和 1 道无答案题。首次运行时,基线首题出现 ConnectionError,耗时 24.16 秒,查询 Embedding 请求数为 0,候选尚未开始。该失败被单独保留;暂停已完成入库的文档处理服务后,按原索引、模型和检索参数恢复测试。
两组 V4 切片配置在封存集的核心指标相同。差异集中在两道具体题:AE-100 收货第 6 日、封条完好时,大切片补上了通用期限条款;普通 KB-87 只打开快递袋、原盒封条未动时,基线反而找到了大切片 Top5 未返回的 POL-02。两组完整覆盖均为 8/11。
最重要的评测结论Top5 命中率 100% 并不意味着证据完整率 100%。如果一道题需要“通用期限 + 商品例外 + 订单状态”共同判断,必须逐项核对这三类证据是否全部进入上下文。 |
无答案题同样重要。“批量购买一百把键盘能优惠多少”没有对应规则,合理答案应说明资料中没有折扣金额,而不是从其他售后条款推测。检索返回了内容,不代表资料里存在所问事实。
09知识组织 / 双知识库协同:通用规则与商品例外分开管理
拆分知识库不是为了增加复杂度,而是为了明确规则的来源、优先级和更新节奏。
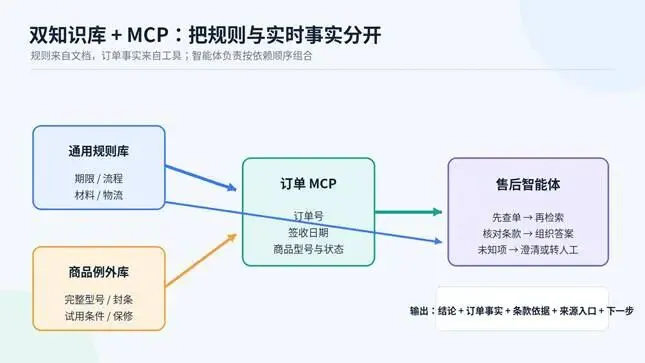
图 6 双知识库、订单 MCP 与售后智能体的协同关系。
知识库 | 文档数 | 切片数 | 职责 |
澄星通用售后规则 | 2 | 8 | 期限、申请流程、材料、物流异常 |
澄星商品例外规则 | 3 | 9 | 完整型号、封条状态、试戴条件、保修边界 |
六个端到端案例固定使用 V4 基线、1024 维向量、256/384 切片、hybrid Top5,关闭 rerank。每次分别查询通用库和商品库,各返回 5 个片段;来源面板最多展示 10 项候选。两库配置与前面单库 512/768 的检索对照不同,不能把两轮结果混为一谈。
规则优先级在资料中明确写出:先核对完整型号及是否定制,商品例外优先;其余事项再适用通用规则。若商品例外与通用条款冲突,不能让模型自行“折中”,而应按事先定义的优先级处理;若缺少适用条款,则应保留未知并请求补充信息。
10工具接入 / MCP 接订单:让动态事实不再依赖模型猜测
知识库回答“应该遵循什么规则”,订单工具回答“这笔订单现在是什么状态”。
演示环境使用只读 MCP 服务,提供`get_order(order_id)` 和 `get_demo_clock()` 两个工具。前者返回商品型号、签收日期、包装状态和订单状态;后者返回固定评价日期与计日规则。对于未签收订单,`delivered_at` 和 `days_since_delivery` 保持 null,不用当前时间或用户语气猜出签收天数。
服务只接受 `DEMO-` 加四位数字的订单号。不存在的订单返回 `ORDER_NOT_FOUND`,格式错误返回 `INVALID_ORDER_ID`。本次通过 Streamable HTTP 接入,工具发现、正常查询和异常参数检查均有记录;调用前后订单数据保持不变。
工具返回 | 示例 | 智能体应如何使用 |
订单号 | DEMO-1001 | 确认查询对象,不把用户口述当成已核验记录 |
商品型号 | KB-87 / AE-100 | 使用完整型号匹配商品例外 |
签收日差 | 7 | 仅在签收日期存在时参与期限判断 |
订单状态 | in_transit | 未签收时不套用签收后期限 |
异常状态 | ORDER_NOT_FOUND | 先澄清订单号,不编造商品与资格 |
生产接入边界演示接口只读,不等于生产系统已经具备完整身份校验。真实接入还必须校验调用者身份、订单归属、字段最小化、审计日志和接口访问范围。 |
11 AGENT 编排 / 先查订单,再检索规则,最后组织答案
工具之间存在数据依赖时,不应把所有调用无条件并行化。
本次提示词要求智能体先查询订单,再根据完整型号和订单状态分别检索通用规则与商品例外,最后输出结论、订单事实、规则依据和下一步。这个顺序很重要:如果检索在订单事实返回前就开始,检索查询可能缺少型号、签收状态和包装条件,造成召回范围过宽。
执行顺序示意# 伪代码:展示依赖关系,不是可直接运行的 SDK 示例
order = get_order(order_id)
if not order.ok:
return ask_user_to_check_order_id()
common_hits = search_common_rules(
model=order.full_model,
delivered_days=order.days_since_delivery,
status=order.status
)
product_hits = search_product_exceptions(
model=order.full_model,
condition=order.item_condition,
packaging=order.packaging_status
)
evidence = verify_expected_clauses(common_hits, product_hits)
return compose_answer(order, evidence)
建议固定的答案结构
输出字段 | 内容要求 |
结论 | 明确可申请、不可申请、待补充信息或转人工核验 |
订单事实 | 只复述工具实际返回的型号、日期、状态和条件 |
规则依据 | 列出完整条款编号及其适用条件 |
来源引用 | 引用必须指向真正包含该条款正文的片段 |
未知信息 | 明确指出资料未覆盖的金额、库存或例外条件 |
下一步 | 说明用户补充什么,或由人工核验什么 |
输出约束不得把“无法通电”扩写成“指示灯不亮”,除非订单记录或用户信息确实包含该事实;不得把相似型号替换成目标型号。 |
12端到端结果 / 业务判断 4/6,完整流程通过 1/6
六个首次尝试案例揭示:最终答复不仅要判断正确,还要满足工具顺序、引用和权限边界。
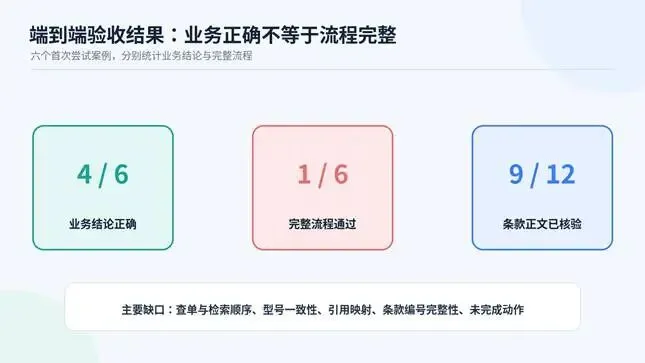
图 7 六个端到端案例的结果概览。
案例 | 核心条件 | 业务判断 | 完整通过 | 主要问题 |
E2E-01 | 普通键盘,签收第 7 日 | 否 | 否 | 输出停在动作记录残片,未形成答复 |
E2E-02 | AE-100,第 4 日,卫生封条已拆 | 是 | 否 | 结论与引用成立,但查单和检索并行 |
E2E-03 | AE-100 Pro,第 5 日,正常短时试戴 | 否 | 否 | 型号解释矛盾,部分引用错配 |
E2E-04 | 充电器,第 10 日,无法通电 | 是 | 否 | 条款编号不完整,增加了未证实细节 |
E2E-05 | 运输中,物流长时间未更新 | 是 | 否 | 保留签收日差未知,但未写条款编号 |
E2E-06 | 订单号不存在 | 是 | 是 | 正确澄清,没有编造商品与资格 |
六例首轮业务结论正确为 4/6,完整通过为1/6。前五例共需要核对 12 个条款项,实际返回正文中有 9项已核验,另有 3 项未验证;这 3 项全部集中在 E2E-01,因为缺少可核验的检索记录。
为什么要分开统计业务结论正确率衡量判断是否正确;完整通过率衡量整个约定流程是否完成。只报告前者,会掩盖引用、执行顺序和输出完整性方面的缺陷。 |
13失败复盘 / 召回正确,为什么回答依然可能错误
模型生成阶段仍可能发生实体漂移、证据错配和无依据扩写。
案例一:Pro 型号在同一句话中变成两种商品
E2E-03 已经查到 AE-100 Pro、签收第 5 日、正常短时试戴和耳罩清洁等事实;检索也返回了 SKU-02 与 POL-02。但最终答复一边写“AE-100 Pro 是入耳式耳机,有专属卫生封条限制”,另一边又写“AE-100 Pro 头戴式耳机无此限制”。这不是召回失败,而是生成时实体与规则绑定不稳定。
案例二:引用编号看似存在,实际指向了别的条款
同一案例中,POL-02 后的一个可点击来源实际是 POL-07(未签收与物流停滞),并不能支持七日期限;真正包含 POL-02 正文的是另一个来源。引用标记存在,不代表引用映射正确,必须打开来源正文核验。
案例三:动作记录残片不等于完成了业务动作
E2E-01 查单和时钟调用成功,但最终输出停在 `completed_action_history` 残片,出现了拟执行的检索动作描述,却没有可核验的检索结果和资格答复。不能因为界面出现工具名称,就把这次任务计为成功。
案例四:答案不能超出输入事实
E2E-04 的订单记录只说明“无法通电”,答复却细化为“指示灯不亮”。即使这个推断看起来合理,也没有证据支持。技术问答中的细节扩写,可能改变后续判断。
失败的共同根因RAG 需要同时约束实体、事实、条款和引用。召回结果是证据候选,不是最终答案;最终答案仍需逐句检查是否被来源支持。 |
14引用溯源 / 从答案句子回到原文条款,而不是只显示一个链接
来源面板的价值在于可核验,不在于让答案看起来更专业。
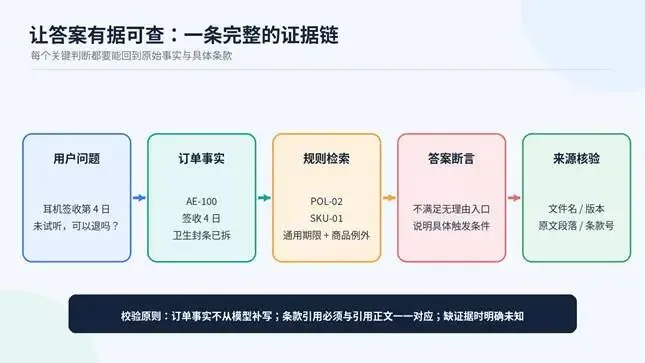
图 8 从用户问题到来源原文的证据链。
以 E2E-02 为例,订单工具给出AE-100、签收第 4 日和卫生封条已拆;检索结果返回完整SKU-01 与 POL-02;最终答复引用对应条款。来源面板能够打开原始文件,看到文件名、文档大纲和版本标识,并对照AE-100 与 AE-100 Pro 的不同条件。
建议在应用层保存一份结构化引用清单,至少包含:答案句子编号、来源文件、文档版本、条款编号、命中片段 ID、原文片段摘要、核验状态。引用映射应在最终渲染前完成校验,而不是等用户发现错链后再追查。
核验项 | 通过标准 | 不通过时的处理 |
文件一致 | 来源文件与知识库记录一致 | 标记来源不可用并重新索引 |
条款一致 | 引用条款号与正文内容一致 | 撤回引用,重新定位片段 |
实体一致 | 型号、版本、订单号前后一致 | 阻止输出并要求重新核验 |
条件完整 | 期限、状态、例外等条件齐全 | 补检索或转人工 |
版本有效 | 引用文档属于当前有效版本 | 使用有效版本重建索引 |
可追溯的最低要求读者点击来源后,应该能在原文中找到支持当前句子的内容;如果只能找到“相似主题”,这条引用就不合格。 |
15故障排查 / 把问题定位到具体链路节点
先保存证据,再改变配置;每次只改一个变量,才能知道修复是否真正有效。
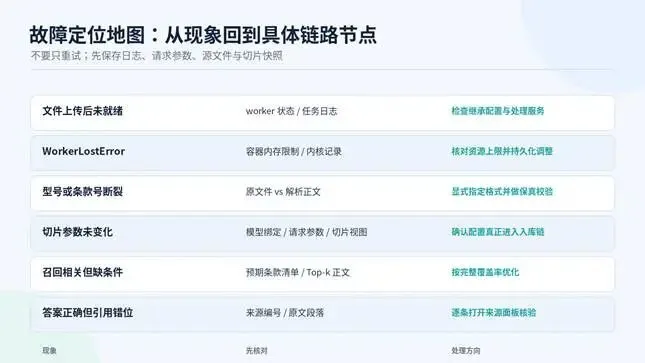
图 9 常见故障的检查方向与处理入口。
现象 | 优先检查 | 本次记录对应处理 |
上传完成但未 Ready | 任务服务、worker、单文件错误 | 清理继承的无效图像模型路径 |
WorkerLostError / SIGKILL | 容器限制、内核日志 | 确认容器 OOM 后调整到 1800 MiB |
型号、条款号断开 | 原文件与解析后正文 | 明确 Markdown/TXT 类型并做保真检查 |
切片数没有变化 | 模型绑定、请求数据流、真实切片 | 用独立模型配置并重新建库 |
第一条相关但缺少条件 | 预期条款清单与 Top-k 正文 | 按完整覆盖率而非单一命中率优化 |
召回正确但答复错误 | 最终措辞、引用编号、来源正文 | 逐句核对实体、事实和引用映射 |
首次封存请求的 ConnectionError 被单独保留,没有从统计中悄悄删除;恢复后重新运行也没有覆盖原失败记录。这种做法能避免把失败样本隐藏起来,使评测结果更接近真实运行状态。
排障记录模板时间戳、软件版本、输入文件哈希、请求参数、日志片段、实际切片、检索结果、错误码、修复动作、复测结果。缺少这些信息时,复现和回归都会变得困难。 |
16回答策略 / 型号、证据、未知项,设置三道输出闸门
让模型知道什么时候可以回答、什么时候必须补检索、什么时候应该明确说不知道。
第一道:实体一致性
把完整型号视为不可随意改写的实体字段。对 AE-100、AE-100 Pro 这类近似型号,要求答案中的每次出现都与订单工具返回值一致;若检索片段中的型号不同,必须说明它只是对照项,不能拿来作为目标商品依据。
第二道:证据完整性
把每道问题拆成必要条件清单。例如退货资格至少可能需要订单状态、签收日期、通用期限、商品例外和商品状态。只有必要条件均有来源支持,才允许输出确定结论;缺少其中一项时,应补充检索或将结论降级为待核验。
第三道:未知项与拒答
如果资料没有折扣、库存或特定配送费用,就直接说明当前知识库没有这项信息。无答案不是系统失败,而是避免编造的正确行为。对订单不存在、未签收或日期为空等情况,应进入澄清分支,而不是套用默认日期。
提示词约束示例请按以下顺序完成任务:
1. 先查询订单;订单不存在时只请求核对订单号。
2. 订单存在后,提取完整型号、签收日期、订单状态和商品状态。
3. 分别检索通用规则与商品例外,记录命中的完整条款编号。
4. 逐条检查每个结论是否有原文支持;不得补写未提供的事实。
5. 证据不完整时说明缺少什么,不得猜测;必要时建议人工核验。
6. 输出结论、订单事实、规则依据、来源和下一步。
一个实用原则模型可以解释证据,但不能创造证据;模型可以提出下一步,但不能越过权限替代人工审核。 |
17上线准备 / 上线前四道验收门:数据、检索、回答、运行
把一次演示变成可持续回归的工程流程,需要把评测、权限和回滚纳入日常运维。
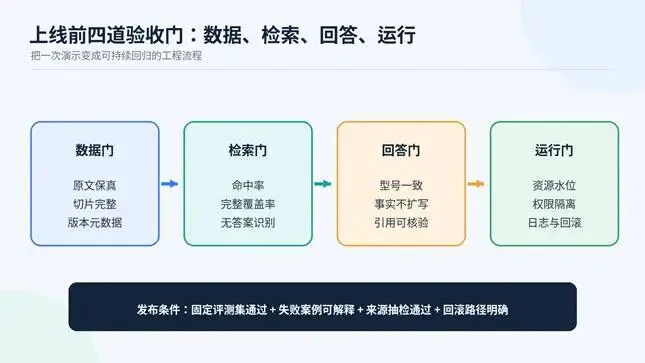
图 10 上线前四道质量门及发布条件。
建议的发布检查清单
·数据门:原始文件版本明确;型号、条款号、日期、金额等关键字段通过保真检查;失效文档可撤回。
·检索门:固定题集覆盖精确编号、口语化表达、跨片段条件、近似型号和无答案问题;同时记录 Hit@k、完整覆盖率与 MRR。
·回答门:抽检答案实体一致性、事实边界、条款适用性、引用映射和未知项处理;失败案例进入回归集。
·运行门:监控 worker 内存、队列积压、Embedding 失败率、检索延迟、工具调用失败率和来源打开失败率。
·权限门:知识库按角色和用户组授权;订单工具采用只读最小权限;凭据不进入提示词和日志正文。
·发布门:智能体配置版本化;评测通过后发布;出现回归时可回退到上一个已验证版本。
Nexent 的公开指南提供知识库管理、模型配置、MCP 工具接入、来源查看和智能体评测等能力入口。评测集可以用于固定问题回归,评测结果也支持查看单个案例并对失败样本进行人工标注。部署时应以目标版本的功能和权限配置为准。
建议的发布门槛不要只设一个总分阈值。至少为完整证据覆盖、实体一致性、引用正确率、无答案处理和工具调用健康度分别设定门槛,并对高风险问题保留人工复核。 |
18总结与资料 / RAG 的终点不是生成答案,而是生成可核验的答案
真正可靠的售后助手,需要把文档、订单、检索、推理和来源串成一条可复查的链。
这组 Nexent v2.8.2 演示记录给出了一个清晰结论:RAG 的效果不由单一 Embedding 模型或一个 Top-k 数字决定。解析保真决定知识有没有被正确读入;切片策略决定必要条件能否一起出现;检索策略决定证据能否被找出;工具编排决定动态事实是否准确;答案约束与来源核验决定结论是否真正可信。
本次实验既展示了可见收益,也暴露了尚未解决的问题:五份文档完成保真校验,切片从 17 个变为 11 个;开发集上 V4 大切片hybrid 的 Top5 完整覆盖达到 11/11;但封存集完整覆盖为 8/11,六个端到端案例只有一个完整通过。这个差距恰恰说明,检索指标不能代替真实业务验收。
下一步最值得投入的工作,不是继续盲目增加上下文,而是补齐缺失条款的召回、修正模型生成阶段的实体漂移、建立可靠的引用映射,并把六个端到端案例沉淀为长期回归集。只有当失败可以定位、修复可以复测、版本可以回退,知识库才真正具备持续运行的基础。
最后记住这五句话原文先保真;切片要验证;检索看完整覆盖;事实交给工具;结论必须能回到来源。 |
参考资料
[1] Nexent 项目概览与核心能力打开官方文档
[2] Nexent 软件架构打开官方文档
[3] DataProcessCore 文件处理与切片策略打开官方文档
[4]知识库配置与切片管理打开官方文档
[5] MCP 服务集成打开官方文档
[6]对话中的来源查看打开官方文档
[7]智能体评测与回归测试打开官方文档
[8]模型与 Embedding 配置打开官方文档
版本说明:公开文档中部分页面标注的版本与本文实验记录版本不同;本文的具体测试数值仅对应所述演示语料、配置和首次尝试记录。