ARTICLE · 1374397
网页、PDF 随手存,AI 自动打标签、写摘要:30k开源项目Karakeep 实测
把网页、PDF 和笔记存到一起,自动补上标签和中文摘要,写东西时再按正文关键词找回来。Karakeep 干的就是这件事。
做公众号、查产品资料、攒学习材料,都用得上。尤其是那些标题记不住、内容却有点印象的资料,不必只靠文件名和收藏夹一层层翻。
这个 GitHub 开源项目可以自己部署。这次实际装了 v0.35.0,放进去 7 个公开网页、1 份 PDF 和1条中文笔记,试了从收藏、整理到查找的整套过程。
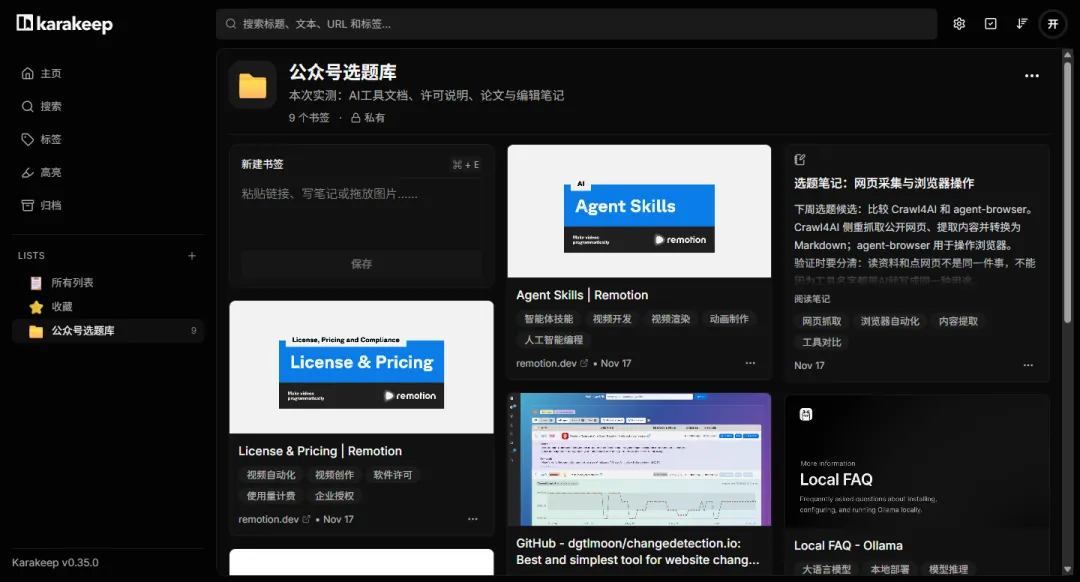
资料按选题归到同一列表
01 存进去以后,少做一点整理
资料里有 Remotion 的技能文档和许可f说明、Crawl4AI 安装教程、changedetection.io 和 Drawnix 的项目页,还有 n8n、Ollama 的文档。它们分别讲视频、网页采集、监控、白板和部署,应该分出不同标签。
最终,9 条资料都生成了中文摘要和标签。Remotion 技能页被标成“视频开发”“动画制作”等;Drawnix 是“开源白板”“思维导图”“流程图”。这些标签由应用调用模型生成,没有为了截图手工补写。
我把它们统一放进“公众号选题库”。列表管这一批资料是做什么用的,标签管单条资料讲什么。 后面再收同类内容,就有地方放了。
中文笔记也能一起收。测试笔记写的是 Crawl4AI 与 agent-browser 的用途区别,自动得到“网页抓取”“浏览器自动化”“内容提取”“工具对比”几个标签。摘要也保留了“读资料”和“操作网页”不能混为一谈的意思。
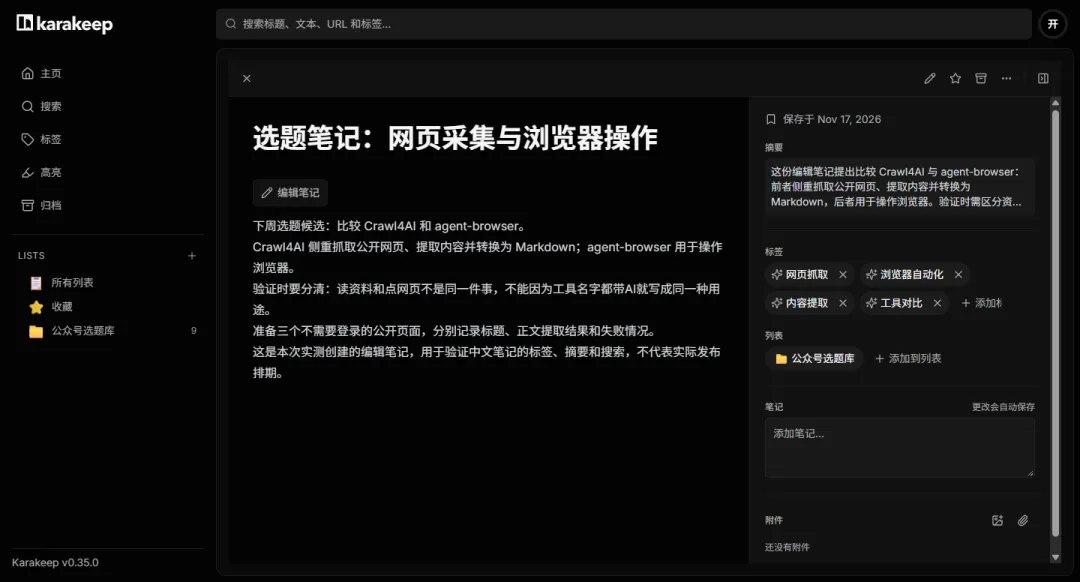
中文笔记与自动生成的分类标签
02 摘要好不好,得看它有没有漏掉条件
只把一大段话压短,很容易看着顺,实际少了半句。
这次专门放进了 Remotion 的许可页面。最需要留下的是:个人和不超过 3 人的公司有免费使用条件,其他公司涉及付费许可,还得遵守条款。
生成的中文摘要保留了这层区别,没有把它缩成一句“免费商用”。左侧原文、右侧摘要和标签,可以放在一个页面对照。
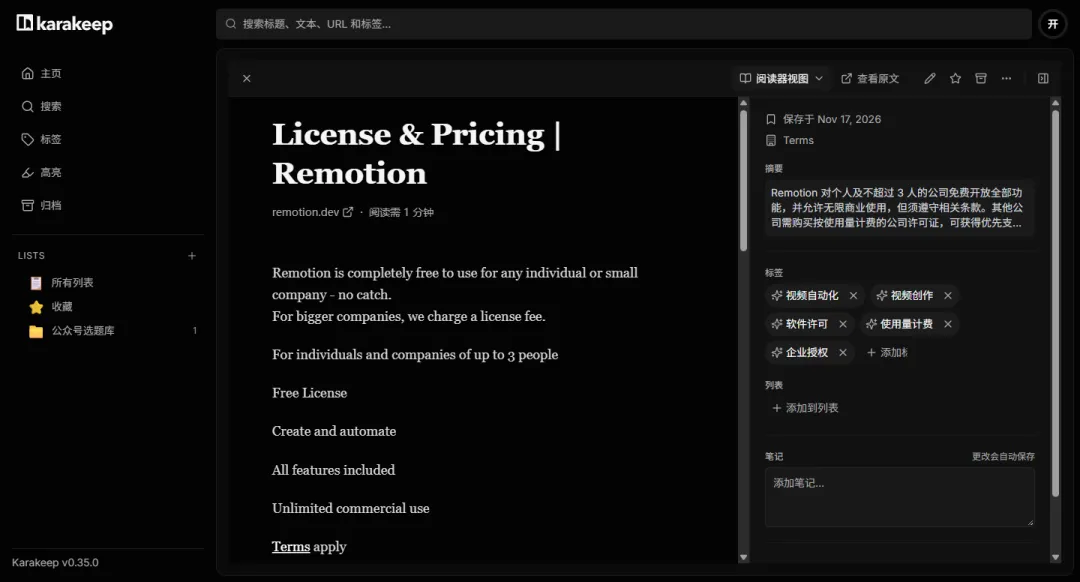
许可原文与中文摘要,免费使用条件没有被略掉
另一个检查点是 n8n 的 Docker 安装文档。这个旧入口已经提示文档过时,建议转到 Docker Compose 指南,摘要也写出了这条提醒。
这两个结果对选题有用:先知道一页资料讲什么、有没有需要留意的限制,再决定要不要细读。涉及价格、授权、操作命令,发布前还是要打开原文核对。 模型换了、页面更新了,摘要也可能不同。
03 忘了标题,可以搜正文里的词
PDF 测的是《Attention Is All You Need》。文件上传后,能直接预览,也生成了中文摘要和“自注意力”“多头注意力”等标签。
这里先说明一下:截图里的中文标题“Transformer原始论文(PDF)”是上传时手动填写的,不是它自动翻译出来的。
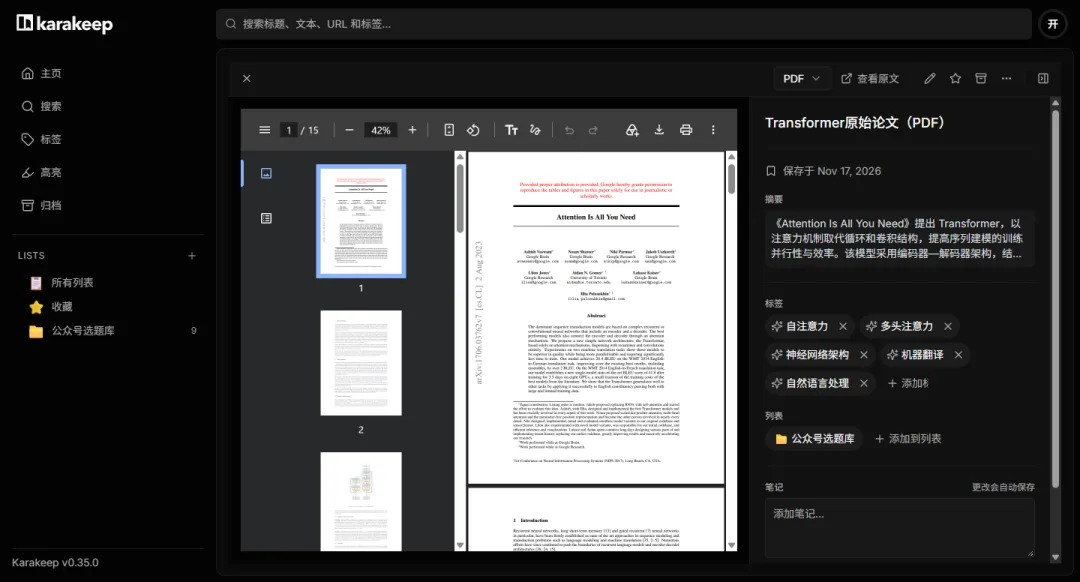
PDF 原文预览及自动标签
接着搜两个词:
位置编码positional encoding两次都找到了这份 PDF。尤其是英文词组,并不在手动填写的中文标题里,照样能从已索引的内容中找回资料。
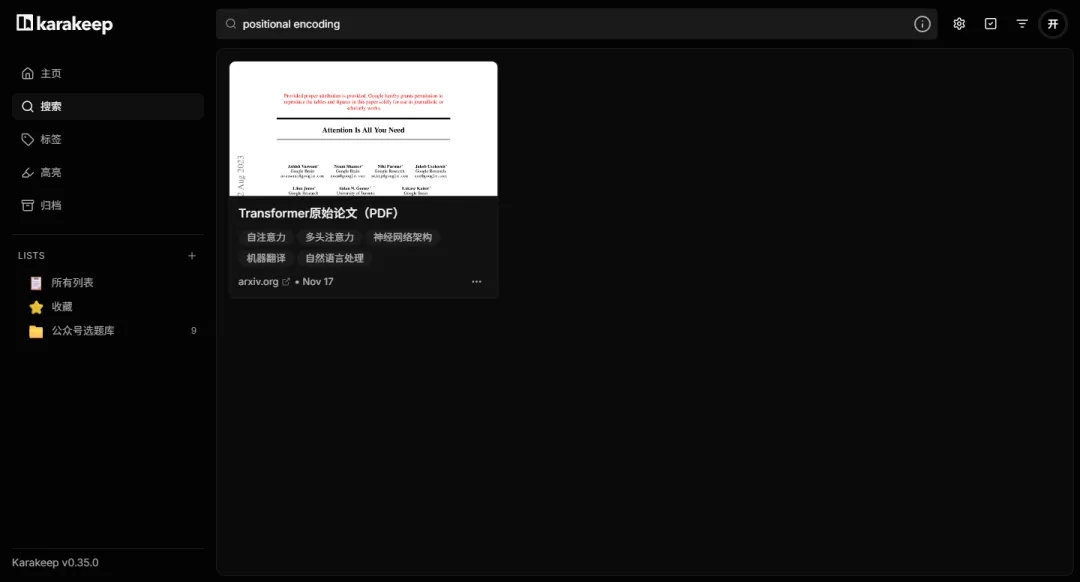
用正文关键词找回标题里没有该词的 PDF
不过,本次用的是全文关键词检索,没有配置语义搜索。 不能据此说,随便描述一个模糊印象,它都能懂。
搜索也有不够准的时候:搜“3 people”,除了 Remotion 许可页,还返回了论文。因此结果需要自己看一眼。一个刻意构造的不存在字符串则返回空结果;重复保存同一 Remotion 网址,返回的是原来那条记录,没有再多出一份。
04 适合拿它收什么?
写公众号,可以把项目主页、使用文档、许可页和自己的测试笔记放在一个选题列表里。准备动笔时,先扫摘要,再回到原文取证。
研究产品,可以按主题收功能说明、价格页、对比文章。要注意:收藏价格页不等于自动监控价格变化,这次也没有测试网页变化提醒。
学习新工具,可以把教程和 PDF 一起收。以后记得某个术语,就按术语查,比只记“上次看过一篇”具体得多。
它更适合已经会不断收资料的人。收进去的内容是否可靠、是否值得写,仍要自己判断。
05 自己部署前,先知道这几件事
这次不是打开就一路顺利。测试电脑的代理把公开域名解析到了保留网段,触发了应用的地址保护。只给这几处已知资料来源配置官方允许名单后,7 个网页才全部抓取成功。其他环境是否遇到,要看网络配置。
AI 模型得另外接。我这次用的是自己改过的接法,复用了 Codex 的登录。第一次自己配的话,这一步可能要花点时间。本次主要试了自动打标签、写摘要和按关键词找资料,图片识别、语义搜索,还有怎么跟 n8n 一起用,这些都还没试。
还有一点:Karakeep 装在自己电脑上,但我这次用的是 Codex,生成标签和摘要时,资料内容还是会发给模型服务。这次没拿到具体的用量数据,所以没算处理一篇资料要消耗多少Tokon。
如果你想要一个能把网页、PDF、笔记放在一起,又能少做些手工归类的资料库,Karakeep 值得试。
项目地址:
https://github.com/karakeep-app/karakeep部署文档:
https://docs.karakeep.com/实测日期:2026-11-17。版本:v0.35.0。
第一次装 Karakeep,不知道从哪一步开始? 欢迎在评论区留言,说说你用的是 Windows、macOS、Linux 还是 NAS。已经动手的,也可以说说卡在哪一步,大家一起看看。装好的朋友,也欢迎分享一下安装时踩过的坑。