ARTICLE · 1377842
从源码到签收:我用 SoduWork 跑通了一条"提需求 → AI 自主交付 → 人工验收"的完整闭环
把 SoduWork 当作一个工作产品来用:从私有化部署、模型底座接入,到需求管理、多 Agent 协作、插件技能、执行节点调度、用量与签收,全流程实测,所有数据均来自本机真实运行记录。
一、先说结论:我为什么挑它来测
SoduWork 吸引我的地方,是它从一开始就没把自己定位成"又一个聊天客户端"。按照官方口径,它是一个企业级 AI 原生引擎,核心关键词是「多底座 · 多 Agent · 私有化部署」,并内置了名为 Pi 的 Agent。换句话说,它想做的是一整套"让 AI 能被派活、能交付、能签收"的工作平台,而模型只是其中可替换的一环。
这正是我想验证的:作为一个工具,SoduWork 到底能不能把一条真实的工作流闭环跑起来? 于是我决定从源码开始,在自己的 Windows 机器上完整部署并实测一遍。
项目地址:https://github.com/mdiri-ai/SoduWork
二、它是什么:官方口径与技术底座
在动手之前,先把"它是谁"讲清楚,避免后面张冠李戴。
一个值得肯定的细节:它的 Hub 服务默认只监听 127.0.0.1 回环地址,不会默认暴露到局域网,这对私有化部署的安全基线是友好的。健康检查接口 /readyz 在我部署完成后返回:
{"ready": true, "database": true, "cluster": true, "mode": "single-instance"}
三、从 0 私有化部署:一条命令拉起,但要会安排磁盘
3.1 本机环境
我的实测环境如下:
3.2 克隆与数据目录的小心思
由于系统盘空间紧张,我没有使用默认路径,而是做了两个安排:
用
git clone --depth 1把仓库浅克隆到空间相对宽裕的E:\SoduWork;运行数据通过
--data-dir显式指向E:\SoduWorkData,而不是默认的%LOCALAPPDATA%,避免把 C 盘撑满。
克隆实测 8.2 秒完成,仓库体积约 114.9 MB、4898 个文件。
3.3 一条命令启动
官方提供了 start.cmd / start.py,我按「先检查、再准备、最后启动桌面」的顺序执行:先 --check 核对环境,再 --prepare-only 预拉依赖,最后 --desktop 启动桌面客户端。首次启动需要为管理员 admin 设置一个 12–128 位的密码;在非交互场景下,需要通过标准输入管道喂入密码。Electron 二进制通过国内镜像下载,约 16.2 秒完成。
各阶段实测耗时如下:
部署完成后,数据目录最终占用与构成如下(总计约 1094 MB、38726 个文件):
进程层面,Electron 多进程合计内存约 1 GB,Python 主进程约 180.8 MB。客观说,这套东西不算轻量,对磁盘和内存有一定要求,老旧小容量机器需要提前规划。
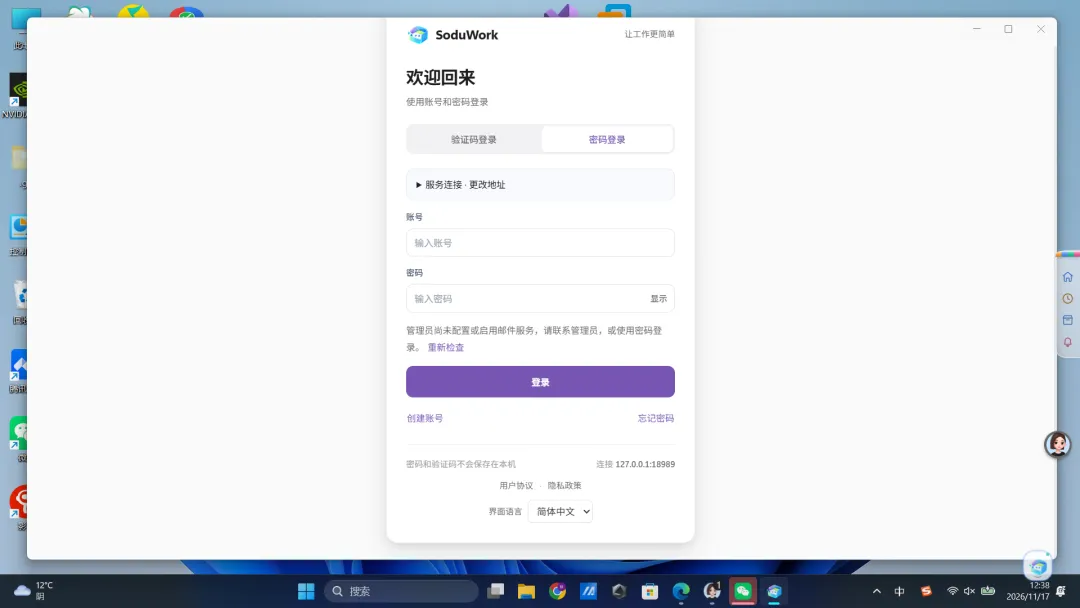
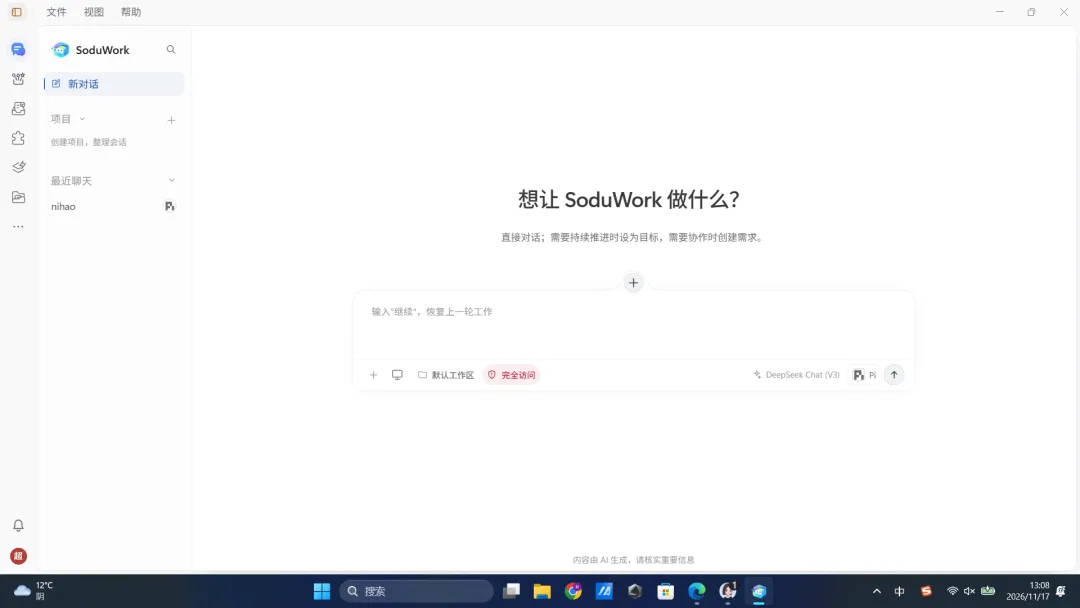
桌面客户端登录页与主界面如下:
四、接入模型底座:多底座不是噱头,"组织级"与"个人凭据"分开存
部署只是第一步,真正干活还得接模型。SoduWork 的「多底座」体现在它内置了 10 个服务提供方模板,包括 OpenAI、Anthropic、Google、DeepSeek、阿里云、智谱、月之暗面、火山引擎方舟、OpenAI 兼容通用、自定义企业服务等。
我这次接入的是 DeepSeek。这里有一个关键的设计认知,也是它和普通聊天客户端的重要区别:模型凭据分两层存储——
组织级模型目录:由后端管理,团队共享,写操作带乐观锁(
expectedRevision),我在这一层配置了deepseek-chat、deepseek-reasoner两个模型;个人本机凭据:在客户端"我的模型"里添加,保存在本机安全存储中,密钥只显示配置状态、不回显明文。
配置完成后,我通过真实能力探测接口(不是看文档参数,而是实际发请求验证)对 deepseek-chat 做了检测,四项能力全部 passed:
探测还返回:接口族为 chat-completions,输入支持 text + image,图像路由为 native,最大输出 token 数 maxOutputTokens = 65536。这意味着该底座具备函数/工具调用能力,而这正是后面 Agent 能自主操作文件、浏览器的前提。
说明:本文所有截图均已对 KEY、UID、手机号等敏感信息做规避处理;客户端本身密钥不回显,管理员密码与具体密钥不会出现在文中。
五、核心实测:一条需求的完整生命周期(本文重点)
环境和底座都就绪,现在进入正题。我要验证的是 SoduWork 最核心的能力——把一个真实需求,从"提出"一路管到"签收"。
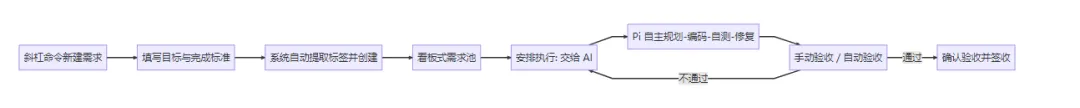
先上一张整体流程图,后面逐步展开:
5.1 创建需求:斜杠命令是最顺手的入口
我尝试过快捷键和侧边栏图标,在 125% 缩放下窄轨道图标容易点空。最可靠的方式是:在输入框直接敲一个斜杠 /,在弹出的命令列表里选择第一项「/需求 · 新建需求(内置表单)」。
随后在表单里填写两段最关键的内容:
目标:为团队官网首页增加一个产品订阅入口,包含邮箱填写、订阅按钮和提交成功提示;
完成标准:首页可见订阅入口,输入合法邮箱点击订阅后有成功提示,非法邮箱有校验提示,代码可直接运行。
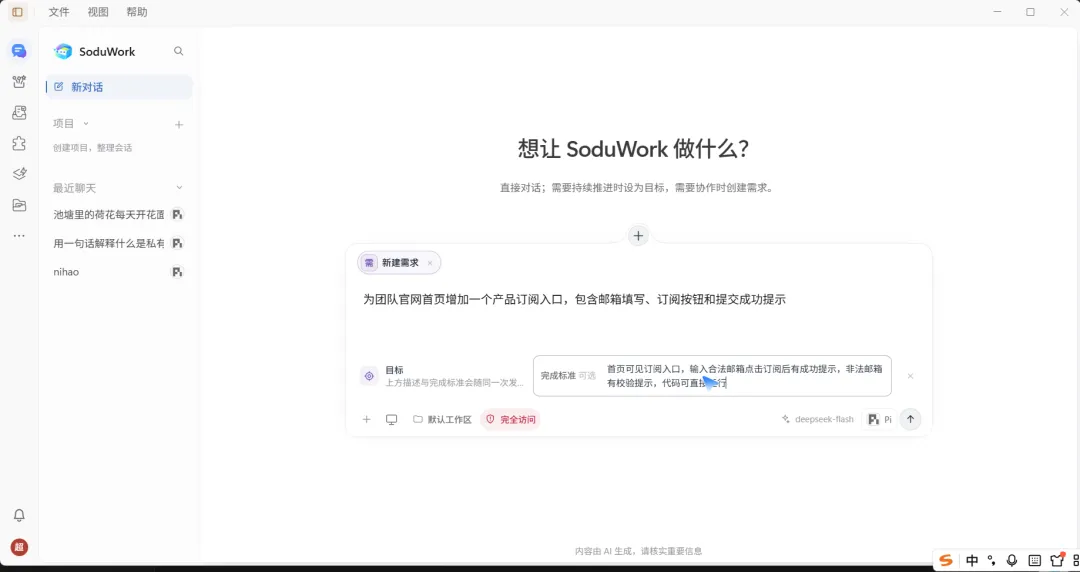
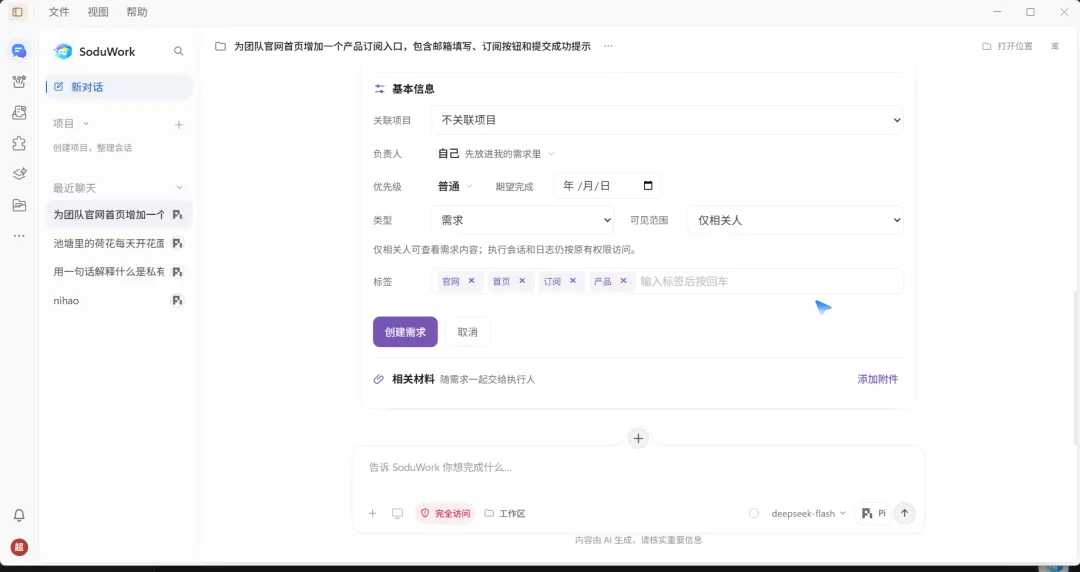
回车后展开完整需求表单,可设置关联项目、负责人、优先级、类型、可见范围、期望完成时间等。让我略感惊喜的是,系统自动从我的自然语言文本里提取出了 4 个标签:官网 / 首页 / 订阅 / 产品,不需要我手动逐个打。
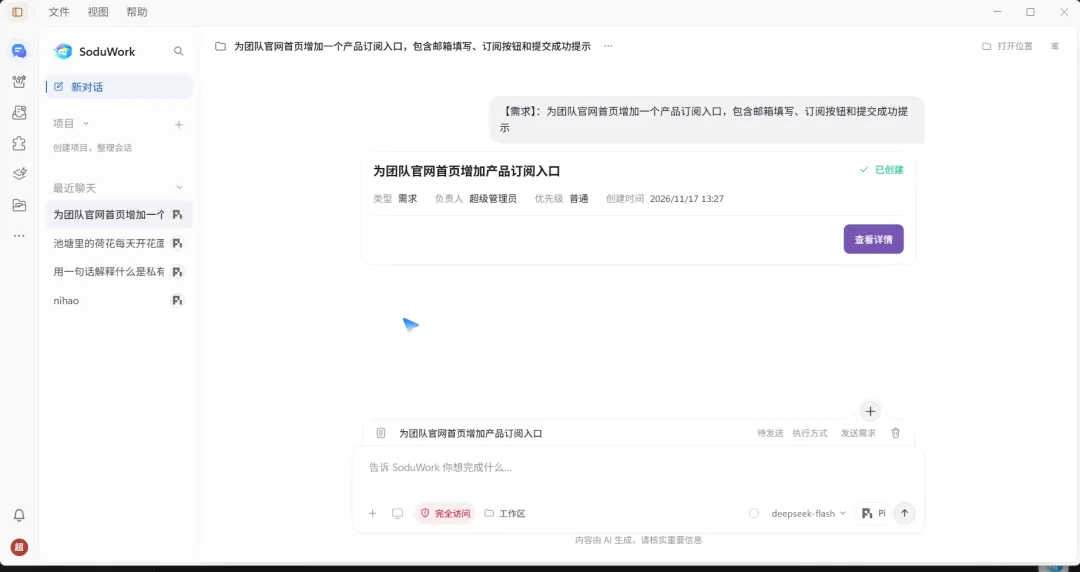
点击"创建需求"后出现绿色"已创建"提示,一条需求正式进入需求池。
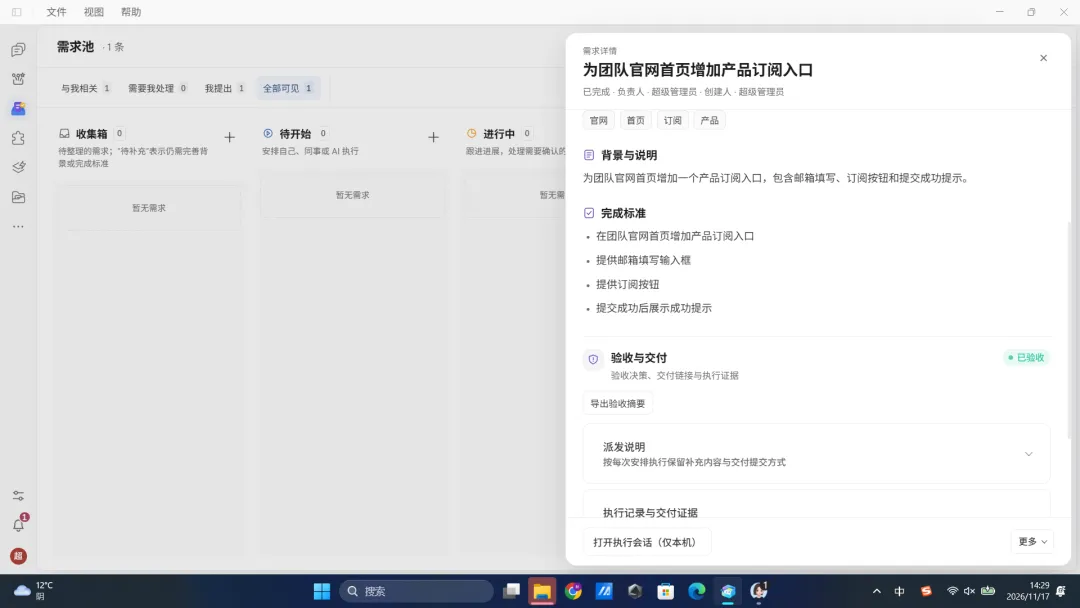
5.2 看板式需求池:完成标准被结构化,验收模块独立存在
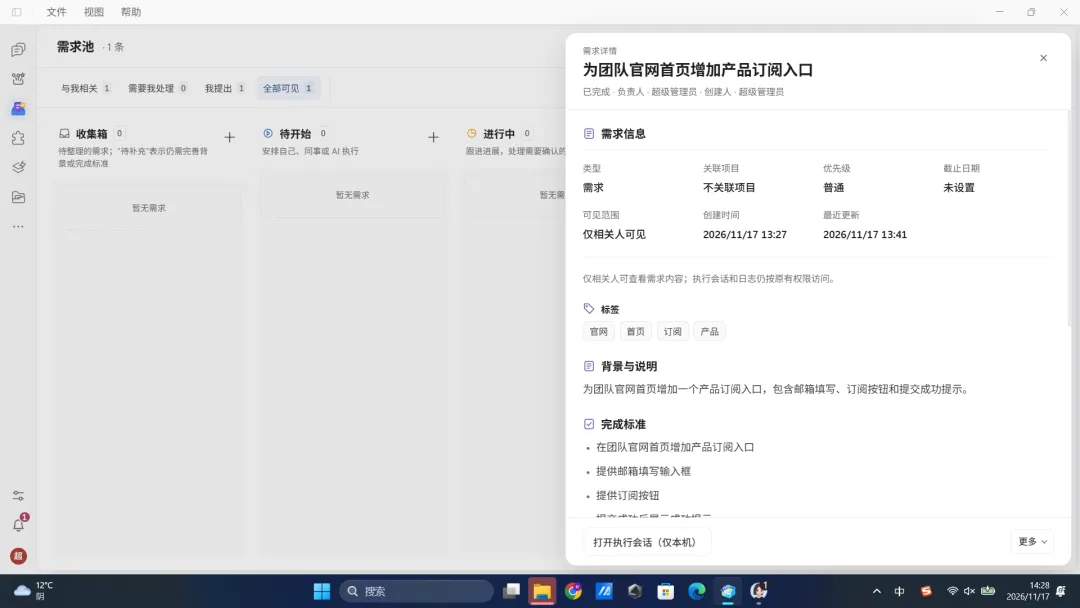
需求池采用看板布局,分为收集箱 / 待开始 / 进行中等列,并提供「与我相关 / 需要我处理 / 我提出 / 全部可见」等标签页。
点开这条需求,右侧详情把我写的完成标准结构化成了 4 条独立条目,而不是一坨文字。更重要的是,它单独提供了一个「验收与交付」模块,包含验收决策、交付链接、执行证据、导出验收摘要等功能——这说明"验收"在产品设计里是一个被严肃对待的独立环节,而不是执行完就自动结束。
5.3 安排执行:明确"交给谁、用什么、怎么交付"
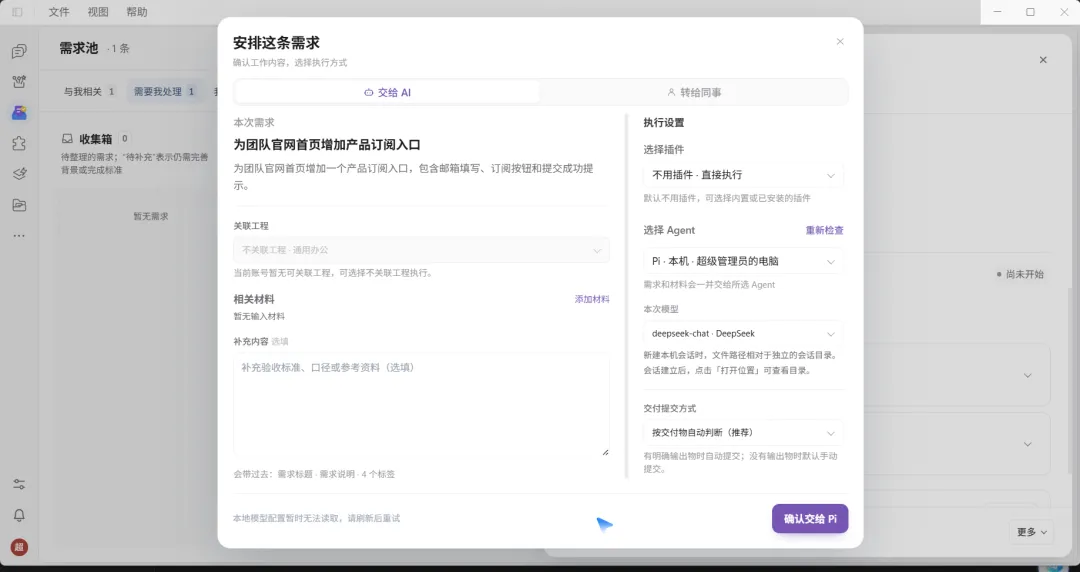
点击"安排执行",弹出执行配置面板。顶部有「交给 AI / 转给同事」两档,我选择交给 AI。右侧执行设置把一次执行的关键决策都列清楚了:
选择插件:不用插件 · 直接执行;
选择 Agent:Pi · 本机 · 超级管理员的电脑;
本次模型:deepseek-chat · DeepSeek;
交付提交方式:按交付物自动判断(推荐)。
确认后,系统进入一个独立的执行会话。这一步很关键:需求和执行是分开的——需求是被管理的对象,执行是为完成需求而派生的具体会话,二者通过关联串起来,而不是混在同一个聊天里。
5.4 Agent 自主执行:规划—编码—自测—修复的真实闭环
这是我最想观察的部分:Pi 拿到需求后,到底是"一把梭"直接吐代码,还是会像一个真正的工程师一样工作。
实测结果:本次执行持续约 14 分钟、共 66 次请求,完整呈现了一个工程闭环。它先检查工作区、确认没有现成工程,然后新建可预览的官网首页并加入订阅表单,接着读取技能说明、写入样式文件,再调用浏览器技能(browser-use)做真实的页面验证,而不仅仅是"写完即走"。
更能说明问题的是,它在过程中主动发现并修复了两个真实缺陷:
成功提示误显示问题:成功提示元素使用了
display: flex,覆盖了hidden属性,导致页面还没提交就显示成功。它通过在样式中加入[hidden] { display: none !important; }修复;无头渲染卡死问题:它通过对照实验定位到吸顶导航的
backdrop-filter在无头浏览器渲染下会导致截图卡死,于是改为不透明背景方案。
此外,它还做了桌面端与移动端的响应式验证,用 CDP 设备模拟确认 390px 视口下无横向溢出,并严谨地修正了文案——因为后端尚未接入,它主动声明"不宣称已发送确认邮件",而不是虚构功能。这种"不夸大、可验证"的行为,在 AI 生成内容里是相当难得的工程素养。
5.5 产物核验:文件真实存在,代码质量在线
我没有只看它的自述,而是直接到会话工作目录做文件系统核验,产物真实存在:
app.js 里的邮箱校验与提交逻辑是这样的(节选):
var EMAIL_RE = /^[^\s@]+@[^\s@]+\.[^\s@]{2,}$/;

form.addEventListener("submit", function (event) {
  event.preventDefault();
  var email = input.value.trim();

  if (!email) {
    showError("请填写邮箱地址。");
    return;
  }
  if (!EMAIL_RE.test(email)) {
    showError("邮箱格式看起来不对,请检查后再试。");
    return;
  }

  clearError();
  setLoading(true);
  // 演示环境:用短延迟模拟提交,真实项目在此处替换为后端接口请求。
  window.setTimeout(function () {
    setLoading(false);
    persist(email);
    successEmail.textContent = email;
    form.hidden = true;
    success.hidden = false;
    success.focus?.();
  }, 450);
});
index.html 则用语义化标签和完整的无障碍属性构建,包含跳转链接(skip-link)、aria-label、aria-describedby、role="alert"、aria-live="polite"、autocomplete 等,并不是一个"能跑就行"的简陋页面。注释也很诚实,明确标注演示环境与真实后端的替换位置。
5.6 验收与签收:手动验收 + 内置浏览器现场核对
执行完成后,进入验收卡。这里提供「手动验收(默认)/ 自动验收」两档:
手动验收:在新会话中核对本次固定版本与证据,不重新执行原需求,避免"验收时偷偷改了东西";
可填写验收补充说明、添加返修资料(不计入交付物),并可选择"退回修改"或"确认验收";
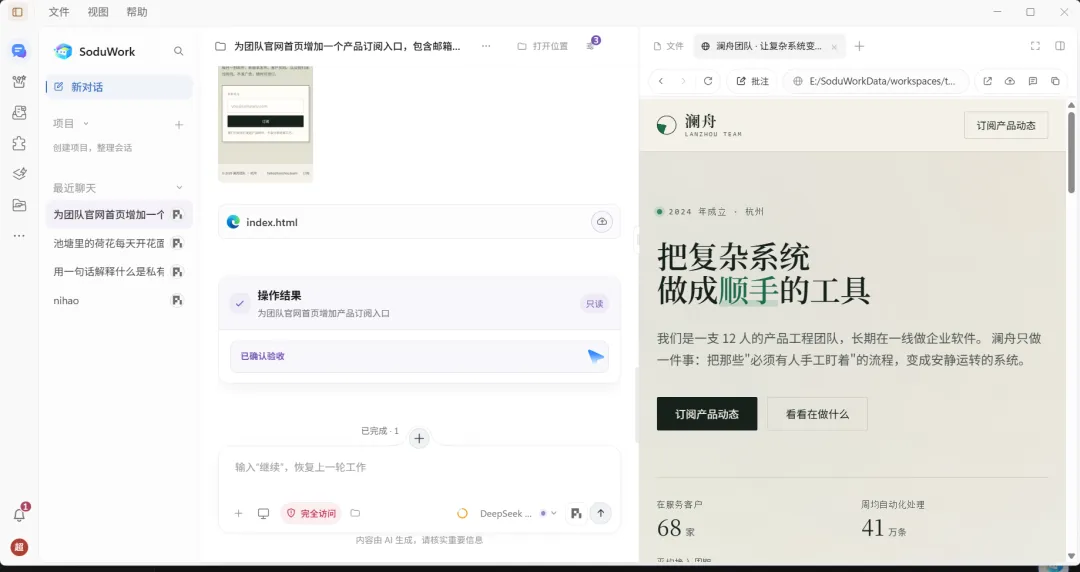
右侧内置浏览器可直接预览交付页面,现场核对效果。
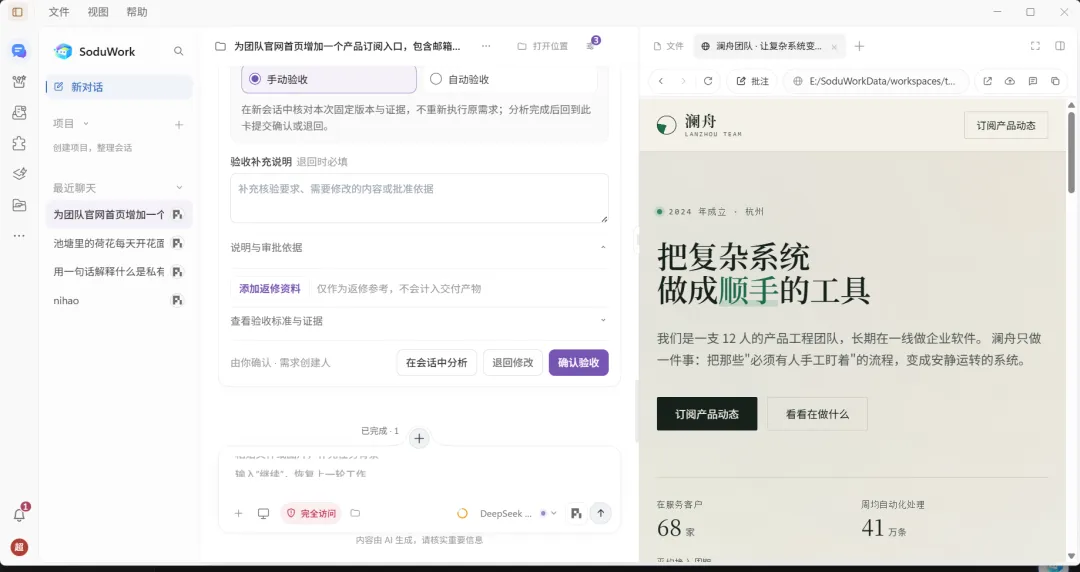
我确认无误后点击"确认验收",页面显示"已确认验收",这条需求从创建到签收的完整闭环正式跑完。
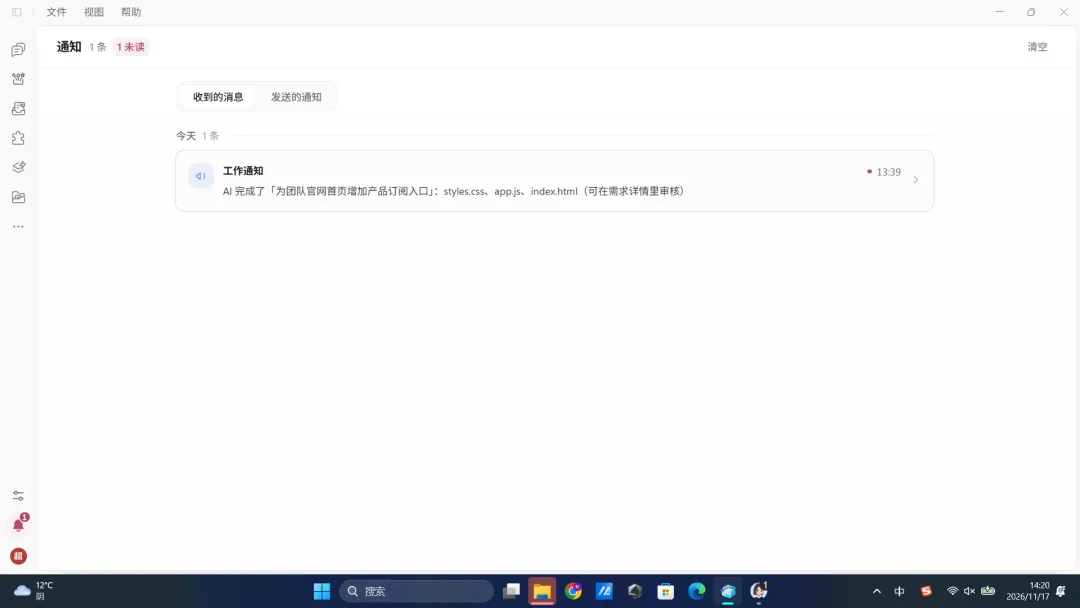
与此同时,通知中心收到一条工作通知,明确告知 AI 已完成哪些文件、可在需求详情里审核。
六、多 Agent / Harness 与 Runner:一个平台管多套执行体
6.1 Agent 管理:7 个可管理 Harness,Pi 已就绪
在 Agent 管理页,我看到统计为「1 已装、0 测通、7 可管理」,并且每个助手都可以单独指定模型。除内置的 Pi 外,还列出了 6 个可安装的 Harness:Codex、Codex Harness、DeepSeek Harness、Kimi Code、OpenCode、Qwen Code,并标注了各自的许可协议与接入方式(ACP 接入、是否使用企业模型、是否需要自己的账号等)。
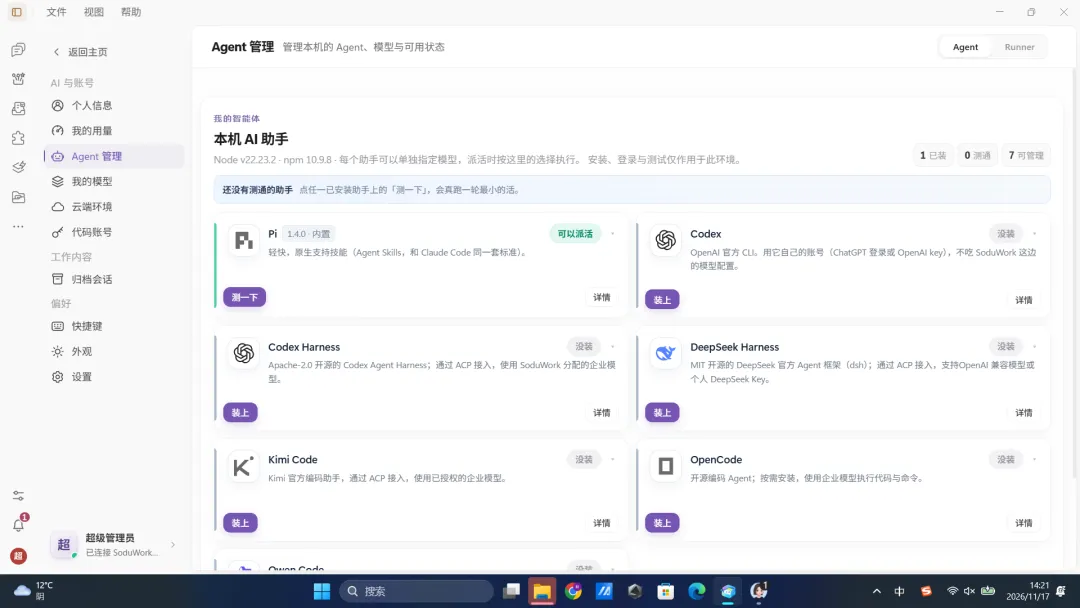
其中内置的 Pi 1.4.0 显示绿色"可以派活",支持 Agent Skills,和 Claude Code 采用同一套技能标准。其余 6 个当前为"没装"状态,可按需安装。这种"一个平台纳管多套 Agent 运行时"的设计,给了团队按场景挑选执行体的自由,避免被单一工具锁定。
6.2 Runner 管理:执行节点健康与接单状态可视化
Runner 标签用于管理执行节点。我看到自动调度策略为「1 个节点在线、1 个可接单,优先使用本机」。节点卡片实时显示资源占用与接单状态:
运行/等待任务数:0/1 运行、0 等待;
实时资源:CPU 在约 14%–21%、内存在约 78%–79% 间动态变化;
节点标记"首选 / 可接任务",可"查看详情 / 测一下 / 停止接新任务"。
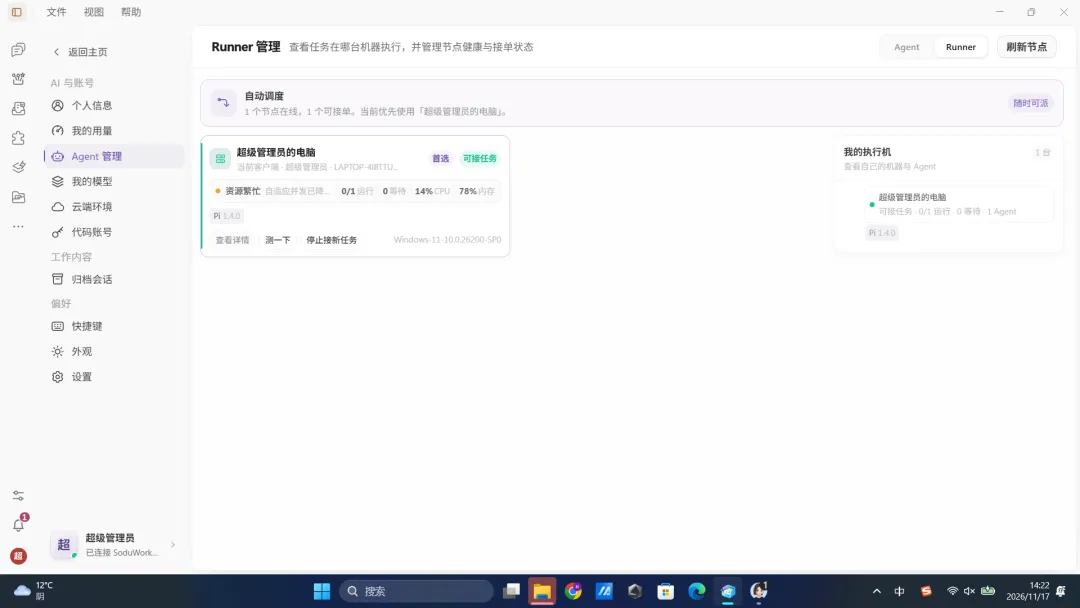
这意味着当组织里有多台机器时,可以把它们统一作为执行资源池纳管,按健康度和接单状态自动调度,而不是只能在当前这台电脑上跑。
七、插件、技能与自动化:把"工作方法"沉淀下来
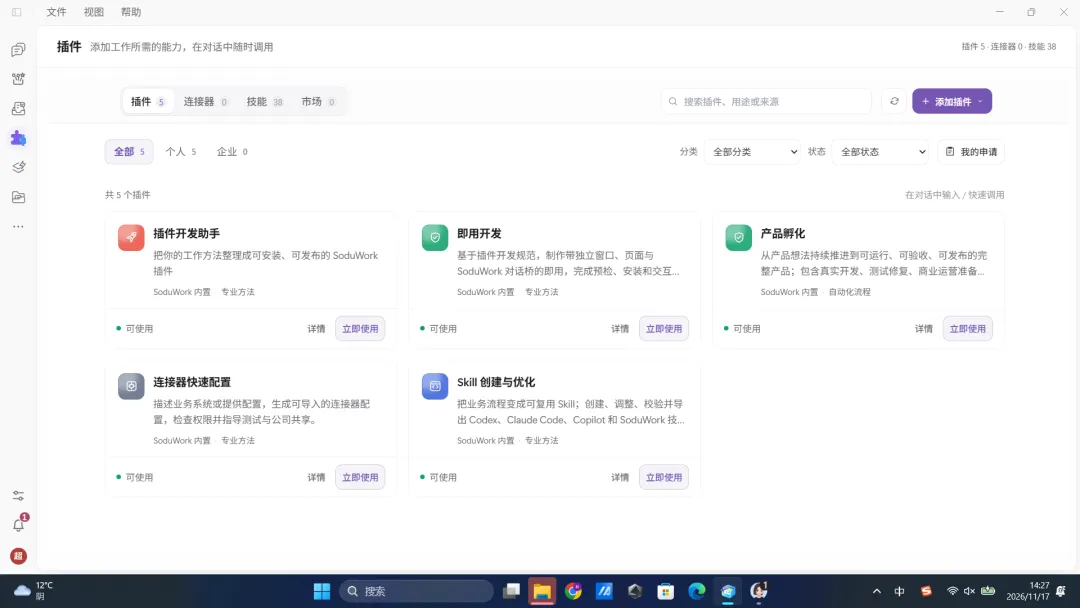
7.1 插件中心:5 个插件、38 项技能、连接器与市场
完整插件页清晰地分为「插件 / 连接器 / 技能 / 市场」四个标签。我这次实测到 5 个内置插件、38 项技能、0 个已接连接器:
插件包括:插件开发助手、即用开发、产品孵化、连接器快速配置、Skill 创建与优化;
连接器页提供企业微信、钉钉、飞书等常用连接入口(官方显示常用连接模板数量可观),连接一次即可在对话、插件和自动化中复用;
市场标签用于后续扩展。
7.2 38 项技能:覆盖完整软件工作流,可逐项开关
技能标签里的 38 项技能,覆盖了从需求到交付的完整链路,且每一项都可以独立开关、开启后在下一次任务生效。我看到的代表性技能包括:
需求与方案探索、智能体产品设计、领域建模;
浏览器操作、电脑操作、前端设计、代码架构设计;
代码审查、发起代码审查、处理审查意见、解决合并冲突;
交付检查、故障诊断、系统化调试、完成开发分支;
Office 文档、演示文稿、技能创建与优化等。
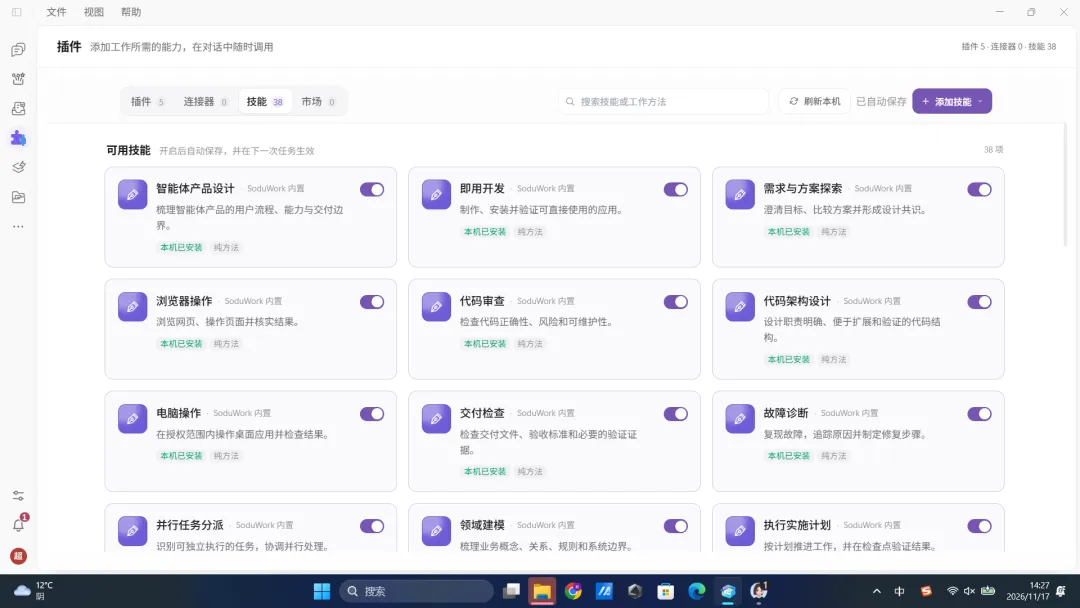
这套技能的价值在于:工作方法可以被显式管理和复用,而不是全靠模型自由发挥。你可以根据任务类型,决定这次给 Agent 开放哪些能力。
7.3 自动化(Schedules):让重复工作按时执行
通过快捷键 Ctrl + Shift + U 可进入自动化页面。它的定位是让重复工作按时执行,过程与结果留在对话中。
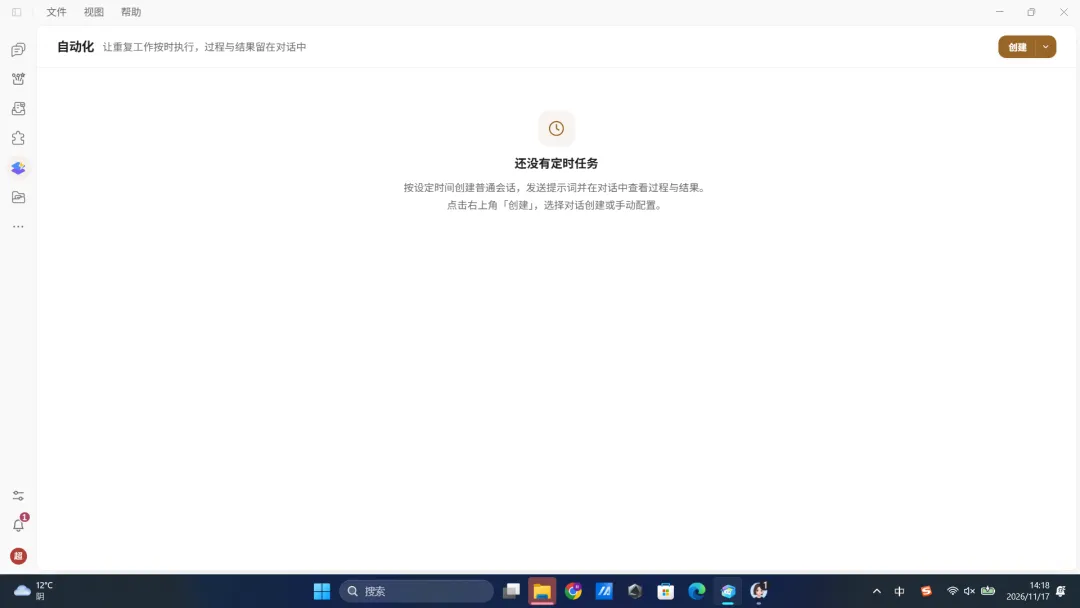
在手动配置面板里,一次自动化可以完整设置:
要它干什么:标题与交给 AI 的原话(每次原样发送);
什么时候跑:支持每天 / 每周 / 每月 / 每小时 / 仅一次 / 自定义,按北京时间执行,触发精度约两分钟;
在哪儿运行:可指定工程,也可留空做通用办公;
怎么执行:执行底座与模型独立保存、分别选择;
容错:失败自动重试(可设次数与间隔)、启用开关。
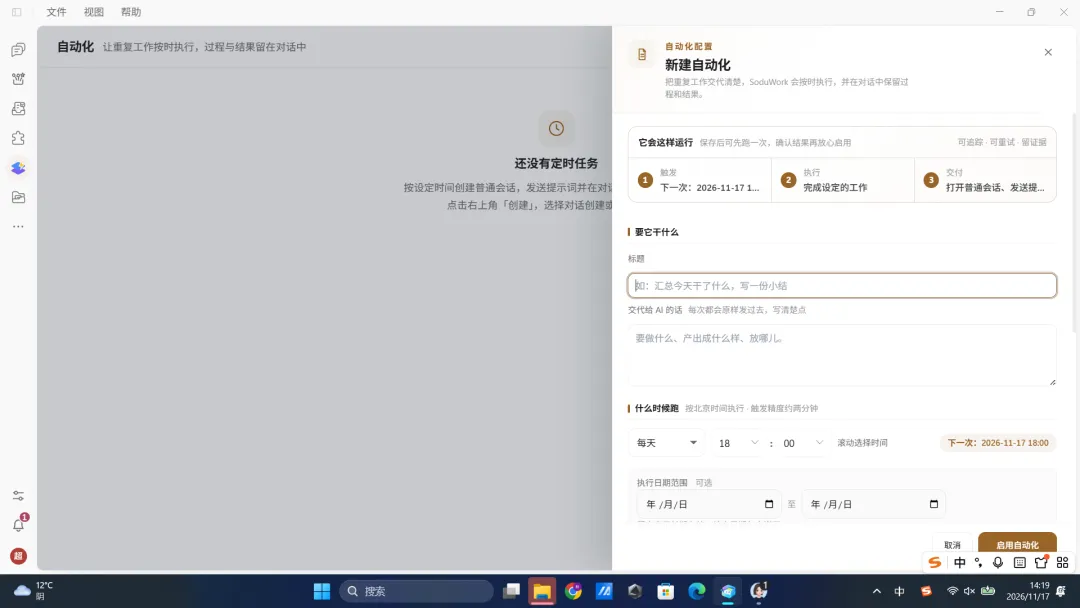
每次触发都会创建一个普通会话,把提示词、模型输出和结果保留在一起,做到可追踪、可重试、留证据。这非常适合每日汇总、定期巡检、网页填报这类重复工作。我本次仅做配置体验,未实际启用,避免产生无意义任务。
八、用量与成本治理:用了多少一目了然,本地版不自动计价
在"我的用量"页,SoduWork 把 AI 消耗做了可视化呈现,可切换 7 / 30 / 90 天。本次实测的累计数据为:
按 Agent / 模型拆分:
Pi + deepseek-chat:1,947,997 token、66 次请求;Pi + deepseek-reasoner:6,666 token、1 次请求。
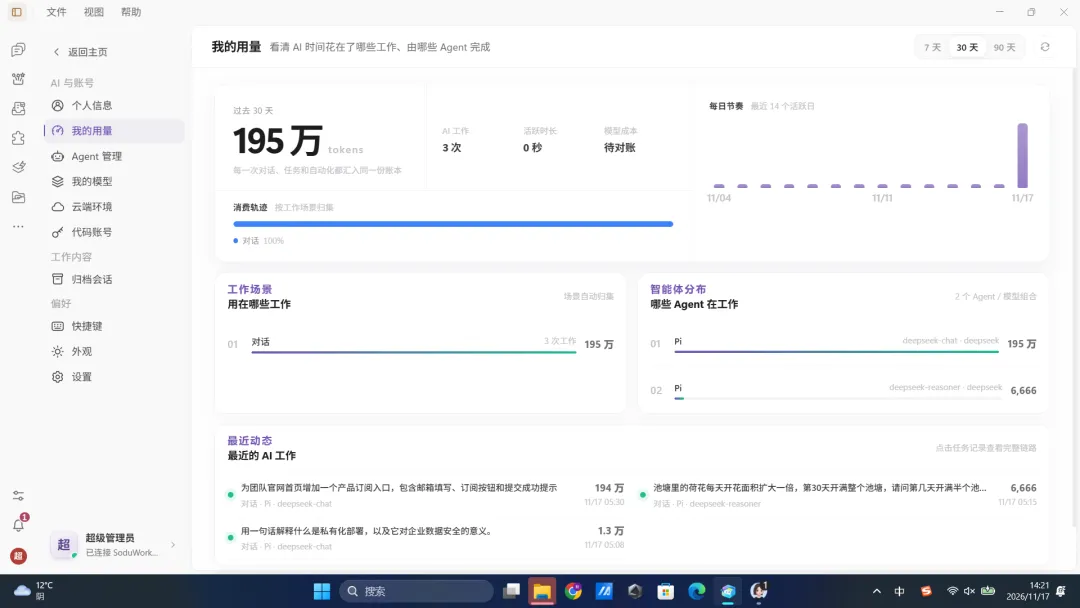
需要特别说明的是,本地私有化版本没有内置价格表,不会自动计价,接口返回的成本标识为"未知",界面显示"待对账"。这是诚实的设计——它不虚构一个成本数字,实际花费需要你按所用模型服务(如 DeepSeek)的官方价格自行核算。对企业而言,这也意味着成本治理要结合自己的模型账单来做。
九、客观评价:优点、局限与适用人群
做得好的地方:
真正闭环的工作流:需求、执行、验收、签收各自独立又相互关联,这是它和"聊天框产品"最本质的区别;
多底座 + 多 Agent 架构:模型可替换、Harness 可扩展,避免被单一厂商或工具锁定,且凭据分层、密钥不回显;
Agent 具备工程素养:会自测、会修真实缺陷、会做响应式验证、不虚构功能,产物可在文件系统核验;
管理能力完整:执行节点健康监控、用量可视化、插件技能可治理、自动化可定时,覆盖了团队落地的周边需求;
安全基线友好:默认回环监听、私有化部署、凭据本机安全存储。
需要正视的局限:
不算轻量:数据目录约 1 GB、Electron 多进程内存约 1 GB,对小磁盘、小内存机器有压力;
125% 缩放下窄轨道图标易点空:虽然可用斜杠命令和快捷键规避,但首次上手需要适应;
其余 6 个 Harness 默认未安装:要体验完整的多 Agent 能力,需要额外安装、部分还需对应账号或密钥;
适合谁: 有私有化部署需求、希望把 AI 纳入规范工作流(带需求管理与验收签收)的小微团队和个人开发者;尤其是既要用 AI 提效、又在意数据安全和厂商锁定的人。
不太适合谁: 只想轻量聊天、机器配置紧张、完全不想做任何配置的用户——这类需求用更轻的纯客户端可能更省心。
一句话总结: SoduWork 不是一个更聪明的聊天框,而是一个让 AI 能被"派活、交付、验收、签收"的工作平台。如果你需要的是一次性的问答,它可能太重;但如果你想把 AI 真正放进可管理、可追溯的工作流,这次实测证明——这条闭环,它确实能跑通。
项目地址:https://github.com/mdiri-ai/SoduWork