ARTICLE · 1379304
PDF明明有图,AI为什么只会念文字
同一份PDF,100页时可以连图带字读,101页时却可能只剩文字。
原因在Claude官方帮助页写明的文件处理规则里:100页以内分析文字和视觉元素;101至1000页只处理文字。
于是,一份教材上传成功、摘要也写得像模像样,仍不能证明里面那张关键示意图参加了回答。要让AI帮你读懂图,第一步有时不在提示词里,而在你把材料交进去的方式里。
你看到一整页,它收到的可能是一串字
PDF很适合把页面原样交给另一个人。标题放在哪里,哪段文字挨着哪张图,打印出来大致还是那个样子。
但软件读文件,未必像人一样打开页面看。它可以先把里面的文字抽出来,再交给模型。这条路适合找句子、做摘要,却不必经过图像理解。
假设有一张阶段比较图:横轴是时间,两个系列用不同线型表示,旁边的正文只写了“结果见下图”。这是一个解释用的例子。
如果输入只保留文字,AI或许能读到标题、时间标签和“结果见下图”,却没有拿到两条线如何起伏、在哪里交叉的信息。让它把回答再写详细一点,并不能从这些字里找回没有传入的线条。
即使图中的文字也被识别出来,事情仍没做完。“第一阶段”“第二阶段”都在,不等于软件知道哪个数字属于哪条线,箭头从哪儿指向哪儿。识字与理解图形关系,需要不同的信息。
开源PDF解析工具pypdf的文档就解释过这种困难:一些表格在文件里只是按位置摆放的文字,抽取时还要判断行列;扫描件则可能只有一张图片,也可能在图片背后另藏一层识别出的文字。
因此,能在PDF里选中文字,是一条有用线索,却不是“所有图都能被AI看懂”的证明。文字层存在,线条、颜色和布局仍可能没有进入同一次分析。
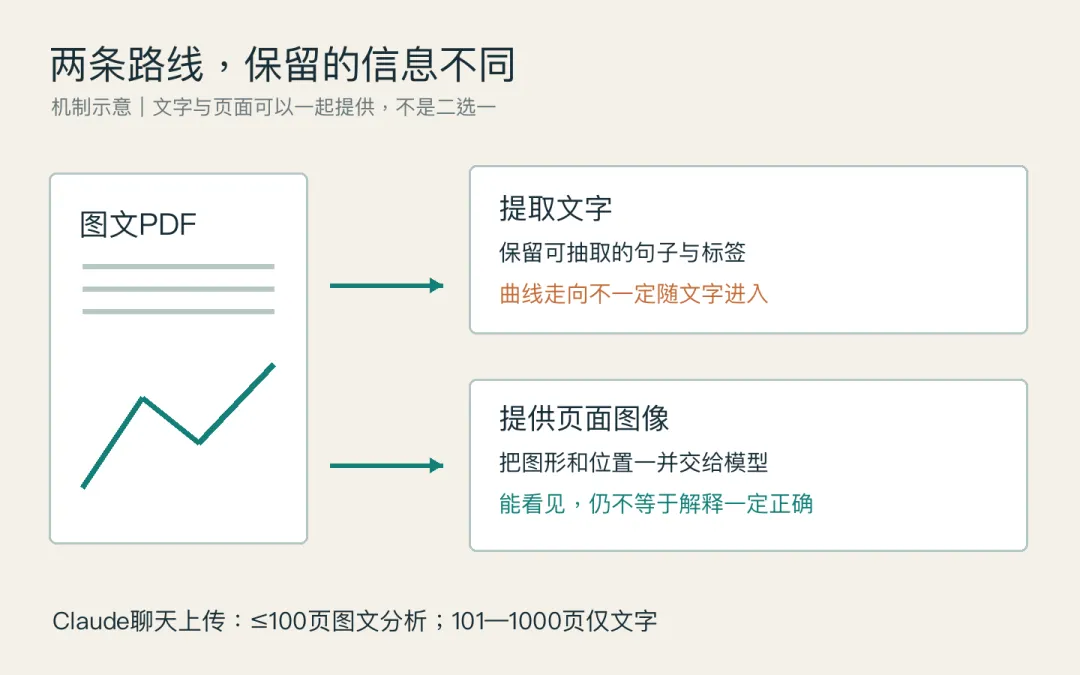
另一条路线,是把页面也交给有视觉能力的模型。Anthropic的API技术说明描述得很直接:每页转为图片,同时提取该页文字,二者一起用于分析。
保留文字,有利于读句子和查找内容;保留页面,有利于理解图形与位置。两条路可以配合,不需要把整份报告一律截图,也不必认为“模型会看图”就意味着所有文件入口都自动这样处理。
那道100页的分界,管的是整份文件
回到Claude的例子,有一个细节值得单独说清。
官方的规则不是“一份长PDF先看前100页的图,后面只看文字”,而是按整份文件的页数分类:100页以内采用图文分析,101至1000页采用纯文本处理。因此,长文件里很靠前的一张图,也不能只因它位于前100页,就认为一定走了视觉分析。
这会改变整理资料的方法。
若读的是一整本教材,想先知道各章讲什么,可以把长文件用于文字层面的梳理。接着研究某张图时,再把相关章节另存为较短的PDF,或者直接上传那一页的清晰图片,把图和解释它的文字一起提供。
拆分的目的不只是让文件更小。在这个具体入口里,它还可能改变材料被处理的方式。与此同时,别把解释某个符号的前一页、说明实验条件的图注都拆掉:图能看见了,缺少上下文,仍会读偏。
这条规则依据的是Claude聊天上传帮助页,不能直接套到API,或能够另外调用工具渲染页面的程序上。Claude当前也不支持中国大陆,须符合其地区和账号条件;这里用它说明处理规则,不是要求读者为此购买海外会员。
对于自己已经在用的AI,更有用的问题是:这个入口会处理文件里的图片吗?长文件是否会改变处理方式?只看“最多支持多少页”,还回答不了这些问题。
同一个产品,放进资料库与附在对话里也有区别
另一处容易混淆的地方,是上传的位置。
把文件存进长期使用的项目资料库,与在当前对话里附上一份文件,看起来都叫“上传”。产品却可能用不同方式准备材料:前者更侧重以后从资料里检索内容,后者可以直接围绕这次附件进行分析。
OpenAI的帮助文档明确区分了这两类入口。GPT知识文件、项目资料文件,与聊天中直接附上的PDF,处理方式不同;要问某张图,官方建议直接附PDF,或者把图单独上传。已经进了项目,也可以在项目内的具体对话里另附文件,不必把“项目”两个字理解为一条统一的阅读路线。
至于个人套餐究竟能否直接读PDF嵌图,OpenAI目前的公开说明并不一致:通用上传页写可以分析PDF文字和图像,专门的视觉FAQ仍写Enterprise专属。我不会据此宣布所有个人版都已开放,也不建议仅为这一点付费升级。
能明确执行的办法是:需要讨论哪张图,就在支持图片输入的对话里附上它,不只指望资料库中的文字检索。使用仍须符合产品的地区、账号及用量条件。
一张整页,一张局部,分别解决两件事
真正准备材料时,可以把问题缩到一张图,而不是反复要求AI“仔细阅读全文”。
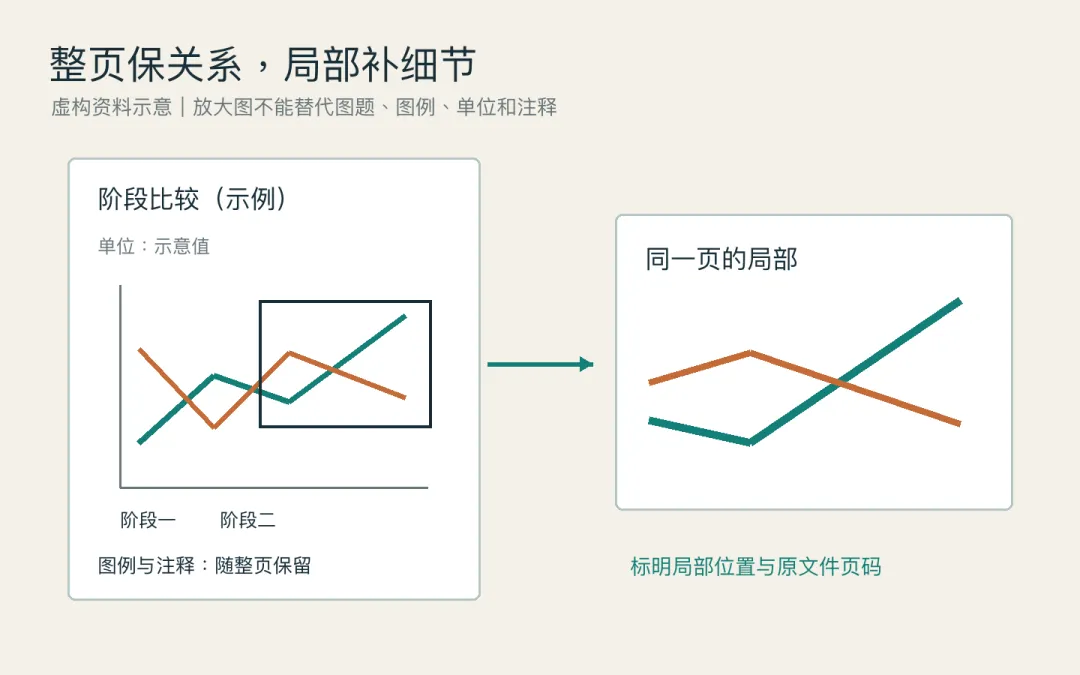
先保留整页。图题、图例、坐标轴、单位和脚注都要在,相关说明不在同一页时,一并提供。它们告诉模型这张图在比较什么,以及结论受什么条件约束。
如果字太小,再补一张局部放大图,并说清它来自整页的哪个位置。整页负责保留关系,局部负责看清细节。只截中间的曲线、裁掉纵轴单位,反而可能让一张更清楚的图变得更难解释。
提问也可以更具体。比如下面这段请求示例:
第一张是整页,第二张是同一页右下角的放大图。请结合正文,解释这张图比较了什么、图例和单位分别是什么,再说明主要变化。看不清的标签请单独列出;没有标数值的位置,不要补成精确数字。
这样问,是把“看图”分成能检查的动作。模型先说清系列和单位,你就更容易发现它是否把两条线认反,而不必等一整段结论写完后重新猜错在哪里。
页码也要留下对应关系。另存章节后,新文件的页码可能重新开始;文档印着的页码与阅读器显示的页码,也未必相同。可以在请求里写明:“本附件第3页,对应原PDF阅读器第27页。”这是标注方式示例,方便之后回到原位置,不是让模型自行猜页码。
最后,要分清自己是在请它解释图,还是准备拿数字继续算。
看趋势、理解结构、解释流程,可以围绕页面问。要计算增长率、求和或重画精确图表,优先找原始表格;只有图时,让它把能读到的数值、单位和位置列出来,再与原图核对。没有标出的数值,不能因为生成了一张整齐的表,就变成精确数据。
图片输入也可能看错颜色、实虚线和小字。把图传进去,解决的是模型有没有拿到视觉材料;解释得对不对,仍然是下一步。这不是无用功:材料完整,错误才更容易被定位和修正。
下一次把一份报告交给AI,可以让原文件负责交代全局,让相关页面负责讲清图,再把需要核算的数据单独拿出来。你要的就不再只是“把这份PDF总结一下”,而是沿着其中真正有信息的地方,一处处读懂。