ARTICLE · 1392201
一份文档吃掉约 3 GB 内存,Claude Docs 团队把问题追到了每一次按键
在一份长文档的末尾补个句号。你看见屏幕上多了一个点,大概不会想到,后台刚刚把整份文档复制了好几遍。
Claude Docs 上线前,团队就碰到了这个毛病。工程师 Vivek Nair 在 11 月 17 日的复盘里写道,他们在测试时发现,光是一份大文档,在处理它的服务器上就占了约 3 GB 内存。这里说的是服务器为了让人打开、编辑这份文档,要在手边放多少东西。你把文件下载到电脑上,看到的大小是另一回事。工程师原文
先把时间拨回到还没人知道原因的时候。屏幕上只有那个难看的数字。换你来查,你会从哪儿下手?
第一个猜测,其实挺像那么回事
为了让文档下次打开得快一些,服务会把用过的数据留在内存里。这就是缓存。Claude 猜,会不会是文档在缓存里待得太久了?它先把团队自己维护的一处缓存缩小,让服务器早点把文档移出去。
如果猜对了,再拿同一份文档测一次,就该看见这处缓存少占了内存,原来的问题也跟着缓解。第二轮测试却把线索指向了项目依赖的一个软件组件。这个组件也有自己的缓存,大头在那里。
于是 Claude 把刚才的修改撤了。
我读这篇复盘时,在这里停了一下。假如它只回一句“已优化缓存”,我很可能会觉得这事办得挺利索。改动有了,解释也很顺,还能讲清为什么理论上会有效。可接下来的问题更要紧。改的是这一个,吃掉内存的是哪一个? 第二轮测试把这两件事分开了。
为什么一个按键,要搬动整份稿子?
接下来,Claude 把测量拆得更细,去看内存究竟花在什么地方。这时才看清按下一个键之后发生了什么。程序会把整份文档复制进好几种数据结构里。对测试中的那份大文档来说,一次按键又要多占几 MB。
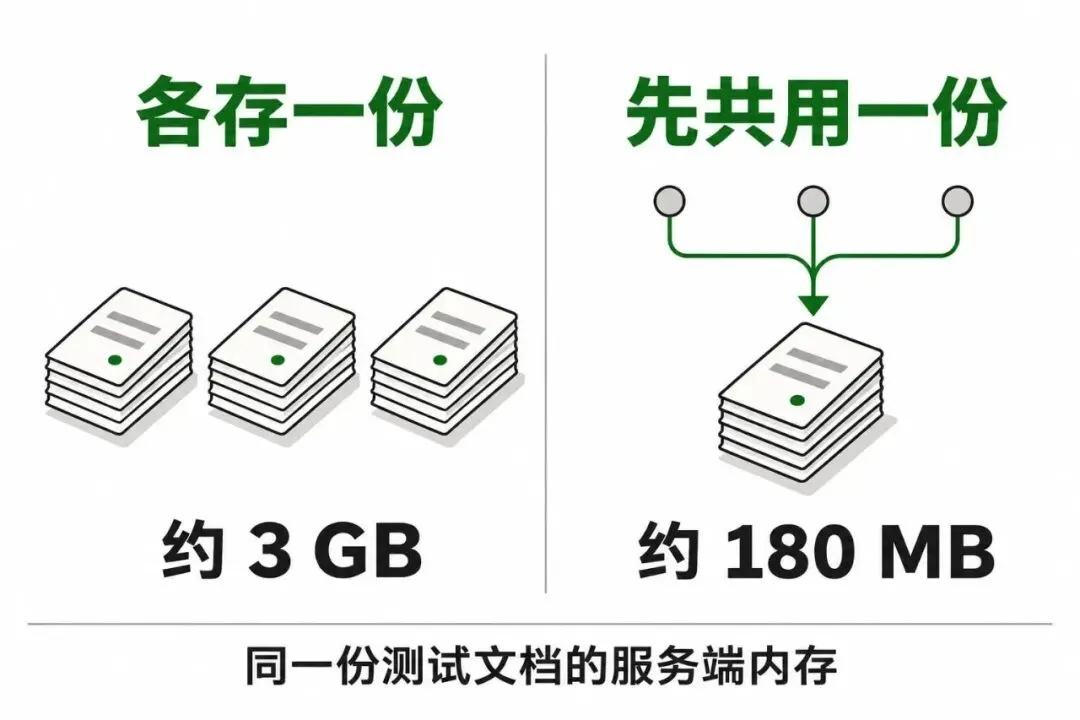
你可以把它想成一张长桌。几个人要查同一份厚稿子,只要指一下页码就能说清的事,桌上却给每个人都摆了一摞完整的复印件。作者在末尾补个句号,复印机又忙起来了。
Claude 随后改了这几处存文档的方式。需要看同一版内容时,几处都指向同一份。等到其中一处真的需要改出一个不同的版本,再给它单独一份。工程上把这个办法叫作“写时复制”。这么一来,只要几处看到的内容还一样,内存里就可以少摆几摞稿子。
前后大约三天,那份文档在后续测试里的内存峰值降到了约 180 MB。用户还是在同一份稿子上打字。服务器终于省下了原来在背后反复搬稿子的那份力气。
要是我来验收,还想看最后一件事
看到 180 MB,这活儿是不是就可以收了?
还有一个比内存更贴近用户的问题。几个人在同一份文档里接着改,屏幕上的“已保存”亮了。你关掉页面,再回来,刚才那个句号还在吗?
Nair 写到,团队在测试前给 Claude 定了两条要求。一是有很长编辑历史的文档也得很快打开。二是服务器只要确认收到了某次编辑,测试就得能证明这次修改还在。优化期间,这两件事都要继续查。
我挺喜欢第二条。假设是我在团队稿里改了一句客户报价,我不会知道后台用了几份副本,也不会记得昨天它用了多少内存。我只知道我把价格改对了,页面告诉我已经保存,同事明天打开时,就该看到那个对的数。
所以,下次 AI 跟我说“已经优化好了”,我会把任务里原来最让人头疼的那份材料再递给它。就拿这一份,改前和改后各量一次。然后,再用平常的方式打开它,看看那个句号还在不在。