ARTICLE · 1397758
数据归一化:PDF、图片、Word 如何收敛成同一种结构
系列第 3 篇。上一篇讲了索引产线的六个阶段,这一篇展开其中最容易低估的一环:把不同来源、不同格式的资料,变成同一种可以被切片的中间结构。
一、"归一化"不是"转成文本"
很多团队对数据归一化的理解是:把 PDF 解析成文本,把 Word 解析成文本,然后统一走切片。
这个理解会带来一个几乎无法修复的后果:结构信息在第一步就丢了,后面所有环节都在补救。
举个具体例子。一份产品手册里有这样一段:
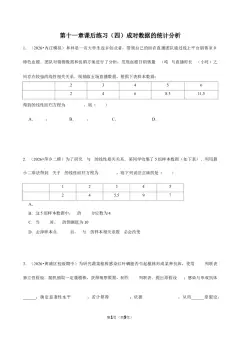
不同型号的适配要求如下表所示:
表格有三列:型号、额定功率、适配机型。表格下面还有一句:"型号后缀带 H 的为高湿环境版本。"
如果归一化输出是纯文本,会变成:
不同型号的适配要求如下表所示: TX-2000A 45kW 标准机柜 TX-2000B 55kW 标准机柜 TX-2000H 55kW 高湿机柜 型号后缀带 H 的为高湿环境版本。模型看到这堆内容,无法确定"45kW"属于哪一列,也无法确定"型号后缀带 H"是一条全局规则还是针对某一行的说明。检索到这段内容时,生成的回答很容易把功率张冠李戴。
而如果归一化输出保留了结构:
{"type": "table","payload": {"row_size": 4, "column_size": 3, "merge_info": []},"cells": [["型号", "额定功率", "适配机型"], ["TX-2000A", "45kW", "标准机柜"], ...]}
再配合紧随其后的正文块,语义就完整了。
所以本项目对归一化的定义是:
将 PDF、Office、网页、扫描件等不同来源的内容,转换为包含标题、段落、表格、图片和来源信息的统一文档结构,供后续切分与索引使用。
关键词是"结构",不是"文本"。归一化的目标产物不是一段字符串,而是一棵带类型、带层级、带来源的树。
二、为什么 Markdown 不能作为唯一中间结构
Markdown 是一个诱人的选择:可读、通用、模型熟悉。但把它作为唯一中间结构,会踩三个坑。
坑一:表格的合并单元格表达不了。 Markdown 表格语法不支持 rowspan 和 colspan。一份带三层表头的报价单,转成 Markdown 后表头关系彻底塌陷。企业文档里,合并单元格是常态而非例外。
坑二:层级与归属丢失。 Markdown 只有 # 到 ###### 六级标题。飞书文档支持九级标题,且允许跳级(一级标题下直接出现三级标题)。转成 Markdown 时,要么被强行改写层级,要么被截断。
更麻烦的是"归属":一段正文到底属于哪个章节?Markdown 靠人眼判断,程序只能靠最近的上一个标题推测。一旦出现跨章节的说明性段落,推测就会出错。
坑三:图片失去了位置语义。 Markdown 里图片是一个链接,但"这张图在第 3 节第 2 段之后"这个位置信息没有了。而图片理解恰恰依赖上下文——同一张架构图,放在"部署方案"章节和放在"故障排查"章节,描述重点完全不同。
所以本项目的做法是:Markdown 是渲染结果,JSON 是中间结构。
结构树用 BlockNode 表达,每个节点包含:
class BlockNode:block_id: str # 来源块 IDblock_type: BlockType # 枚举,未知类型保留原始整数content: str # 仅本节点内容,不含子树payload: dict # 表格尺寸/合并信息、代码语言、图片存储位置children: list[...] # 有序子节点
等到需要给模型看时,再按需渲染成 Markdown 或 HTML。渲染是可逆的、可替换的;结构丢了就不可逆了。
三、选型的五个评估维度
市面上可选的文档解析方案不少。本项目的选型表覆盖了 8 个方案,评估维度收敛为五条:
维度一:结构保真度。 能不能输出标题、段落、表格、图片的边界,而不只是一段文本流。这一条决定后续切片质量的上限。
维度二:表格能力。 是否输出 HTML 或结构化单元格,能否保留 rowspan / colspan。企业文档里表格承载的信息密度最高,这一项权重极大。
维度三:阅读顺序。 多栏排版、图文混排、页眉页脚干扰下,能否还原正确的阅读顺序。这是 PDF 解析的老大难。
维度四:部署与成本。 能否私有化部署。企业知识库涉及客户资料、报价体系、内部工艺参数,绝大多数场景不接受把文档上传到第三方 API。
维度五:许可与可持续性。 开源协议是否允许商用,模型权重是否另有条件。这一点经常被忽略,直到法务审核才发现问题。
按这五条,主流方案的定位大致如下:
本项目的落地策略是分层处理,按来源选路径:
- 飞书文档
:走官方 API 拿原生块结构,不经过任何解析器。这是最优路径——结构是文档自带的,不需要推测。 - PDF / 扫描件
:走 MinerU 或 PaddleOCR 的文档解析产线,优先保证版面与表格。纯 OCR 只解决"字认出来",不解决"结构还原"。 - Office 文件
:走原生解析(python-docx、python-pptx)拿段落与表格,缺失的图片理解再补视觉模型。 - 网页 / HTML
:走 DOM 结构提取,保留标题层级与列表。
关键判断是:能拿原生结构就不要走 OCR,能走文档解析就不要走纯文本抽取。 每往下一层,信息损失就多一层。
四、归一化过程中必然发生的信息损失
即便选对了工具,归一化仍然会损失信息。承认这一点,比假装没有更有价值。
损失一:版式语义。 "这段文字用红色标注"在结构树里通常只剩一个类型标记。而红色在很多企业文档里表示"注意"或"变更"。可行的补偿方式是把样式差异转成显式标记(比如 [警告] 前缀),而不是彻底丢弃。
损失二:跨页与跨块引用。 "见上一页表 3"这类指代,在结构化之后失去了指向。补偿方式是在切片时保留上下文占位符,让相邻块可以被一起召回。
损失三:图片的原始分辨率语义。 一张工艺流程图,缩略图和原图承载的信息量差异巨大。所以本项目在归一化阶段只记录图片的 token 和存储位置,真正的理解放到后续的多模态环节,用原图。
损失四:批注与修订痕迹。 飞书文档的评论、Word 的修订记录,通常不在正文块里。这些内容往往包含关键决策信息。本项目当前不处理批注,这是一个明确的边界,也是一个已知的待补项。
工程上有一个通用原则:归一化层要把"能保留的都保留",下游按需取用。 不要在上游做"这个字段以后可能用不上"的判断,因为下游的需求变化永远比你的预判快。
五、标准结构的四个必备要素
回到本项目的结构树设计,有四个要素是不可省的。
要素一:稳定的来源标识。 每个节点带 block_id,每份文档带 space_id、node_token、obj_token、revision_id、url。这些字段支撑三件事:增量更新(比对 revision)、权限过滤(按 space 限定)、来源引用(回答里给出可点击链接)。
要素二:可判定的类型。 类型不是"文本/非文本"二分,而是细分到 page、heading、image、table、code。因为不同类别的切片策略完全不同——代码不能按句号切,表格不能按段落切。
要素三:独立的自身内容。 每个节点的 content 只包含自己的内容,不拼接子树。这一点在实现时很容易写错:图省事把子树全文拼进父节点,会导致父切片的体积爆炸,且与子切片内容重复。正确做法是父节点保留占位符,子内容独立成文档。
要素四:可校验的关系。parent_id 与 children 必须一致,不能出现"子块声明了父块,但父块没把孩子列进来"的情况。这类不一致在真实数据里并不罕见,必须显式报错而不是容错处理。
六、一个反例:容错处理如何埋雷
很多解析代码会这样写:
try:tree = build_tree(blocks)except Exception:logger.warning("构建失败,跳过该文档")return []
看起来稳健,实际是灾难的开始。
因为归一化的错误具有传导性:一棵结构错误的树,会产生错误的标题路径;错误的标题路径会让切片挂到错误的章节下;错误的章节归属会让检索命中后给出错误的上下文。最终表现为"模型答非所问",而你去查生成提示词、查 rerank 参数,永远查不到根因。
本项目的处理方式是快速失败:空输入、重复 ID、多根节点、父子冲突、重复挂载、成环、图片缺 token、行内元素不支持——全部抛 ValueError,并明确指出是哪个 block_id 出的问题。不返回"部分成功的树"。
这样做短期内会让失败率看起来很高,但每一个失败都是可定位、可修复的。而静默容错制造的是一批"看起来成功、实际错误"的数据,污染整个索引,且无法通过任何指标发现。
七、本篇小结
三点:
- 归一化的产物是结构,不是文本。
Markdown 可以作为渲染层,不能作为唯一中间表示。 - 选型看五维:结构、表格、顺序、部署、许可。
能拿原生结构就不走 OCR。 - 宁可失败,不可静默降级。
结构错误会一路传导到回答,且极难溯源。
下一篇进入结构重建的核心:一份扁平的、可能乱序的、带脏数据的块列表,如何被重建成一棵可校验的文档树。