文档文本内容
专题13 统计与随机变量及其分布小题综合
解题秘籍
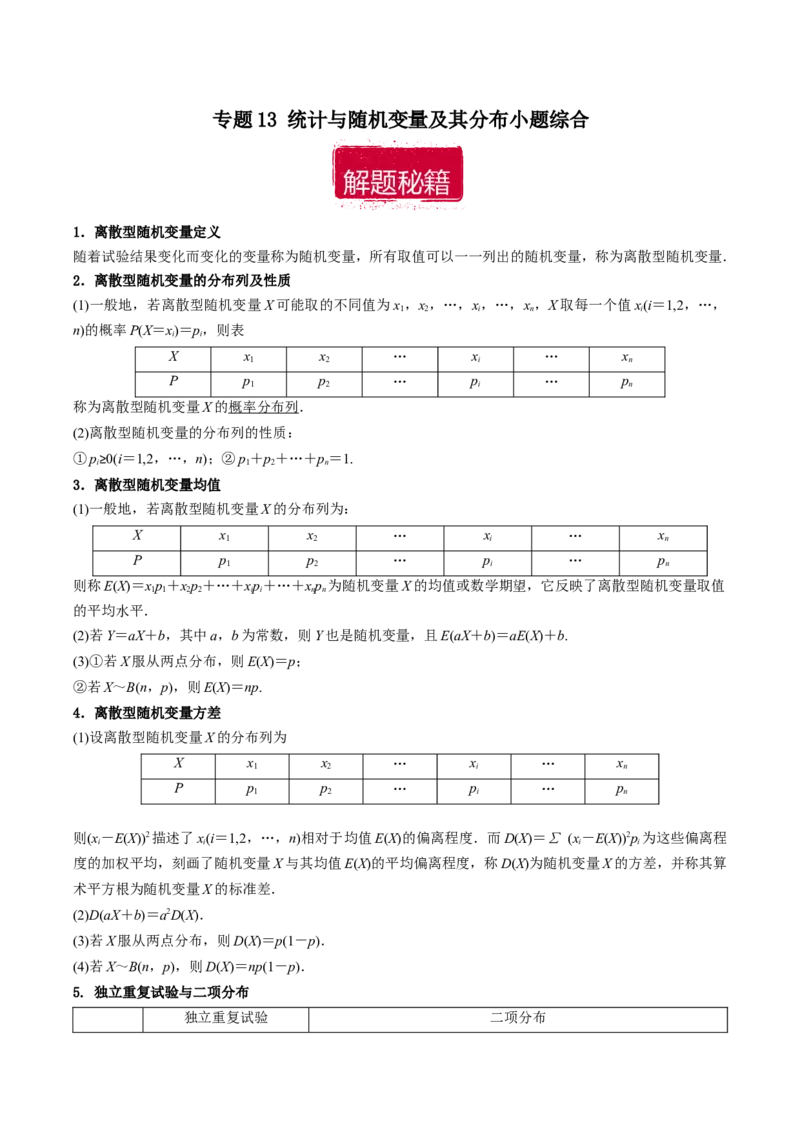
1.离散型随机变量定义
随着试验结果变化而变化的变量称为随机变量,所有取值可以一一列出的随机变量,称为离散型随机变量.
2.离散型随机变量的分布列及性质
(1)一般地,若离散型随机变量X可能取的不同值为x ,x ,…,x,…,x ,X取每一个值x(i=1,2,…,
1 2 i n i
n)的概率P(X=x)=p,则表
i i
X x x … x … x
1 2 i n
P p p … p … p
1 2 i n
称为离散型随机变量X的概率分布列.
(2)离散型随机变量的分布列的性质:
①p≥0(i=1,2,…,n);②p+p+…+p=1.
i 1 2 n
3.离散型随机变量均值
(1)一般地,若离散型随机变量X的分布列为:
X x x … x … x
1 2 i n
P p p … p … p
1 2 i n
则称E(X)=xp +xp +…+xp+…+xp 为随机变量X的均值或数学期望,它反映了离散型随机变量取值
1 1 2 2 i i n n
的平均水平.
(2)若Y=aX+b,其中a,b为常数,则Y也是随机变量,且E(aX+b)=aE(X)+b.
(3)①若X服从两点分布,则E(X)=p;
②若X~B(n,p),则E(X)=np.
4.离散型随机变量方差
(1)设离散型随机变量X的分布列为
X x x … x … x
1 2 i n
P p p … p … p
1 2 i n
则(x-E(X))2描述了x(i=1,2,…,n)相对于均值E(X)的偏离程度.而D(X)=∑ (x-E(X))2p为这些偏离程
i i i i
度的加权平均,刻画了随机变量X与其均值E(X)的平均偏离程度,称D(X)为随机变量X的方差,并称其算
术平方根为随机变量X的标准差.
(2)D(aX+b)=a2D(X).
(3)若X服从两点分布,则D(X)=p(1-p).
(4)若X~B(n,p),则D(X)=np(1-p).
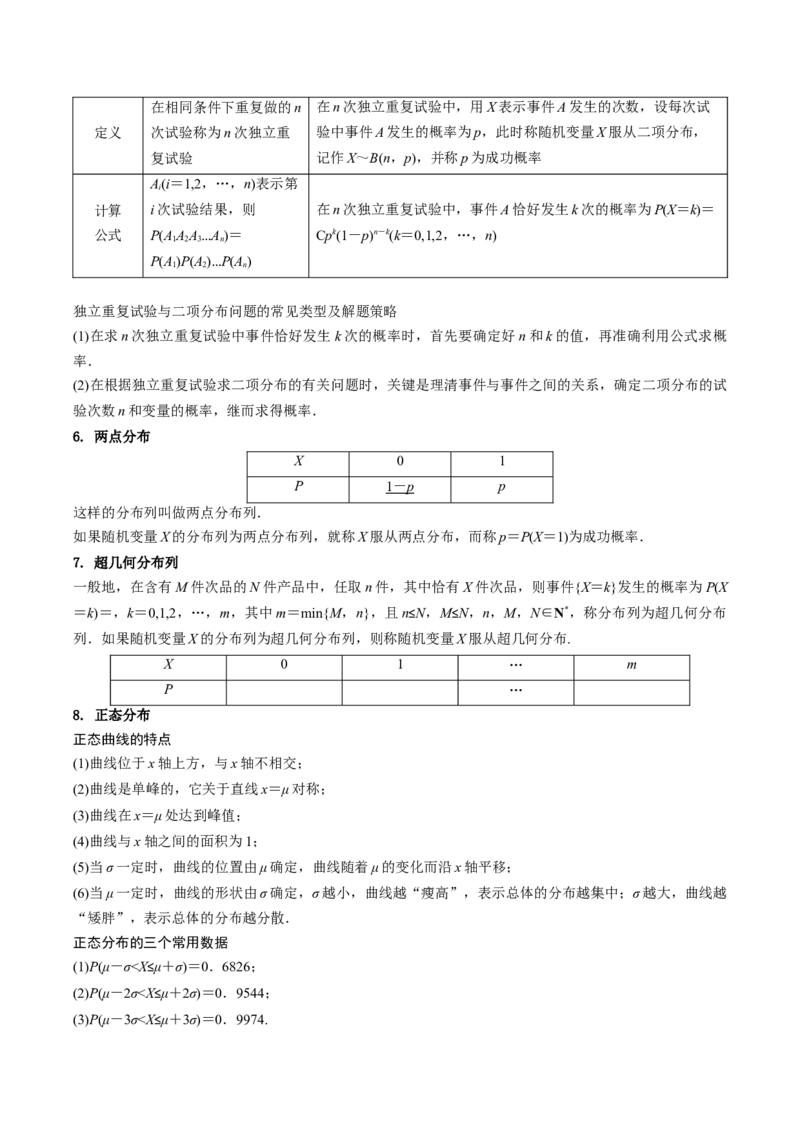
5. 独立重复试验与二项分布
独立重复试验 二项分布在相同条件下重复做的n 在n次独立重复试验中,用X表示事件A发生的次数,设每次试
定义 次试验称为n次独立重 验中事件A发生的概率为p,此时称随机变量X服从二项分布,
复试验 记作X~B(n,p),并称p为成功概率
A(i=1,2,…,n)表示第
i
计算 i次试验结果,则 在n次独立重复试验中,事件A恰好发生k次的概率为P(X=k)=
公式 P(AAA…A)= Cpk(1-p)n-k(k=0,1,2,…,n)
1 2 3 n
P(A)P(A)…P(A)
1 2 n
独立重复试验与二项分布问题的常见类型及解题策略
(1)在求n次独立重复试验中事件恰好发生k次的概率时,首先要确定好n和k的值,再准确利用公式求概
率.
(2)在根据独立重复试验求二项分布的有关问题时,关键是理清事件与事件之间的关系,确定二项分布的试
验次数n和变量的概率,继而求得概率.
6. 两点分布
X 0 1
P 1 - p p
这样的分布列叫做两点分布列.
如果随机变量X的分布列为两点分布列,就称X服从两点分布,而称p=P(X=1)为成功概率.
7. 超几何分布列
一般地,在含有M件次品的N件产品中,任取n件,其中恰有X件次品,则事件{X=k}发生的概率为P(X
=k)=,k=0,1,2,…,m,其中m=min{M,n},且n≤N,M≤N,n,M,N∈N*,称分布列为超几何分布
列.如果随机变量X的分布列为超几何分布列,则称随机变量X服从超几何分布.
X 0 1 … m
P …
8. 正态分布
正态曲线的特点
(1)曲线位于x轴上方,与x轴不相交;
(2)曲线是单峰的,它关于直线x=μ对称;
(3)曲线在x=μ处达到峰值;
(4)曲线与x轴之间的面积为1;
(5)当σ一定时,曲线的位置由μ确定,曲线随着μ的变化而沿x轴平移;
(6)当μ一定时,曲线的形状由σ确定,σ越小,曲线越“瘦高”,表示总体的分布越集中;σ越大,曲线越
“矮胖”,表示总体的分布越分散.
正态分布的三个常用数据
(1)P(μ-σ<X≤μ+σ)=0.6826;
(2)P(μ-2σ<X≤μ+2σ)=0.9544;
(3)P(μ-3σ<X≤μ+3σ)=0.9974.9. 简单随机抽样
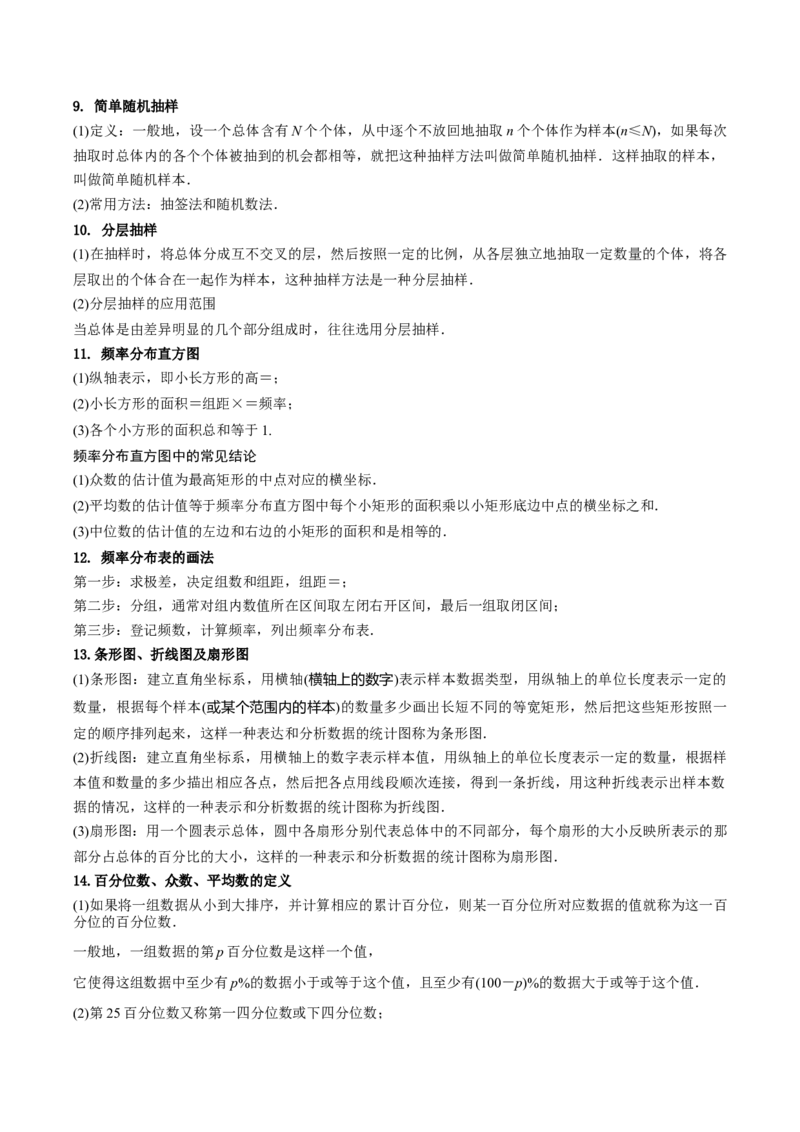
(1)定义:一般地,设一个总体含有N个个体,从中逐个不放回地抽取n个个体作为样本(n≤N),如果每次
抽取时总体内的各个个体被抽到的机会都相等,就把这种抽样方法叫做简单随机抽样.这样抽取的样本,
叫做简单随机样本.
(2)常用方法:抽签法和随机数法.
10. 分层抽样
(1)在抽样时,将总体分成互不交叉的层,然后按照一定的比例,从各层独立地抽取一定数量的个体,将各
层取出的个体合在一起作为样本,这种抽样方法是一种分层抽样.
(2)分层抽样的应用范围
当总体是由差异明显的几个部分组成时,往往选用分层抽样.
11. 频率分布直方图
(1)纵轴表示,即小长方形的高=;
(2)小长方形的面积=组距×=频率;
(3)各个小方形的面积总和等于1.
频率分布直方图中的常见结论
(1)众数的估计值为最高矩形的中点对应的横坐标.
(2)平均数的估计值等于频率分布直方图中每个小矩形的面积乘以小矩形底边中点的横坐标之和.
(3)中位数的估计值的左边和右边的小矩形的面积和是相等的.
12. 频率分布表的画法
第一步:求极差,决定组数和组距,组距=;
第二步:分组,通常对组内数值所在区间取左闭右开区间,最后一组取闭区间;
第三步:登记频数,计算频率,列出频率分布表.
13.条形图、折线图及扇形图
(1)条形图:建立直角坐标系,用横轴(横轴上的数字)表示样本数据类型,用纵轴上的单位长度表示一定的
数量,根据每个样本(或某个范围内的样本)的数量多少画出长短不同的等宽矩形,然后把这些矩形按照一
定的顺序排列起来,这样一种表达和分析数据的统计图称为条形图.
(2)折线图:建立直角坐标系,用横轴上的数字表示样本值,用纵轴上的单位长度表示一定的数量,根据样
本值和数量的多少描出相应各点,然后把各点用线段顺次连接,得到一条折线,用这种折线表示出样本数
据的情况,这样的一种表示和分析数据的统计图称为折线图.
(3)扇形图:用一个圆表示总体,圆中各扇形分别代表总体中的不同部分,每个扇形的大小反映所表示的那
部分占总体的百分比的大小,这样的一种表示和分析数据的统计图称为扇形图.
14.百分位数、众数、平均数的定义
(1)如果将一组数据从小到大排序,并计算相应的累计百分位,则某一百分位所对应数据的值就称为这一百
分位的百分位数.
一般地,一组数据的第p百分位数是这样一个值,
它使得这组数据中至少有p%的数据小于或等于这个值,且至少有(100-p)%的数据大于或等于这个值.
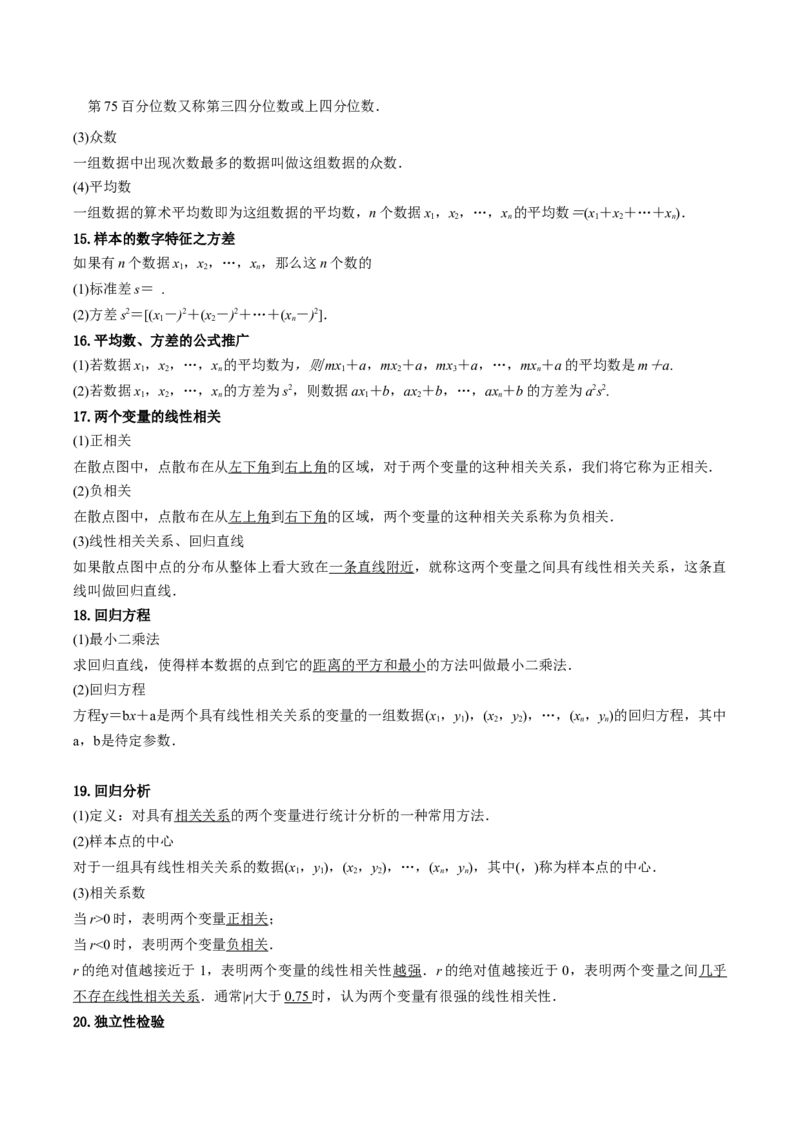
(2)第25百分位数又称第一四分位数或下四分位数;第75百分位数又称第三四分位数或上四分位数.
(3)众数
一组数据中出现次数最多的数据叫做这组数据的众数.
(4)平均数
一组数据的算术平均数即为这组数据的平均数,n个数据x,x,…,x 的平均数=(x+x+…+x).
1 2 n 1 2 n
15.样本的数字特征之方差
如果有n个数据x,x,…,x,那么这n个数的
1 2 n
(1)标准差s= .
(2)方差s2=[(x-)2+(x-)2+…+(x-)2].
1 2 n
16.平均数、方差的公式推广
(1)若数据x,x,…,x 的平均数为,则mx+a,mx+a,mx+a,…,mx+a的平均数是m+a.
1 2 n 1 2 3 n
(2)若数据x,x,…,x 的方差为s2,则数据ax+b,ax+b,…,ax+b的方差为a2s2.
1 2 n 1 2 n
17.两个变量的线性相关
(1)正相关
在散点图中,点散布在从左下角到右上角的区域,对于两个变量的这种相关关系,我们将它称为正相关.
(2)负相关
在散点图中,点散布在从左上角到右下角的区域,两个变量的这种相关关系称为负相关.
(3)线性相关关系、回归直线
如果散点图中点的分布从整体上看大致在一条直线附近,就称这两个变量之间具有线性相关关系,这条直
线叫做回归直线.
18.回归方程
(1)最小二乘法
求回归直线,使得样本数据的点到它的距离的平方和最小的方法叫做最小二乘法.
(2)回归方程
方程y=bx+a是两个具有线性相关关系的变量的一组数据(x,y),(x,y),…,(x,y)的回归方程,其中
1 1 2 2 n n
a,b是待定参数.
19.回归分析
(1)定义:对具有相关关系的两个变量进行统计分析的一种常用方法.
(2)样本点的中心
对于一组具有线性相关关系的数据(x,y),(x,y),…,(x,y),其中(,)称为样本点的中心.
1 1 2 2 n n
(3)相关系数
当r>0时,表明两个变量正相关;
当r<0时,表明两个变量负相关.
r的绝对值越接近于1,表明两个变量的线性相关性越强.r的绝对值越接近于0,表明两个变量之间几乎
不存在线性相关关系.通常|r|大于0.75 时,认为两个变量有很强的线性相关性.
20.独立性检验(1)分类变量:变量的不同“值”表示个体所属的不同类别,像这样的变量称为分类变量.
(2)列联表:列出的两个分类变量的频数表,称为列联表.假设有两个分类变量X和Y,它们的可能取值分
别为{x,x}和{y,y},其样本频数列联表(称为2×2列联表)为
1 2 1 2
2×2列联表
y y 总计
1 2
x a b a+b
1
x c d c+d
2
总计 a+c b+d a+b+c+d
构造一个随机变量K2=,其中n= a + b + c + d 为样本容量.
(3)独立性检验
利用随机变量 K 2 来判断“两个分类变量有关系”的方法称为独立性检验.
当χ2≤2.706时,没有充分的证据判定变量A,B有关联;
当χ2>2.706时,有90%的把握判定变量A,B有关联;
当χ>3.841时,有95%的把握判定变量A,B有关联;
当χ>6.635时,有99%的把握判定变量A,B有关联.
模拟训练
一、单选题
1.(22·23下·自贡·三模)一组数据 、 、 、 、 的方差为 ,则 、 、 、 、
的方差为( )
A.2 B.3 C.4 D.
【答案】A
【分析】根据新旧方差之间的关系 计算即可.
【详解】设原数据随机变量为X,根据题可知原数据方差 ,
则新数据随机变量可表示为 ,根据方差公式可知 .
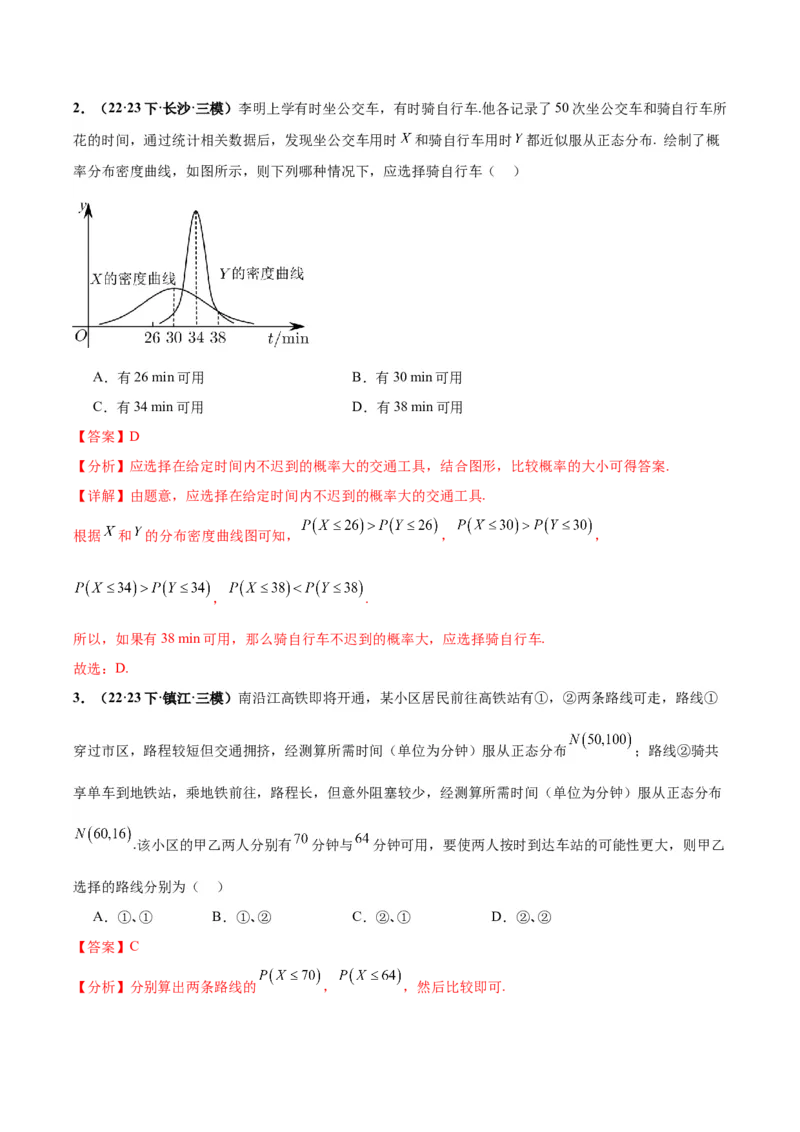
故选:A.2.(22·23下·长沙·三模)李明上学有时坐公交车,有时骑自行车.他各记录了50次坐公交车和骑自行车所
花的时间,通过统计相关数据后,发现坐公交车用时 和骑自行车用时 都近似服从正态分布. 绘制了概
率分布密度曲线,如图所示,则下列哪种情况下,应选择骑自行车( )
A.有26 min可用 B.有30 min可用
C.有34 min可用 D.有38 min可用
【答案】D
【分析】应选择在给定时间内不迟到的概率大的交通工具,结合图形,比较概率的大小可得答案.
【详解】由题意,应选择在给定时间内不迟到的概率大的交通工具.
根据 和 的分布密度曲线图可知, , ,
, .
所以,如果有38 min可用,那么骑自行车不迟到的概率大,应选择骑自行车.
故选:D.
3.(22·23下·镇江·三模)南沿江高铁即将开通,某小区居民前往高铁站有①,②两条路线可走,路线①
穿过市区,路程较短但交通拥挤,经测算所需时间(单位为分钟)服从正态分布 ;路线②骑共
享单车到地铁站,乘地铁前往,路程长,但意外阻塞较少,经测算所需时间(单位为分钟)服从正态分布
.该小区的甲乙两人分别有 分钟与 分钟可用,要使两人按时到达车站的可能性更大,则甲乙
选择的路线分别为( )
A.①、① B.①、② C.②、① D.②、②
【答案】C
【分析】分别算出两条路线的 , ,然后比较即可.【详解】由正态分布的区间概率知 ,
,
令路线①所需时间 ,路线②所需时间
对于甲:有 分钟可走,
走第一条路线:故 ,
走第二条路线:则 ,
所以 ,所以应选择路线②;
对于乙:有 分钟可走,
走第二条路线:
走第一条路线:则 ,
所以 ,所以选择路线①.
故选:C
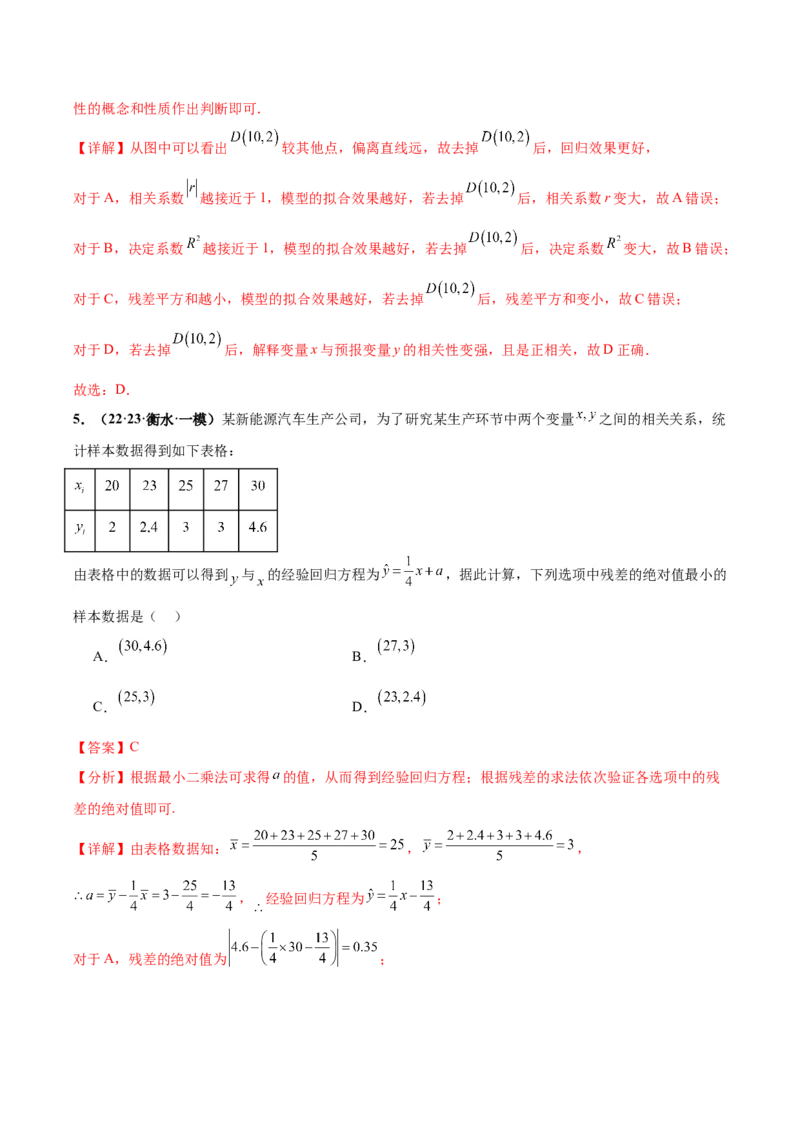
4.(22·23下·杭州·二模)某兴趣小组研究光照时长x(h)和向日葵种子发芽数量y(颗)之间的关系,
采集5组数据,作如图所示的散点图.若去掉 后,下列说法正确的是( )
A.相关系数r变小 B.决定系数 变小
C.残差平方和变大 D.解释变量x与预报变量y的相关性变强
【答案】D
【分析】从图中分析得到去掉 后,回归效果更好,再由相关系数,决定系数,残差平方和和相关性的概念和性质作出判断即可.
【详解】从图中可以看出 较其他点,偏离直线远,故去掉 后,回归效果更好,
对于A,相关系数 越接近于1,模型的拟合效果越好,若去掉 后,相关系数r变大,故A错误;
对于B,决定系数 越接近于1,模型的拟合效果越好,若去掉 后,决定系数 变大,故B错误;
对于C,残差平方和越小,模型的拟合效果越好,若去掉 后,残差平方和变小,故C错误;
对于D,若去掉 后,解释变量x与预报变量y的相关性变强,且是正相关,故D正确.
故选:D.
5.(22·23·衡水·一模)某新能源汽车生产公司,为了研究某生产环节中两个变量 之间的相关关系,统
计样本数据得到如下表格:
由表格中的数据可以得到 与 的经验回归方程为 ,据此计算,下列选项中残差的绝对值最小的
样本数据是( )
A. B.
C. D.
【答案】C
【分析】根据最小二乘法可求得 的值,从而得到经验回归方程;根据残差的求法依次验证各选项中的残
差的绝对值即可.
【详解】由表格数据知: , ,
, 经验回归方程为 ;
对于A,残差的绝对值为 ;对于B,残差的绝对值为 ;
对于C,残差的绝对值为 ;
对于D,残差的绝对值为 ;
残差绝对值最小的样本数据是 .
故选:C.
6.(22·23·重庆·二模)用模型 拟合一组数据组 ,其中 ,设
,得变换后的线性回归方程为 ,则 ( )
A. B. C.70 D.35
【答案】B
【分析】根据回归直线方程必过样本中心点 ,再结合题意以及对数的运算计算即可.
【详解】因为 ,
所以 ,则 ,
即 ,
即 ,所以 .
故选:B.
7.(22·23下·长沙·一模)若 ,则当 ,1,2,…,100时( )
A. B.
C. D.【答案】C
【分析】利用比大小的方法,即可求出k的值.
【详解】解:由题意得:
即 ,
化简得: ,
又k为整数,可得 ,所以 ,
故选:C.
8.(22·23·烟台·二模)口袋中装有编号分别为1,2,3的三个大小和形状完全相同的小球,从中任取2个
球,记取出的球的最大编号为 ,则 ( )
A. B. C. D.
【答案】A
【分析】先求随机变量 的分布列,再运用公式求
【详解】由题意, 可能取值为2,3
包含事件为取出的两个球为1,2
所以
包含事件为取出的两个球为1,3或2,3
所以
,
.
故选:A.9.(22·23下·宁波·二模)设随机变量 服从正态分布, 的分布密度曲线如图所示,若 ,则
与 分别为( )
A. B. C. D.
【答案】C
【分析】根据题意和正态曲线即可求得 ,又根据正态曲线可得 ,进而即可求得
.
【详解】根据题意,且 ,则 ,
由正态曲线得 ,所以 .
故选:C.
10.(22·23下·山东·一模)新能源汽车具有零排放、噪声小、能源利用率高等特点,近年来备受青睐.某
新能源汽车制造企业为调查其旗下A型号新能源汽车的耗电量(单位:kW·h/100km)情况,随机调查得到
了1200个样本,据统计该型号新能源汽车的耗电量 ,若 ,则样本中耗电
量不小于 的汽车大约有( )
A.180辆 B.360辆 C.600辆 D.840辆
【答案】A
【分析】根据正态分布的性质,求得 的值,再由样本容量求得频数,即可得到答案.
【详解】因为 ,且 ,
所以 ,所以样本中耗电量不小于 的汽车大约 (辆).
故选:A.
11.(22·23·梅州·二模)云计算是信息技术发展的集中体现,近年来,我国云计算市场规模持续增长.已知
某科技公司2018年至2022年云计算市场规模数据,且市场规模y与年份代码x的关系可以用模型
(其中e为自然对数的底数)拟合,设 ,得到数据统计表如下:
年份 2018年 2019年 2020年 2021年 2022年
年份代码x 1 2 3 4 5
云计算市场规模y/千万元 7.4 11 20 36.6 66.7
2 2.4 3 3.6 4
由上表可得经验回归方程 ,则2025年该科技公司云计算市场规模y的估计值为( )
A. B. C. D.
【答案】B
【分析】根据 可得线性回归方程,再由回归方程求出2025年 的预测值,代入 即可得解.
【详解】因为 ,
所以 ,
即经验回归方程 ,
当 时, ,
所以 ,
即2025年该科技公司云计算市场规模y的估计值为 ,
故选:B
12.(2023·遂宁·三模)下图是遂宁市2022年4月至2023年3月每月最低气温与最高气温(℃)的折线统
计图:已知每月最低气温与最高气温的线性相关系数 ,则下列结论正确的是( )A.月温差(月最高气温﹣月最低气温)的最大值出现在8月
B.每月最低气温与最高气温有较强的线性相关性,且二者为线性负相关
C.每月最高气温与最低气温的平均值在4-8月逐月增加
D.9﹣12月的月温差相对于5﹣8月,波动性更小
【答案】C
【分析】根据图表,温差最大值出现在10月,A错误,二者为线性正相关,B错误,计算得到C正确D错
误,得到答案.
【详解】对选项A:月温差(月最高气温﹣月最低气温)的最大值出现在10月,错误;
对选项B:每月最低气温与最高气温有较强的线性相关性,且二者为线性正相关,错误;
对选项C:每月最高气温与最低气温的平均值在4-8月分别为 ,逐月增加,正确;
对选项D:9﹣12月的月温差为 ;5﹣8月的月温差为 ,9﹣12月的月温差的波动性
更大,错误;
故选:C.
13.(22·23·九江·一模)为了学习、宣传和践行党的二十大精神,某班组织全班学生开展了以“学党史、
知国情、圆梦想”为主题的党史暨时政知识竞赛活动.已知该班男生 人,女生 人,根据统计分析,
男生组成绩和女生组成绩的方差分别为 .记该班成绩的方差为 ,则下列判断正确的是( )
A. B. C. D.
【答案】D【分析】由方差公式推出 , ,可得 ,
,再用推导公式求班级的方差即可.
【详解】记男生组成绩和女生组成绩的平均分分别为 ,则
,
,
同理 ,
, , ,
,
故选:D.
14.(22·23·沧州·三模)某公司为了调查员工的健康状况,由于女员工所占比重大,按性别分层,用按比
例分配的分层随机抽样的方法抽取样本,已知所抽取的所有员工的体重的方差为120,女员工的平均体重
为 ,标准差为6,男员工的平均体重为 ,标准差为4.若样本中有21名男员工,则女员工的人数
为( )
A.28 B.35 C.39 D.48
【答案】C
【分析】设女、男员工的权重分别为 和 ,根据方差公式可求出结果.【详解】由题意,记样本中女员工的平均体重和标准差分别为 , ,所占权重为 ,
男员工的平均体重和标准差分别为 , ,所占权重为 ,
所以样本中全部员工的平均体重为 ,方差
,
化简得 ,即 ,
解得 或 (舍),
所以女员工的人数为: ,
故选:C.
15.(22·23·宁德·二模)5G技术在我国已经进入高速发展的阶段,5G手机的销量也逐渐上升,某手机商
城统计了最近5个月手机的实际销量,如下表所示:
时间x 1 2 3 4 5
销售量y(千只) 0.5 0.8 1.0 1.2 1.5
若y与x线性相关,且线性回归方程为 ,则下列说法不正确的是( )
A.由题中数据可知,变量y与x正相关
B.线性回归方程 中
C.可以预测 时该商场5G手机销量约为1.72(千只)
D. 时,残差为
【答案】D
【分析】对于 ,利用表中的数据分析即可求解;对于 ,利用平均数的定义及样本中心,结合样本中心
在回归直线上即可求解;对于 ,利用预测值和残差的定义即可求解;对于 ,利用回归方程即可求出预
测值.
【详解】对于 ,从数据看 随 的增加而增加,所以变量y与x正相关,故 正确;对于 ,由表中数据知,
所以样本中心点为 ,将样本中心点 代入 中得 ,故 正确;
对于 ,当 时该商场5G手机销量约为 (千只),故 正确.
对于 ,线性回归方程为 ,所以 , ,故 错误;
故选: .
16.(22·23下·浙江·二模)在某次考试中,多项选择题的给分标准如下:在每题给出的四个选项中,正确
选项为其中的两项或三项,全部选对的得5分,部分选对的得2分,有错选的得0分.甲、乙、丙三人在
完全不会做某个多项选择题的情况下,分别选了 , , ,则三人该题得分的数学期望分别为
( ).
A. B.
C. D.
【答案】D
【分析】先考虑正确答案所有可能的情况,从而再分别考虑甲乙丙三人的可能得分情况,计算出相应得分
的概率,根据期望公式计算出三人得分的期望,即可得答案.
【详解】由题意正确选项若为2项,则有 种可能情况,
正确选项若为3项,则有 种可能情况,共正确选项的可能情况共有10种,
甲选A,则他可能得分的情况即正确答案中含有A,有 种,
故甲得2分的概率为 ,
甲可能的得分分数 为0,2,故他得分的数学期望为 ;
乙选AB,他可能的得分 为 ,
若正确答案为AB,即他可能得5分的情况有1种,此时 ,若正确答案为ABC或ABD,他可能得2分的情况有2种,此时 ,
则 ,故 ;
丙选ABC,他可能的得分 为 ,
若正确答案为ABC,则 ,则 ,
故 ,
即三人该题得分的数学期望分别为 ,
故选;D
17.(22·23上·山西·一模)已知随机变量 的分布列如下:
0 1 2
其中 ,2,若 ,则( )
A. , B. ,
C. , D. ,
【答案】B
【分析】由题知 ,进而根据二项分布的期望与方差公式,方差的性质依次讨论各选项即可得
答案.
【详解】解:由表中数据可知 ,
∴ , ,
又∵ ,
∴ , ,∴ , .
故选:B
18.(22·23·山东·二模)已知随机变量 ,且 ,则 的
最大值为( )
A. B.
C. D.
【答案】D
【分析】根据正态分布的性质求出 的值,则 ,令 ,
,则 ,利用基本不等式求出 的最小值,即可得解.
【详解】因为随机变量 ,且 ,
所以 ,即 ,所以 ,
所以
令 , ,
所以 ,
又 ,当且仅当 ,即 时取等号,
所以 ,
即 的最大值为 .
故选:D.19.(23·24上·浙江·一模)下列命题中错误的是( )
A.已知随机变量 ,则
B.已知随机变量 ,若函数 为偶函数,则
C.数据1,3,4,5,7,8,10的第80百分位数是8
D.样本甲中有 件样品,其方差为 ,样本乙中有 件样品,其方差为 ,则由甲乙组成的总体样
本的方差为
【答案】D
【分析】由二项分布方差计算公式可判断A,由正态分布密度曲线的性质即可判断B,根据第 百分位数
定义可判断C,可按分层抽样样本方差的计算公式判断D.
【详解】对于A, ,A正确;
对于B,由函数 为偶函数,则 ,
所以 ,
所以区间 , 关于 对称,则 ,B正确;
对于C, ,所以数据1,3,4,5,7,8,10的第80百分位数是第六个数据8,C正确;
对于D,由按分层抽样样本方差的计算公式可知选项缺少平均数的相关数据,D错误.
故选:D.
20.(21·22下·武汉·二模)某同学在课外阅读时了解到概率统计中的切比雪夫不等式,该不等式可以使人
们在随机变量 的期望 和方差 存在但其分布末知的情况下,对事件“ ”的概率
作出上限估计,其中 为任意正实数.切比雪夫不等式的形式为: ,其中
是关于 和 的表达式.由于记忆模糊,该同学只能确定 的具体形式是下列四个选项中的某一种.请你根据所学相关知识,确定该形式是( )
A. B. C. D.
【答案】D
【分析】由题知 ,计算可得结果.
【详解】切比雪夫不等式的形式为: ,
由题知 ,
则 的具体形式为 .
故选:D.
二、多选题
21.(22·23·深圳·二模)下列说法正确的是( )
A.一组数据 、 、 、 、 、 、 、 的第 分位数(中位数)为
B.一组数据 、 、 、 、 、 、 、 的第 分位数为
C.若变量 服从 , ,则
D.若变量 服从 , ,则
【答案】ABD
【分析】利用百分位数的定义可判断AB选项;利用正态分布的对称性可判断CD选项.
【详解】对于AB选项,数据 、 、 、 、 、 、 、 共 个数,
因为 , ,
因此,这组数据的 分位数(中位数)为 ,
这组数据的 分位数为 ,AB都对;
对于CD选项,因为变量 服从 , ,
则 ,C错D对.故选:ABD.
22.(23·24上·永州·一模)下列关于概率统计说法中正确的是( )
A.两个变量 的相关系数为 ,则 越小, 与 之间的相关性越弱
B.设随机变量 ,若 ,则
C.在回归分析中, 为0.89的模型比 为0.98的模型拟合得更好
D.某人解答10个问题,答对题数为 ,则
【答案】BD
【分析】A项,通过相关系数的定义即可得出结论;B项,通过求出 即可求出 的
值;C项,通过比较相关指数即可得出哪个模型拟合更好;D项,通过计算即可求出 .
【详解】由题意,
A项,
两个变量 的相关系数为 , 越小, 与 之间的相关性越弱,
故A 错误,
对于 B,
随机变量 服从正态分布 , 由正态分布概念知若 , 则
,
故 B 正确,
对于 ,
在回归分析中, 越接近于 1 , 模型的拟合效果越好,
∴ 为 0.98 的模型比 为 0.89 的模型拟合的更好
故 C 错误,
对于 ,
某人在 10 次答题中, 答对题数为 , 则数学期望 ,故 D 正确.
故选:BD.
23.(22·23·哈尔滨·三模)下列四个命题中正确的是( )
A.已知随机变量X服从正态分布 ,若 ,则
B.对具有线性相关关系的变量x,y,其线性回归方程为 ,若样本点的中心为 ,则
实数m的值是4
C.已知随机变量X服从二项分布 ,若 ,则
D.样本相关系数r,当 越接近1时,成对样本数据的线性相关程度越强
【答案】ACD
【分析】根据正态分布曲线的对称性,可求得 的值,判断A;根据线性回归直线过样本中心可求得m的
值,判断B;根据二项分布的方差的性质可判断C;根据样本相关系数的意义可判断D.
【详解】对于A,随机变量X服从正态分布 ,则由 ,
可得 ,即 ,
故 ,则 ,A正确;
对于B,将样本点的中心 代入 ,可得 ,B错误;
对于C,随机变量X服从二项分布 ,则 ,
若 ,则 ,C正确;
对于D,样本相关系数r,当 越接近1时,成对样本数据的线性相关程度越强,正确,
故选:ACD
24.(22·23下·长沙·二模)下列说法中,正确的命题有( )
A.在做回归分析时,残差图中残差点分布的带状区域的宽度越窄表示回归效果越好B.已知随机变量 服从正态分布N(2, ), ,则
C.以模型 去拟合一组数据时,为了求出回归方程,设 ,求得线性回归方程为
,则c,k的值分别是 和0.3
D.若样本数据 , ,… 的方差为2,则数据 , ,… 的方差为16
【答案】AC
【分析】对于A,利用残差图的意义即可判断;对于B,利用正态分布的对称性计算判断;对于C,对给
定模型取对数比对即得;对于D,利用新数据方差计算公式判断作答.
【详解】对于A,在做回归分析时,由残差图表达的意义知,A正确;
对于B,因 ,且 ,于是得 ,
B不正确;
对于C,由 得 ,依题意得 , ,即 ,C正确;
对于D,依题意, , ,…, 的方差为 ,D不正确.
故选:AC.
25.(22·23·曲靖·三模)下列命题中正确是( )
A.在回归分析中,可用相关系数 的值判断模型拟合效果, 越趋近于0,模型的拟合效果越好
B.已知随机变量 ,若 ,则
C.在经验回归方程 中,当解释变量每增加1个单位时,响应变量将平均减少0.3个单位
D.已知采用分层抽样得到的高三年级100名男生、50名女生的身高情况为:男生样本平均数173,女
生样本平均数164,则总体样本平均数为170
【答案】CD
【分析】根据相关指数的定义判断A,根据二项分布的方差公式及方差的性质判断B,根据回归方程的定
义判断C,根据平均数公式判断D.
【详解】对于A:在回归分析中,可用相关指数 的值判断模型拟合效果, 越趋近于 ,模型的拟合效果越好,故A错误;
对于B:因为 ,所以 ,则 ,解得 ,故B
错误;
对于C:在经验回归方程 中,当解释变量每增加1个单位时,
响应变量将平均减少 个单位,故C正确;
对于D:分层抽样的平均数 ,故D正确;
故选:CD.
26.(22·23·三明·三模)已知某地区中小学生人数如图①所示,为了解该地区中小学生的近视情况,卫生
部门根据当地中小学生人数,用分层抽样的方法抽取了 的学生进行视力调查,调查数据如图②所示,
下列说法正确的有( )
A.该地区的中小学生中,高中生占比为
B.抽取调查的高中生人数为 人
C.该地区近视的中小学生中,高中生占比超过
D.从该地区的中小学生中任取 名学生,记近视人数为 ,则 的数学期望约为
【答案】ABD
【分析】根据扇形统计图计算高中生的占比,可判断A选项;利用分层抽样可判断B选项;计算出近视的
中小学生中,高中生的占比,可判断C选项;分析可知 ,利用二项分布的期望公式可判断D
选项.
【详解】对于A选项,由图①可知,该地区的中小学生中,高中生占比为 ,A对;
对于B选项,用分层抽样抽取了 的学生,则抽取的高中生人数为 人,B对;
对于C选项,该地区近视的中小学生中,小学生近视的人数为 人,
初中生近视的人数为 人,高中生近视的人数为 人,
所以,该地区近视的中小学生中,高中生占比为 ,C错;
对于D选项,从该地区中的中小学生中任意抽取一名,该学生近视的概率为 ,
从该地区的中小学生中任取 名学生,记近视人数为 ,则 ,
所以, ,D对.
故选:ABD.
27.(22·23·张家口·三模)一组互不相等的样本数据 ,其平均数为 ,方差为 ,极差为 ,
中位数为 ,去掉其中的最小值和最大值后,余下数据的平均数为 ,方差为 ,极差为 ,中位数为
,则下列选项一定正确的有( )
A. B.
C. D.
【答案】ACD
【分析】根据中位数、平均数、方差、极差的定义逐项分析判断可得答案.
【详解】对于A,中位数是把数据从小到大依次排列后,排在中间位置的数或中间位置的两个数的平均数,
因为是对称的同时去掉最小值和最大值,故中间位置的数相对位置保持不变,故新数据的中位数保持不变,
故A正确;
对于B,平均数受样本中每个数据的影响,故去掉最小值和最大值后,余下数据的平均数可能会改变,故
B不一定正确;
对于C,方差反映数据的离散程度,当去掉数据中的最小值和最大值后,数据的离散程度减小,故方差减
小,故C正确;
对于D,极差为最大值与最小值之差,是原来数据里面任意两个数据差值的最大值,,故去掉最小值和最大值后,新数据的极差必然小于原数据的极差,故D正确.
故选:ACD
28.(22·23下·嘉兴·二模)已知一组样本数据 ,现有一组新的
,则与原样本数据相比,新的样本数据( )
A.平均数不变 B.中位数不变 C.极差变小 D.方差变小
【答案】ACD
【分析】利用平均数、极差的定义计算判断AC;利用中位数的定义举例判断B;利用方差的意义分析判
断D作答.
【详解】对于A,新数据的总和为: ,
与原数据总和相等,且数据个数都是 ,因此平均数不变,A正确;
对于B,不妨设原数据为: ,中位数为 ,则新数据为: ,中位数为2,B错误;
对于C,原数据极差为: ,新数据极差为: ,
而 ,即极差变小了,C正确;
对于D,由于两组数据的平均数不变,而极差变小,说明新数据相对原数据更集中于平均数,因此方差变
小,D正确.
故选:ACD.
29.(22·23·海口·二模)为了向社会输送优秀毕业生,中等职业学校越来越重视学生的实际操作(简称实
操)能力的培养.中职生小王在对口工厂完成实操产品100件,质检人员测量其质量(单位:克),将所
得数据分成5组: .根据所得数据制成如图所示的频率分布直
方图,其中质量在 内的为优等品.对于这100件产品,下列说法正确的是( )A.质量的平均数为99.7克(同一区间的平均数用区间中点值代替) B.优等品有45件
C.质量的众数在区间 内 D.质量的中位数在区间 内
【答案】ABD
【分析】根据频率分布直方图的性质,以及其数据特征估计值的计算,可得答案.
【详解】对于选项A,质量的平均数为
(克),选项A正确;
对于选项B,优等品有 件,选项B正确;
对于选项C,频率分布直方图上不能判断质量众数所在区间,质量众数不一定落在区间[98,100)内,所
以选项C错误;
对于选项D,质量在 内的有45件,质量在 内的有15件,质量在 内的有5件,
所以质量的中位数一定落在区间 内,所以选项D正确.
故选:ABD.
30.(22·23·梅州·三模)某公司经营五种产业,为应对市场变化,在五年前进行了产业结构调整,优化后
的产业结构使公司总利润不断增长,今年总利润比五年前增加了一倍,调整前后的各产业利润与总利润的
占比如图所示,则下列结论错误的是( )A.调整后传媒的利润增量小于杂志
B.调整后房地产的利润有所下降
C.调整后试卷的利润增加不到一倍
D.调整后图书的利润增长了一倍以上
【答案】ABC
【详解】设调整前的各产业利润的总和为 ,则调整后的各产业利润的总和为 ,对比调整前后各产业利
润的变化,可得出合适的选项.
【分析】设调整前的各产业利润的总和为 ,则调整后的各产业利润的总和为 .
对于选项A,调整前传媒的利润为 ,杂志的利润为 ,
调整后传媒的利润为 ,杂志的利润为 ,
则调整后传媒的利润增量为 ,杂志的利润增量为 ,故选项A不正确;
对于选项B,调整前房地产的利润为 ,调整后房地产的利润为 ,故选项B不正确;
对于选项C,调整前试卷的利润为 ,调整后试卷的利润为 ,且 ,故选项C不正确;
对于选项D,调整前图书的利润为 ,调整后图书的利润为 ,且 ,故选项D正确.
故选:ABC.
31.(22·23·唐山·二模)2022年的夏季,全国多地迎来罕见极端高温天气.某课外小组通过当地气象部门
统计了当地七月份前20天每天的最高气温与最低气温,得到如下图表,则根据图表,下列判断正确的是
( )A.七月份前20天最低气温的中位数低于25℃
B.七月份前20天中最高气温的极差大于最低气温的极差
C.七月份前20天最高气温的平均数高于40℃
D.七月份前10天(1—10日)最高气温的方差大于最低气温的方差
【答案】BD
【分析】根据折线统计图一一分析即可.
【详解】七月份前20天中,最低气温低于 ℃的天数不超过9天,故中位数不可能低于 ℃,故 A错
误;
最高气温的最大值大于 ℃,最小值低于 ℃,而最低气温的最大值小于 ℃,最小值接近 ℃,
故最高气温的极差大于最低气温的极差,故B正确;
最高气温超过 ℃的天数不超过5天,且最大值不超过 ℃,故平均数不可能高于 ℃,故C错误;
前10天中,最低气温的分布更集中,故最高气温的方差大于最低气温的方差,故D正确.
故选:BD
32.(22·23·广州·三模)下列说法正确的是( )
A.若 ,则随机变量 的方差
B.若 , ,则
C.若随机事件 满足 , , ,则
D.数据5,7,8,11,13,15,17的第80百分位数为15
【答案】BCD
【分析】由二项分布的方差公式,正态分布的对称性,全概率公式及百分位数,逐项判断即可.
【详解】对于A:若 ,则随机变量 的方差 ,故A错误;对于B:若 ,则 ,故B正确;
对于C:由全概率公式,得 ,故C正确;
对于C:由于 ,所以数据5,7,8,11,13,15,17的第80百分位数为15,故D正确;
故选:BCD.
33.(22·23·白山·二模)装疫苗的玻璃瓶用的不是普通玻璃,而是中性硼硅玻璃,这种玻璃有较好的平均
线膨胀系数(简称:膨胀系数).某玻璃厂有两条硼硅玻璃的生产线,其中甲生产线所产硼硅玻璃的膨胀
系数 ,乙生产线所产硼硅玻璃的膨胀系数 ,则下列选项正确的是( ).
(附:若 ,则 , ,
)
A.甲生产线所产硼硅玻璃的膨胀系数范围在 的概率约为0.7685
B.甲生产线所产硼硅玻璃的膨胀系数比乙生产线所产硼硅玻璃的膨胀系数数值更集中
C.若用于疫苗药瓶的硼硅玻璃的膨胀系数不能超过5,则乙生产线所产硼硅玻璃符合标准的概率更大
D.若用于疫苗药瓶的硼硅玻璃的膨胀系数为 ,则甲生产线所产硼硅玻璃符合标准的概率约为
乙生产线的2倍
【答案】BD
【分析】根据正态分布性质及对应特殊区间上的概率计算分别判断各个选项即可.
【详解】因为 ,所以 , .
因为 ,所以 , .
因为 ,故A错误.
因为 ,所以甲生产线所产硼硅玻璃的膨胀系数数值更集中,故B正确.
因为 , ,所以 ,所以甲生产线所产硼硅玻璃符合标准的概率更大,故C错误.
因为 ,
,所以D正确.
故选:BD.
34.(22·23·山东·二模)在平面直角坐标系 的第一象限内随机取一个整数点
,若用随机变量 表示从这 个点中随机取出的一个点的横、纵坐标之和,
表示 , 同时发生的概率,则( )
A.当 时,
B.当 时,
C.当 时, 的均值为
D.当 ( 且 )时,
【答案】ACD
【分析】利用条件概率公式可判断A选项;列举出满足 的点的坐标,利用古典概率公式可判断B
选项;利用离散型随机变量的期望公式可判断C选项;列举出满足 , 的点的坐标,利用古典
概型的概率公式可判断D选项.
【详解】对于A选项,当 时,整数点共 个,则 ,
由 得 ,即满足 , 的点的坐标为 ,
所以, ,A对;对于B选项,当 时,整数点共 个,
满足 的整数点为 , ,则 ,B错;
对于C选项,当 时,
的可能取值有 、 、 、 、 、 、 、 、 ,此时,样本点共 个,
满足 的点为 ,则 ,
满足 的点为 、 ,则 ,
满足 的点为 、 、 ,则 ,
满足 的点为 、 、 、 ,则 ,
满足 的点为 、 、 、 、 ,则 ,
满足 的点为 、 、 、 ,则 ,
满足 的点为 、 、 ,则 ,
满足 的点为 、 ,则 ,
满足 的点为 ,则 ,
故当 时, ,C对;
对于D选项,满足 的解为 ,则 ,D对.
故选:ACD.
35.(23·24上·郴州·一模)下列说法正确的是( )
A.若随机变量 服从正态分布 ,且 ,则
B.一组数据 的第60百分位数为14
C.若线性相关系数 越接近1,则两个变量的线性相关性越强D.对具有线性相关关系的变量 ,其线性回归方程为 ,若样本点的中心为 ,则
实数 的值是-4
【答案】ACD
【分析】根据正态分布概率性质计算判断A,由百分位数定义计算判断B,根据相关系数的概念判断C,
把中心点代入回归方程求解后判断D.
【详解】选项A,由已知 ,因此 ,A正确;
选项B,总共有10个数,由于 ,因此第60百分位数为 ,B错;
选项C,线性相关系数 越接近1,两个变量的线性相关性越强,越接近0,两个变量的线性相关性越弱,
C正确;
选项D,由已知 ,解得 ,D正确.
故选:ACD.
三、填空题
36.(22·23·宝山·三模)随机变量 , ,若 ,那么实数
的值为 .
【答案】
【分析】由正态分布性质可得 , ,由此可利用对称性构造方程求得结果.
【详解】 , , , ,
, ,解得: .
故答案为: .
37.(22·23·宁德·二模)若随机变量 ,且 ,则
.
【答案】 /
【分析】利用正态曲线的对称性求出 的值,然后根据正态密度曲线的对称性可得出,代值计算即可得解.
【详解】因为 ,且 ,则 ,
所以, .
故答案为: .
38.(22·23·吕梁·二模)某种红糖的袋装质量 服从正态分布 ,随机抽取5000袋,则袋装质
量在区间 的约有 袋.(质量单位: )
附:若随机变量 服从正态分布 ,则 ,
, .
【答案】4093
【分析】根据正态分布的对称性,结合 求解即可.
【详解】由题意知, ,
所以 , ,得
,
所以袋装质量在区间 的约有 袋.
故答案为:4093
39.(22·23·宁德·一模)某学习小组共有20人,在一次数学测试中,得100分的有2人,得95分的有4
人,得90分的有5人,得85分的有3人,得80分的有5人,得75分的有1人,则这个学习小组成员该次
数学测试成绩的第70百分位数是 .【答案】 /
【分析】将数据从小到大排列,结合百分位数的计算方法,即可求解.
【详解】根据题意,将20个数据从小到大排列:其中75分1个,80分5个,85分3个,90分5个,95分
4个,100分2个,
由 ,所以 百分位数是第14和15个数据的平均数,
所以 百分位数为 .
故答案为: .
40.(22·23·保定·二模)由正整数组成的一组数据共有4个,其中位数,平均数,方差均等于4,则这组
数据的极差为 .
【答案】
【分析】设出这四个数据,根据题意列出方程组,结合这四个数是正整数进行求解.
【详解】不妨设四个数为 ,则 , ,即 ,
又 ,
∴ ,因为 是正整数,且 ,
不符合题意,否则 ,
若 ,可得 ,结合 ,可以解得 ,
若 ,故 可化简成:
但 ,这是不可能的,
若 ,结合 ,得到 ,这与 矛盾.
所以 , ,极差为 .
故答案为: