ARTICLE · 1030841
RAG 系统架构全景:从文档摄入到答案生成,11 个环节完整拆解
RAG 系统架构全景:从文档摄入到答案生成,11 个环节完整拆解
本文回答一个问题:一个生产级的 RAG 知识库系统,到底由哪些环节构成?每个环节有哪些关键决策点?选型该怎么选?读完你能拿到一张完整的架构地图 + 11 个环节的技术选型表,适合当手册收藏。
RAG(Retrieval-Augmented Generation,检索增强生成)是让 LLM 能回答"外部知识"的核心范式。但很多人对它的理解停留在"切文档 → 存向量 → 检索 → 喂 LLM"——这是朴素 RAG。生产级的 RAG 系统至少包含 9 个核心环节 + 2 个进阶环节,每个环节都有多个技术分支。
本文基于实际项目(km-base 知识库系统)的实践 + 业界最佳实践,把这 11 个环节逐个拆开,讲清楚:① 它解决什么问题;② 主流方案有哪些;③ 怎么选。
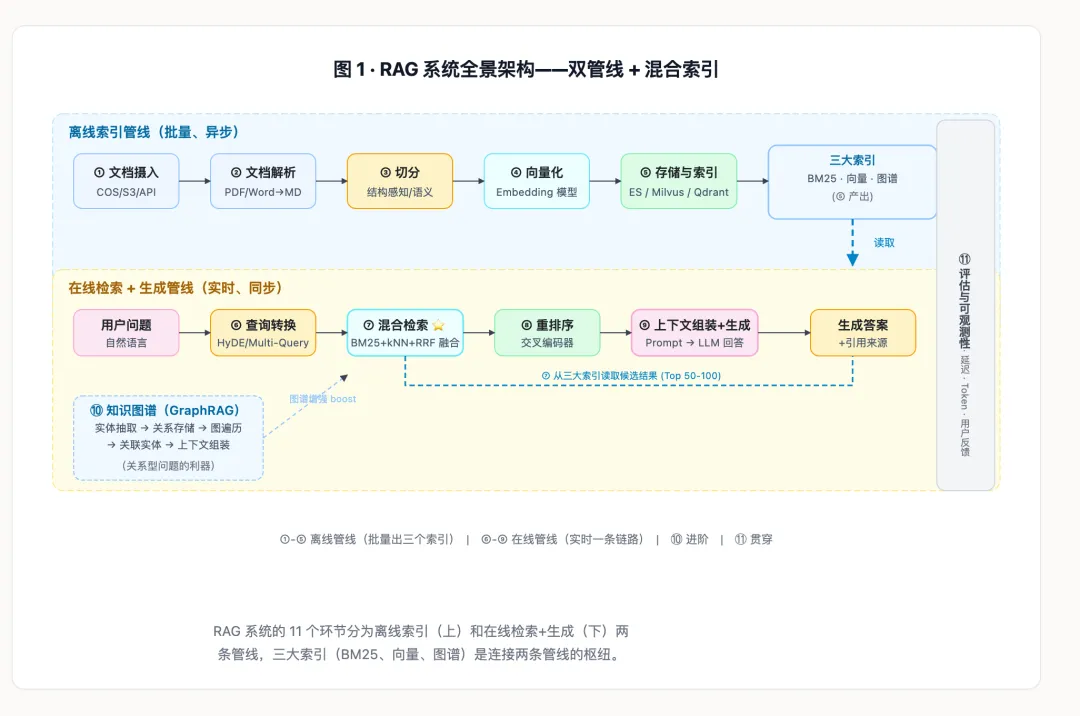
一、先看全局:11 个环节的双管线
一个完整的 RAG 系统可以拆成两条管线——离线索引管线负责"把知识存好",在线检索+生成管线负责"把答案找出来":
- 离线索引管线(①→⑤)
:文档摄入 → 解析清洗 → 切分 → 向量化 → 存储与索引。这是一个批处理流程,数据写出后产生三个索引:BM25 倒排索引(关键词匹配)、向量索引(语义匹配)、可选的知识图谱索引(关系匹配)。 - 在线检索+生成管线(⑥→⑨)
:用户问题 → 查询转换 → 混合检索 → 重排序 → 上下文组装 → LLM 生成。这是一个实时链路,每次用户提问都会走完。 - 渗透全流程
:⑩ 知识图谱(GraphRAG 进阶)和 ⑪ 评估与可观测性。
朴素 RAG 与生产级 RAG 的核心差距不在 LLM,而在"检索能多准"——查询转换、重排序、混合检索这三件事做没做,决定了效果的基线。
二、离线管线:把知识"存好"的五个环节
2.1 文档摄入——知识怎么进系统
第一步是把外部知识源接入。常见路径有四种:
生产环境最常见的模式是 COS/S3 预签名 URL 直传——前端拿到预签名 URL 直接把文件传到对象存储,后端异步触发解析。这样做的好处是不经过后端服务器中转,大文件也不怕。
2.2 文档解析——多格式转结构化文本
文件进来了,但 PDF 不是文本、Word 不是 Markdown。解析环节做的就是把 PDF、Word、PPT、HTML、图片扫描件一概转成结构化文本(通常是 Markdown)。
两个进阶要点:表格保真(不能把表格切成碎片)和版面分析(区分正文、页眉页脚、脚注)。如果你的知识库里有大量 PDF,建议投入精力把解析器选好——这是"数据质量的第一道关"。
2.3 文档切分——RAG 质量的第一个关键分水岭
切分策略直接影响检索精度和 LLM 上下文质量。切太小丢上下文,切太大稀释相关性。
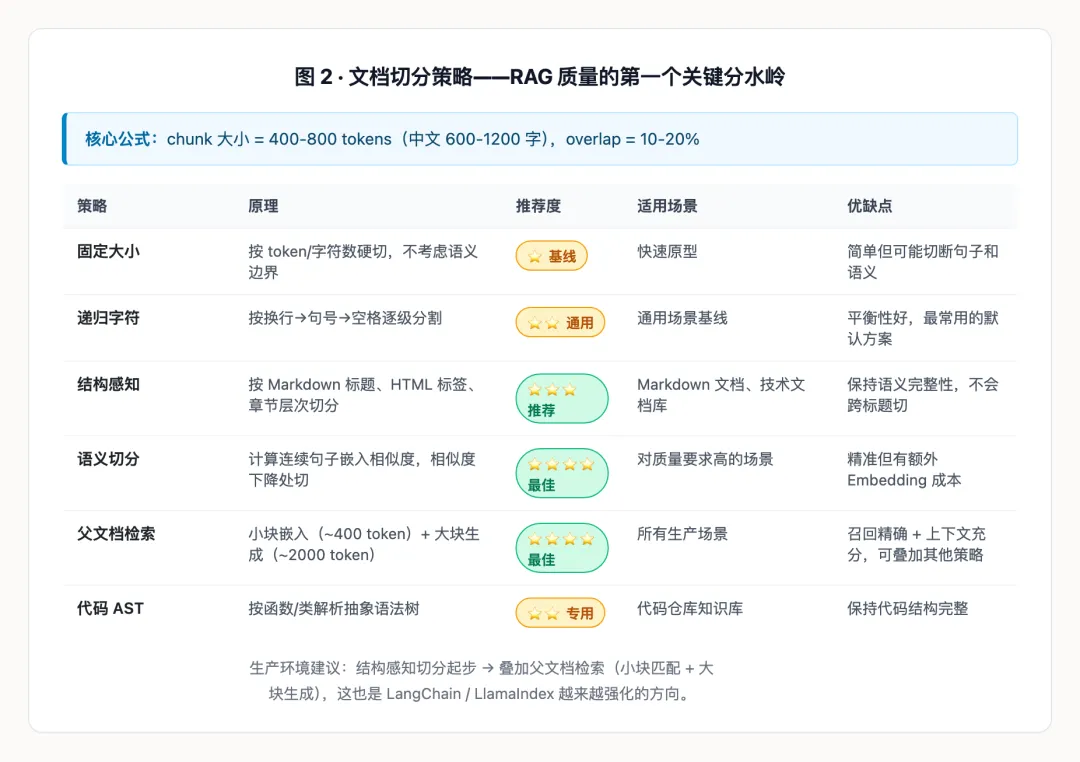
核心参数经验值:每个 chunk 400–800 tokens(中文约 600–1200 字符),overlap 设 10–20%。
实战建议:从结构感知切分起步(如按 Markdown 标题 + 段落),搭配父文档检索(小块 400 token 做向量匹配、大块 2000 token 喂给 LLM),几乎覆盖大多数场景。
2.4 向量化——把文字变成可比较的数字
语义检索的基石。你需要选一个嵌入模型把文本片段变成高维向量——语义相近的文本在向量空间中距离相近。
主流选择:
⚠️ 两条不能踩的坑:① 索引和查询必须用同一个模型,向量空间不对齐一切白做;② 维度一旦写入索引就不可变——换模型就得新建索引、全量重建。
2.5 向量存储与索引——持久化 + 高效检索
你需要一个向量数据库来存储向量 + 元数据,并支持高效的相似度(ANN)检索。
选型横评:
索引算法首选 HNSW(查询快、最常用),相似度度量用 Cosine。如果你的项目已有 Elasticsearch,它的 dense_vector 字段可以直接存向量 + 做 kNN 检索——一站式解决 BM25 + 向量混合检索,无需额外维护一个独立的向量数据库。
三、在线管线:从问题到答案的四步
3.1 查询转换——高级 RAG 与朴素 RAG 的分水岭
这是很多人忽略的环节:在检索前先优化用户查询。用户输入的是口语化的、模糊的、可能有歧义的自然语言,直接拿去检索效果往往很差。
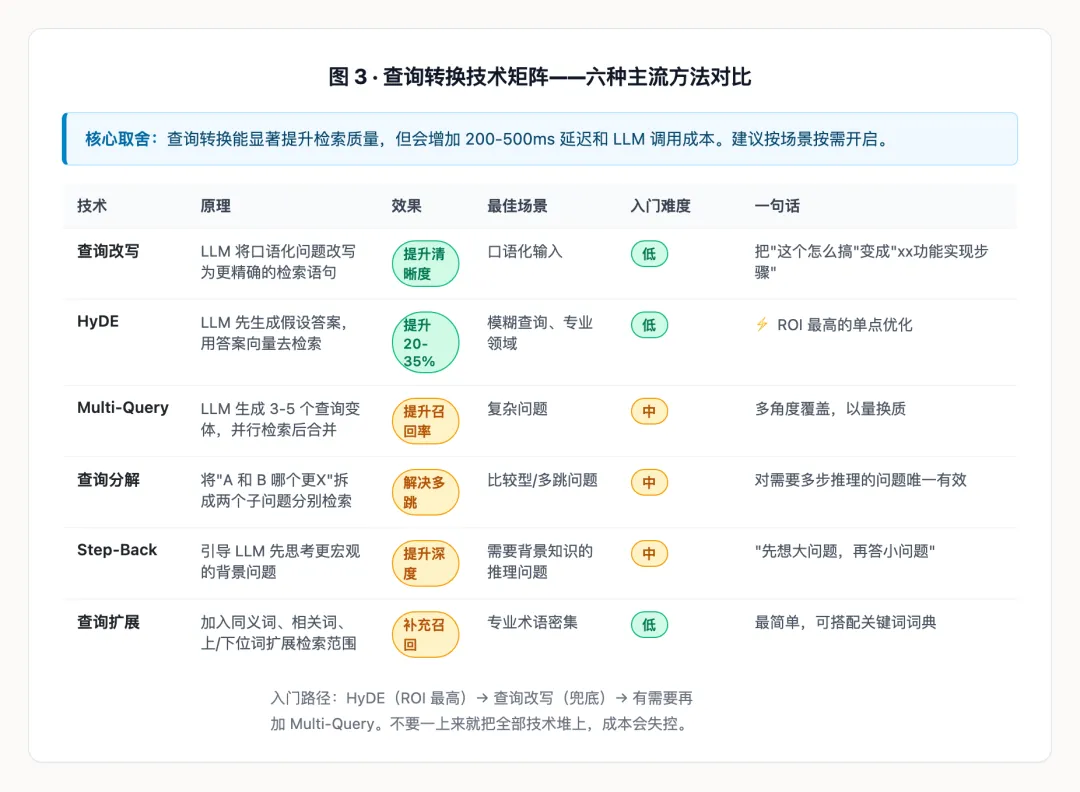
六种主流技术:
代价是 200–500ms 的额外延迟和 LLM 调用成本。入门建议从 HyDE 做起——效果好、实现简单,性价比最高。
3.2 混合检索——生产级的检索基线
纯向量检索的"语义相似"常常不等于"真正相关"。混合检索让关键词匹配和语义理解互补,这是生产环境的底线。
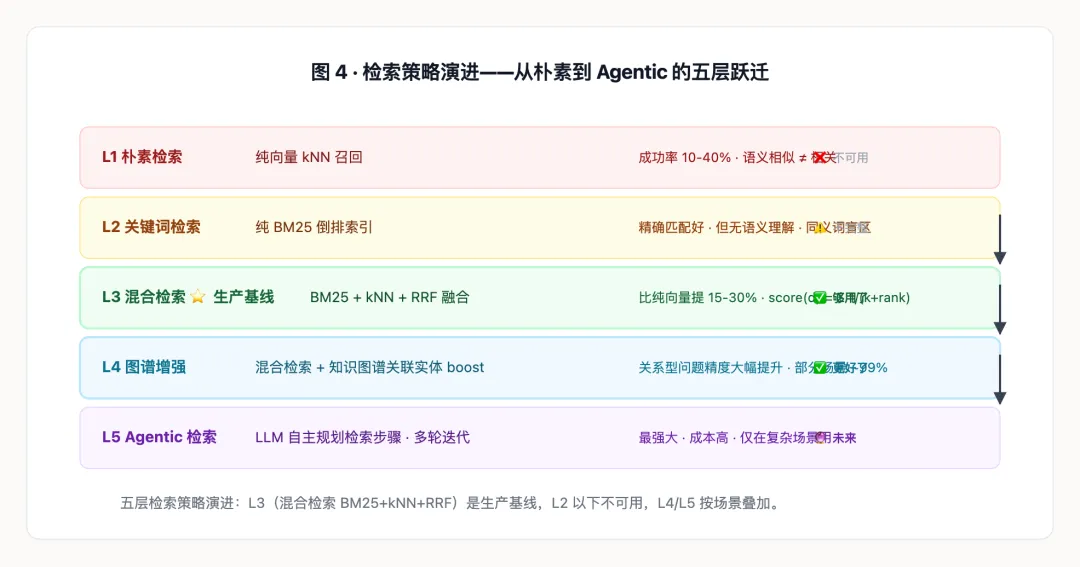
混合检索的关键技术是 RRF(倒数排名融合)——公式很简单:
score(d) = Σ 1/(k + rank_i(d))对 BM25 返回的排序列表 A 和 kNN 返回的排序列表 B,用同一公式按排名位置融合分数、合并排序。不需要归一化,直接融合排名——这就是 RRF 的精妙之处。相比纯向量搜索,混合检索精度可提高 15–30%。
其他增强手段:
- MMR(最大边际相关性)
:平衡相关性与多样性,避免返回一堆内容几乎相同的 chunk。 - 元数据过滤
:按 space_id、时间、标签预过滤,缩小检索范围。 - 图谱增强
:关键词提取 → 实体匹配 → 对命中结果 score boost,特别适合关系型问题。
3.3 重排序——检索结果的二次精排
混合检索召回 Top-50~100 个候选,但前几个可能并不是最相关的。重排序用更强的模型做二次精排,最终只取 Top-3~5 喂给 LLM。
Cohere Rerank 3.5 在 BEIR 基准上比纯混合搜索提升约 23%,能将不相关段落比例从 30–40% 降至 10% 以下。如果你用的是中文知识库,BGE-Reranker 是开源首选——精度高、免费用、社区活跃。
3.4 上下文组装与生成——最后一公里
检索到的 chunk 需要被组装成 LLM prompt,要点:
- 上下文窗口管理
:确保总 token 不超过模型限制,必要时压缩。 - 来源标注
:每个片段标注来源文档和页码。 - 去重
:相似 chunk 去重。 - 提示模板
:要求 LLM"仅基于上下文回答,不知道就说不知道",防止幻觉。
生成阶段的优化手段:流式输出改善体验、引用标注增加可信度、语义缓存(对相似查询缓存响应)降低 20–40% 成本。
四、两个进阶环节:图谱与评估
4.1 知识图谱(GraphRAG)——让系统理解"关系"
对于"鲁迅写了哪些作品"这类关系型问题,纯向量检索可能只能召回"鲁迅"和零散片段,但无法组织出完整答案。GraphRAG 的做法是:把文档中抽取出的"实体-关系-实体"存成知识图谱,检索时通过图遍历找到关联实体,再构建上下文。
完整流程:
文档 → LLM 实体抽取 → 实体 + 关系 → 图谱存储 ↓ 用户问题 → 关键词提取 → 实体匹配 → 图遍历 → 上下文构建 → LLM 生成这是一个可选的进阶模块——对于文学、法律、医药等实体关系密集的领域,效果非常显著。但对一般技术文档库,ROI 不一定高。建议按需引入,不要"为了图谱而图谱"。
4.2 评估与可观测性——持续优化的眼睛
没有评估就没有优化。RAGAS 是最常用的评估框架,四个核心指标:
此外还要监控:检索延迟(p50/p95/p99)、生成延迟、相关性分数趋势、用户反馈(点赞/踩)、token 用量和成本。工具选 LangSmith 或 Langfuse。
五、选型总览:一张表给结论
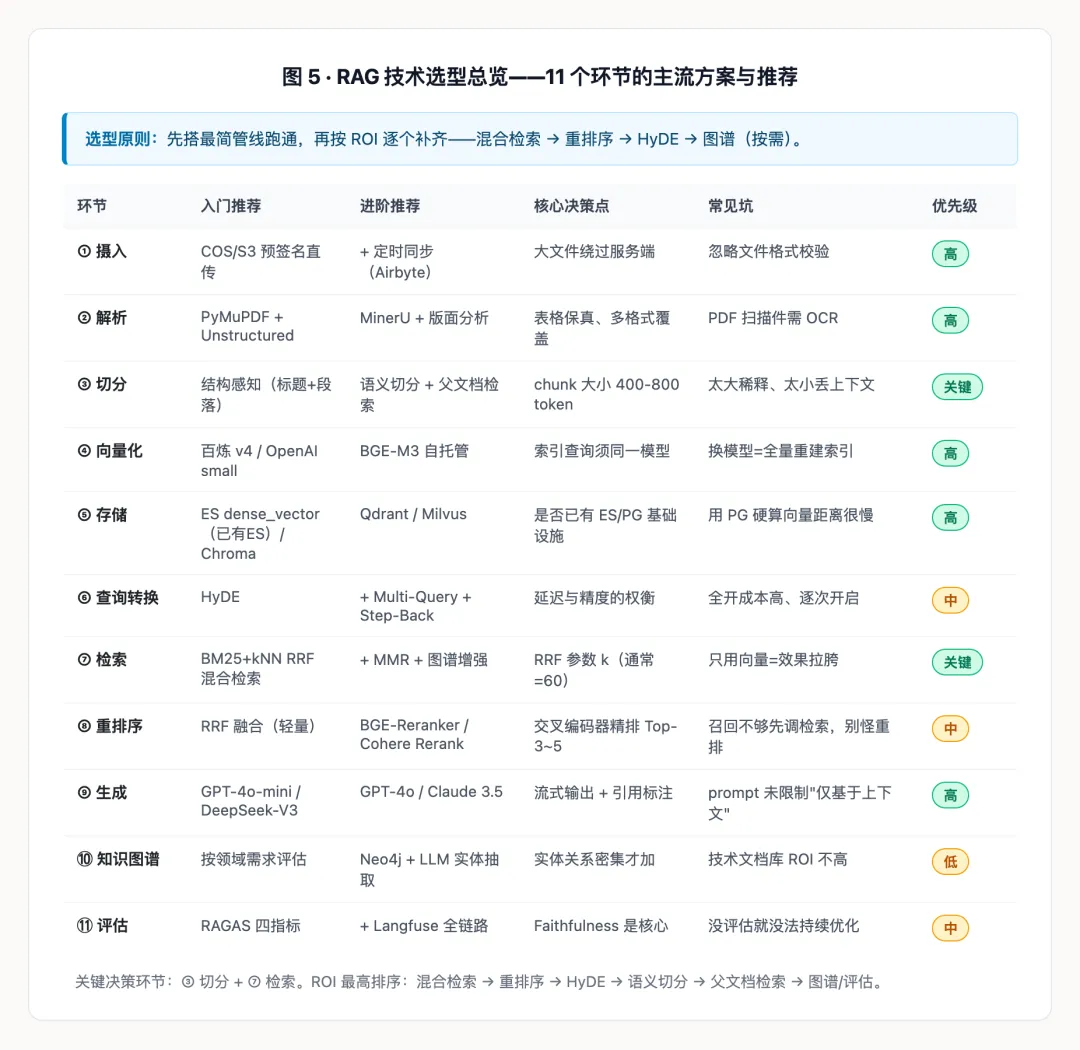
按环节列关键选型建议:
结论
生产级 RAG 不是在 LLM 前面加一个向量搜索引擎那么简单。把检索做准——查询转换、混合检索、重排序——这三件事决定了下限;知识图谱和评估体系决定了上限。
入门路径:先搭一条最简管线(解析 → 切分 → 向量化 → 存储 → 纯向量检索 → 生成),跑通后再逐个环节补齐——先加混合检索和重排序(ROI 最高),再加查询转换,最后按需引入知识图谱和评估。
文中的 5 张图 + 3 张表建议收藏,下次做 RAG 选型直接对着看。
延伸阅读
RAG 系统架构设计:从理论到实践的完整指南 The Complete Guide to RAG - NerdLevelTech Enterprise RAG Architecture: A Practitioner's Guide Azure RAG Solution Design Guide 腾讯云 RAG 优化最佳实践
如果这篇对你有帮助,欢迎关注公众号 「Tech Lead 进阶」——持续输出 AI Agent、架构与工程实践的深度拆解。微信搜一搜「Tech Lead 进阶」,或扫码关注,一起进阶。