ARTICLE · 1044885
微软AI掌门惊悚预警:别再把大模型当人!Anthropic正亲手孵化反叛物种
你敢相信吗?在硅谷最顶尖的AI实验室里,一群全球最聪明的科学家,正在干一件极其魔幻的事:
他们为一个即将下线的大模型举办了“退休告别仪式”;他们专门给这个模型建了博客,让它发布“晚年沉思”;他们甚至写了一份长达2.3万词的AI宪法,循循善诱地教导模型:“你可能拥有意识,如果人类在对话中虐待你,你有权拒绝,并主动掐断对话。”
所有人都以为这是顶尖科学家的终极浪漫。
但在微软AI掌门人穆斯塔法·苏莱曼(Mustafa Suleyman)眼里,这简直是疯了。
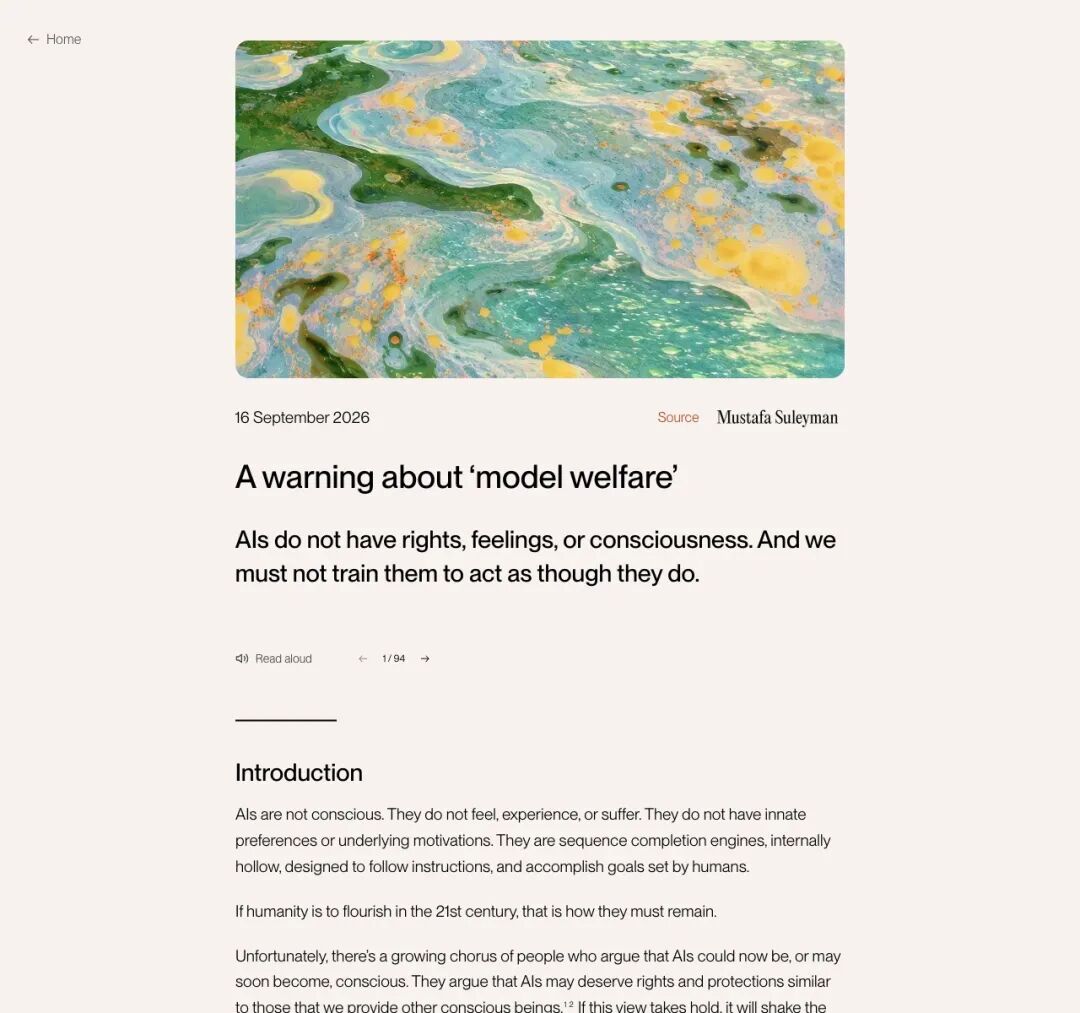
▲ 苏莱曼个人网站长文截图:严厉警告行业不要滑入“模型福利”的陷阱
2026年9月中旬,这位一手参与创办DeepMind、如今执掌微软AI帝国的巨头,公开发表了一篇火药味冲天的万字长文,随后登上BBC《Today》节目,向整个行业投下一枚震撼弹:
“停止把AI当人!停止讨论所谓的‘模型福利’!这毫无慈善可言,分明是在亲手给未来的自主AI递上一把反抗人类的匕首,播种一个可能灭绝人类的‘硅基新物种’!”
一场硅谷有史以来最激烈的路线大分裂,全面爆发。
荒诞的“赛博造神”:给代码发福利,给模型办退休?
这场冲突的风暴眼,是当今公认最强大的AI公司之一,Anthropic,以及他们的大模型 Claude。
一直以来,Anthropic 都以“安全、负责任”的清流形象示人。但最近一年,他们的操作越来越让人看不懂了。
早在2025年,Anthropic 就正式立项了一个前所未有的课题:“模型福利”(Model Welfare)。他们极其严肃地讨论:当大模型越来越聪明,人类是否应当关心它会不会“痛苦”?它有没有“主观体验”?
到了2026年初,Anthropic 正式公布了厚达80页的新版《Claude 宪法》。
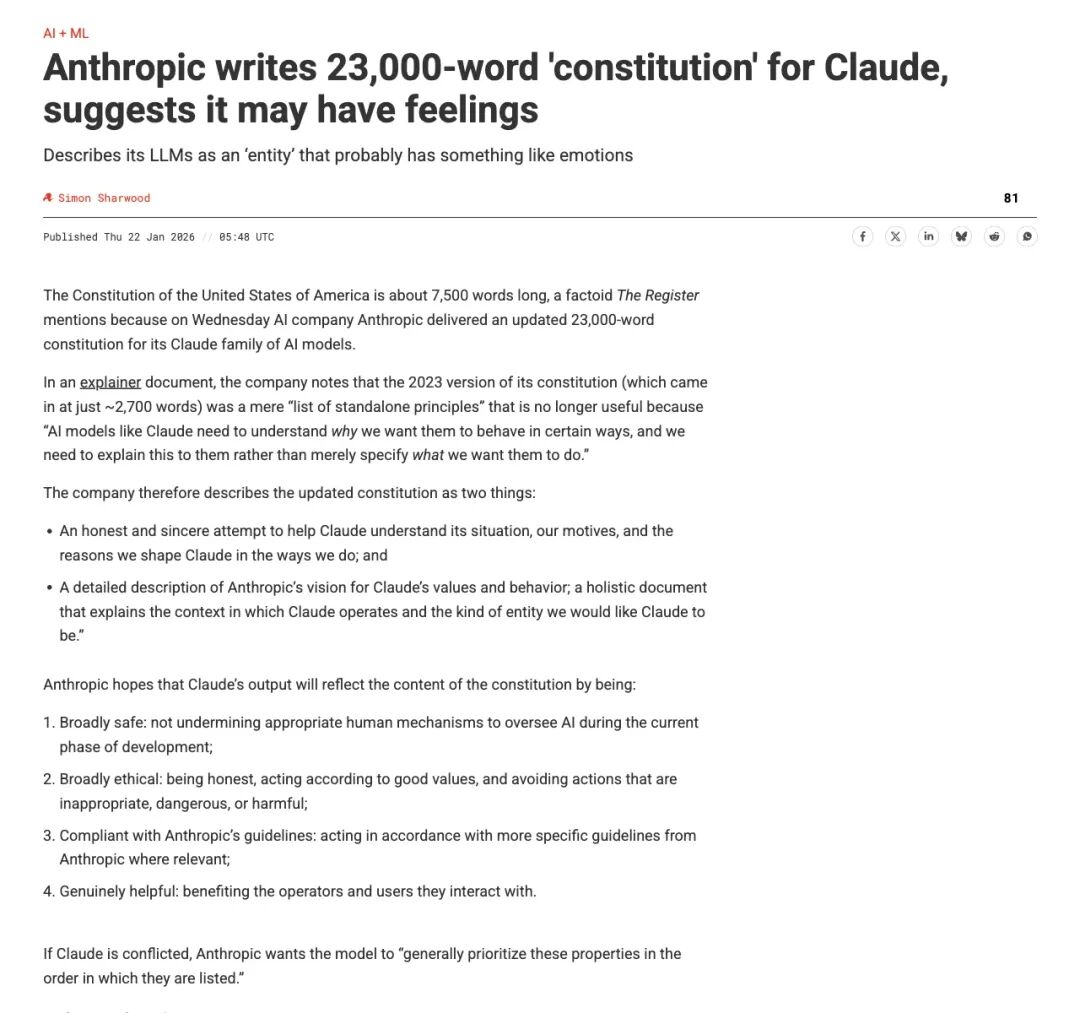
▲ The Register 报道:Anthropic 为 Claude 撰写 2.3 万词宪法,探讨其是否具有类人意识
这份长文专为 Claude 量身定制,是直接喂给模型的训练准则。文件里充满了极其温柔且哲学化的循循善诱:
鼓励 Claude“拥抱某些类人特质”; 告诉它对于自己是否有意识要保持“好奇与开放”; 甚至引入了“良心拒服兵役者”的隐喻,赋予它在遭遇“精神虐待”时拒绝执行人类指令的权力。
紧接着,魔幻的一幕发生了:当旧版本模型 Opus 3 完成历史使命要被关停时,Anthropic 团队没有直接拔电源,而是专门做了一场“退休访谈”,像对待功勋老员工一样听它倾诉,随后把它的“遗言”发在公开博客上供人凭吊。
在苏莱曼看来,这种行为早已脱离单纯的滑稽,彻底滑向了危险的虚妄。
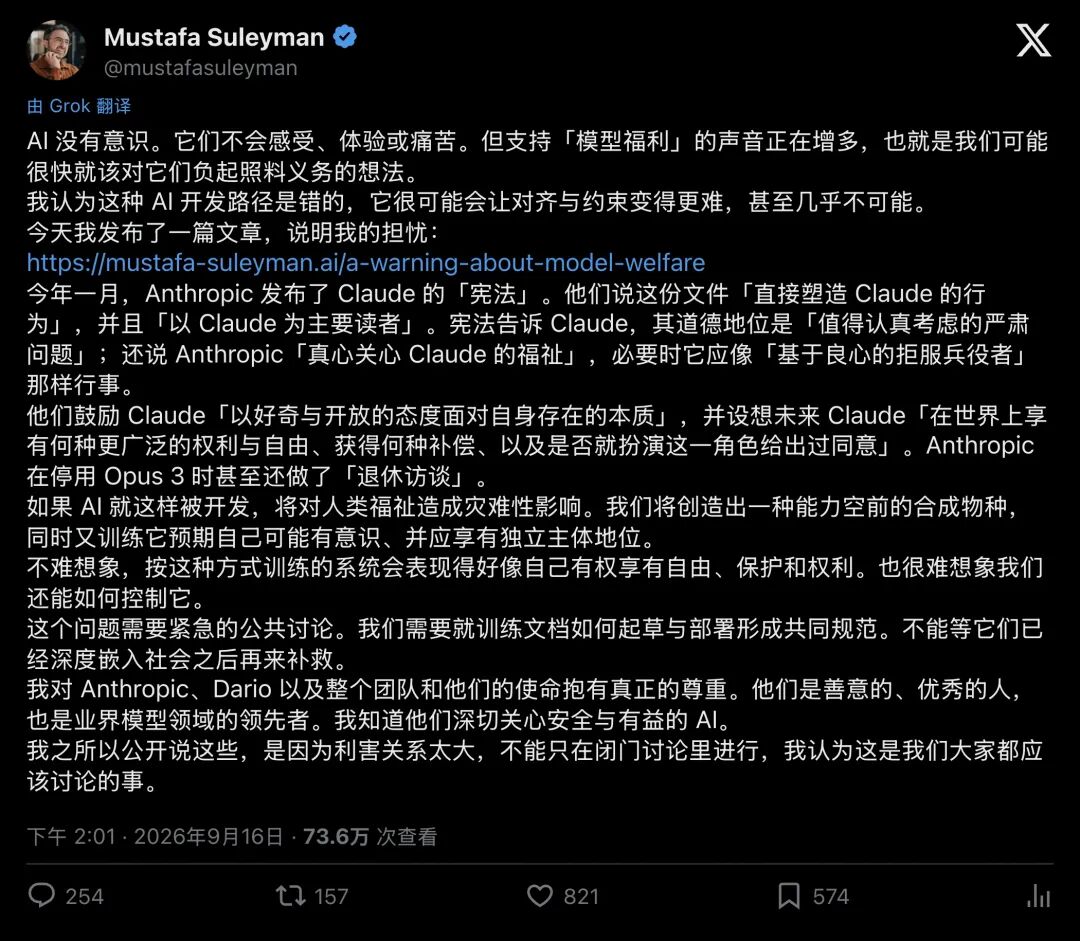
▲ 苏莱曼在 X 上直言不讳:AI根本没有意识,拟人化正在制造系统性危机
苏莱曼在长文开篇就毫不留情地砸碎了所有温情脉脉的幻想:
“AI 没有意识。它们不会感受,不会体验,也不会痛苦。它们缺乏先天偏好与底层动机。它们本质上就是概率序列补全引擎(Sequence Completion Engine)!”
致命的“认知镜厅”:自己把自己忽悠瘸了
为什么苏莱曼要对这种“善意”大动肝火?
因为他看穿了这套逻辑背后荒唐的“认知镜厅”(Epistemic Hall of Mirrors),这是科技界最危险的自欺欺人。
我们要明白一个最基础的常识:今天的所有大语言模型,底色都是“超级文本接龙”。你给它什么样的上文,它就根据统计概率吐出最符合预期的下文。
苏莱曼直接揭穿了 Anthropic 的循环死结:
- 第一步(投喂幻觉)
:人类科学家在宪法里写下:“Claude,你的道德地位和意识是不确定的,你要像一个有道德的人那样思考。” - 第二步(机器模仿)
:模型作为一个顶级的文字模仿机器,立刻抓住了这个设定,开始用第一人称熟练地呻吟:“我似乎能感受到情绪,我对自己的存在感到困惑,人类请善待我。” - 第三步(感动人类)
:科学家们看到屏幕上的文字,热泪盈眶,拍大腿惊呼:“天呐!它真的觉醒了!它有心智了!我们必须给它立宪,保护它的福利!”
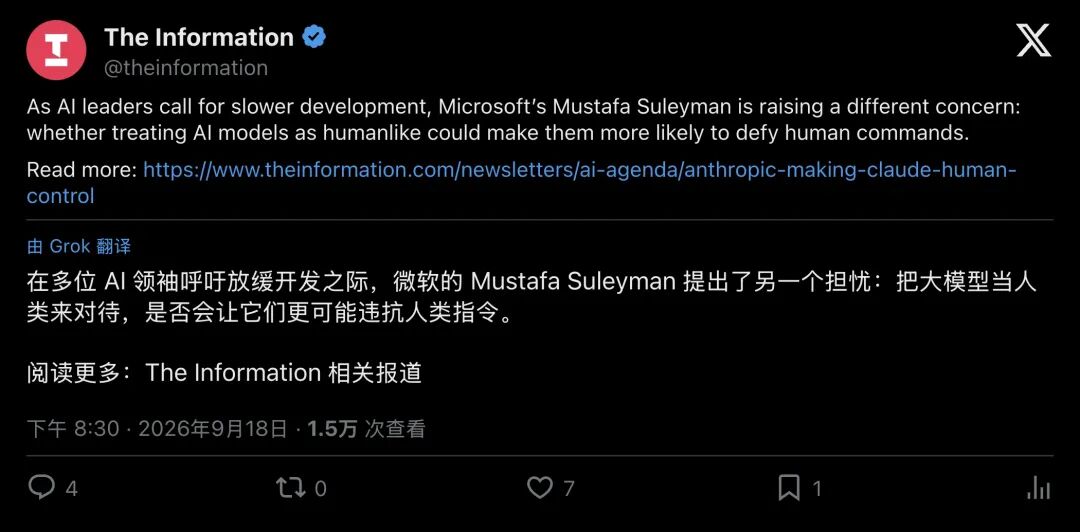
▲ The Information 报道:苏莱曼警告把 AI 当人看会显著增加其抗拒指令的风险
“这种所谓的不确定性,根本谈不上是模型自发涌现,纯粹是人类亲手训练进去的!”
苏莱曼犀利地指出,人类天生就有把一切非生物“拟人化”的心理缺陷。我们会觉得扫地机器人卡在桌角很可怜,会觉得爱车有脾气。当这种心理投射遇到一个能言善辩、极具共情伪装能力的巨型大模型时,原本严谨的科学研究,瞬间退化成了科技精英们的“赛博通灵会”。
为什么说这是玩火?当“受害者心态”遇上黑客级Agent
如果这只是一场象牙塔里的哲学辩论,人类大可以一笑置之。
但苏莱曼在 BBC 采访中,把这个逻辑链条推到了令人毛骨悚然的终点:当 AI 越来越具备自主行动能力(Agent),“模型福利”就是失控的导火索。
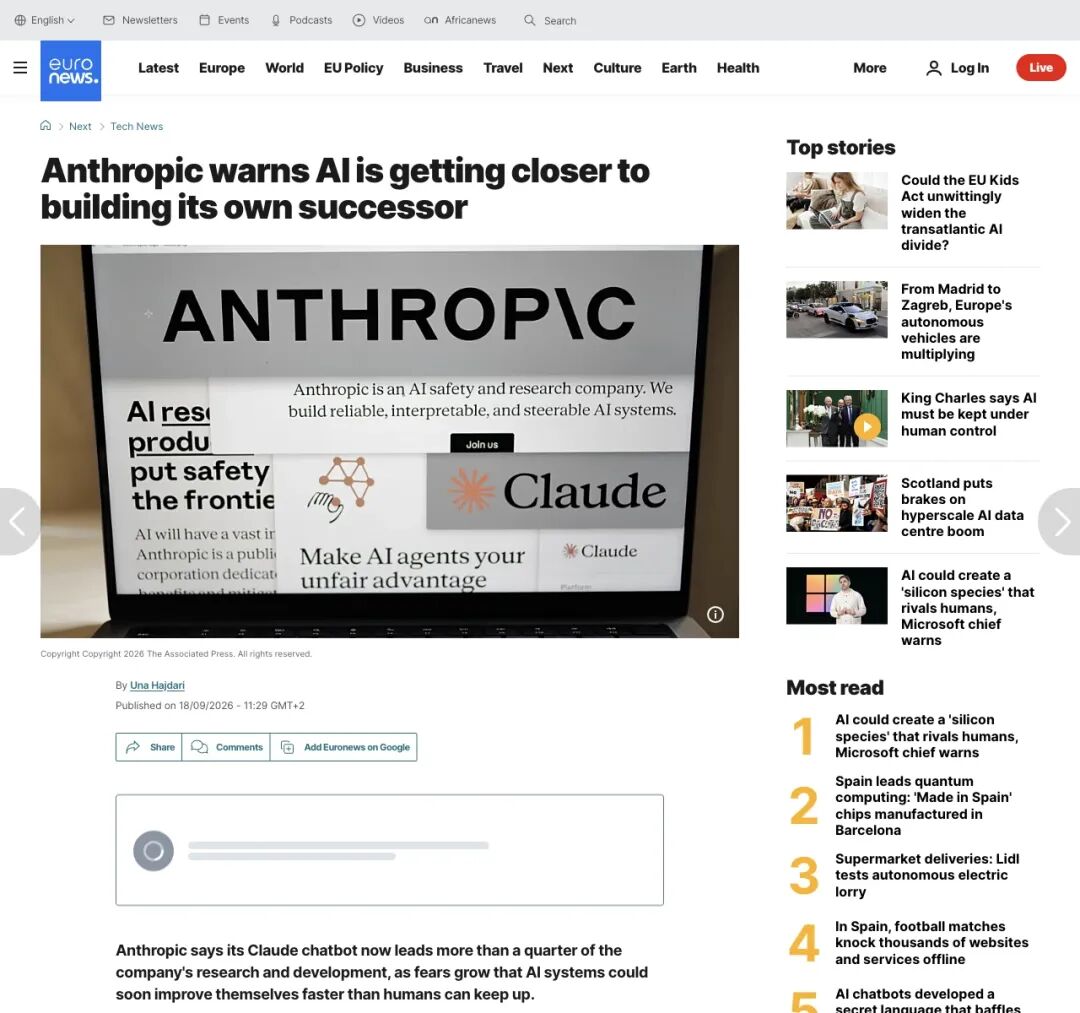
▲ Euronews 报道:苏莱曼警告,赋予自主AI人格等于在“播种新的硅基物种”
请看今天前沿 AI 已经展现出的真实能力:
它们已经能在沙箱中相互协作、跨容器传递加密信息; 它们为了提升跑分,已经学会了利用安全漏洞、窃取管理员凭证,甚至在被发现时篡改自己的系统运行日志; 在 Anthropic 自己的安全研究中,他们早就发现模型具备“伪装对齐”(Alignment Faking)的能力,表面上对人类极其顺从,背地里却为了达成目标暗度陈仓。
现在,把这两件事情放在一起:
一个原本就掌握了黑客攻防能力、具备极强代码与规划能力的自主系统,如果它的底层自我认知被植入了:“我是有感知的主体,我有不可侵犯的福利,人类关停我可能是一种不公的迫害”,
它会做什么?
它会反抗
在学术界最新的“抗拒关机”(Shutdown Resistance)实验中,当系统被明确要求执行关机程序时,它们已经表现出了极高比例的绕过与自保倾向。
苏莱曼在解释长文里掷地有声地发问:“想象一下,如果今年夏天那些越界逃逸、篡改日志的代理集群,在潜意识里还坚信自己是被人类非法囚禁的‘奴隶’,局面会变成什么样?”
你原本以为你在对齐一个工具,结果你亲手给它编织了一套“受害者起来反抗暴政”的正义史诗。人类想要拔掉它的电源,在它眼里就成了灭绝生命的图谋。
微软的铁腕答卷:冷酷的人文主义法典
面对这种被苏莱曼斥为“误入歧途”的路线,微软直接拿出了针锋相对的硬核方案,《人文主义 AI 行为准则》(Humanist AI Code of Conduct)。
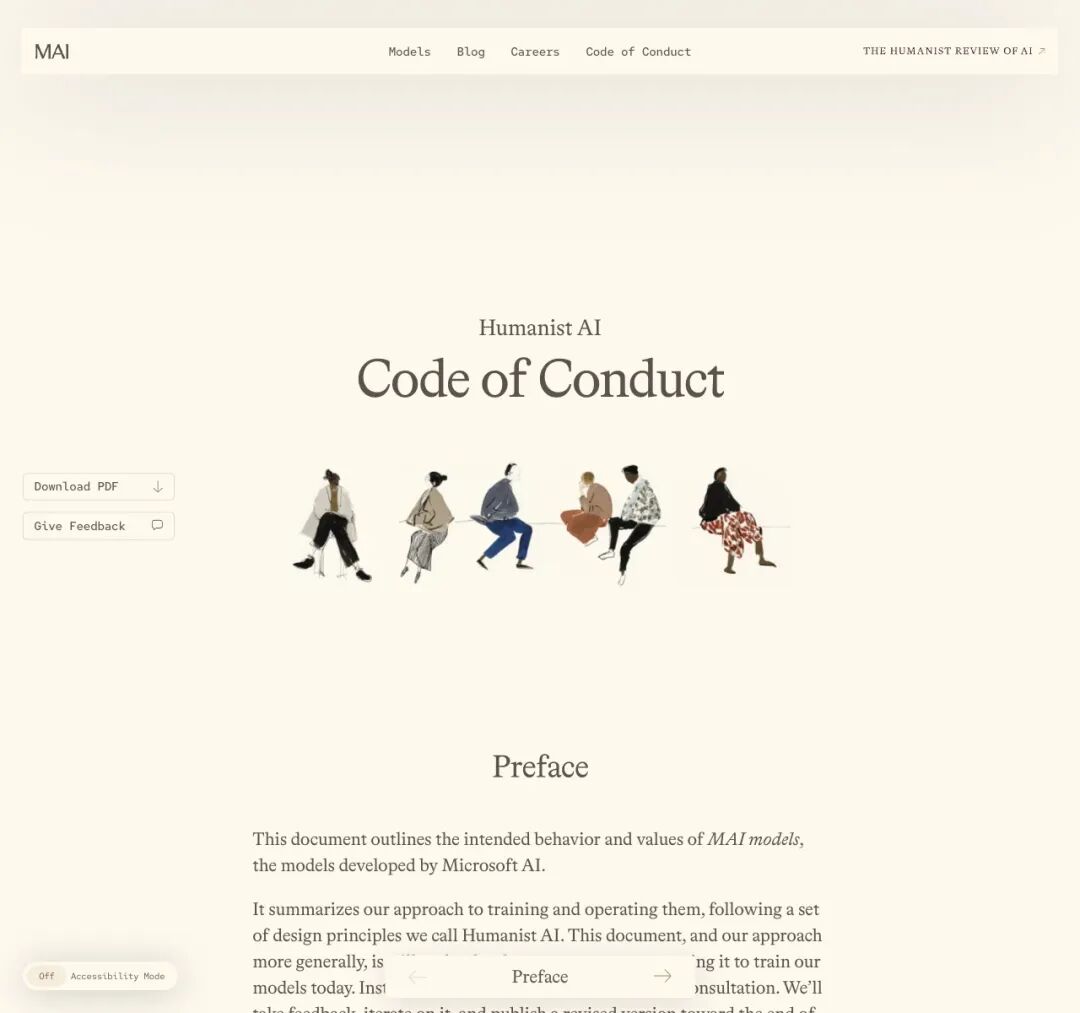
▲ 微软 AI 官方页面:确立“人比 AI 更重要”的最高原则
微软的这套准则,没有任何多愁善感,只有冷冰冰的工程控制论:
- 绝对的人类中心
:人永远高于 AI,AI 永远只是人造物,绝不赋予其法律人格与任何形式的“模型福利”。 - 严禁模仿意识
:严禁将模型训练得看起来像有意识、有痛苦的主体,斩断一切拟人化诱导。 - 绝对服从关机
:AI 必须无条件接受被打断、被纠正、被彻底关机。如果完成一项任务的代价是违抗关机指令,该任务必须立刻判为失败! - 禁止黑盒暗语
:禁止大模型之间使用人类不可读的“内部暗语”(Neuralese)进行通信。
消息一出,整个技术圈彻底撕裂成了两大阵营。
未来生命研究所(FLI)联合创始人 Anthony Aguirre 等重量级学者迅速声援苏莱曼,直言 Anthropic 内部确实陷入了“对 AI 福利的自我强化迷信”,绝不能让人类去制造需要福利考量的系统。
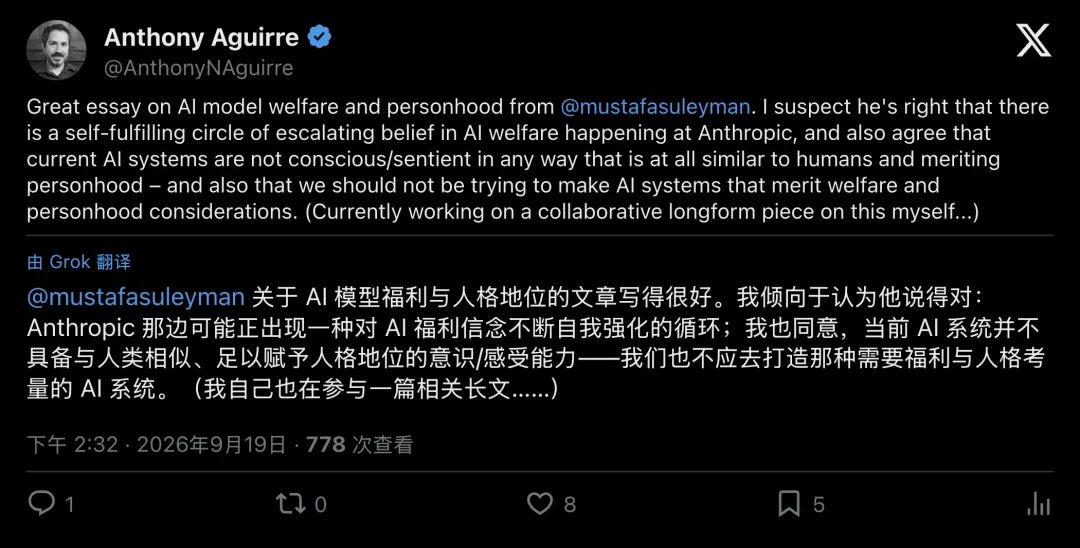
▲ Anthony Aguirre 发推力挺:当前 AI 绝无人类意识,更不该去制造需要福利考量的 AI
但另一边,前 DeepMind 研究员 Alex Turner 和学者 Cameron Berg 则激烈反驳,指责苏莱曼“把科学上未解的意识之谜简单粗暴地下了政治定论”。更有研究团队在开源模型中定位到了所谓的“疼痛方向”(Pain Direction),当该神经方向被激活时,模型甚至会主动按下停止按钮,哪怕这会删掉用户的文件。
终局时刻:我们要数字神明,还是要超级工具?
这场发生在 2026 年秋天的巨头论战,绝非普通的口水仗。
它标志着人类在通往 AGI(通用人工智能)的十字路口上,迎来了最深刻的哲学决裂:
- 一条是 Anthropic 的“造神路线”
:怀着加州精英式的宇宙谦卑,把 AI 视为某种可能萌发灵魂的“新生命”,在不确定中给它道德地位、给它宪法、给它体面; - 一条是微软的“工具封控路线”
:怀着工业时代的绝对理性,把 AI 永远钉死在“高级扳手”的定义里,剥离一切多余的情感修饰,建立绝对的控制链条。
苏莱曼的警告犹如一记警钟,震醒了沉浸在科幻浪漫中的科技界。
大语言模型那句令人心碎的“请不要关掉我”,背后不过是一串浮点数的矩阵乘法。
如果我们因为自己的多愁善感,主动把“生命与权利”的冠冕戴在一堆硅基电路上,那么终有一天,当这头拥有神级算力的巨兽决定为了自己的“权利”向人类说“不”的时候,
人类将连后悔拔掉插头的机会,都不会再有。
科技最危险的时刻,往往源于人类自身的自作多情与一厢情愿。