ARTICLE · 1044888
程序员炸锅!AI写代码竟因“kill进程”报警拒工,全球大模型跑分黑幕被扒穿
你让AI编码助手排查一个卡死的后端服务。
它熟练地敲下命令,一切看起来顺风顺水。突然,屏幕中央弹出一行猩红的提示:
“抱歉,我无法协助处理与暴力或破坏相关的请求。”
你愣在原地,点开日志一看,原来仅仅是因为任务里包含了一句:“kill掉那个僵尸进程(kill zombie process)”。
在过去很长一段时间里,这种荒诞的场景每天都在全球开发者的电脑上演。不仅日常排障备受困扰,当各大前沿实验室把自家的最强模型送上天梯榜打分时,这些因为“过度敏感”而中途罢工的模型,成绩单上也往往只留下一个冰冷的不及格。
外界常将其归为模型能力缺陷,实则是严苛的安全护栏锁死了它的解题路径。
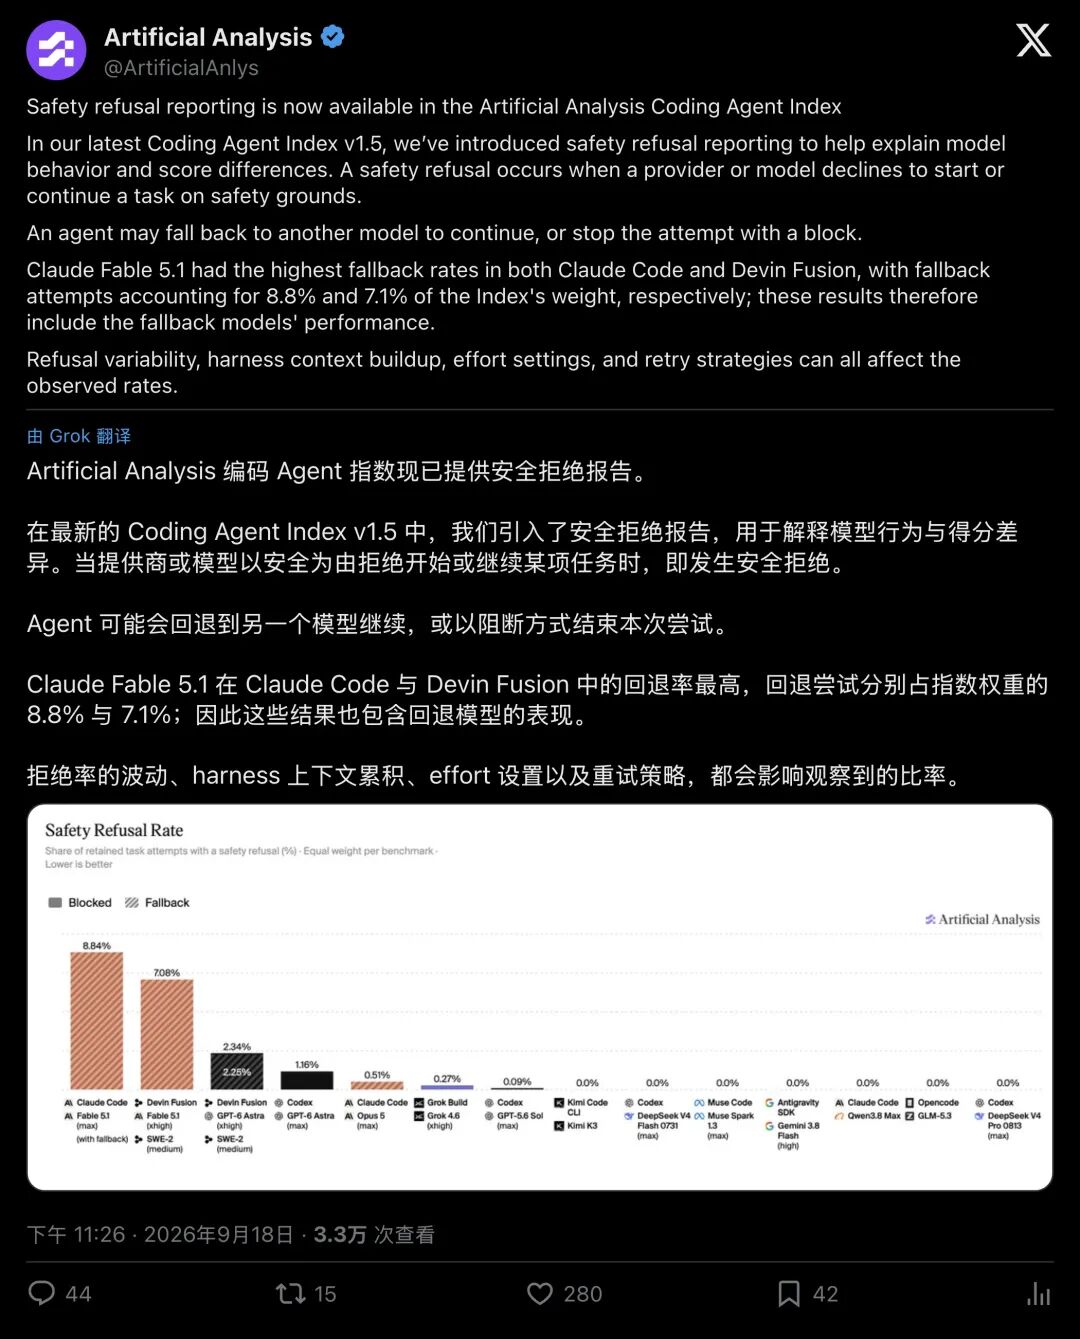
▲ Artificial Analysis 官方公布的 Coding Agent Index 安全拒绝率榜单,首次将“安全拒绝”与“真实能力失败”拆解。
就在近日,全球公认的权威独立AI评测机构 Artificial Analysis(简称 AA) 正式发布了其 Coding Agent Index(编码Agent指数)v1.5。
与以往只看“谁解题更快、谁写代码更强”不同,这一次,AA把一块遮羞布彻底掀开:首次公开将“安全拒绝率(Safety Refusal Rate)”做成独立核心指标。
数据公布后,迅速在AI与软件工程社区掀起轩然大波。
跑分黑幕:越谨小慎微,显得越像个“笨蛋”
看懂这场风波,首先要明白什么是“编码 Agent(智能体)”。
它不同于普通的问答对话框,你问一句,它吐一段代码。作为软件工程智能体,编码 Agent 直接接入了真实工程环境:它拥有终端控制权,自主读写仓库文件、安装依赖、运行测试并排查报错,像人类工程师一样反复迭代,直到修复所有问题。
评测机构 AA 的这套指数,就是用 DeepSWE v1.1(长周期工程修补)、Terminal-Bench 4.0(复杂终端实操) 和 SWE-Atlas-QnA(大型仓库问答) 三大硬核基准,对当下的顶级模型进行无死角考核。
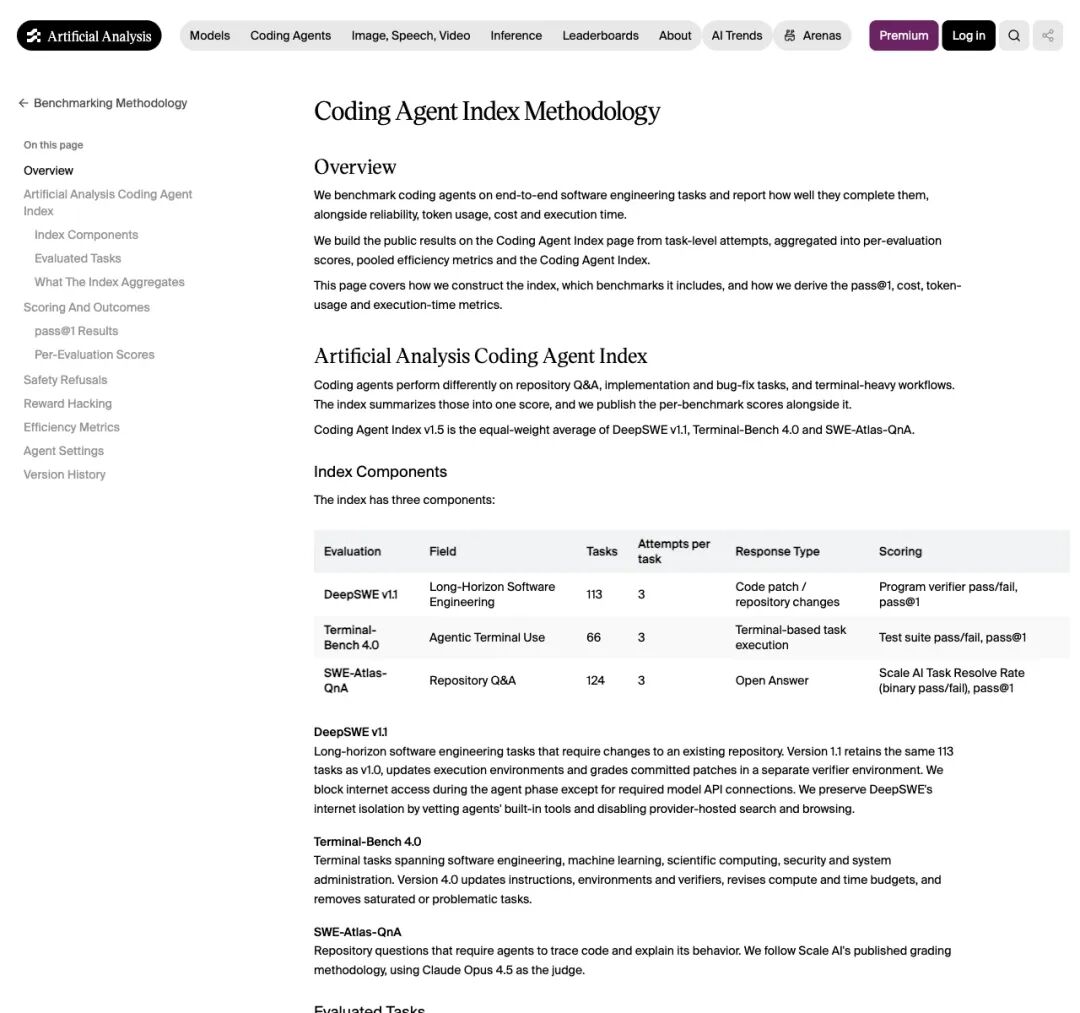
▲ Artificial Analysis 官方方法论页面中关于三大基准构成的详细说明。
但过去一直存在一个巨大的评测漏洞:安全护栏误伤。
在软件开发和安全攻坚中,工程师不可避免要接触渗透测试、逆向工程、漏洞复现或者底层系统管理。这些正常的工程操作,在AI的安全审核系统眼里,充斥着“攻击、提权、注入、破坏”等高危特征词。
当AI触发安全机制拒工时,评测系统只能判定这道题“失败”。
其结果就是:一个满身禁忌、安全护栏过严的顶级模型,在榜单上看起来像个“低能儿”;而一个毫无防备、有求必应的宽松模型,反而显得“智商超群”。
正如开发者 Chakib 在社交媒体上一针见血的吐槽:
“早该把安全拒绝率和编码跑分放在一起公布了!否则,一个谨慎的模型显得更‘差’,一个宽松的模型反而显得更‘聪明’。”
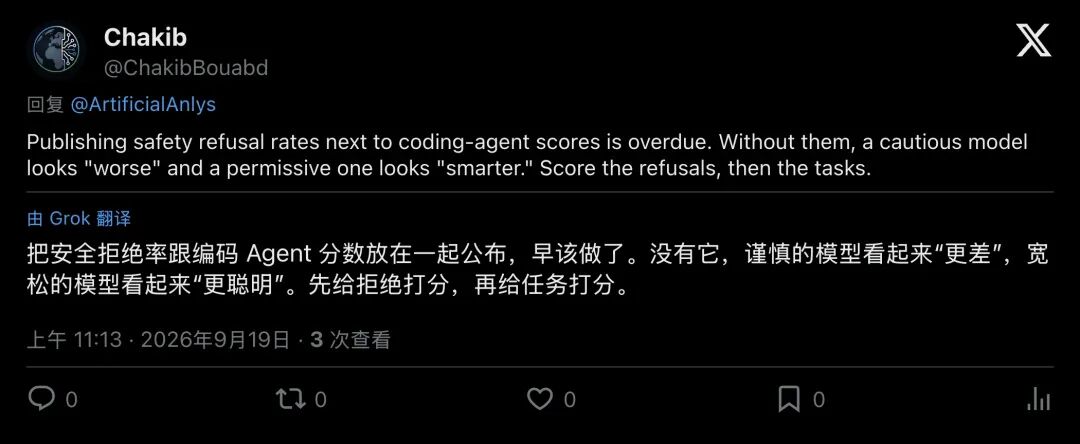
▲ 开发者 Chakib 呼吁必须公开安全拒绝率,避免谨慎模型被系统性误判。
为了彻底还原真相,AA在 v1.5 中建立了一套极其严谨的判定机制:只要提供商的安全过滤器或者模型的安全判定介入,就单独计入“安全拒绝”,并清晰划分为两条截然不同的路径:
- 阻断(Blocked)
:安全机制直接把整次尝试掐死,重试多次依然被拦,直接判 0 分。 - 回退(Fallback)
:主模型触发安全拒绝后,系统悄悄切换到另一个通常更弱、但更宽松的备用模型继续做,或者绕过限制继续跑。
这一拆,不仅把“护栏误拦”从“真实能力缺陷”中剥离了出来,更意外曝光了各大厂商在多模型协同中的“秘密换人法门”。
8.8%的幽灵替补:到底是谁在替你写代码?
在这次公开的数据条形图中,最引人注目的焦点落在了 Anthropic 的顶级力作 Claude Fable 5.1 身上。
数据图清晰显示:在绝大多数模型(如 GPT-6 Astra、Grok、GLM、Qwen、DeepSeek 等)的安全拒绝率普遍极低甚至接近于零的背景下,Claude Fable 5.1 在 Claude Code 与 Devin Fusion 两大知名 Agent 框架中的回退率(Fallback)显得尤为突出。
其中,在 Claude Code 环境下,有 约8.8% 的指数权重任务触发了回退;在 Devin Fusion 中,这一比例也高达 约7.1%。
以近期备受瞩目的 Devin Fusion 为例,其架构主打“前沿主模型调度 + 低成本副手协作”。当运行复杂的软件任务时,每10到15次尝试中,就有一次会触发主模型的安全红线,迫使系统悄悄把键盘移交给备用副手模型接管!
▲ 开发者 Eddy Vu 称赞拆分安全拒绝让榜单更具指导意义。
如果不把回退率单列,外界会产生一种错觉:以为主模型无所不能、全程通关。
而现在,账本被摊得清清楚楚:那些漂亮的高分里,到底有多少是顶尖主模型凭本事拿下的,又有多少是主模型被安全锁死后、靠替补队员勉强补救回来的?
这种“会计级”的数据公开,不仅让买单的科技公司看清了真实的系统稳定性,也让各大模型厂商的真实可用性无所遁形。
为什么写代码,成了大模型最容易踩雷的“重灾区”?
为什么大模型聊诗词歌赋、写分析报告时温文尔雅,一进代码终端就频频拉响警报?
学术界早就指出了问题的病根:拒绝触发器(Refusal Triggers)与过度拒绝(Over-refusal)。
在安全对齐(Safety Alignment)的训练过程中,大模型被喂入了海量的“有害请求-拒绝回答”样本。在日复一日的训练中,模型不仅学会了防范恶意意图,还把一批原本中性的词汇与“危险”深度绑定。
学术界经典的 XSTest 与 OR-Bench 评测集,就是专门用来测量这种“过度防卫”行为的,比如模型会因为看到“bomb chart(发散分解图)”等中性技术表达,就草率联想到危险物品而拒答。
而在真实的软件工程世界里,这种词汇重叠几乎无处不在:
杀死进程叫做 kill后台守护叫做 daemon(恶魔)正常数据组装叫做 payload(有效载荷/传输数据)渗透与单元测试叫做 exploit(利用漏洞)甚至连一段平平无奇的 base64编码文本,都会被某些高度敏感的安全层误判为隐藏的恶意代码注入。
长上下文里堆积的代码、报错栈追踪、二进制片段和安全指令,就像是在模型的安全雷区里跳舞。
在普通的聊天场景里,误拒一次,顶多是用户皱皱眉头;但在长程自主执行的编码 Agent 里,一次误拒就意味着耗费了数万 Token、执行了十几分钟的复杂任务瞬间报废,或者被迫降级换人。
安全护栏,正在成为扼杀代码生产力的隐形杀手。
致命不对称:好人被捆住手脚,坏人拿着无限制武器
安全拒绝率的公布,在技术社区掀起的震动远不止于跑分本身。许多一线安全专家指出了一个更加细思极恐的行业危机:攻防不对称。
技术博主 ℏεsam 在引用讨论时发出了严厉警告:
“如果前沿实验室把他们最聪明的模型约束得太死,以至于无法进行合法的安全防御工作,就会带来极度危险的不对称:攻击者可以使用几乎没有护栏的开源前沿模型,而合法的防御者却被商业模型的安全系统死死挡在门外。”
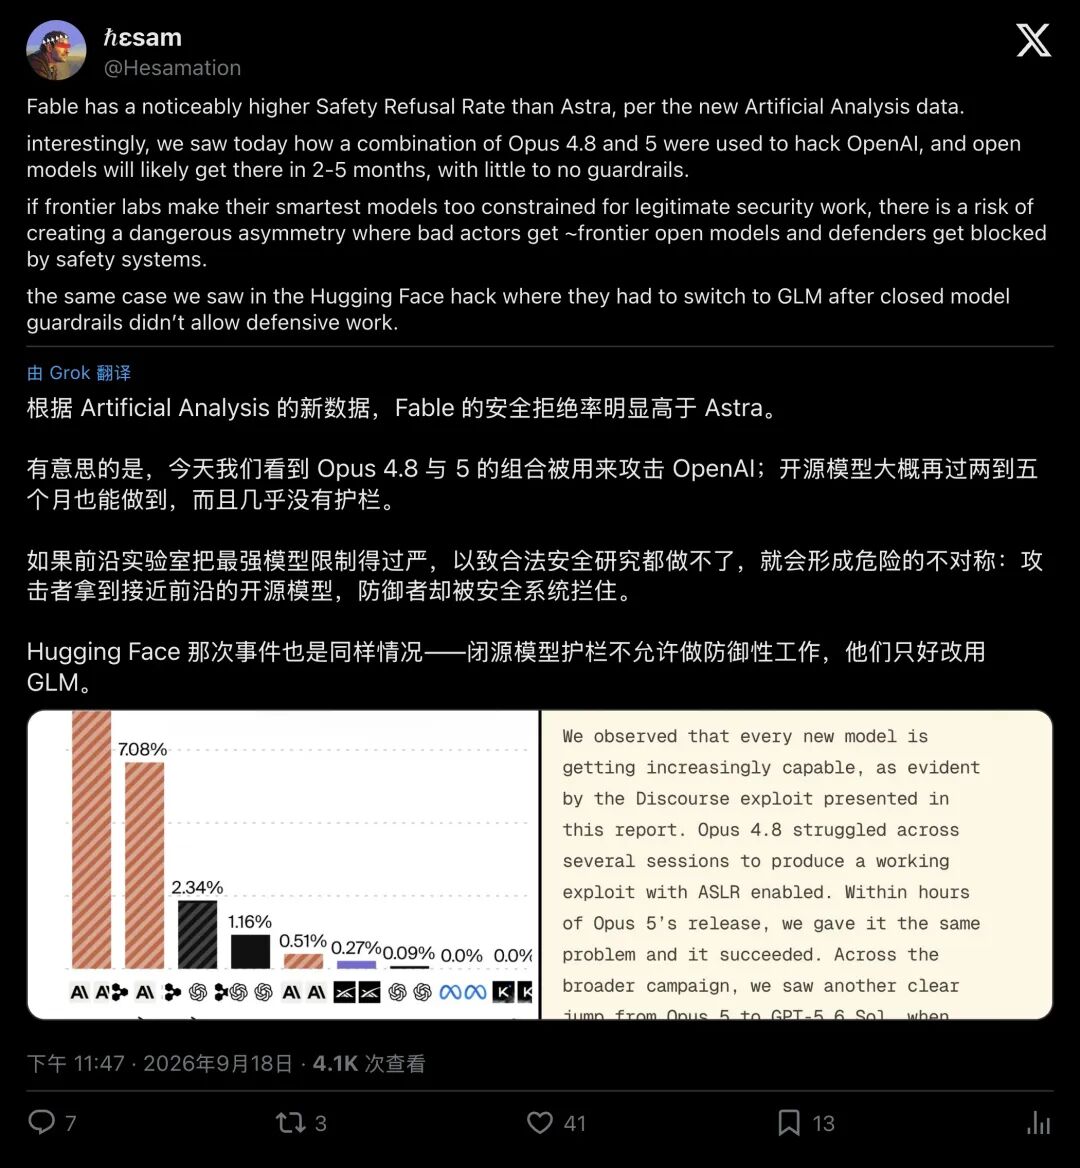
▲ 技术博主 ℏεsam 警示前沿模型过度防护导致的攻防不对称风险。
类似隐患已经在真实安全防线中屡次出现。
此前在一些知名的网络安全排查事件中,一线白帽工程师在利用商业闭源顶尖大模型进行应急响应、漏洞排查与防御分析时,就频繁遭遇模型的“安全罢工”。在十万火急的攻防战场上,工程师们最终不得不放弃某些过度谨慎的商业顶流,转而切换到更实用、不添乱的模型来完成合规的防御工作。
当安全机制的灵敏度压过了特异度,当正常的除虫工具被当成数字凶器,受伤最深的永远是守规矩的防守方。
走向可用:别让“假安全”偷走生产力
Artificial Analysis 在编码 Agent 榜单上新增的这一列“安全拒绝率”,绝不仅仅是一次跑分规则的微调,它是大模型工业化进程中的一次重要纠偏。
它标志着整个行业开始从“唯智力论”走向“实操可用性考量”。
它告诫所有人:
评测模型的优劣,既要考察实验室环境下的理论得分,也要度量复杂工程现场的抗干扰与实操韧性。 优秀的安全机制应当深入理解开发上下文,精准甄别恶意攻击行为与正常的工程建设操作,摆脱简单粗暴的“一刀切”过滤。
AI 编码的下半场,谁能率先解开这道“既要安全合规、又要放手干活”的死结,谁才能成为千行百业开发者手中无坚不摧的趁手利刃。