ARTICLE · 1045445
游戏角色声音被AI复刻,米哈游获赔75万:企业能赢的案子,配音演员为什么难

米哈游AI声音侵权案胜诉获赔75万,依托运营数据证明角色声音的商业标识属性赢下官司;但配音演员等个体维权面临声音溯源难、可识别性举证成本高的痛点;前置数据知识产权登记可填补举证缺口,为个体和企业提供双重保护路径。
蝶境智科 | 上海浦东法院判例深度解读

近期,上海首例涉AI声音仿冒不正当竞争纠纷案尘埃落定,一审判决生效:被告运营AI变声软件,未经许可抓取《原神》游戏角色音频,训练模型生成63款角色声音资源包对外付费售卖,还使用涉案游戏的角色形象、剧情动画制作宣传视频,改编角色形象作为声音资源包头像。
原告米哈游提起著作权侵权及不正当竞争诉讼,浦东法院最终判令被告停止全部侵权行为,赔偿经济损失及维权合理开支合计75万元。
本案是国内首例企业作为原告胜诉的AI声音侵权案,与此前配音演员自然人维权的判例形成鲜明对比,也暴露出个体与企业在AI侵权维权中的资源差距。

本案胜诉依赖三条彼此独立的证据链:
- 技术证据:
声纹司法鉴定结论「倾向认定同一」,为声音同一性提供技术支撑 - 事实证据:
被告自认截取约一分钟角色音频用于模型训练,直接证明数据来源的非法性 - 混淆证据:
被告使用角色头像、剧情画面进行整体仿冒,强化了混淆可能性的认定 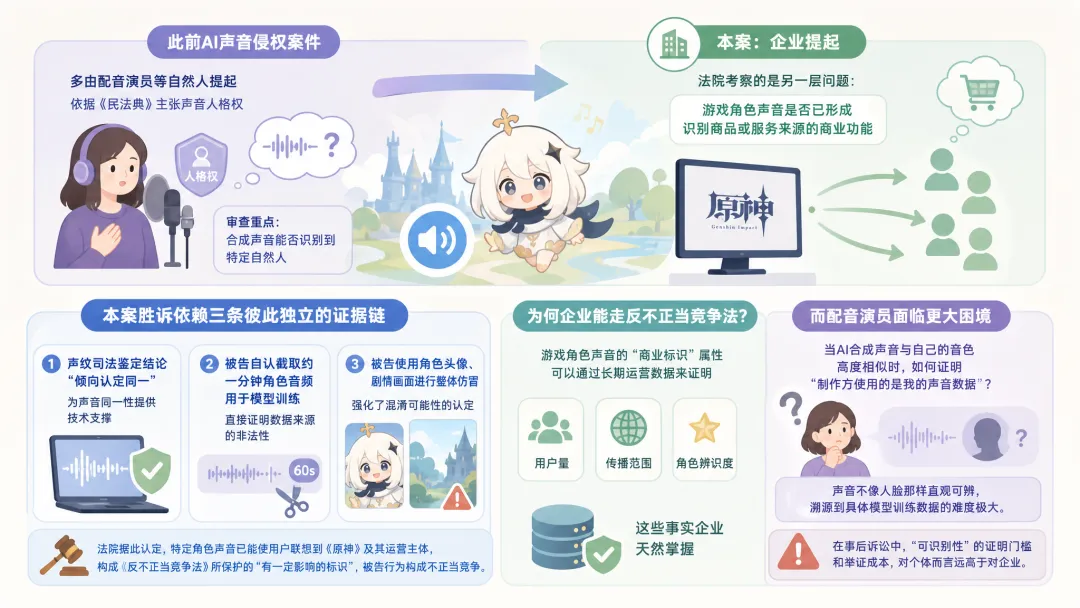
企业能走反不正当竞争法路径,是因为游戏角色声音的「商业标识」属性可以通过长期运营数据来证明——用户量、传播范围、角色辨识度,这些事实企业天然掌握。企业vs配音演员维权难度对比:
但配音演员面对的是另一种困境:当AI合成声音与自己的音色高度相似时,如何证明「制作方使用的是我的声音数据」?声音不像人脸那样直观可辨,溯源到具体模型训练数据的难度极大,在事后诉讼中,「可识别性」的证明门槛和举证成本,对个体而言远高于对企业。

当发生特征抽取、AI复刻争议时,它可以辅助解决「制作方是否使用了我的数据」这一溯源难题——这正是事后举证中最薄弱的一环。
本案判决同时明确,企业依据反不正当竞争法维权,并不排除配音演员依据《民法典》另行主张声音人格权益,二者分属不同法益,可以并行保护。

AI是创作工具,但创新不能建立在盗用他人声音、形象资产之上。权属确认、授权核验,应当前置到数据采集、模型训练的起点。
对创作者和企业而言,AI时代的声音资产保护不能只依赖事后诉讼,事后维权往往遭遇溯源困难、算法黑箱带来的举证难题。在做好原始素材授权审核之外,将角色音色、人脸特征经过清洗、标注、结构化处理,通过数据知识产权登记完成前置权属存证,可以在发生争议时作为财产性利益的初步证据,与人格权诉讼形成互补,降低事实查明的难度。
本文部分信息来源于上海市浦东新区人民法院发布会、新京报公开专访。
👇 关注「蝶境智能」公众号
获取数据知识产权登记最新政策、司法判例与落地方案