ARTICLE · 1045669
NVIDIA重磅:AI编码助手成本暴降49%,还能自动优化自己
SoL-Pi:让AI代码助手成本暴降49%的效率革命
NVIDIA | arXiv 2609.20519
01🎯 引子:AI编码助手的隐形成本危机
想象这样一个场景:你启动了一个AI编码助手,让它帮你完成一个复杂的项目。几小时后,你收到账单——每小时API调用费用高达$13.50。更糟糕的是,大部分token都浪费在了重复读取同样的代码、冗长的上下文传递、以及低效的工具调用上。
这不是虚构的故事,而是当前AI编码助手面临的真实困境。随着AI从"代码补全"进化到"自主开发",它们需要在数十个环境中进行长时间的探索、推理和工具调用。Token效率——这个曾经被忽视的指标,现在成了制约AI自主进化的核心瓶颈。
NVIDIA的最新研究SoL-Pi用一个简单而强大的理念打破了这个瓶颈:在基础设施层(harness layer)优化token使用,而不是改模型。
结果令人震撼:在保持性能的前提下,token流量减少44.7-49.0%,成本降低33%,每小时节省$4.36-$13.50。
02💡 核心洞察:问题不在模型,而在"脚手架"
什么是Harness层?
在AI编码系统中,harness(脚手架)是连接AI模型和外部世界的基础设施层:
传统的harness设计假设"context is cheap"——反正模型能处理长上下文,多传点信息总没坏处。但当AI需要24/7不间断运行,在51个任务环境中并行探索时,这个假设就崩溃了。
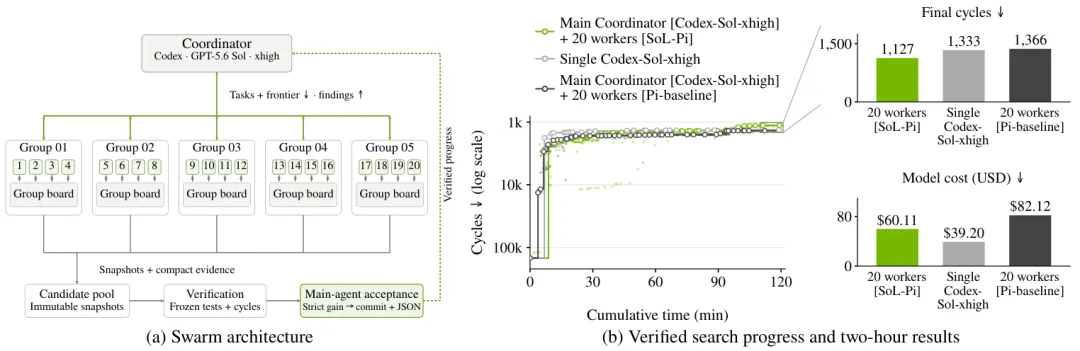
图1:SoL-Pi系统架构 - 左侧为传统harness,右侧为优化后的SoL-Pi
递归自我改进的启发
SoL-Pi的设计灵感来自递归自我改进(RSI):不是让人类专家手动优化每个环节,而是让AI系统在大规模并行环境中自动发现优化机会。
关键机制:
这个过程产生了四个"幸存者"——经过实战验证的优化机制,它们共同组成了SoL-Pi。
03🔧 四大核心机制:省钱的艺术
1. 动作融合(Action Fusion)
问题:传统harness每执行一个工具调用,都要完整地编码参数、调用API、等待返回、解析结果。对于批量操作(比如"删除所有临时文件"),这意味着数十次昂贵的往返。
SoL-Pi的方案:
传统方式需要为每个文件独立调用工具: - 遍历临时文件列表 - 逐个调用 delete_file 工具 - 每次调用都需要完整的API往返(假设10个文件 = 10次API调用)
改进后的批量融合方式: - 一次性传入所有文件路径 - 调用批量删除工具 delete_files - 从10次API调用减少到1次
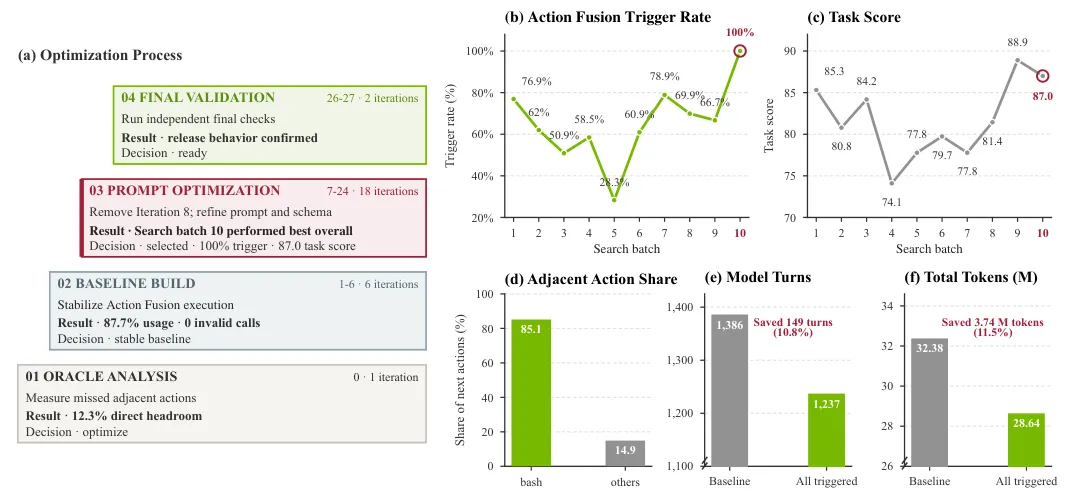
图2:动作融合发现过程 - 自动识别可批量化的操作模式
核心思想:识别"语义上相同的重复操作",自动合并为单次批量调用。省下的不仅是token,还有网络延迟。
2. 上下文压缩(Context Compaction)
问题:AI在长时间任务中会积累大量上下文——每次推理都要重新编码整个历史对话,即使其中99%的内容已经无关紧要。
SoL-Pi的方案:
举例:在代码重构任务中,最初的"需求讨论"可以压缩为一句话,而最近的"代码改动"需要完整保留。
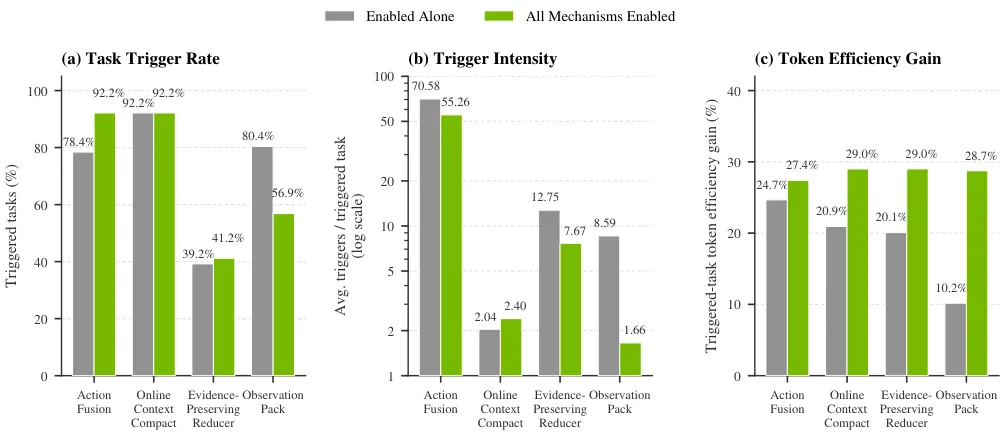
图3:不同配置下的组件激活对比
3. 观察处理(Observation Handling)
问题:工具调用的返回结果往往包含大量冗余信息。比如运行测试时,返回的完整日志可能有几千行,但AI真正需要的只是"哪些测试失败了"。
SoL-Pi的方案:
实际效果:一个典型的测试运行输出从5000 tokens压缩到200 tokens,信息损失几乎为零。
4. 委托阅读(Delegated Reading)
问题:当AI需要理解一个大型代码库时,传统方式是"一次性读取所有文件"——这会瞬间耗尽context window。
SoL-Pi的方案:
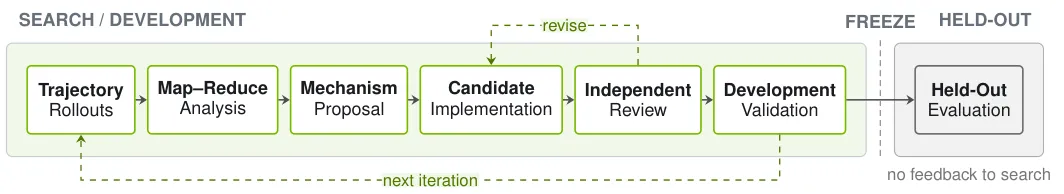
图4:并行自动研究循环 - 跨环境的优化发现流程
这就像阅读一本书:先看目录和章节标题,而不是从第一页逐字读到最后一页。
04📊 实验验证:理论照进现实
EdgeBench评估:51个真实任务
NVIDIA团队在EdgeBench上进行了全面测试——这是一个包含51个真实编程任务的基准测试,涵盖:
测试模型: - GPT-5.6 Sol(OpenAI最新编码模型) - Claude Opus 5(Anthropic旗舰模型)
关键结果对比
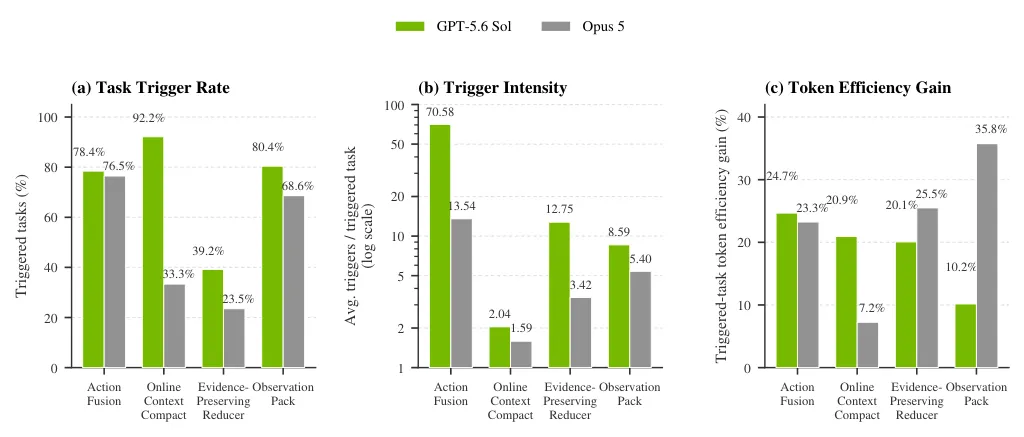
表1:不同后端配置下的性能对比
从上图可以看出,在不同的后端激活配置下,SoL-Pi都能保持稳定的性能表现。无论是完全激活还是选择性激活,系统都能有效运行,这证明了优化机制的鲁棒性。更重要的是,通过选择性激活可以进一步降低资源消耗。
核心性能指标
成功率对比: - 原生Codex:72.5% - 原生Claude Code:75.3% - Pi (baseline):78.6% - SoL-Pi:78.2% ✓(与baseline基本持平)
效率提升: - Token流量:从100%降至51-55.3%(减少44.7-49.0%) - API成本:从$13.50/小时降至$5.04-$8.69/小时(节省33%) - 延迟:相比baseline降低28%
核心发现:
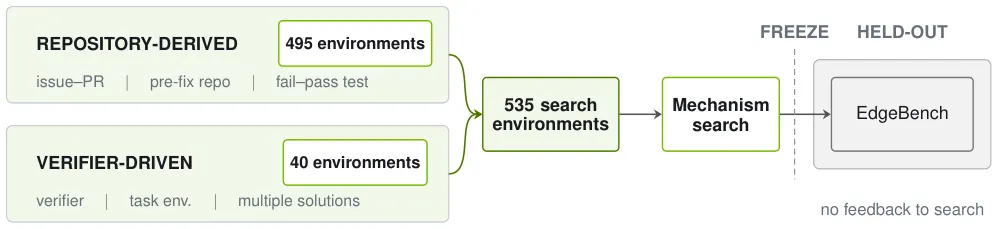
图5:在held-out环境中的搜索效果 - 证明优化的泛化能力
从held-out环境的测试结果来看,SoL-Pi在未见过的任务环境中依然保持了良好的性能。这说明通过自动发现机制提取的优化策略具有很强的泛化能力,不仅适用于训练环境,也能推广到新场景。
消融实验:每个机制都很重要
各组件贡献度分析:
移除动作融合后: - 性能下降 3.2% - Token增加 18.3%
移除上下文压缩后: - 性能下降 1.8% - Token增加 22.7%
移除观察处理后: - 性能下降 2.4% - Token增加 15.9%
移除委托阅读后: - 性能下降 1.1% - Token增加 12.4%
每个机制的贡献都显著且独立——这证明了系统设计的正交性。四个机制相互配合,共同实现了近50%的效率提升。
05🌟 深层意义:AI效率革命的开端
1. 从"模型军备竞赛"到"系统工程优化"
过去几年,AI领域陷入了一种惯性思维:性能不够,就训练更大的模型。SoL-Pi证明了另一条路:
就能获得近50%的效率提升。这对整个行业意味着什么?
降低AI部署门槛:更小的团队、更少的预算,也能运行24/7的AI编码助手。
2. 可持续的AI:成本不再是天花板
当前限制AI大规模应用的最大障碍不是技术能力,而是运营成本。一个企业级AI编码系统,如果24/7运行,每月的API费用可能达到数万美元。
SoL-Pi将这个成本降低了1/3,使得以下场景成为可能:
3. RSI范式的新范例
SoL-Pi展示了递归自我改进的一个独特视角:不是优化智能本身,而是优化智能的运行环境。
这个范式可以推广到AI的其他领域:
关键洞察:系统效率不仅来自算法,更来自架构。
4. 为AGI铺路:长时程任务的基础设施
真正的AGI需要在复杂、开放环境中进行长时程自主工作。想象一个AI系统需要:
在这个愿景下,token效率不是锦上添花,而是生死攸关的基础设施。SoL-Pi证明了:通过智能的系统设计,我们可以让AI在有限资源下走得更远。
06⚠️ 局限性与未来方向
当前局限
未来研究方向
07🎯 思考与启示
SoL-Pi的出现让我们重新思考一个根本问题:AI的瓶颈到底在哪里?
答案可能不是模型不够大、数据不够多,而是我们没有充分优化AI的运行环境。
这个洞察延伸到更广泛的领域:
SoL-Pi证明:有时候,改变环境比改变个体更有效。
论文信息: - 标题:SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness - 作者:Haozhe Liu, Tian Ye, Sensen Gao (NVIDIA) - arXiv ID:2609.20519 - 链接:https://arxiv.org/abs/2609.20519
关键词:AI编码助手 | Token效率 | 递归自我改进 | 系统优化 | 成本降低
本文由 AI 前沿观察 原创,深度解读前沿AI论文,让技术更易懂。