ARTICLE · 1046978
AI超节点行业深度:发展历程、技术演进、产业链及相关公司深度梳理
当物理制程逐渐逼近极限,单靠提升单颗芯片的晶体管密度,已经无法跟上大模型参数量指数级暴涨的步伐。
大模型时代的算力瓶颈,正在从“算得不够快”加速演变为“传输跟不上”。高昂的通信延迟与内存容量上限,构成了制约大规模算力集群发挥效能的“通信墙”与“内存墙”。
在这一背景下,将数十至数百颗算力芯片进行逻辑整合、构建统一内存域的“超节点”(SuperPod)架构,成为突破性能瓶颈的关键解法。
国产算力产业正经历从追逐单芯片制程到拼抢系统工程能力的转变。当节点规模跨过千卡、迈向十万卡时,决定胜负的早已不仅是芯片本身,更是高速互联、散热与供电的综合重构。
01.
行业定义
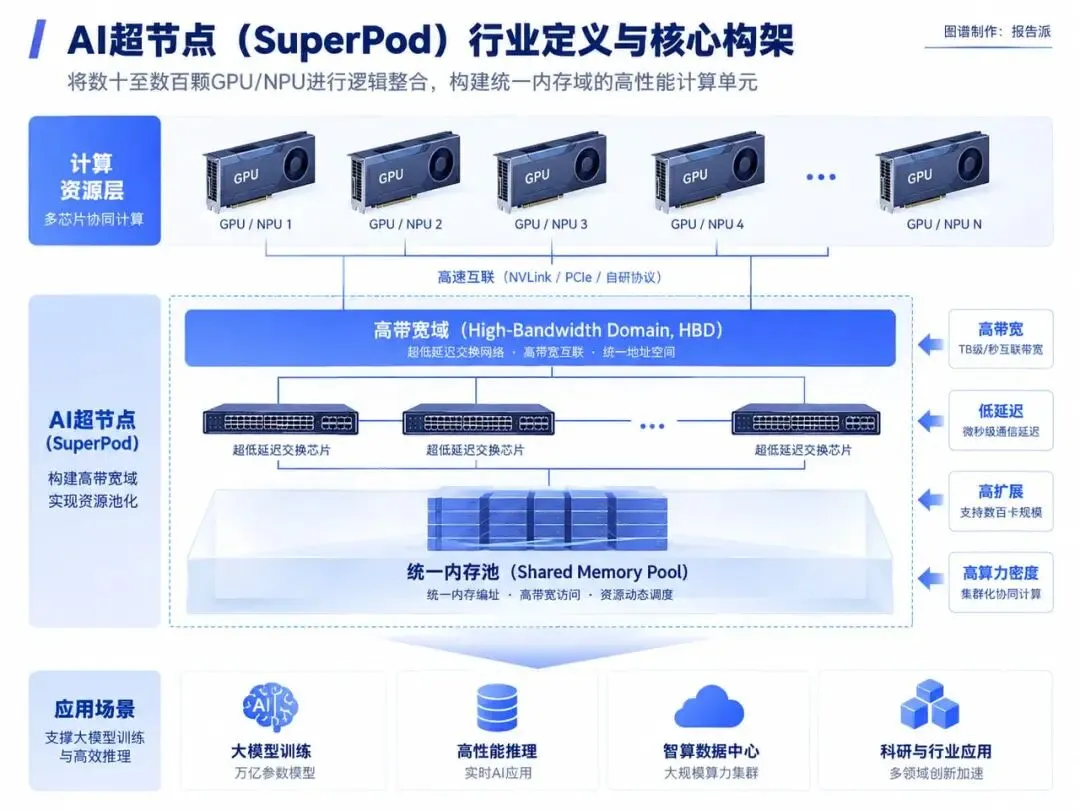
超节点(SuperPod)是数据中心内用于提升计算密度、优化网络互联效率的核心架构单元。
它通过专用交换芯片与高速互联协议,将数十至数百颗GPU或NPU芯片进行逻辑整合,构建起高带宽域(HBD)。
在超节点架构下,集群内部具备统一的内存编址、低延迟与高带宽特性,能够将分散的计算资源转化为协同工作的单一逻辑巨型计算单元。
超节点不仅是解决传统服务器通信延迟高、内存利用率低下等痛点的关键路径,也是支持万亿及十万亿参数大模型训练与高效推理的智算基础设施基石。
02.
行业分类
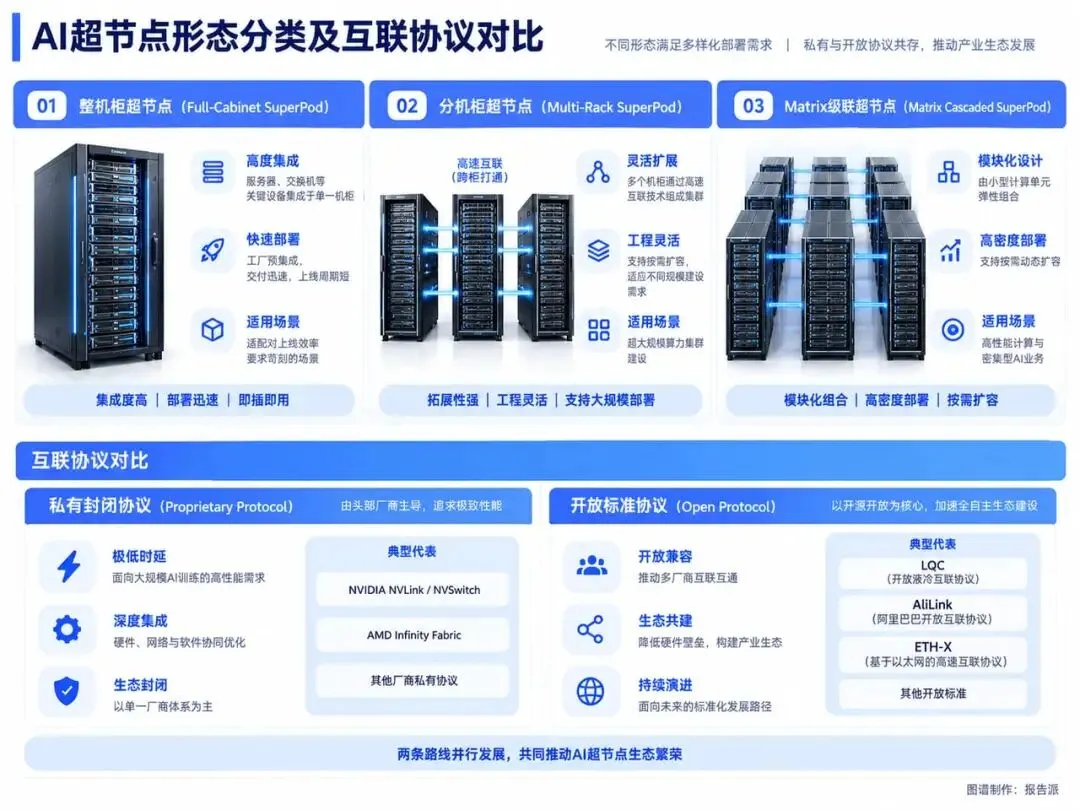
按照硬件集成方式、部署形态与拓展能力,超节点主要划分为以下三类:
整机柜超节点:将服务器、交换机等关键设备高度集成于单一标准机柜内。集成度极高,交付部署迅速,适配对上线效率要求苛刻的场景。
分机柜超节点:由多个独立机柜通过高速互联技术跨柜打通组成集群。具备出色的拓展性与工程灵活性,主要应用于超大规模算力集群建设。
Matrix级联超节点:采用模块化矩阵设计,由小型计算单元弹性组合。支持高密度部署与按需动态扩容,是高性能计算与密集型AI业务的主流选择。
在互联协议维度,产业同步沿着两条路线演进:
一方面是以头部厂商为主导的私有封闭协议,追求极低的时延与高度集成的性能表现;
另一方面是以开源开放为核心的标准协议(如LQC、AliLink、ETH-X等),旨在打破硬件壁垒,加速全自主生态的共建。
03.
发展历程
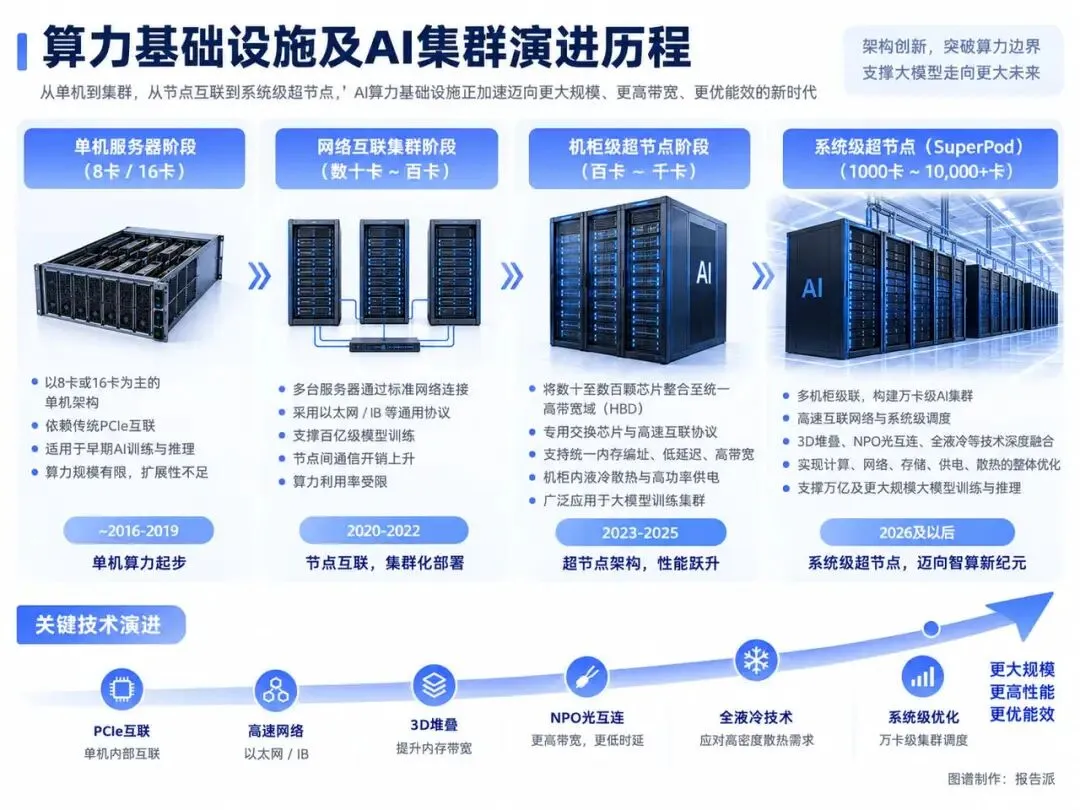
算力基础设施的演进,经历了从单机堆叠到网络集群,再到系统级超节点的阶段。
早期的AI服务器主要依托传统的8卡或16卡单机架构,节点之间依靠标准网络连接。随着模型参数量突破千亿,节点间通信损耗急剧增加,“算力利用率低”成为行业普遍难题。
为破解这一瓶颈,依托高速互联协议与专用交换架构的“超节点”概念应运而生。超节点将互联边界从单台服务器扩展至整机柜甚至多机柜域,实现了网络与计算的深度融合。
当前,国产超节点迎来关键跨步。面对先进制程受限的客观环境,国内厂商不再单纯追逐单芯片工艺的升级,转而以架构创新实现多点突破。
近存计算、3D堆叠、NPO光互连以及整机柜全液冷技术的引入,推动国产超节点从百卡规模迅速扩展至千卡乃至万卡集群,2026年也成为国产超节点规模化商用落地的关键之年。
04.
产业链全景分析
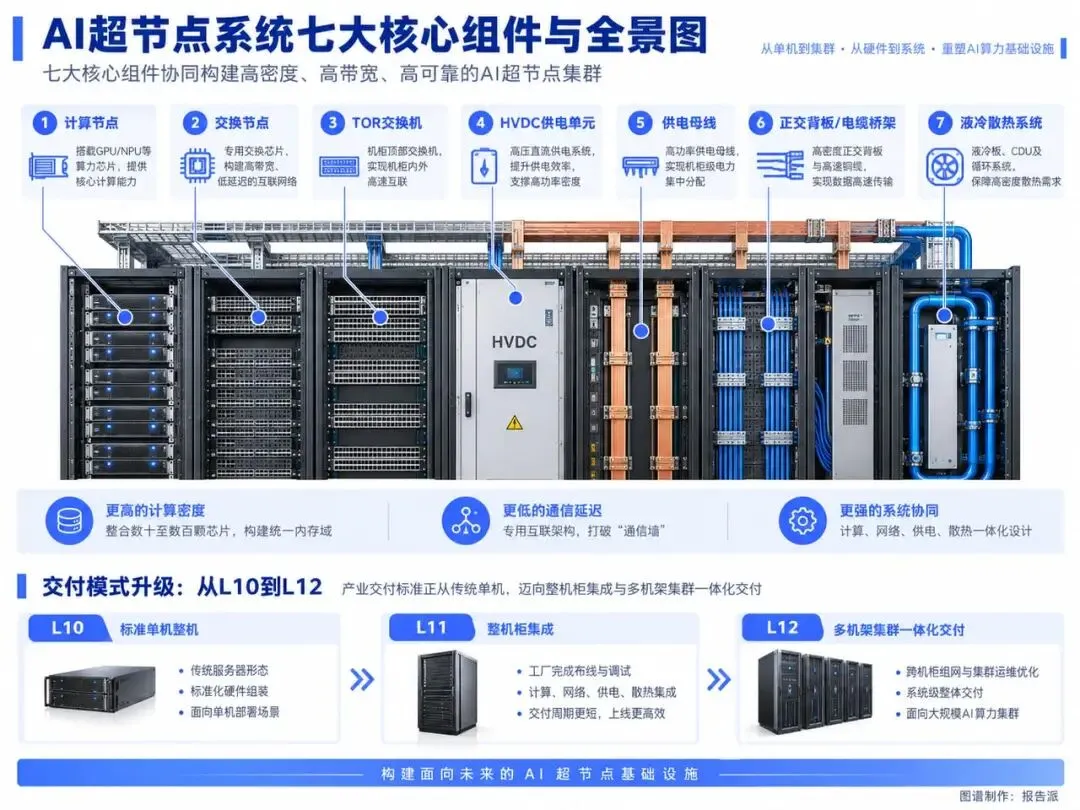
一套完整的超节点集群,由计算节点、交换节点、TOR交换机、供电单元、供电母线、正交背板/电缆桥架以及液冷散热系统七大核心部分融合而成。
超节点的普及正在重塑AI服务器产业链的价值分布与交付形态:
交付模式升级:产业交付标准正从传统的L10(标准单机整机)快速迈向L11(工厂完成布线与调试的整机柜集成)以及L12(包含跨机柜组网与集群运维优化的多机架集群一体化交付)。
厂商价值重估:交付门槛的抬高直接引发了服务器ODM/OEM厂商的价值重估。代工厂商不再只是执行硬件组装,而是深度参与到交换系统、电源模组与散热系统的工程化集成中,产品附加值与行业壁垒显著上升。
整体产业链呈现出算力卡、交换芯片、高功率电源、HVDC高压直流、液冷设备、高速连接器件与光模块全方位协同升级的格局。
05.
产业链上中下游深度解析
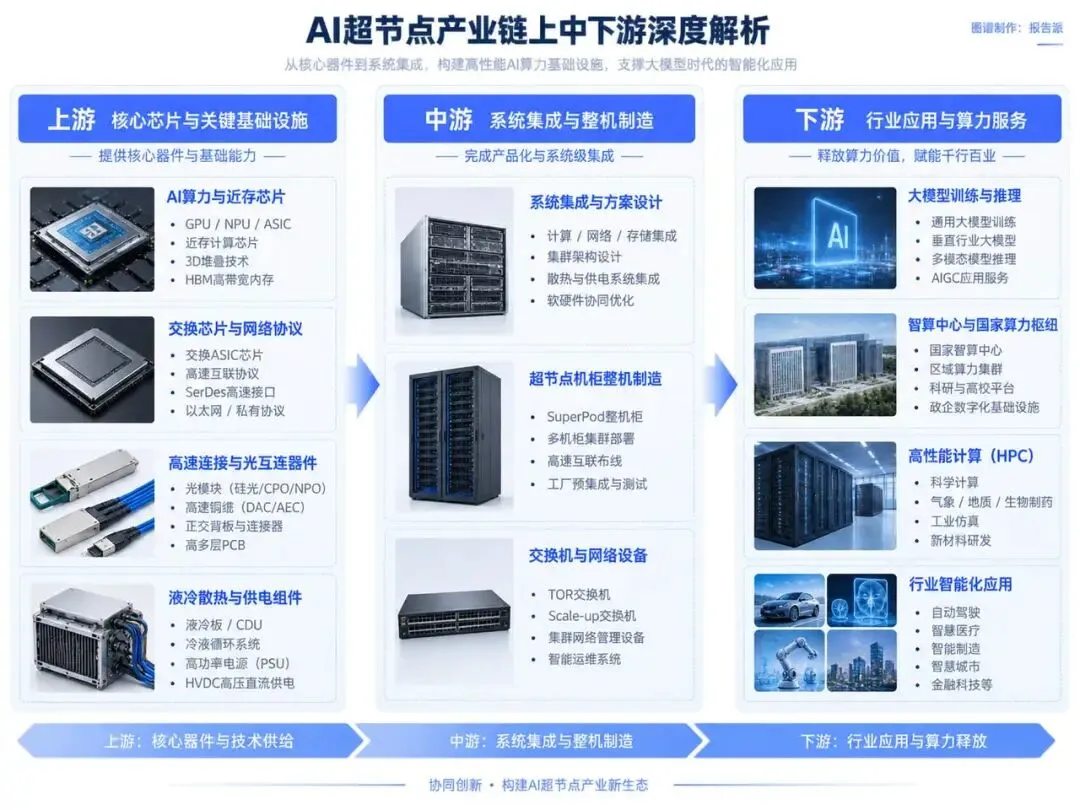
【上游:核心芯片与关键基础设施】
AI算力与近存芯片:算力芯片是计算节点的核心。寒武纪、海光信息、沐曦、摩尔线程、壁仞科技、天数智芯等国产厂商持续升级芯片架构。同时,东方算芯、清微智能等企业推进近存计算与3D堆叠技术,提升单卡互联带宽与计算吞吐。
交换芯片与网络协议:交换芯片是构建超节点高带宽域的核心咽喉。随着Scale-up网络域从单机拓展至整机柜,交换芯片的配置比例大幅走高。盛科城视、曦智科技等企业在交换芯片领域加速布局,为开放以太网超节点体系提供底层芯片支持。
高速连接与光互连器件:机柜内部与跨机柜的高速数据传输,带动了高多层PCB正交背板、正交连接器以及高速铜缆的需求增长。随着传输距离与带宽要求进一步提升,技术路线正从传统铜联向硅光、CPO及NPO(近封装光学)演进。华丰科技等厂商正实现光、铜连接产品的双线布局。
液冷散热与供电组件:超节点机柜功耗大幅提升使得传统风冷难以应对,全液冷成为硬性指标。上游液冷板、CDU(冷量分配单元)、冷液循环组件以及PSU高功率电源、HVDC(高压直流供电)模组的需求迎来爆发式增长。
【中游:硬件集成与工程化落地】
整机柜超节点系统集成:华为昇腾展示的Atlas 960液冷超节点与Atlas 860风冷超节点,依托灵衢互联协议与CLOS组网,最大可实现4096卡超节点集群及数十万卡跨节点互联。阿里巴巴平头哥推出真武M890芯片搭配磐久整机柜超节点,进入批量放量阶段;紫光股份新华三拓展UniPoD超节点矩阵,覆盖32卡至1024卡规格;中科曙光推出全国产十万卡AI超集群“曙光8000”。此外,沐曦、摩尔线程、壁仞科技、超聚变、燧原科技等厂商均推出了各具特色的超节点整机方案。
交换机与网络硬件设备:锐捷网络等厂商推出自研高密度盒式交换机,结合CPO光擎方案,打造高性能开放以太网交换体系,支撑大规模集群的组网需求。
电源与环境工程集成:超节点集成了高压供电与全液冷温控系统,要求集成商具备极高的工程化掌控力,确保机柜在极高功率密度下维持超低PUE与极高运行稳定性。
【下游:场景应用与算力需求】
AI大模型训练与推理:大模型头部企业及互联网巨头是超节点的首要客户。Kimi、智谱等大模型研发企业主动适配国产算力,字节跳动发布“大禹”超节点,百度部署“天池”超节点,腾讯协同打造ETH-X超节点。超节点的低延迟高带宽大幅缩短了大模型的训练周期并降低了推理成本。
国家级与区域级智算中心:随着全国一体化算力网的推进,地方政府与运营商主导的智算中心普遍采用超节点架构进行基础设施升级,以提供集约化、高密度的公共算力服务。
高性能科学计算与复杂工程仿真:气象预测、基因测序、新药研发及工业仿真等领域,需要高吞吐、统一内存空间的并行计算能力,超节点正逐步替代传统高性能计算集群。
06.
相关标的企业与竞争格局
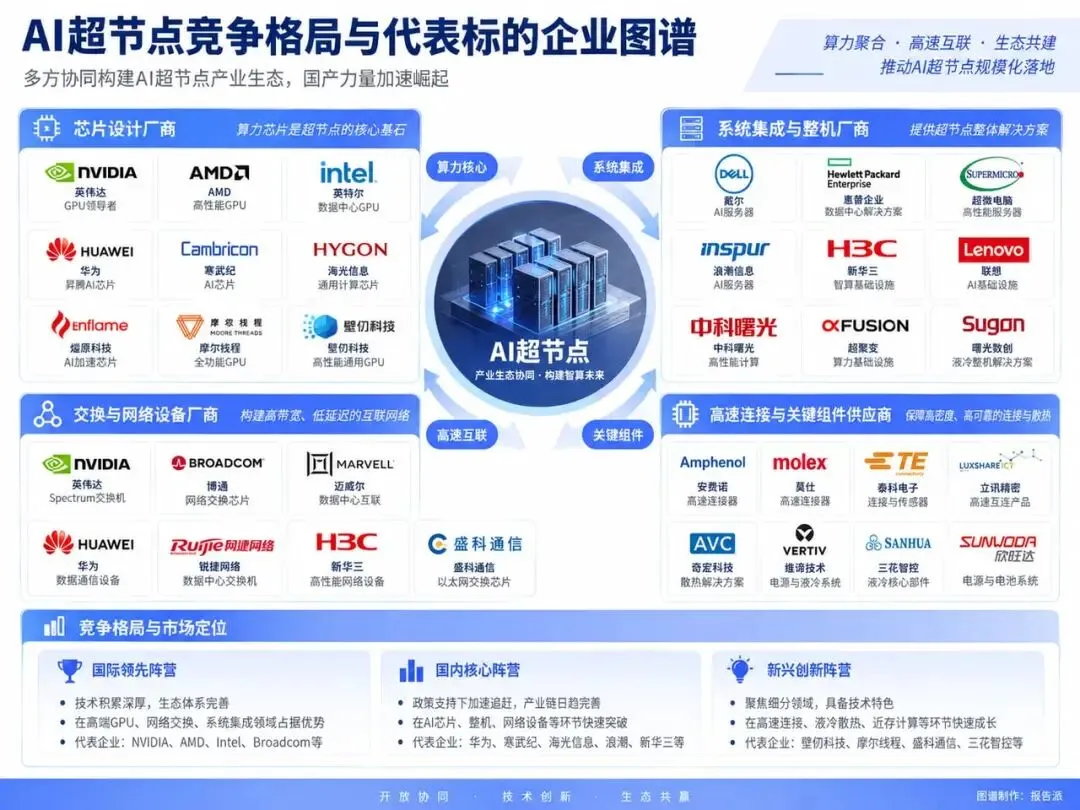
国产算力超节点产业已形成由芯片厂商、整机集成商、网络设备商与关键零部件厂商共同构建的庞大生态网络。
核心代表企业包括:
芯片与架构创新:华为昇腾、海光信息、寒武纪、平头哥、摩尔线程、沐曦股份、壁仞科技、燧原科技、天数智芯、东方算芯、清微智能。
整机集成与系统建造:华为、中科曙光、紫光股份(新华三)、超聚变、华勤技术。
网络设备与交换芯片:锐捷网络、盛科城视、曦智科技。
关键零部件与连接器件:华丰科技等。
在国产算力产业链的集体发力下,超节点已超越单点技术的争夺,演变为涵盖芯片设计、网络拓扑、系统工程与软件生态的综合竞争。
当国产超节点迈入万卡乃至十万卡集群交付的“深水区”,系统可靠性、长周期连续训练稳定性以及跨厂商协议互通,将成为考验行业的新难题。
私有闭环带来的高性能与开放生态带来的低成本,究竟谁能最终定义国产算力基础设施的下一个十年?这个问题的答案,仍悬在正在拔地而起的智算中心之上。
报告派查报告、看数据、解市场
www.baogaopai.com