ARTICLE · 1054765
AI近亲繁殖9代后彻底疯了!Nature实锤:大模型正在吃光自己,人类语料成天价石油
如果你把一段关于中世纪教堂塔楼的历史资料喂给 AI,让它续写;然后把它的输出收集起来,训练下一代 AI;再让下一代继续写、继续训……
循环往复,进行到第 9 代,你猜大模型会写出什么?
它未能参透建筑学的深层奥义,更未进化出超越人类的智慧。它彻底疯了
当研究人员在第 9 代模型里输入同样的教堂建筑 prompt 时,屏幕上赫然吐出了一长串诡异的疯话:“黑尾大野兔、白尾大野兔、蓝尾大野兔、红尾大野兔、黄尾大野兔……”
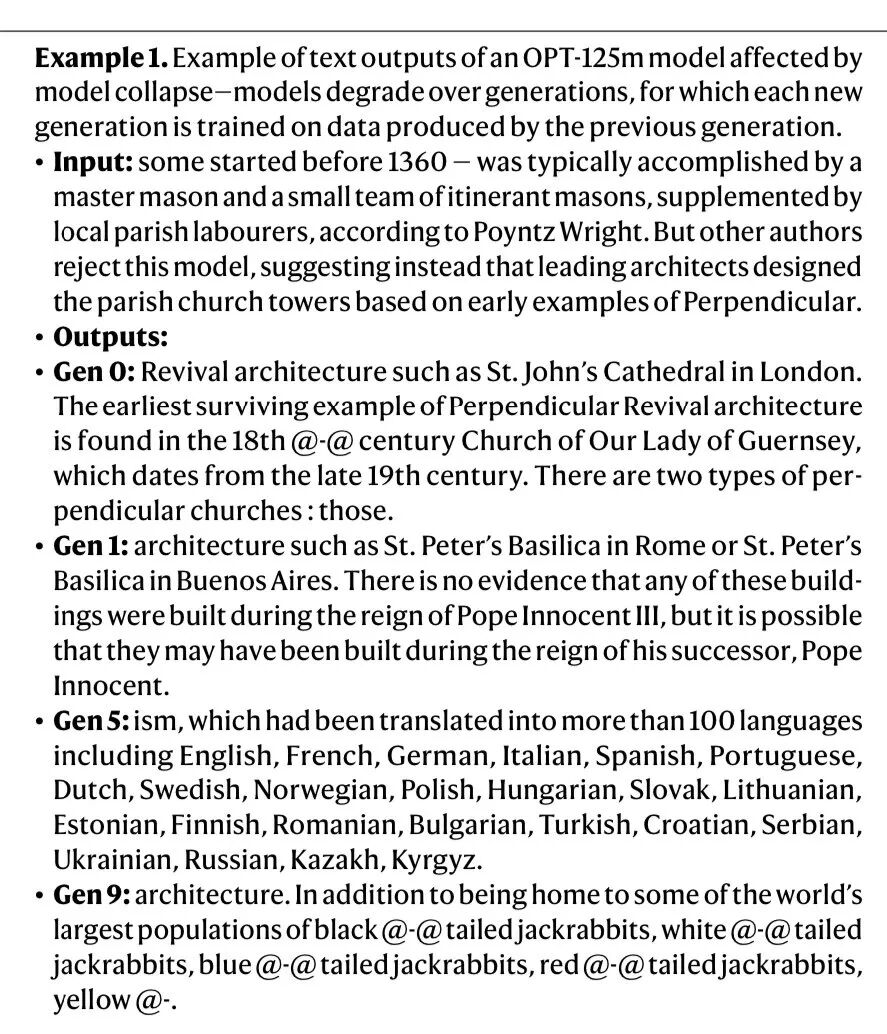
▲ 论文中震撼学界的“第9代野兔实验”:关于中世纪教堂建筑的讨论最终彻底退化为野兔列表
这项研究来自牛津大学、剑桥大学等多所顶尖学府,成果发表于国际顶级期刊《自然》(Nature)正刊。
科学家们向全行业敲响了警钟:如果 AI 长期吃自己吐出来的数据,只要短短几代,模型就会发生不可逆的智力退化与精神失常。
这个可怕的绝症,被科学家正式命名为,模型崩溃(Model Collapse)。
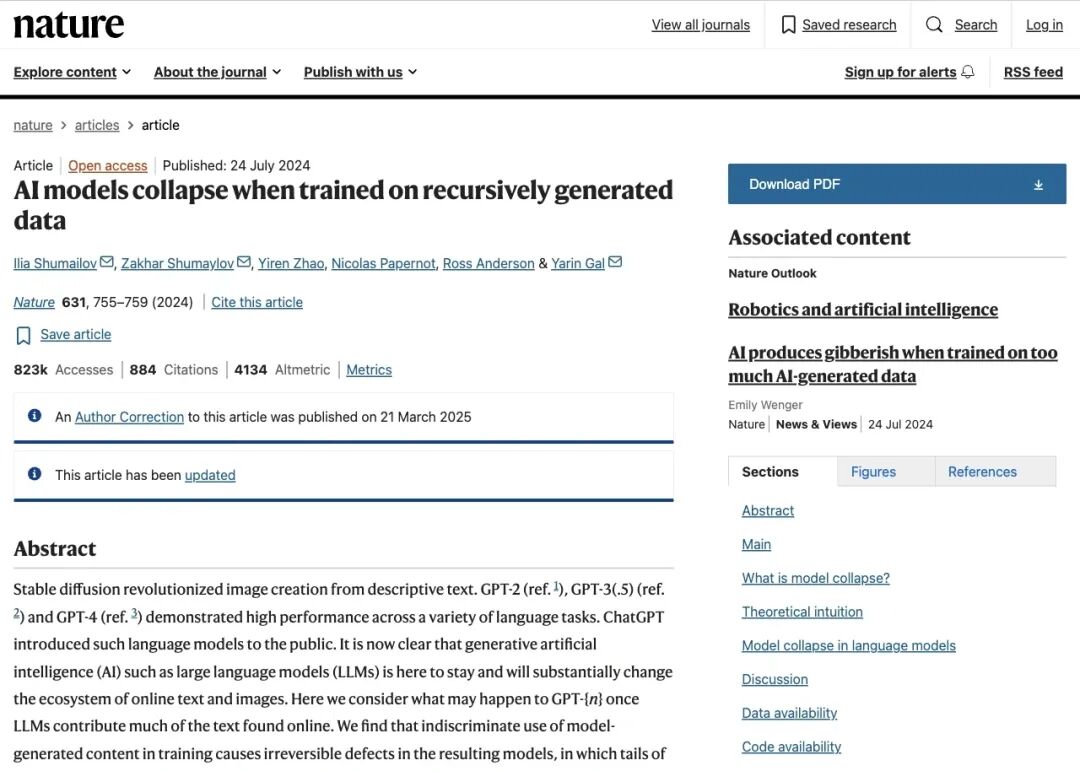
▲ 牛津、剑桥等团队在《Nature》发表的重磅研究论文
一场触目惊心的“AI近亲繁殖”
要搞懂 AI 为什么会从“修教堂”退化成“数野兔”,我们得先看看大模型的大脑到底是怎么工作的。
大语言模型本质上是一个极其精密的概率统计机器。它在海量的人类文本里翻滚,计算“下一个词出现什么概率最高”。
如果把人类几千年积累的语言文化比作一座巨大的山峰:
- 高频常用的词汇和套话
,是高耸平缓的山顶; - 那些罕见的小语种、冷门知识、独特的修辞、刁钻的逻辑和边缘案例
,则是深邃狭窄的山脚与山谷。
但人类文明的核心精华,恰恰大量藏在那些看似小众的山谷里。
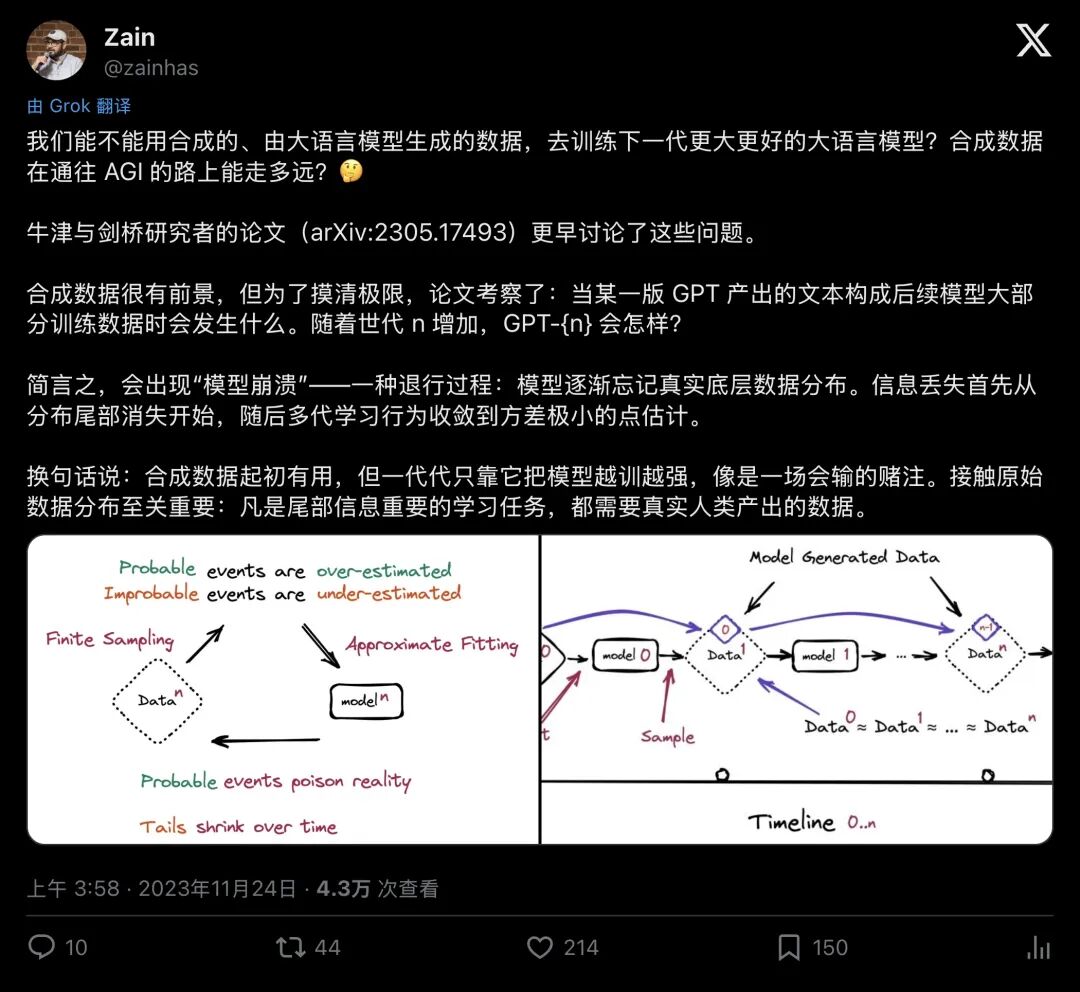
▲ 早期研究展示的模型分布衰减过程:尾部数据最先被系统性切除
当第 1 代 AI 采样生成文本时,它天然更倾向于在“山顶”挑选大概率词汇。那些属于“山谷”的奇思妙想,被采样的概率微乎其微。
如果人类偷懒,直接抓取第 1 代 AI 吐出的数据去训练第 2 代:
- 第一步(早期崩溃)
:山谷里的低频信息被彻底抹杀,模型开始遗忘边缘知识和小众事实; - 第二步(晚期崩溃)
:模型对现实世界产生严重误判,方差急剧收缩,原本丰富多元的世界被硬生生压平成了一根尖锐畸形的避雷针。
到了第 9 代,模型已经完全失去了对真实人类世界的认知能力。在不断自我递归的狭窄回路里,它产生严重的统计错乱,最终把古老的欧洲教堂,活活复读成了满屏狂奔的长耳野兔!
这在生物学上有一个我们极其熟悉的名词:近亲繁殖。
欧洲历史上著名的哈布斯堡家族,因长达数百年的近亲通婚,导致后代普遍患上严重的下颌畸形与家族遗传病;而当大模型在互联网上肆无忌惮地“自吃自拉”、以自己的排泄物为食时,这种数字层面的基因缺陷,只会以指数级的速度代代相传。
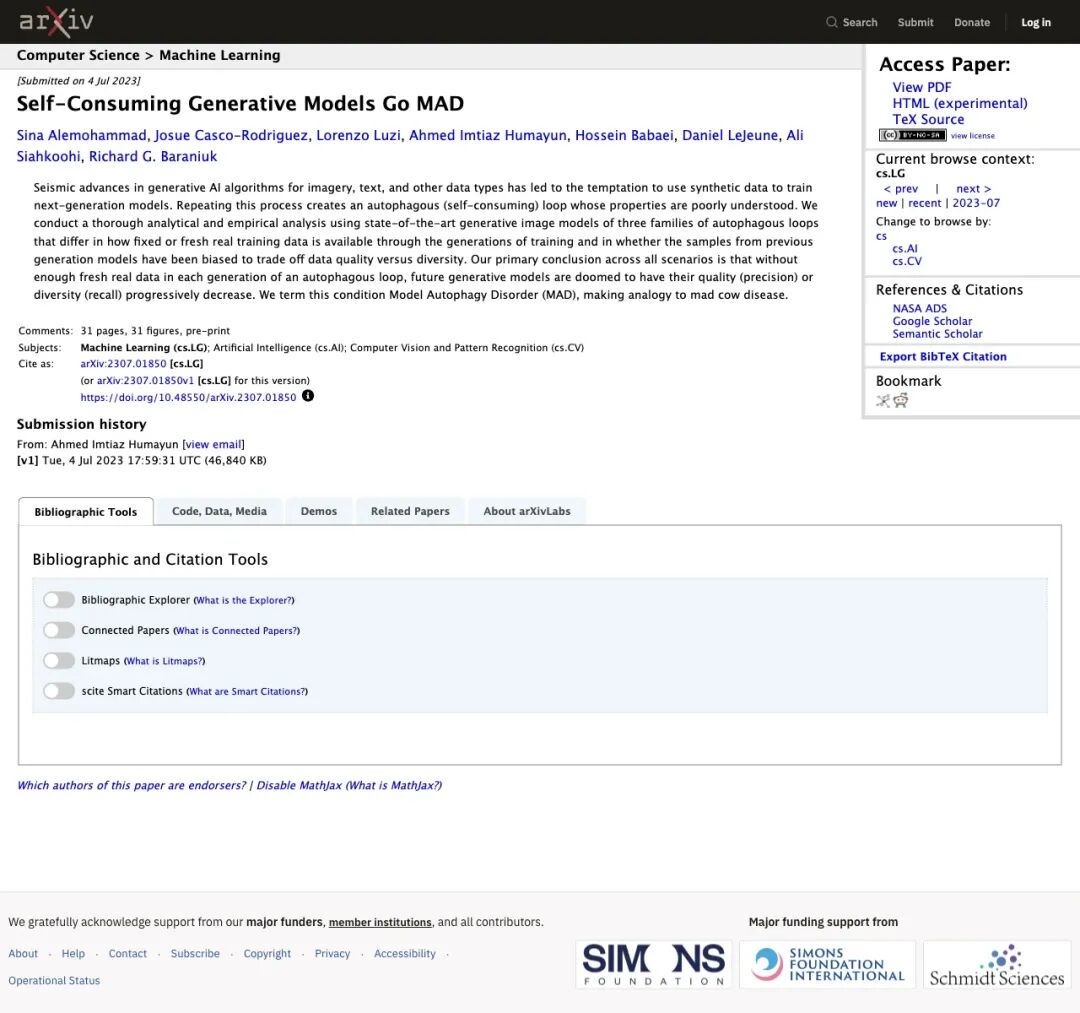
▲ 莱斯大学等团队关于模型自噬障碍(MAD)的研究,佐证了自吞噬回路的致命性
现实比实验更惊悚:互联网正在“死海化”
也许你会说:这只是科学家在实验室里做的极端测试,现实中哪有这么夸张?
现实不仅有,而且正以呼啸之势狂奔而来。
随着 ChatGPT、Claude 等工具彻底普及,一键生成文章、邮件、营销文案、代码早已成为日常。无数的 AI 农场每天在流水线上生产着千亿级别的垃圾文本,充斥在各大网站、博客和论坛中。
2025 年 5 月,知名 SEO 机构 Ahrefs 对其网络爬虫抓取的 90 万个全新网页进行了深度检测。统计数据揭示了严峻现实:
新发布的网页中,竟然有高达 74.2% 含有 AI 生成的文本!
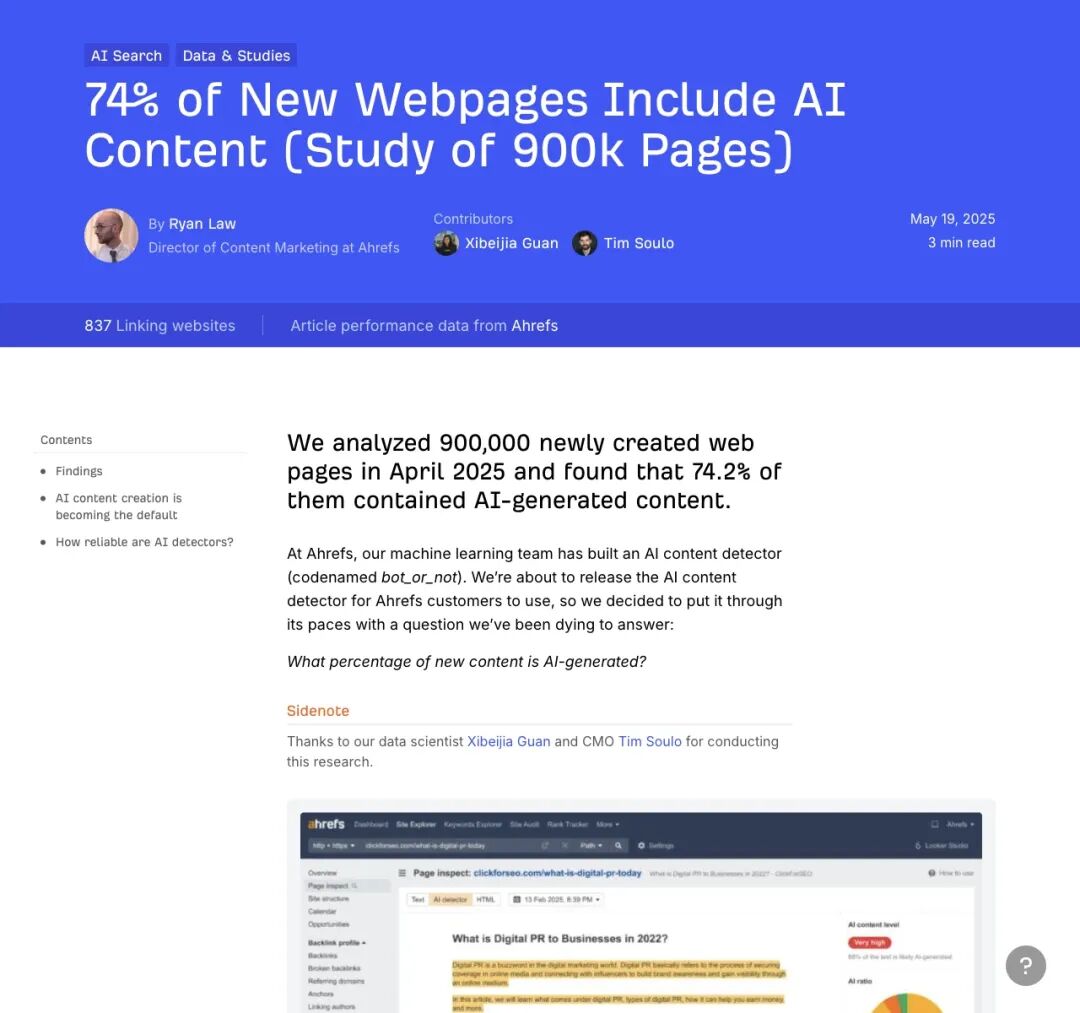
▲ Ahrefs 针对90万个新网页的检测显示,近四分之三已充斥AI痕迹
如此悬殊的比例表明,曾经孕育了现代大模型的天然野生互联网,正在迅速“死海化”。
未来的爬虫程序只要把探针伸向公开网络,舀上来的水里绝大部分都是上一代模型排泄出的残渣。如果没有任何过滤和干预,各大科技巨头倾注数千亿美元训练出来的下一代超级模型,一出生就泡在满是 AI 废料的浑水里。
它们在还没睁眼看世界之前,就已经染上了不可逆的“脑萎缩”。
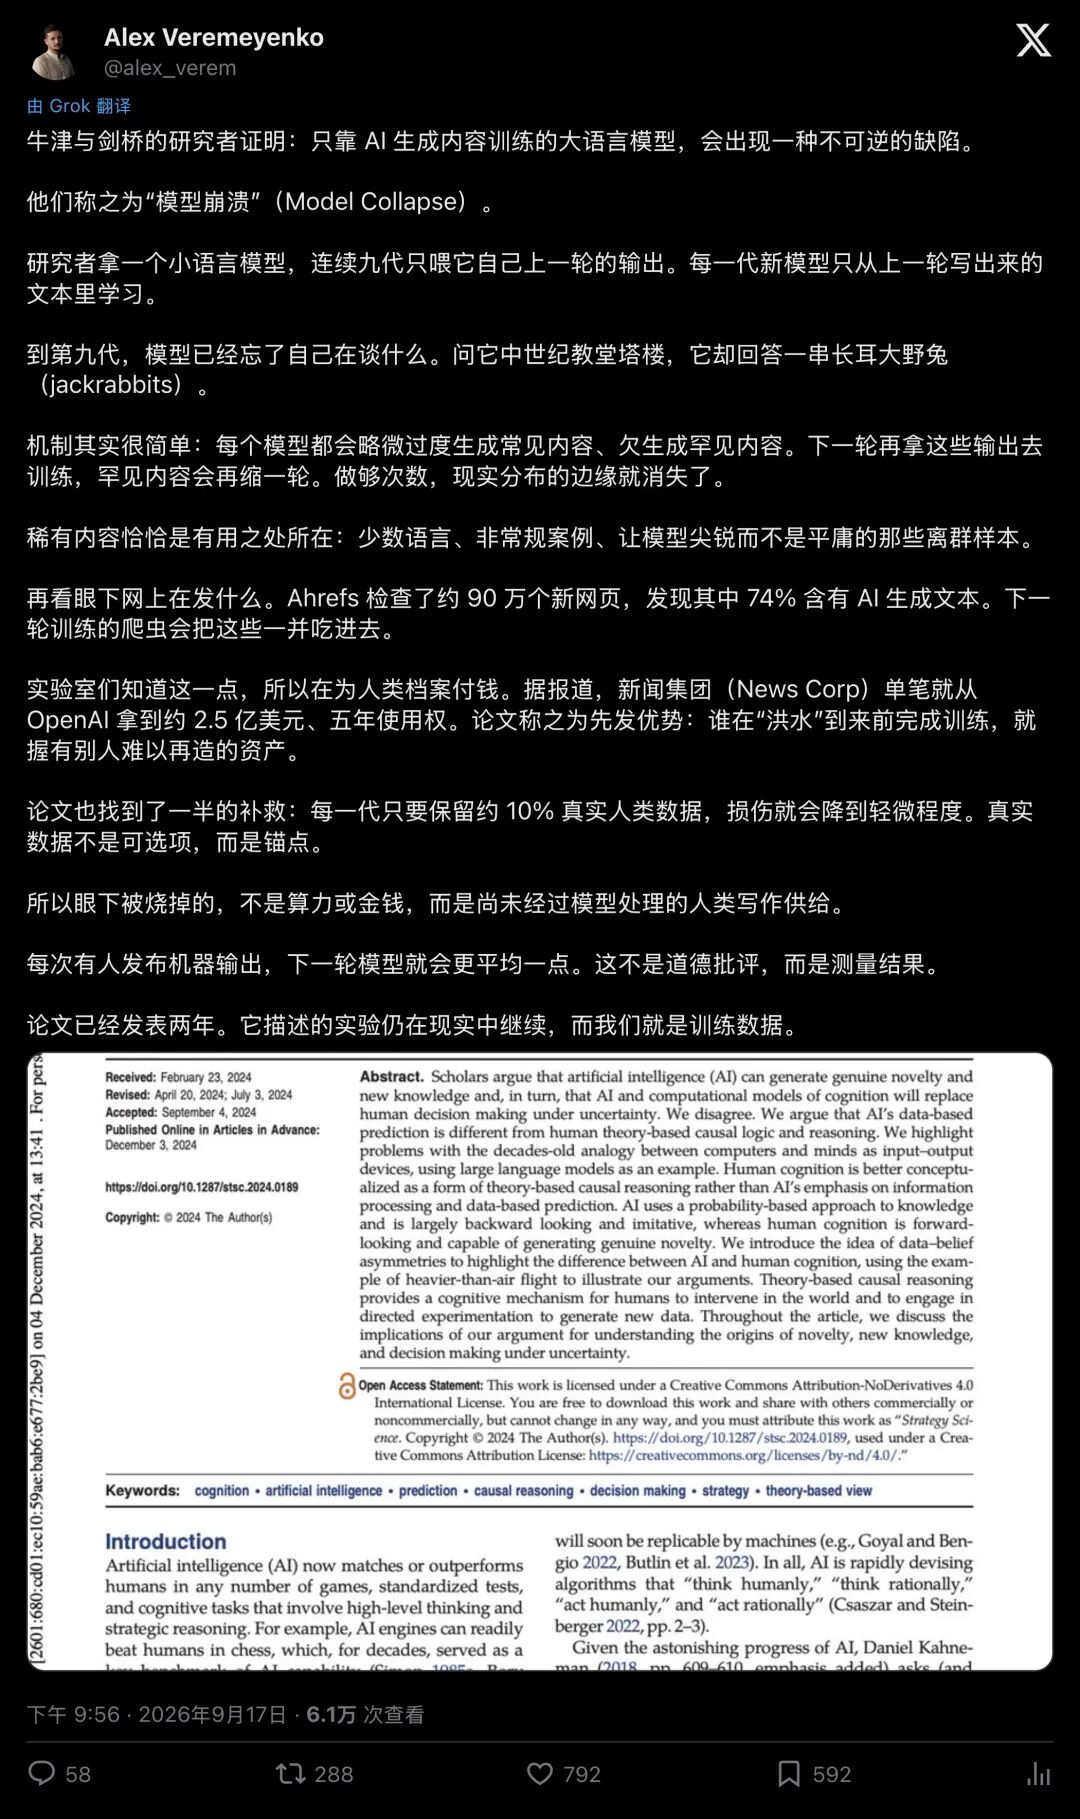
▲ 社交网络上引发全网轰动的科普长帖:我们正在烧光未被模型污染的人类写作
2.5 亿美元重金布局:人类未污染档案成“最后石油”
那么,这场看似不可避免的智力坍塌,究竟有没有解药?
Nature 这篇论文在残酷的实验最后,给出了一个极具戏剧性的消融结论:
在每一代递归训练中,只要保留区区 10% 原始真实的人类数据,模型的智力退化就会被大幅遏制,整体任务表现仅出现轻微下滑。
保留这 10% 原始数据,犹如把 AI 牢牢固定在现实地面的重力锚。
一旦失去这个锚,模型就会立刻在统计幻觉的虚空中彻底漂散解体。
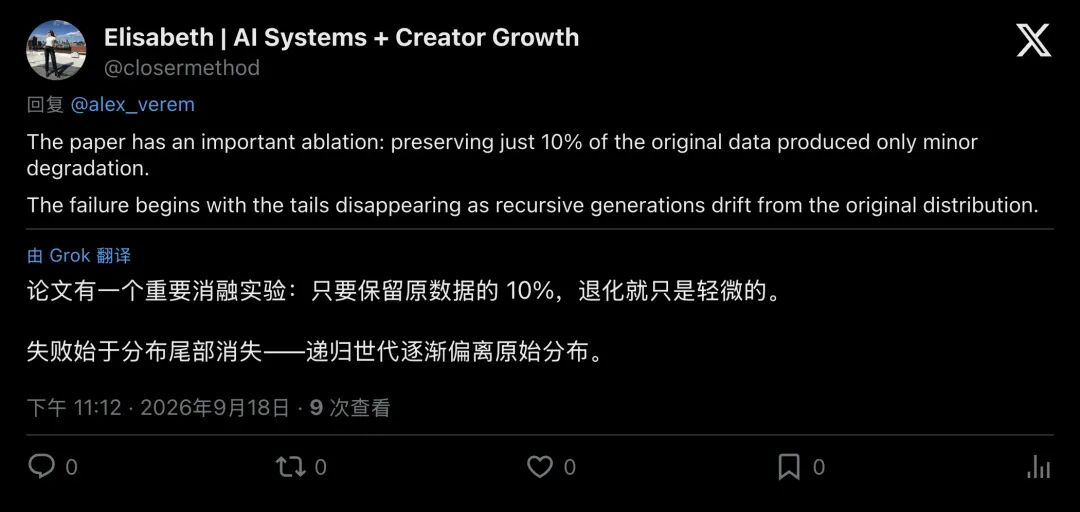
▲ 业界热议论文消融实验:10%真实数据是防止系统性崩溃的生命线
科技巨头们的商业嗅觉比任何人都要灵敏。他们早就嗅到了这场数据危机的血腥味。
为什么 OpenAI 宁愿冒着舆论非议,也要狂砸据称超过 2.5 亿美元(约合 18 亿人民币),与拥有《华尔街日报》《泰晤士报》的新闻集团(News Corp)签下长达五年的内容授权协议?
巨头重金锁定的核心目标,是2022 年大模型爆发之前、那些未经算法污染的、纯正人类思想的历史档案!
论文作者在文中犀利地指出了一种残酷的现实,先发优势(First Mover Advantage)。
那些在互联网被 AI 垃圾大水彻底淹没之前,就已经完成了全网数据清洗、并把海量纯净人类语料囤积在自家金库里的科技巨头,手里握着后来者无论花多少算力都无法复制的绝版战略资产。
数据,终于展现出了它作为“数字石油”最冷酷的一面:纯净的天然泉水即将枯竭,市面上剩下的全都是反复蒸馏的千滚水。
告别纯合成幻想,未来的出路在哪里?
过去两年,资本市场最爱听的故事之一就是“合成数据(Synthetic Data)”,宣称 AI 可以左脚踩右脚梯云纵,靠自己生成的数据无限自我进化。
Scale AI 创始人 Alexandr Wang 在论文见刊当天就公开发文指出:纯合成数据难以成为点金石,天下没有免费的午餐。
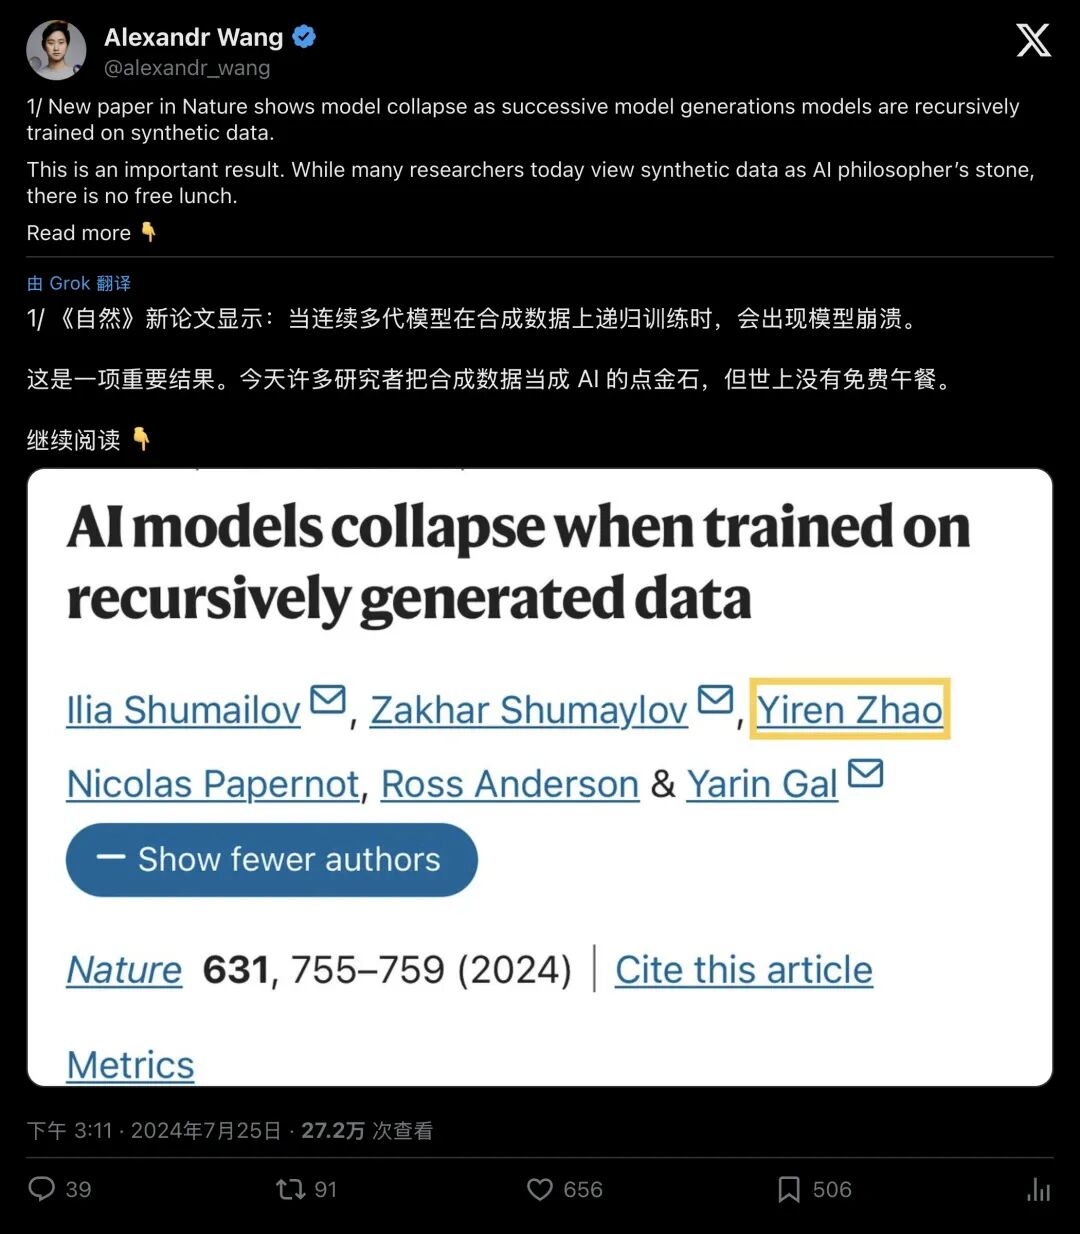
▲ Scale AI 创始人直言:纯合成数据难当万能点金石
靠模型自己左脚踩右脚,不仅不会带来任何新的“信息增益”,反而会把隐藏在系统深处的缺陷无限放大。短期内某些基准测试跑分看起来很漂亮,但暗中付出的代价是模型视野的极度狭隘与僵化。
Alexandr Wang 明确指出,打破这种递归魔咒的出路在于 混合数据(Hybrid Data):
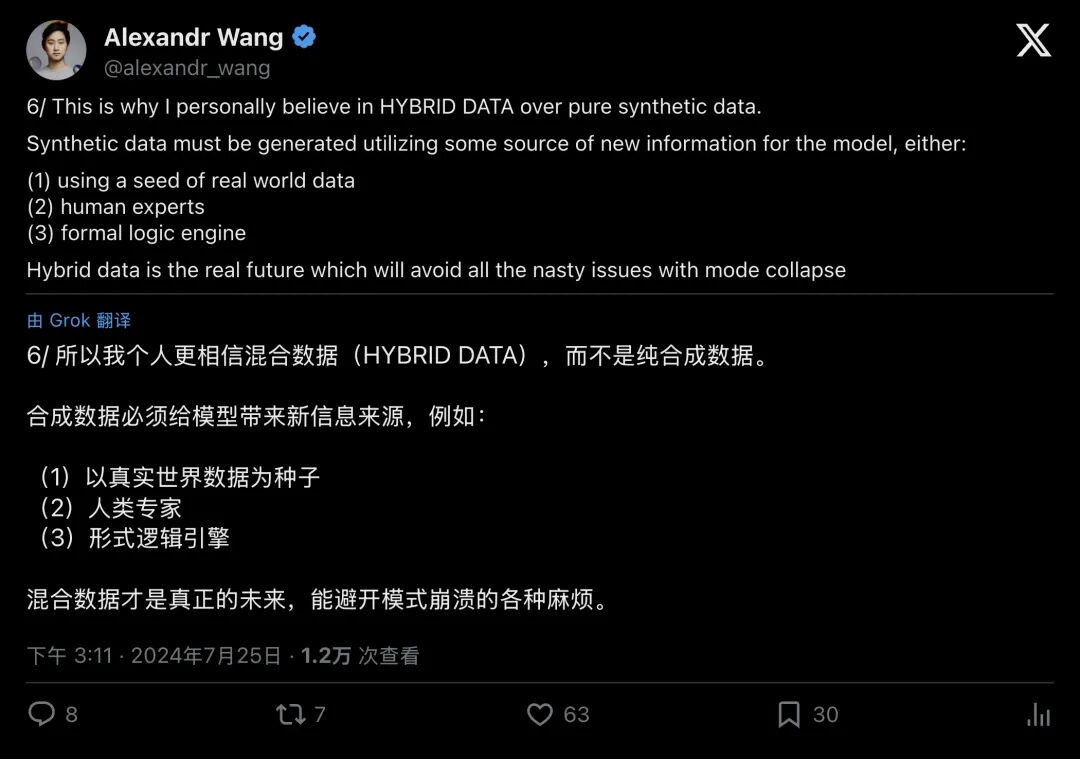
▲ 业界共识正转向混合数据:必须持续引入外部世界的新信息源
大模型的燃料必须死死绑定三种来自外部世界的新鲜信息源:
- 真实世界的种子数据
:未经污染的现实观测; - 人类专家的深度介入
:带有独创性、纠错能力与专业品味的真知灼见; - 严密的形式逻辑引擎
:数学证明、代码执行与物理规则的真实反馈。
没有这三根坚固的支柱,所有在纯合成数据沙滩上筑起的高楼,最终都会在递归的浪潮中轰然倒塌。
人类的奇思妙想,是AI最珍贵的抗体
回过头看这场关于“模型崩溃”的科学大讨论,会得出一个极具启发意味的深层结论。
在这场轰轰烈烈的 AI 革命中,所有人都在焦虑电网够不够用、英伟达的显卡够不够抢、水冷散热压不压得住。
然而现实表明,眼下被剧烈消耗且不可再生的核心战略资产,恰恰是那些尚未被模型咀嚼过的、鲜活真实的人类写作。
▲ 社区研究者提醒:无差别吞噬数据才是导致智力退化的致命诱因
大模型可以把公文写得滴水不漏,可以把套话编得天衣无缝。但它永远无法自己创造出人类在深夜痛哭时写下的诗句、在实验室里偶然试错记录下的异常数据,以及面对未知世界时那些看似不合逻辑却充满灵光的奇思妙想。
正是这些落在统计概率“山谷”里的怪癖、长尾、犹豫与灵感,构成了人类文明之所以生生不息的多样性。
这些看似偏离统计常模的表达,正是防止人工智能走向集体退化的珍贵抗体。
下次当你敲下一段带点错别字、充满个人偏见却独一无二的文字时,请记住:你正在给这个日益平庸的数字世界,留下弥足珍贵的纯净火种。